Poda e esparsidade de modelos no YOLOv5#
📚 Este guia explica como aplicar a poda aos modelos YOLOv5 🚀 para criar redes mais eficientes sem comprometer o desempenho.
O que é a poda de modelos?#
A poda de modelos é uma técnica usada para reduzir o tamanho e a complexidade das redes neurais, removendo parâmetros menos importantes (pesos e ligações). Este processo cria um modelo mais eficiente, com várias vantagens:
- Redução do tamanho do modelo para facilitar a implementação em dispositivos com recursos limitados
- Inferência mais rápida com impacto mínimo na precisão
- Menor utilização de memória e consumo de energia
- Maior eficiência geral em aplicações em tempo real
A poda identifica e remove os parâmetros que contribuem pouco para o desempenho do modelo, resultando num modelo mais leve com precisão semelhante.
Antes de começar#
Clone o repositório e instale requirements.txt em um ambiente Python>=3.8.0, incluindo PyTorch>=1.8. Os modelos e conjuntos de dados são baixados automaticamente da versão mais recente do YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Testar o desempenho de referência#
Antes de aplicar a poda, estabelece um desempenho de referência para comparação. Este comando testa o YOLOv5x em COCO val2017 com um tamanho de imagem de 640 pixels. yolov5x.pt é o maior e mais preciso modelo disponível. Outras opções são yolov5s.pt, yolov5m.pt e yolov5l.pt, ou o teu próprio checkpoint do treino num conjunto de dados personalizado, por exemplo, runs/train/exp/weights/best.pt. Para ver detalhes de todos os modelos disponíveis, consulta a tabela do README.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSaída:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Aplicar poda ao YOLOv5x (30% de esparsidade)#
Podemos aplicar a poda ao modelo usando a função prune() definida em utils/torch_utils.py. Para testar um modelo podado, atualizamos val.py para podar o YOLOv5x com uma esparsidade de 0.3 (30% dos pesos definidos como zero):
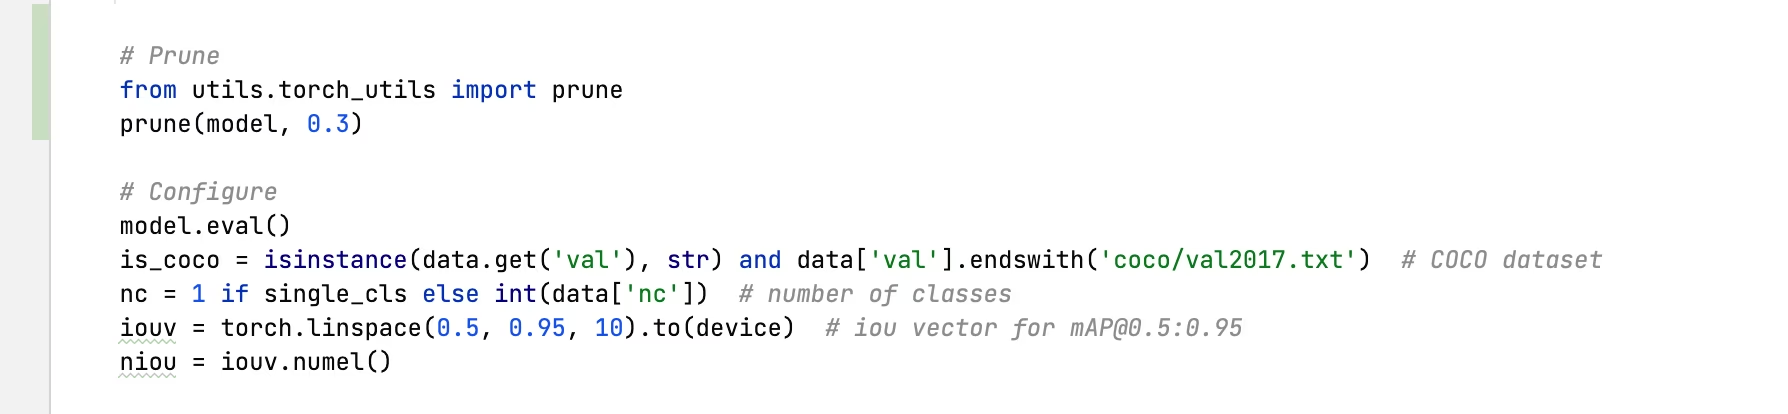
Resultado com 30% de poda:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Análise dos resultados#
Com base nos resultados, podemos observar:
- Esparsidade de 30% alcançada: 30% dos parâmetros de peso do modelo nas camadas
nn.Conv2dsão agora zero - O tempo de inferência permanece inalterado: Apesar da poda, a velocidade de processamento é praticamente a mesma
- Impacto mínimo no desempenho: O mAP diminuiu ligeiramente de 0.507 para 0.489 (uma redução de apenas 3.6%)
- O tamanho do modelo não se alterou: Os pesos definidos como zero continuam armazenados de forma densa, por isso o tamanho do ficheiro só diminui com formatos compatíveis com esparsidade ou com compressão
Isto demonstra que a poda pode reduzir significativamente a complexidade do modelo com apenas um pequeno impacto no desempenho, sendo uma técnica de otimização eficaz para a implementação em ambientes com recursos limitados.
Ajuste fino de modelos podados#
Para obter os melhores resultados, os modelos podados devem ser ajustados finamente após a poda para recuperar a precisão. Podes fazê-lo da seguinte forma:
- Aplicar a poda com o nível de esparsidade pretendido
- Treinar o modelo podado durante algumas épocas com uma taxa de aprendizagem mais baixa
- Avaliar o modelo podado após o ajuste fino comparando-o com o desempenho de referência
Este processo ajuda os parâmetros restantes a adaptarem-se e a compensarem as ligações removidas, recuperando muitas vezes a maior parte ou toda a precisão original.
Ambientes compatíveis#
A Ultralytics oferece uma variedade de ambientes prontos para uso, cada um com dependências essenciais pré-instaladas, como CUDA, CUDNN, Python e PyTorch, para você começar seus projetos.
- Notebooks gratuitos com GPU:


- Google Cloud: Guia de início rápido do GCP
- Amazon: Guia de início rápido da AWS
- Azure: Guia de início rápido do AzureML
- Docker: Guia de início rápido do Docker

Estado do projeto#

Este emblema indica que todos os testes de Integração contínua (CI) das GitHub Actions da YOLOv5 estão a passar. Estes testes de CI verificam rigorosamente a funcionalidade e o desempenho da YOLOv5 em vários aspetos importantes: treino, validação, inferência, exportação e avaliação de desempenho. Os testes garantem um funcionamento consistente e fiável em macOS, Windows e Ubuntu e são realizados a cada 24 horas e sempre que é criado um novo commit.
Perguntas frequentes#
A poda não estruturada define os pesos como zero, mas mantém inalteradas as formas dos tensores, pelo que os kernels densos do PyTorch executam a mesma quantidade de operações. Para acelerar, é necessário um ambiente de execução compatível com esparsidade, como o DeepSparse, ou uma poda estruturada que remova canais inteiros.
Chama a função auxiliar de
utils/torch_utils.pyantes da validação ou da exportação:from utils.torch_utils import prune prune(model, amount=0.3) # 30% de esparsidade global nos pesos nn.Conv2dComeça com 0.3 e mede o mAP. O YOLOv5x perdeu cerca de 3.6% de mAP com 30% de esparsidade, sem ajuste fino; níveis mais elevados de esparsidade geralmente exigem algumas épocas de retreino com uma taxa de aprendizagem baixa para recuperar a precisão.
Sim. Os pesos definidos como zero são guardados como quaisquer outros, por isso
export.pyfunciona sem alterações. O tamanho do ficheiro só diminui se o formato de destino ou o ambiente de execução comprimir os tensores esparsos.