Ensembling de modelos YOLOv5#
Este guia explica como usar o ensemble de modelos Ultralytics YOLOv5 durante o teste e a inferência para melhorar o mAP e a revocação.
Da aprendizagem por ensembles:
A modelagem por ensembles é um processo em que vários modelos diversificados são criados para prever um resultado, seja através da utilização de muitos algoritmos de modelagem diferentes ou de conjuntos de dados de treino distintos. Em seguida, o modelo ensemble agrega as previsões de cada modelo base e gera uma previsão final para os dados não vistos. A motivação para usar modelos ensemble é reduzir o erro de generalização da previsão. Desde que os modelos base sejam diversificados e independentes, o erro de previsão do modelo diminui com a utilização da abordagem ensemble. Esta abordagem procura aproveitar a sabedoria das multidões para fazer uma previsão. Embora o modelo ensemble contenha vários modelos base, comporta-se e funciona como um único modelo.
Antes de começar#
Clone o repositório e instale requirements.txt em um ambiente Python>=3.8.0, incluindo PyTorch>=1.8. Os modelos e conjuntos de dados são baixados automaticamente da versão mais recente do YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Testar normalmente#
Antes de combinar modelos, estabeleça o desempenho de referência de um único modelo. Este comando testa YOLOv5x no COCO val2017 com tamanho de imagem de 640 pixels. yolov5x.pt é o maior e mais preciso modelo P5. Outras opções são os pontos de verificação pré-treinados menores yolov5n.pt, yolov5s.pt, yolov5m.pt e yolov5l.pt, ou seu próprio ponto de verificação de treinamento em um conjunto de dados personalizado, como runs/train/exp/weights/best.pt.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSaída:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Teste do ensemble#
É possível combinar vários modelos pré-treinados durante o teste e a inferência, acrescentando modelos ao argumento --weights em qualquer comando val.py ou detect.py existente. Este exemplo testa um ensemble de dois modelos:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfVocê pode listar quantos pontos de verificação quiser, incluindo pesos personalizados como runs/train/exp5/weights/best.pt. O YOLOv5 executará cada modelo automaticamente e concatenará as previsões por imagem antes de realizar NMS.
Saída:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images  Instances          P          R      mAP50   mAP50-95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844
Inferência com ensemble#
Acrescenta modelos ao argumento --weights para executar a inferência com ensemble:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesSaída:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)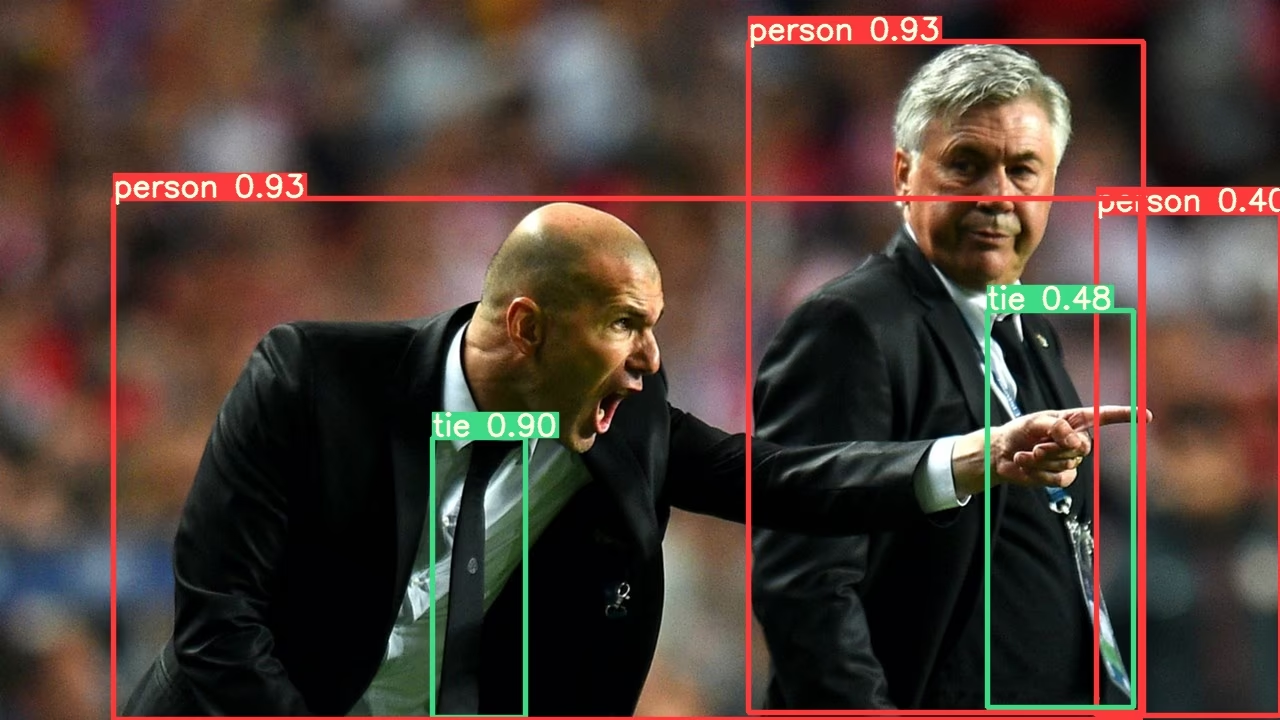
Vantagens do ensembling de modelos#
O ensembling de modelos com YOLOv5 oferece várias vantagens:
- Maior precisão: Como demonstram os exemplos acima, combinar vários modelos aumenta o mAP de 0.504 para 0.515 e o mAR de 0.681 para 0.689.
- Melhor generalização: combinar modelos diversos ajuda a reduzir o sobreajuste e melhora o desempenho em dados variados.
- Maior robustez: Os ensembles são geralmente mais robustos ao ruído e aos valores atípicos nos dados.
- Pontos fortes complementares: Modelos diferentes podem destacar-se na deteção de tipos de objetos distintos ou em diferentes condições ambientais.
A principal contrapartida é o aumento do tempo de inferência, como mostram as métricas de velocidade (22.4ms para um único modelo contra 39.5ms para o ensemble).
Quando usar o ensembling de modelos#
Considera usar o ensembling de modelos nos seguintes cenários:
- Quando a precisão é mais importante do que a velocidade de inferência
- Em aplicações críticas nas quais é necessário minimizar os falsos negativos
- Ao processar imagens difíceis, com iluminação, oclusão ou escala variáveis
- Durante competições ou avaliações comparativas que exigem o máximo desempenho
Para aplicações em tempo real com requisitos rigorosos de latência, a inferência com um único modelo pode ser mais adequada.
Ambientes compatíveis#
A Ultralytics oferece diversos ambientes prontos para uso, cada um com dependências essenciais pré-instaladas, como CUDA, cuDNN, Python e PyTorch, para você começar seus projetos.
- Notebooks gratuitos com GPU:


- Google Cloud: Guia de início rápido do GCP
- Amazon: Guia de início rápido da AWS
- Azure: Guia de início rápido do AzureML
- Docker: Guia de início rápido do Docker

Estado do projeto#

Este emblema indica que todos os testes de Integração contínua (CI) das GitHub Actions da YOLOv5 estão a passar. Estes testes de CI verificam rigorosamente a funcionalidade e o desempenho da YOLOv5 em vários aspetos importantes: treino, validação, inferência, exportação e avaliação de desempenho. Os testes garantem um funcionamento consistente e fiável em macOS, Windows e Ubuntu e são realizados a cada 24 horas e sempre que é criado um novo commit.
Perguntas frequentes#
Qualquer quantidade. Lista todos os checkpoints depois de
--weights, por exemplo,--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. O tempo de inferência aumenta aproximadamente em proporção ao número de modelos.Sim. As previsões são concatenadas antes de aplicar NMS, por isso todos os modelos têm de ser treinados com a mesma lista de classes e na mesma ordem. Os tamanhos de entrada e as arquiteturas podem ser diferentes.
Sim. Acrescenta
--augmentao mesmo comandoval.pyoudetect.pypara aplicar TTA a todos os modelos do ensemble.O ensembling é gerido pelo módulo
Ensembledo PyTorch emmodels/experimental.py, por isso aplica-se apenas a checkpoints.pt. Exporta cada modelo separadamente se precisares de ficheiros ONNX ou TensorRT.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.