Aumento no momento do teste (TTA)#
📚 Este guia explica como usar o Aumento no Momento do Teste (TTA) durante os testes e a inferência para melhorar o mAP e a recall com YOLOv5 🚀.
Antes de começar#
Clone o repositório e instale requirements.txt em um ambiente Python>=3.8.0, incluindo PyTorch>=1.8. Os modelos e conjuntos de dados são baixados automaticamente da versão mais recente do YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Testar normalmente#
Antes de experimentar o TTA, queremos estabelecer um desempenho de referência para comparar. Este comando testa YOLOv5x no COCO val2017 com um tamanho de imagem de 640 píxeis. yolov5x.pt é o maior e mais preciso modelo disponível. As outras opções são yolov5n.pt, yolov5s.pt, yolov5m.pt e yolov5l.pt, ou o teu próprio checkpoint do treino com um conjunto de dados personalizado, ou seja, runs/train/exp/weights/best.pt. Para ver informações sobre todos os modelos disponíveis, consulta a documentação do YOLOv5.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfSaída:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Testar com TTA#
Acrescenta --augment a qualquer comando val.py existente para ativar o TTA e aumenta o tamanho da imagem em cerca de 30% para obter melhores resultados. Tem em conta que a inferência com TTA ativado demora normalmente cerca de 2 a 3 vezes mais do que a inferência normal, porque as imagens são invertidas na horizontal e processadas em 3 resoluções diferentes, e os resultados são combinados antes da NMS. Parte da redução da velocidade deve-se simplesmente ao maior tamanho das imagens (832 em vez de 640), enquanto outra parte se deve às próprias operações de TTA; por isso, confirma que a tua GPU tem memória suficiente antes de aumentares --img.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfSaída:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
Inferência com TTA#
A inferência TTA de detect.py funciona exatamente como a inferência TTA de val.py: basta acrescentar --augment a qualquer comando detect.py existente:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentSaída:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)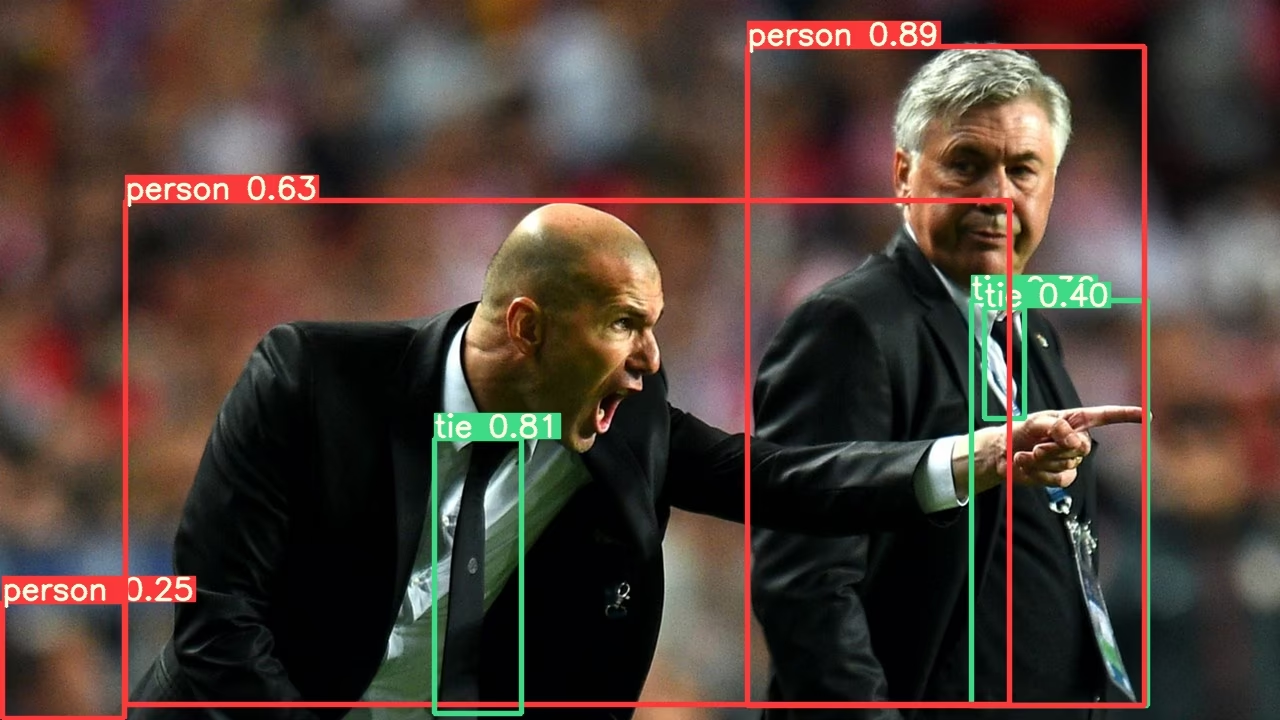
TTA no PyTorch Hub#
O TTA está integrado automaticamente em todos os modelos YOLOv5 PyTorch Hub e pode ser ativado passando augment=True durante a inferência.
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # ou yolov5m, yolov5x, personalizado

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # ou file, PIL, OpenCV, numpy, múltiplos

# Inference
results = model(img, augment=True)  # <--- inferência TTA

# Results
results.print() # ou .show(), .save(), .crop(), .pandas(), etc.Personalizar#
Podes personalizar as operações TTA aplicadas no método forward_augment() do YOLOv5.
Vantagens do Aumento no Momento do Teste#
O Aumento no Momento do Teste oferece várias vantagens importantes para tarefas de deteção de objetos:
- Maior precisão: como demonstram os resultados acima, o TTA aumenta o mAP de 0,504 para 0,516 e o mAR de 0,681 para 0,696.
- Melhor deteção de objetos pequenos: o TTA melhora especialmente a deteção de objetos pequenos, aumentando a AP para áreas pequenas de 0,351 para 0,361.
- Maior robustez: ao testar várias versões de cada imagem, o TTA reduz o impacto do ângulo de visão, da iluminação e de outros fatores ambientais.
- Implementação simples: basta adicionar a flag
--augmentaos comandos existentes.
A contrapartida é o aumento do tempo de inferência, o que torna o TTA mais adequado para aplicações que dão prioridade à precisão em detrimento da velocidade.
Ambientes compatíveis#
A Ultralytics oferece uma variedade de ambientes prontos para uso, cada um com dependências essenciais pré-instaladas, como CUDA, CUDNN, Python e PyTorch, para você começar seus projetos.
- Notebooks gratuitos com GPU:


- Google Cloud: Guia de início rápido do GCP
- Amazon: Guia de início rápido da AWS
- Azure: Guia de início rápido do AzureML
- Docker: Guia de início rápido do Docker

Estado do projeto#

Este emblema indica que todos os testes de Integração contínua (CI) das GitHub Actions da YOLOv5 estão a passar. Estes testes de CI verificam rigorosamente a funcionalidade e o desempenho da YOLOv5 em vários aspetos importantes: treino, validação, inferência, exportação e avaliação de desempenho. Os testes garantem um funcionamento consistente e fiável em macOS, Windows e Ubuntu e são realizados a cada 24 horas e sempre que é criado um novo commit.
Perguntas frequentes#
Cada imagem é processada em três escalas e com uma inversão horizontal, e as previsões são combinadas antes da NMS. As perspetivas adicionais melhoram a recall, especialmente para objetos pequenos, à custa de mais computação.
Espera um tempo de inferência cerca de 2 a 3 vezes superior ao normal. Parte do custo deve-se ao maior tamanho
--img, por isso confirma que a tua GPU tem memória suficiente antes de o aumentares.Executar o processamento com uma resolução cerca de 30% superior, por exemplo 832 em vez de 640, fornece mais detalhes às passagens multiescala e produziu os melhores resultados nos benchmarks acima.
Não. A passagem direta aumentada é executada no
DetectionModeldo PyTorch, por isso--augmentsó afeta checkpoints.pt. Os formatos ONNX, TensorRT e outros formatos exportados ignoram essa opção.