Evolução de hiperparâmetros para YOLOv5#
📚 Este guia explica a evolução de hiperparâmetros para YOLOv5 🚀. A evolução de hiperparâmetros é um método de otimização de hiperparâmetros que utiliza um algoritmo genético (GA) para otimização.
Os hiperparâmetros na aprendizagem automática controlam vários aspetos do treino, e encontrar os valores ideais pode ser um desafio. Os métodos tradicionais, como a pesquisa em grelha, podem rapidamente tornar-se impraticáveis devido a:
- O elevado número de dimensões do espaço de pesquisa
- Correlações desconhecidas entre as dimensões
- O elevado custo da avaliação da aptidão em cada ponto
Por isso, os algoritmos genéticos são uma opção adequada para a pesquisa de hiperparâmetros.
Antes de começar#
Clone o repositório e instale requirements.txt em um ambiente Python>=3.8.0, incluindo PyTorch>=1.8. Os modelos e conjuntos de dados são baixados automaticamente da versão mais recente do YOLOv5.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Inicializar os hiperparâmetros#
O YOLOv5 tem cerca de 30 hiperparâmetros usados em várias configurações de treino. Estes estão definidos nos ficheiros *.yaml do diretório /data/hyps. Estimativas iniciais melhores produzem melhores resultados finais, por isso é importante inicializar estes valores corretamente antes da evolução. Se tiveres dúvidas, usa simplesmente os valores predefinidos, otimizados para treinar o YOLOv5 com COCO desde o início.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Definir a aptidão#
A aptidão é o valor que procuramos maximizar. No YOLOv5, definimos uma função de aptidão predefinida como uma combinação ponderada de métricas: mAP@0.5 representa 10% do peso e mAP@0.5:0.95 representa os 90% restantes, sem incluir a precisão (P) nem a sensibilidade (R). Podes ajustar estes valores como entenderes ou usar a definição de aptidão predefinida em utils/metrics.py (recomendado). Esta aptidão determina qual resultado é guardado em hyp_evolve.yaml; o próprio algoritmo genético classifica os progenitores e os indivíduos de elite apenas por mAP@0.5, por isso alterar estes pesos não afeta a seleção dos progenitores.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # pesos para [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Evoluir#
A evolução é realizada em relação a um cenário de base que procuramos melhorar. Neste exemplo, o cenário de base é o ajuste fino do COCO128 durante 10 épocas, usando o YOLOv5s pré-treinado. O comando de treino do cenário de base é:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cachePara evoluir os hiperparâmetros específicos deste cenário, começando pelos nossos valores iniciais definidos na Secção 1. e maximizando a aptidão definida na Secção 2., adiciona --evolve:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
As definições padrão de evolução executam 300 gerações, e cada geração treina o cenário de base uma vez para cada um dos 50 indivíduos da população. Podes modificar o número de gerações através do argumento --evolve, por exemplo, python train.py --evolve 1000.
Os principais operadores genéticos são o cruzamento e a mutação. Em cada geração, cada indivíduo é treinado e classificado por mAP@0.5; os pais são selecionados por seleção de torneio, com os indivíduos de elite mais aptos adicionados ao conjunto de pais; e a população seguinte é formada por cruzamento e mutação, com taxas que se adaptam à medida que a evolução avança. Os resultados são registados em runs/evolve/exp/evolve.csv, e o descendente com a maior aptidão é guardado a cada geração como runs/evolve/exp/hyp_evolve.yaml:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Recomendamos um mínimo de 300 gerações de evolução para obter os melhores resultados. Tem em conta que a evolução é geralmente dispendiosa e demorada, uma vez que o cenário de base é treinado milhares de vezes, podendo exigir centenas ou milhares de horas de GPU.
Quando a evolução terminar, reutiliza as definições descobertas indicando o ficheiro guardado no treino, por exemplo, python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Visualizar#
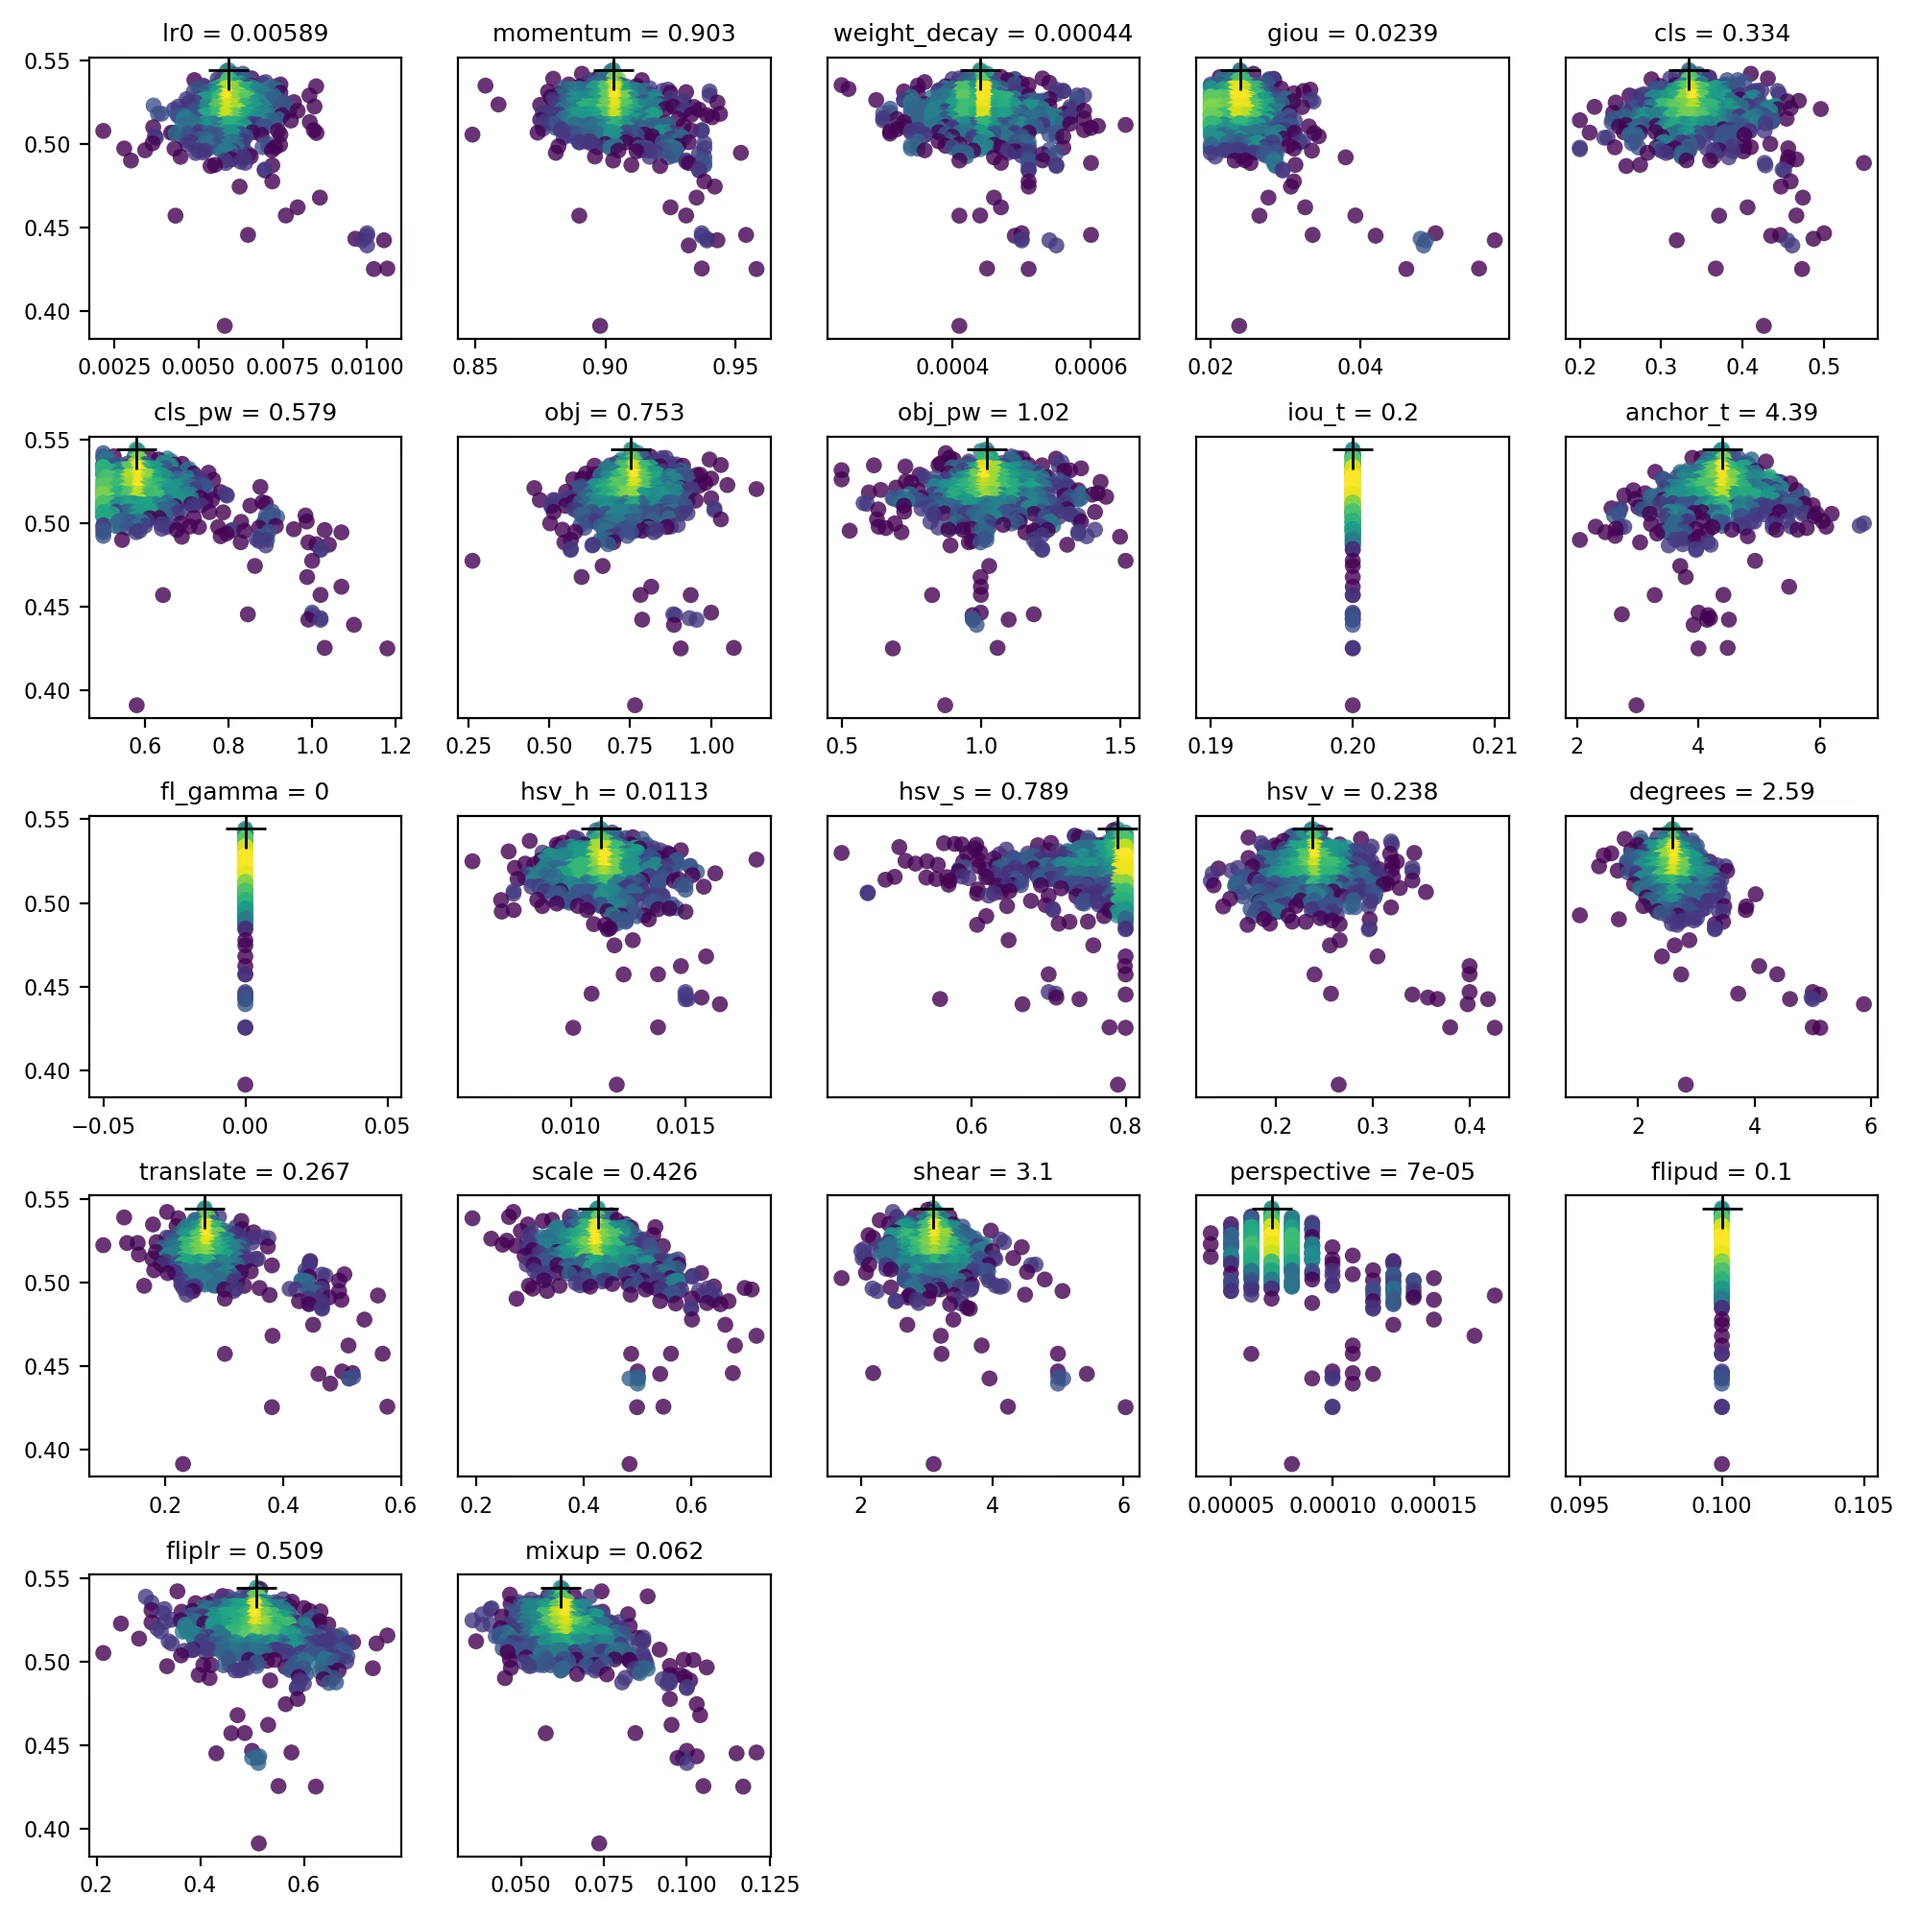
evolve.csv é representado graficamente como evolve.png por utils.plots.plot_evolve() após a conclusão da evolução, com um subplot por hiperparâmetro que mostra a aptidão (eixo y) em função dos valores do hiperparâmetro (eixo x). O amarelo indica concentrações mais elevadas. As distribuições verticais indicam que um parâmetro foi desativado e não sofre mutação. Esta opção pode ser selecionada pelo utilizador no dicionário meta em train.py e é útil para fixar parâmetros e impedir que evoluam.
Ambientes compatíveis#
A Ultralytics oferece uma variedade de ambientes prontos para uso, cada um com dependências essenciais pré-instaladas, como CUDA, CUDNN, Python e PyTorch, para você começar seus projetos.
- Notebooks gratuitos com GPU:


- Google Cloud: Guia de início rápido do GCP
- Amazon: Guia de início rápido da AWS
- Azure: Guia de início rápido do AzureML
- Docker: Guia de início rápido do Docker

Estado do projeto#

Este emblema indica que todos os testes de Integração contínua (CI) das GitHub Actions da YOLOv5 estão a passar. Estes testes de CI verificam rigorosamente a funcionalidade e o desempenho da YOLOv5 em vários aspetos importantes: treino, validação, inferência, exportação e avaliação de desempenho. Os testes garantem um funcionamento consistente e fiável em macOS, Windows e Ubuntu e são realizados a cada 24 horas e sempre que é criado um novo commit.
Perguntas frequentes#
Cada geração treina o cenário de base uma vez por indivíduo na população de 50 elementos; por isso, 300 gerações de uma execução do COCO128 com 10 épocas custam aproximadamente 15 000 vezes mais do que uma execução desse tipo. Mantém o cenário de base curto e representativo. O ciclo multi-GPU acima inicia uma pesquisa independente em cada GPU em vez de partilhar uma única pesquisa; por isso, reduz
--evolvepor processo se estiveres a trabalhar com um orçamento fixo.Sim.
--evolvetem como predefinição 300 gerações; passa um valor, como--evolve 1000, para executar mais.Define o primeiro valor da respetiva entrada no dicionário
metadetrain.pycomoFalse. Os parâmetros excluídos mantêm o valor inicial e aparecem como linhas verticais emevolve.png.Passa o ficheiro guardado a uma execução de treino normal:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.