Treine o YOLOv5 com dados personalizados#
Este guia explica como treinar o teu próprio conjunto de dados personalizado com o modelo YOLOv5. Treinar modelos personalizados é uma etapa fundamental para adaptar soluções de visão computacional a aplicações específicas do mundo real, para além da deteção de objetos genérica.
Antes de começar#
Primeiro, verifique se o ambiente necessário está configurado. Clone o repositório YOLOv5 e instale as dependências necessárias de requirements.txt. É essencial usar um ambiente com Python>=3.8.0 e PyTorch>=1.8. Os modelos e conjuntos de dados são baixados automaticamente da versão mais recente do YOLOv5 se não forem encontrados localmente.
git clone https://github.com/ultralytics/yolov5 # Clone the repository
cd yolov5
pip install -r requirements.txt # Install dependencies
Treinar com dados personalizados#
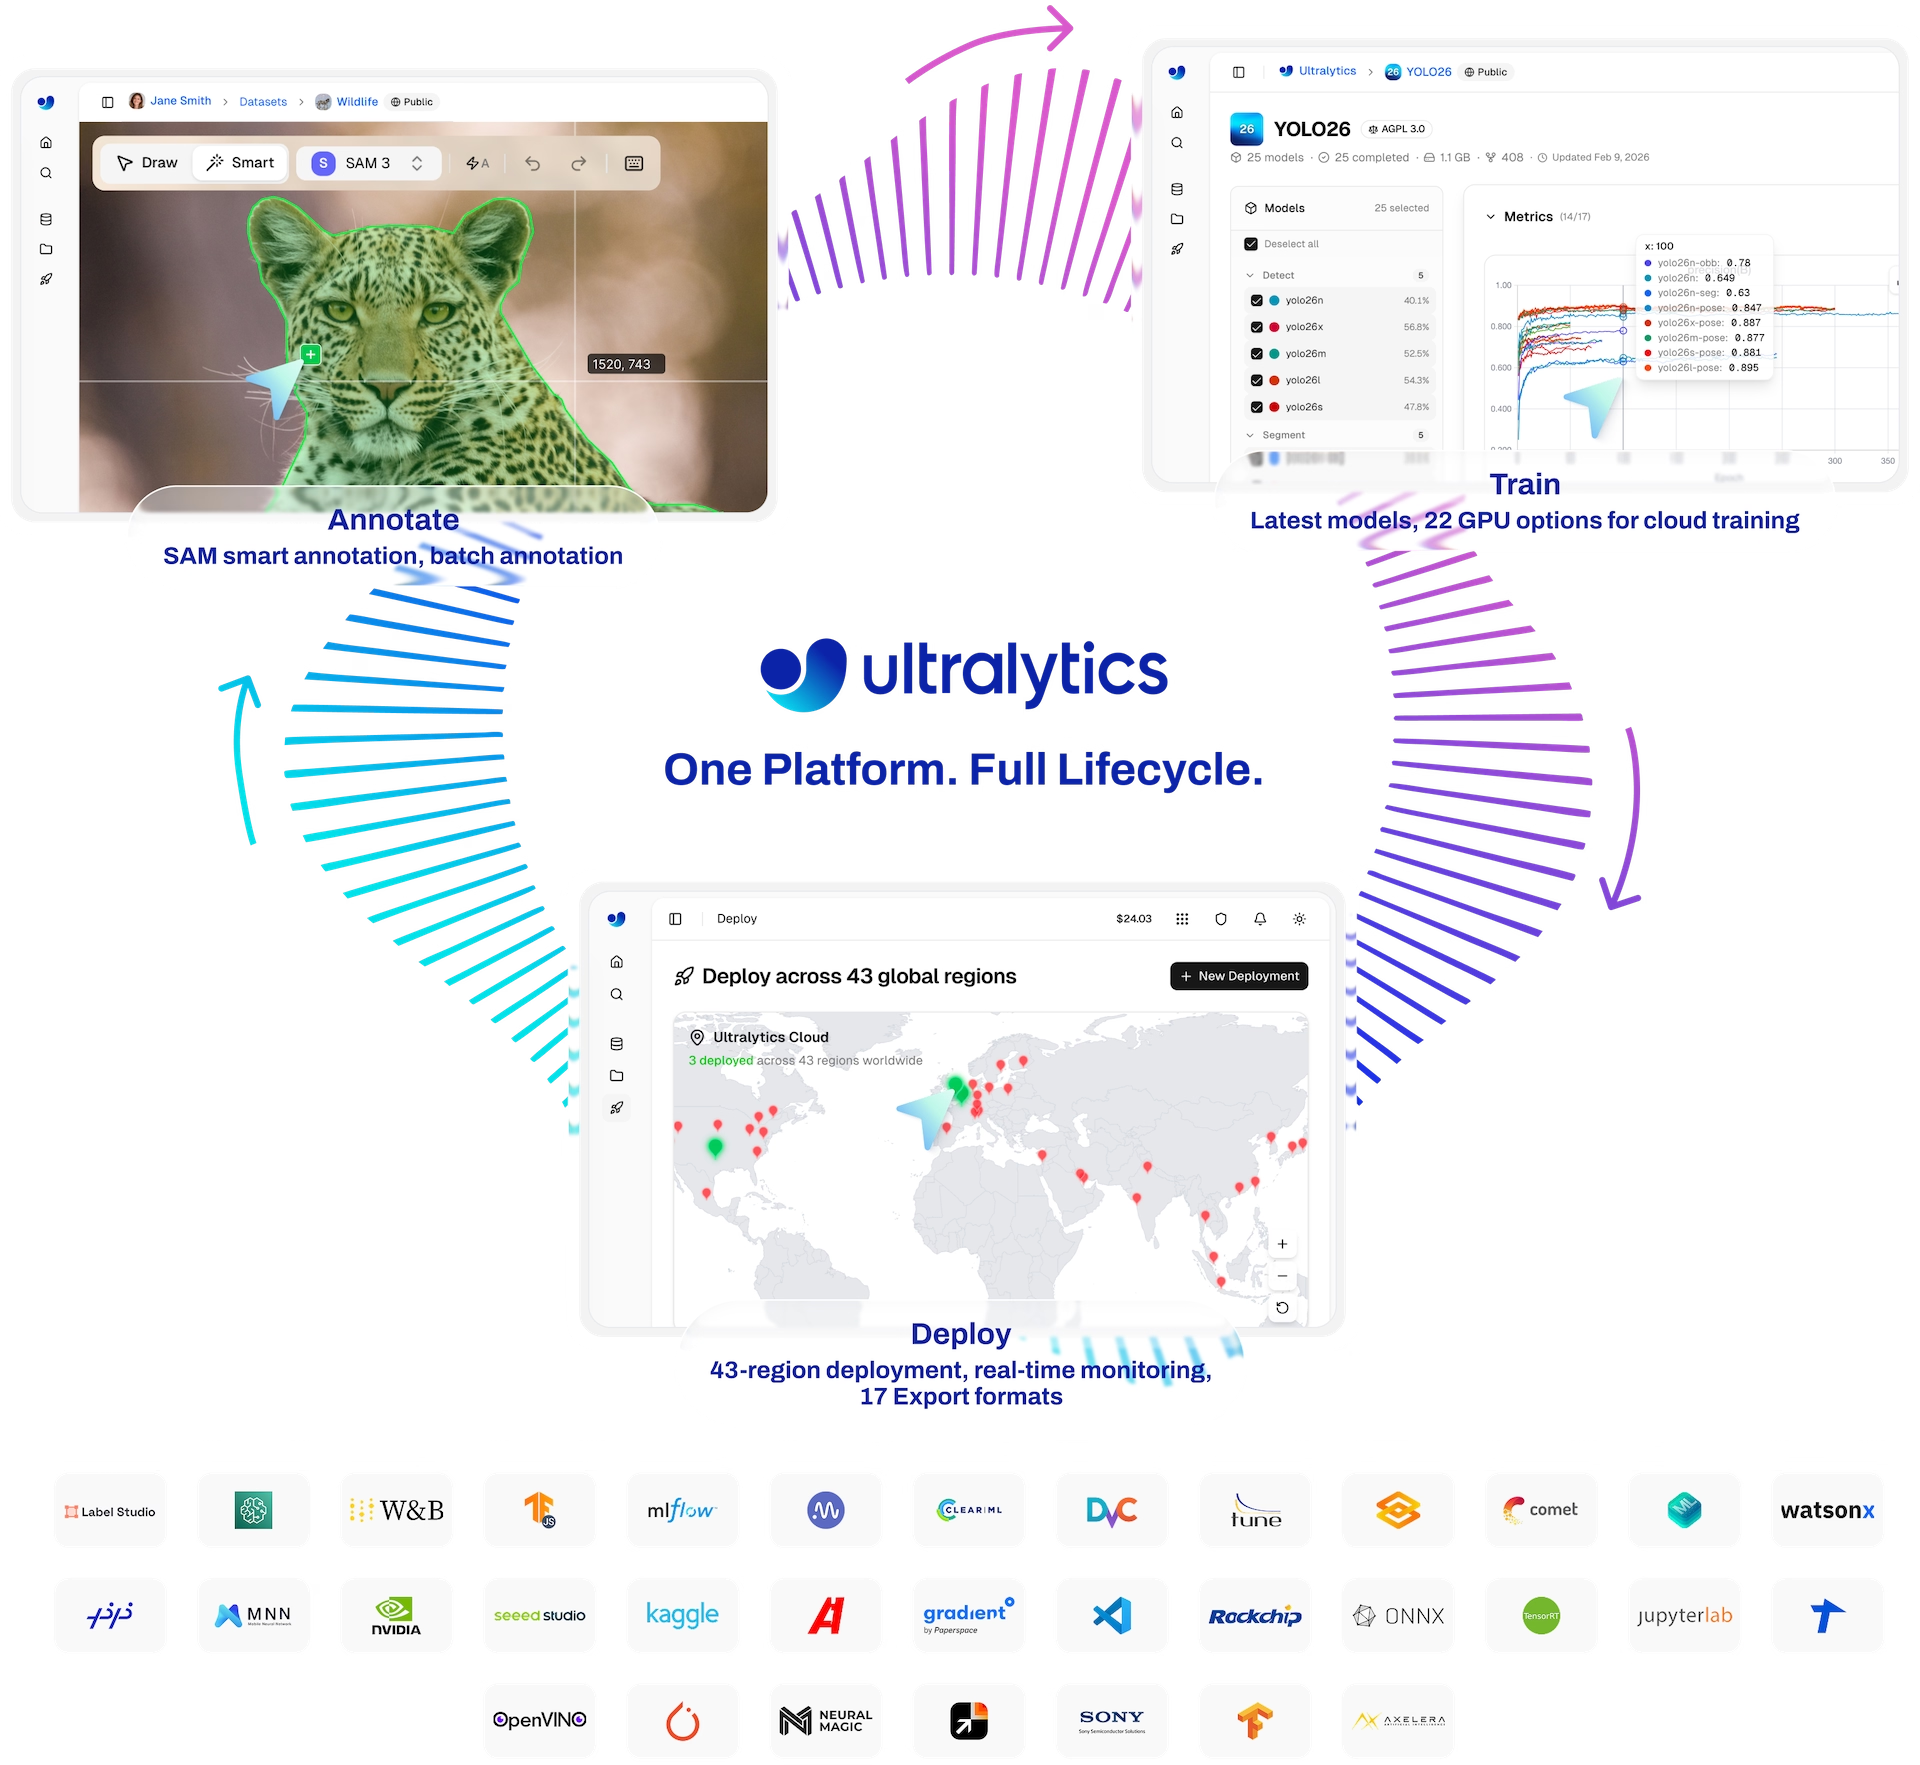
Desenvolver um modelo personalizado de detecção de objetos é um processo iterativo:
- Coletar e organizar imagens: reúna imagens relevantes para sua tarefa específica. Dados de alta qualidade e diversificados são essenciais. Consulte nosso guia sobre coleta e anotação de dados.
- Rotular objetos: anote com precisão os objetos de interesse nas imagens.
- Treinar um modelo: use os dados rotulados para treinar seu modelo YOLOv5. Aproveite o aprendizado por transferência, começando com pesos pré-treinados.
- Implementar e prever: utiliza o modelo treinado para fazer inferência em novos dados que ainda não foram vistos.
- Coletar casos extremos: identifique situações em que o modelo tem um desempenho ruim (casos extremos) e adicione dados semelhantes ao conjunto de dados para aumentar a robustez. Repita o ciclo.
A Ultralytics Platform oferece uma solução sem código para todo este ciclo de operações de aprendizagem automática (MLOps), incluindo a gestão de conjuntos de dados, o treino de modelos e a implementação.
A Ultralytics oferece duas opções de licença para atender a diferentes cenários de uso:
- Licença AGPL-3.0: esta licença de código aberto aprovada pela OSI é ideal para estudantes, pesquisadores e entusiastas que valorizam a colaboração aberta e o compartilhamento de conhecimento. Ela exige que trabalhos derivados sejam compartilhados sob a mesma licença. Consulte o arquivo LICENSE para ver todos os detalhes.
- Licença empresarial: para utilização em desenvolvimento e produção, esta licença permite integrar o software Ultralytics e os modelos de IA em produtos e serviços empresariais, incluindo ferramentas internas, fluxos de trabalho automatizados e implementações de produção, sem as obrigações de código aberto da AGPL-3.0. Para começar, contacta-nos através da Licenciamento Ultralytics.
Conheça melhor nossas opções de licenciamento na página Licenciamento da Ultralytics.
Antes de iniciar o treinamento, é essencial preparar o conjunto de dados.
1. Criar um conjunto de dados#
Os modelos YOLOv5 precisam de dados rotulados para aprender as características visuais das classes de objetos. Organizar corretamente o conjunto de dados é fundamental.
1.1 Criar dataset.yaml#
O arquivo de configuração do conjunto de dados (por exemplo, coco128.yaml) descreve a estrutura do conjunto de dados, os nomes das classes e os caminhos para os diretórios de imagens. COCO128 é um pequeno conjunto de dados de exemplo, composto pelas primeiras 128 imagens do extenso conjunto de dados COCO. Ele é útil para testar rapidamente o pipeline de treinamento e diagnosticar possíveis problemas, como sobreajuste.
A estrutura do arquivo dataset.yaml inclui:
path: o diretório raiz que contém o conjunto de dados.train,val,test: caminhos relativos depathpara diretórios que contêm imagens ou arquivos de texto com listas de caminhos de imagens dos conjuntos de treinamento, validação e teste.names: um dicionário que associa índices de classe (começando em 0) aos nomes de classe correspondentes.
Você pode definir path como um diretório absoluto (por exemplo, /home/user/datasets/coco128) ou como um caminho relativo, como ../datasets/coco128, ao iniciar o treinamento a partir do diretório raiz do repositório YOLOv5.
Abaixo está a estrutura de coco128.yaml (veja no GitHub):
# Dataset root directory relative to the yolov5 directory
path: ../datasets/coco128

# Train/val/test sets: specify directories, *.txt files, or lists
train: images/train2017 # 128 images for training
val: images/train2017 # 128 images for validation
test: # Optional path to test images

# Classes (example using 80 COCO classes)
names:
    0: person
    1: bicycle
    2: car
    # ... (remaining COCO classes)
    77: teddy bear
    78: hair drier
    79: toothbrush
1.2 Aproveitar modelos para rotulagem automatizada#
A rotulagem manual é a abordagem mais comum, mas consome muito tempo. Modelos de base podem automatizar ou semiautomatizar a anotação e acelerar a criação de conjuntos de dados. Veja alguns exemplos de modelos que podem ajudar a gerar rótulos:
- Google Gemini: os grandes modelos multimodais, como Gemini, têm fortes capacidades de compreensão de imagens. Podem receber instruções para identificar e localizar objetos em imagens, gerando caixas delimitadoras ou descrições que podem ser convertidas em etiquetas no formato YOLO, como demonstrado no notebook do tutorial associado. O quadro de classificação VLM da Ultralytics compara a precisão com que Gemini e outros modelos de linguagem e visão anotam automaticamente conjuntos de dados de deteção do mundo real.
- SAM2 (Modelo Segment Anything 2): modelos de base voltados à segmentação, como o SAM2, conseguem identificar e delinear objetos com alta precisão. Embora sejam usados principalmente para segmentação, as máscaras resultantes muitas vezes podem ser convertidas em anotações de caixas delimitadoras adequadas para tarefas de detecção de objetos.
- YOLO-World: este modelo oferece capacidades de deteção com vocabulário aberto. Podes fornecer descrições textuais dos objetos que te interessam, e YOLO-World consegue localizá-los em imagens sem ter sido previamente treinado nessas classes específicas. Isto pode servir de ponto de partida para gerar etiquetas iniciais, que podem depois ser aperfeiçoadas.
A utilização destes modelos pode proporcionar uma etapa de «pré-etiquetagem», reduzindo o trabalho manual necessário. A Anotação Inteligente da Ultralytics Platform oferece pré-etiquetagem com SAM, YOLO e modelos de linguagem e visão no navegador, sem código. No entanto, é essencial rever e aperfeiçoar as etiquetas geradas automaticamente para garantir a precisão e a consistência, uma vez que a qualidade afeta diretamente o desempenho do modelo YOLOv5 treinado. Depois de gerares (e, se necessário, aperfeiçoares) as etiquetas, certifica-te de que cumprem o formato YOLO: um ficheiro *.txt por imagem, com cada linha a representar um objeto como class_index x_center y_center width height (coordenadas normalizadas, classe indexada a partir de zero). Se uma imagem não tiver objetos de interesse, não é necessário um ficheiro *.txt correspondente.
As especificações dos arquivos *.txt no formato YOLO são precisas:
- Uma linha por caixa delimitadora.
- Cada linha deve conter:
class_index x_center y_center width height. - As coordenadas devem ser normalizadas para um intervalo entre 0 e 1. Para isso, divida os valores em pixels de
x_centerewidthpela largura total da imagem e dividay_centereheightpela altura total da imagem. - Os índices das classes começam em zero (ou seja, a primeira classe é representada por
0, a segunda por1e assim por diante).
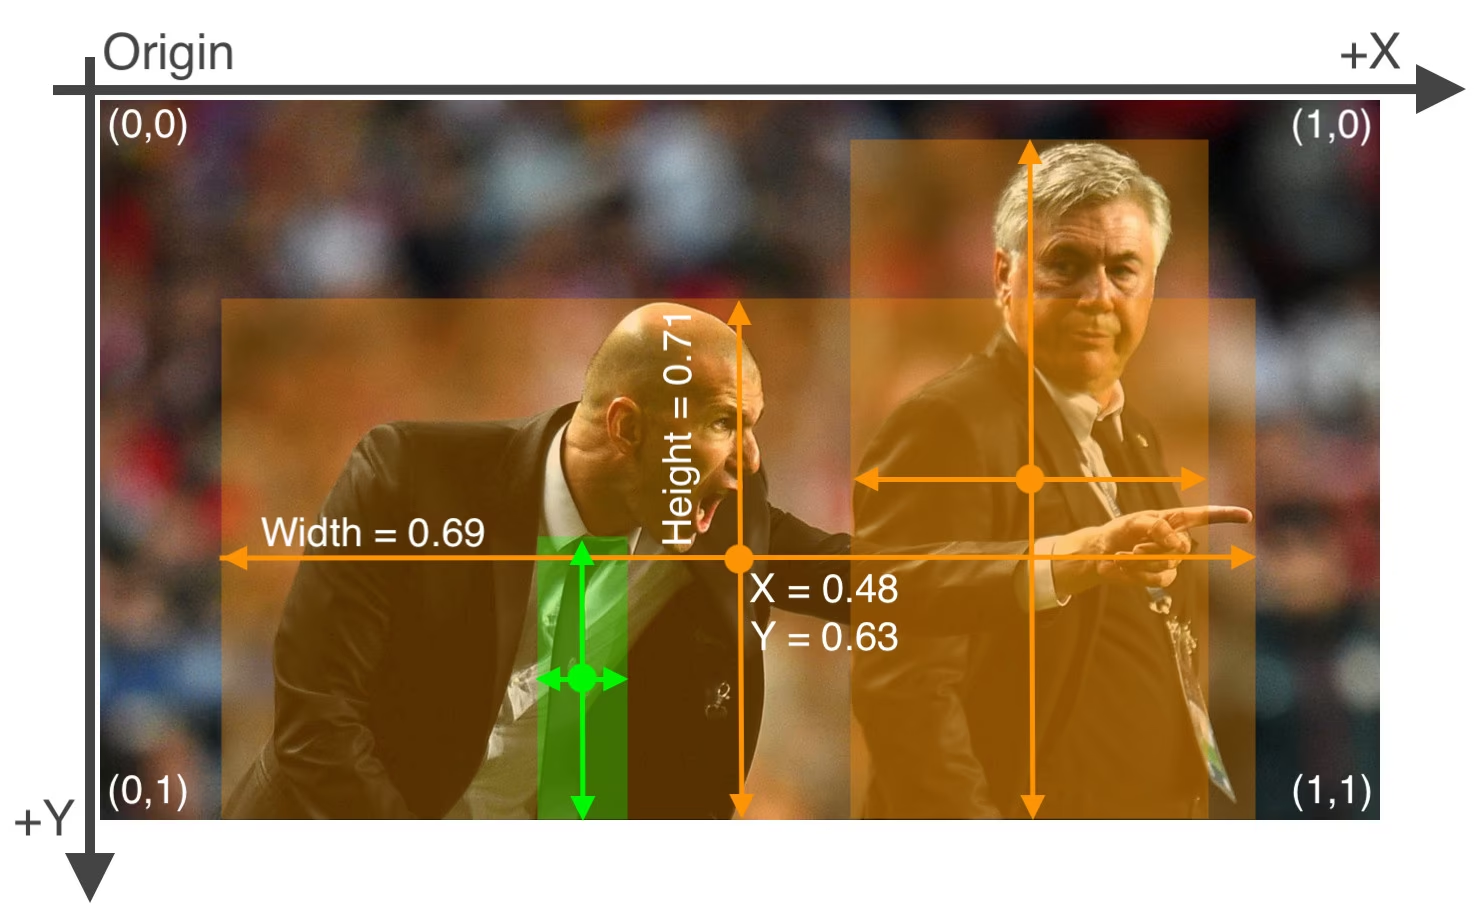
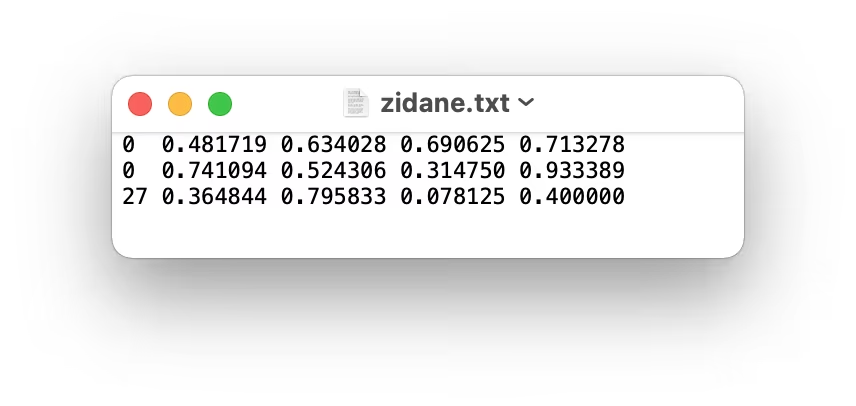
O arquivo de rótulos correspondente à imagem acima, com dois objetos 'person' (índice de classe 0) e um objeto 'tie' (índice de classe 27), ficaria assim:
1.3 Organizar diretórios#
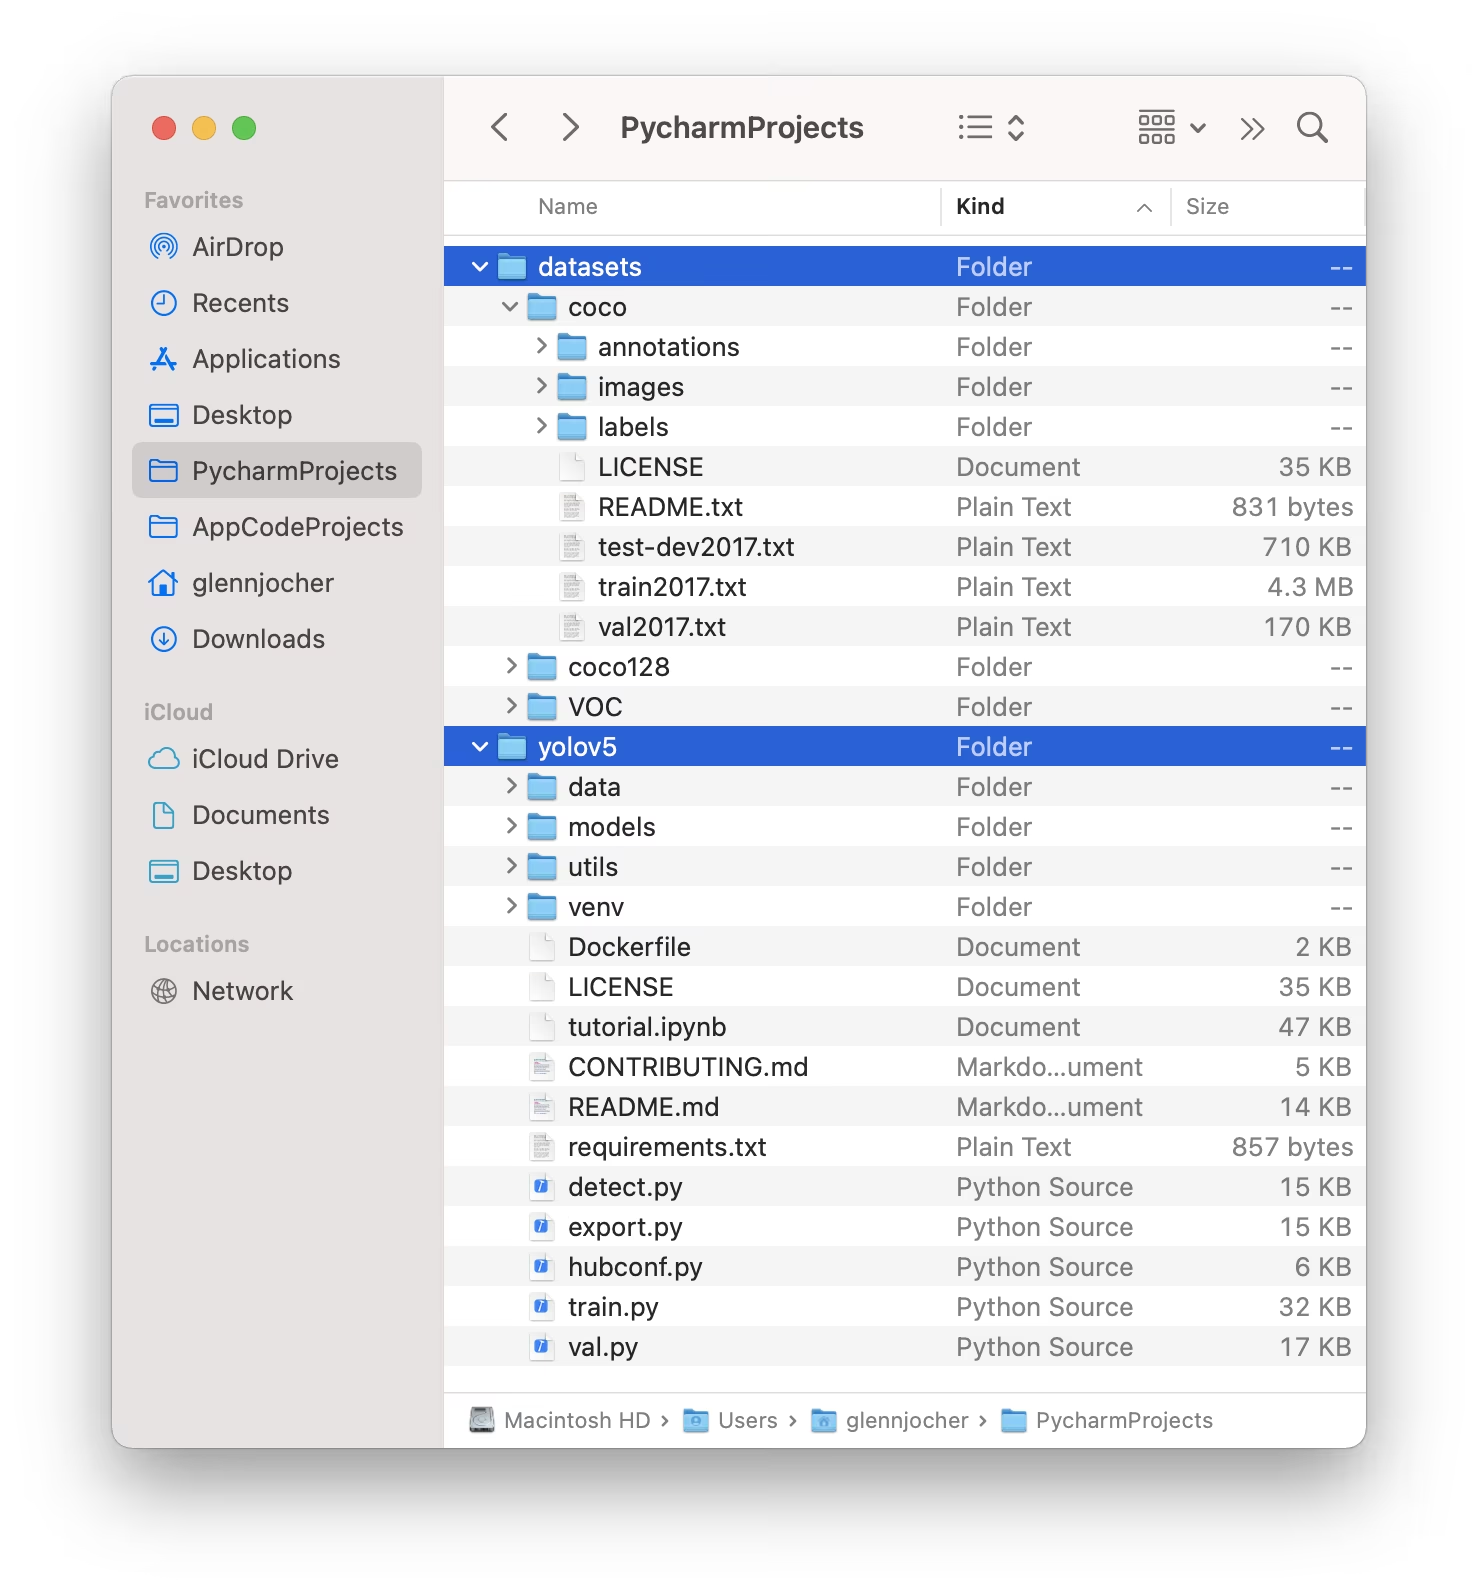
Organiza o diretório dos teus conjuntos de dados como ilustrado abaixo. Por predefinição, YOLOv5 espera que o diretório do conjunto de dados (por exemplo, /coco128) esteja dentro de uma pasta /datasets localizada ao lado do diretório do repositório /yolov5.
O YOLOv5 localiza automaticamente os rótulos de cada imagem substituindo a última ocorrência de /images/ no caminho da imagem por /labels/. Por exemplo:
../datasets/coco128/images/im0.jpg # Path to the image file
../datasets/coco128/labels/im0.txt # Path to the corresponding label file
A estrutura de diretórios recomendada é:
/datasets/
└── coco128/  # Dataset root
    ├── images/
    │   ├── train2017/  # Training images
    │   │   ├── 000000000009.jpg
    │   │   └── ...
    │   └── val2017/    # Validation images (optional if using same set for train/val)
    │       └── ...
    └── labels/
        ├── train2017/  # Training labels
        │   ├── 000000000009.txt
        │   └── ...
        └── val2017/    # Validation labels (optional if using same set for train/val)
            └── ...
2. Selecionar um modelo#
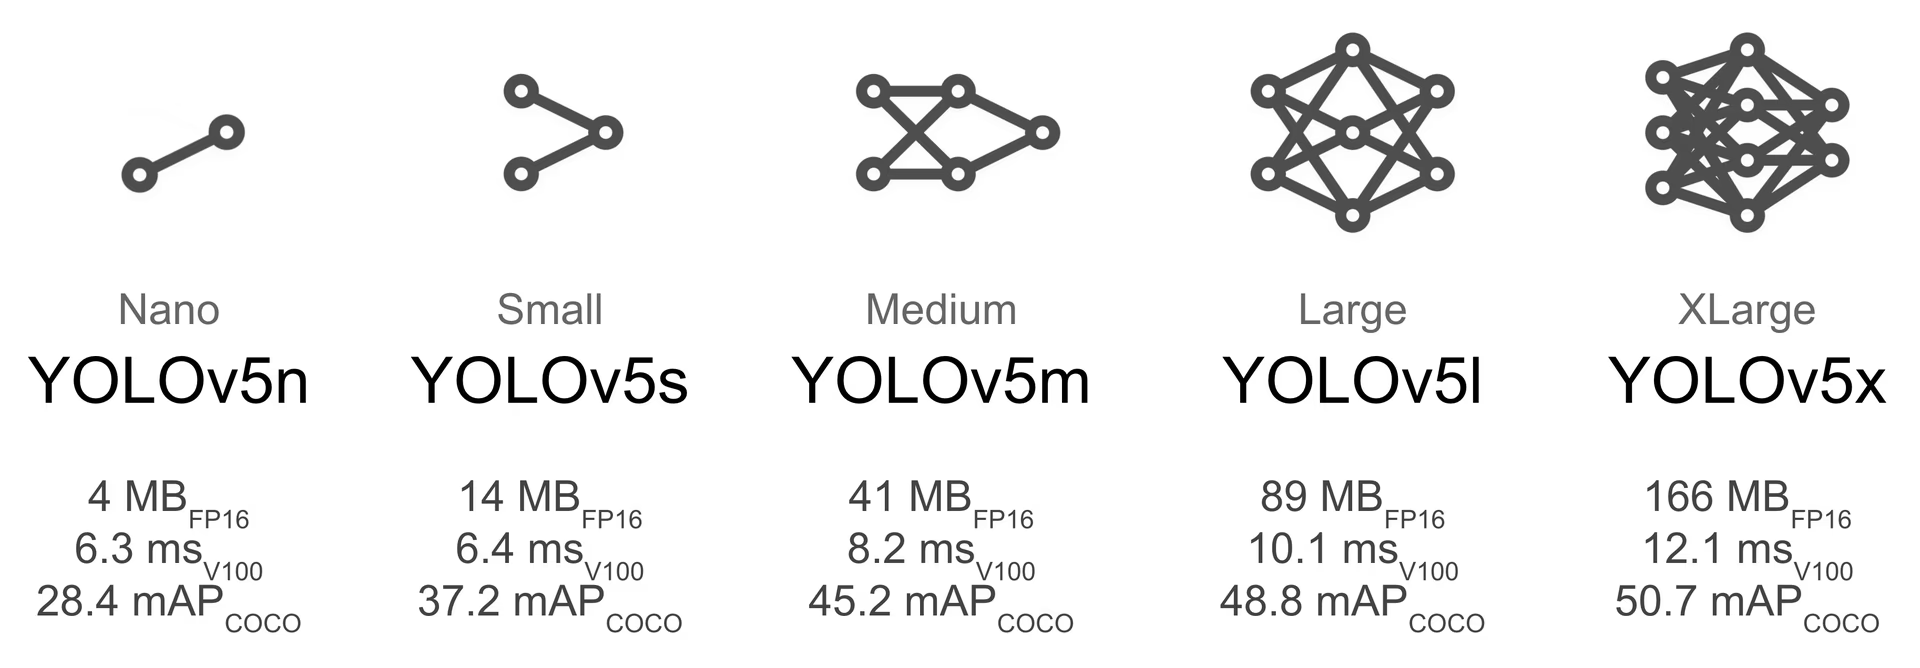
Escolhe um modelo pré-treinado para iniciar o processo de treino. Começar com pesos pré-treinados acelera significativamente a aprendizagem e melhora o desempenho em comparação com o treino do zero. YOLOv5 oferece vários tamanhos de modelo, cada um com um equilíbrio diferente entre velocidade e precisão. Por exemplo, YOLOv5s é o segundo modelo mais pequeno e o segundo mais rápido, sendo adequado para ambientes com recursos limitados.
3. Treinar#
Inicie o treinamento do modelo com o script train.py. Os argumentos essenciais incluem:
--img: define o tamanho da imagem de entrada (por exemplo,--img 640). Tamanhos maiores geralmente proporcionam mais precisão, mas exigem mais memória da GPU.--batch: determina o tamanho do lote (por exemplo,--batch 16). Escolha o maior tamanho que sua GPU consegue suportar.--epochs: especifica o número total de épocas de treinamento (por exemplo,--epochs 100). Uma época corresponde a uma passagem completa por todo o conjunto de dados de treinamento.--data: caminho para seu arquivodataset.yaml(por exemplo,--data coco128.yaml).--weights: caminho para o ficheiro de pesos iniciais. Recomenda-se utilizar pesos pré-treinados (por exemplo,--weights yolov5s.pt) para obter uma convergência mais rápida e melhores resultados. Para treinar do zero (não recomendado, a menos que tenhas um conjunto de dados muito grande e necessidades específicas), utiliza--weights '' --cfg yolov5s.yaml.
Os pesos pré-treinados são baixados automaticamente da versão mais recente do YOLOv5 se não forem encontrados localmente.
# Example: Train YOLOv5s on the COCO128 dataset for 3 epochs
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.ptUtiliza --cache ram ou --cache disk para colocar em cache as imagens do conjunto de dados na RAM ou no disco local, respetivamente. Isto pode acelerar significativamente o treino, sobretudo quando as operações de E/S (entrada/saída) do conjunto de dados são um estrangulamento. Tem em conta que isto exige bastante RAM ou espaço em disco.
Treina sempre com conjuntos de dados armazenados localmente. Aceder a dados em unidades de rede (como o Google Drive) ou num armazenamento remoto pode ser significativamente mais lento e prejudicar o desempenho do treino. Copiar o conjunto de dados para um SSD local é, muitas vezes, a melhor prática.
Todos os resultados do treinamento, incluindo pesos e logs, são salvos no diretório runs/train/. Cada sessão de treinamento cria um novo subdiretório (por exemplo, runs/train/exp, runs/train/exp2 etc.). Para uma experiência interativa e prática, explore a seção de treinamento nos nossos notebooks de tutorial oficiais: 

4. Visualizar#
YOLOv5 integra-se com várias ferramentas para visualizar o progresso do treino, avaliar resultados e monitorizar o desempenho em tempo real.
Registro e visualização com Comet#
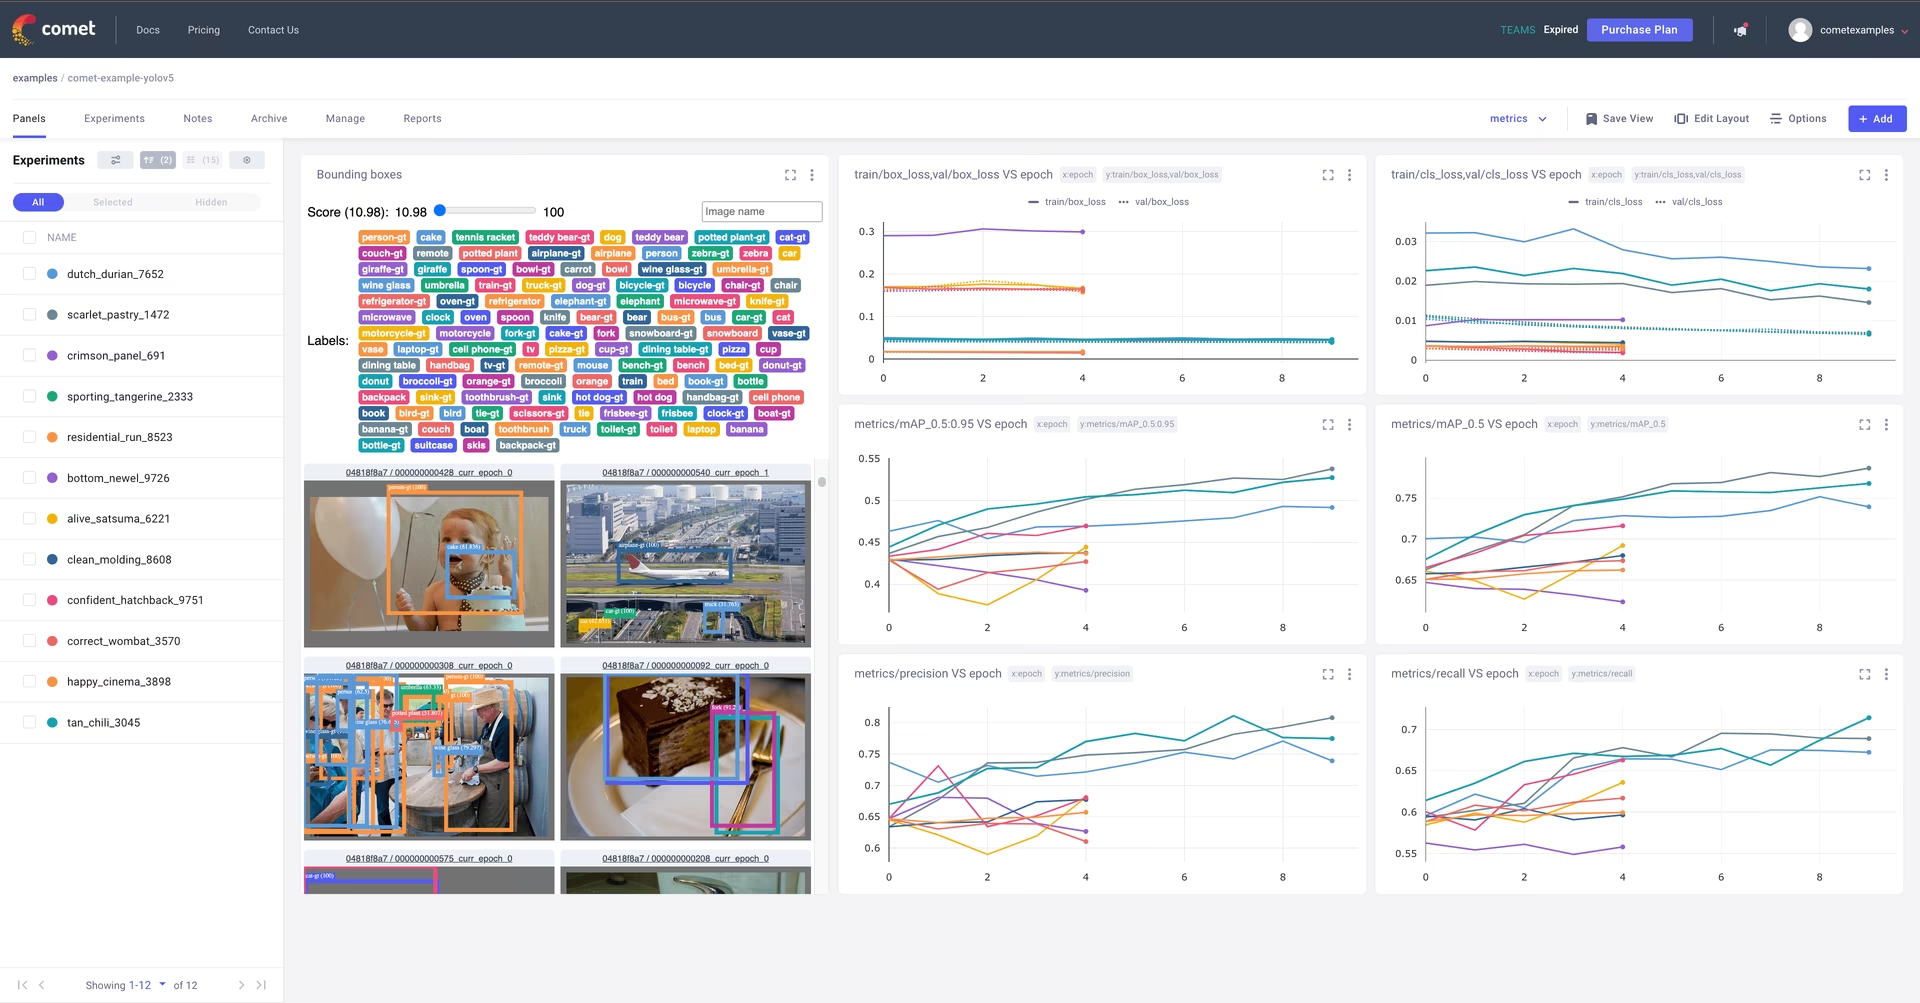
Comet está integrado para permitir o acompanhamento de experiências completo. Visualiza métricas em direto, guarda hiperparâmetros, gere conjuntos de dados e pontos de controlo do modelo e analisa previsões do modelo através dos painéis personalizados do Comet interativos.
É fácil começar:
pip install comet_ml                                                          # 1. Install Comet library
export COMET_API_KEY=YOUR_API_KEY_HERE                                        # 2. Set your Comet API key (create a free account at Comet.ml)
python train.py --img 640 --epochs 3 --data coco128.yaml --weights yolov5s.pt # 3. Train your model - Comet automatically logs everything!
Experimente o Notebook do Comet para Colab para ver uma demonstração ao vivo:
Registro e automação com ClearML#
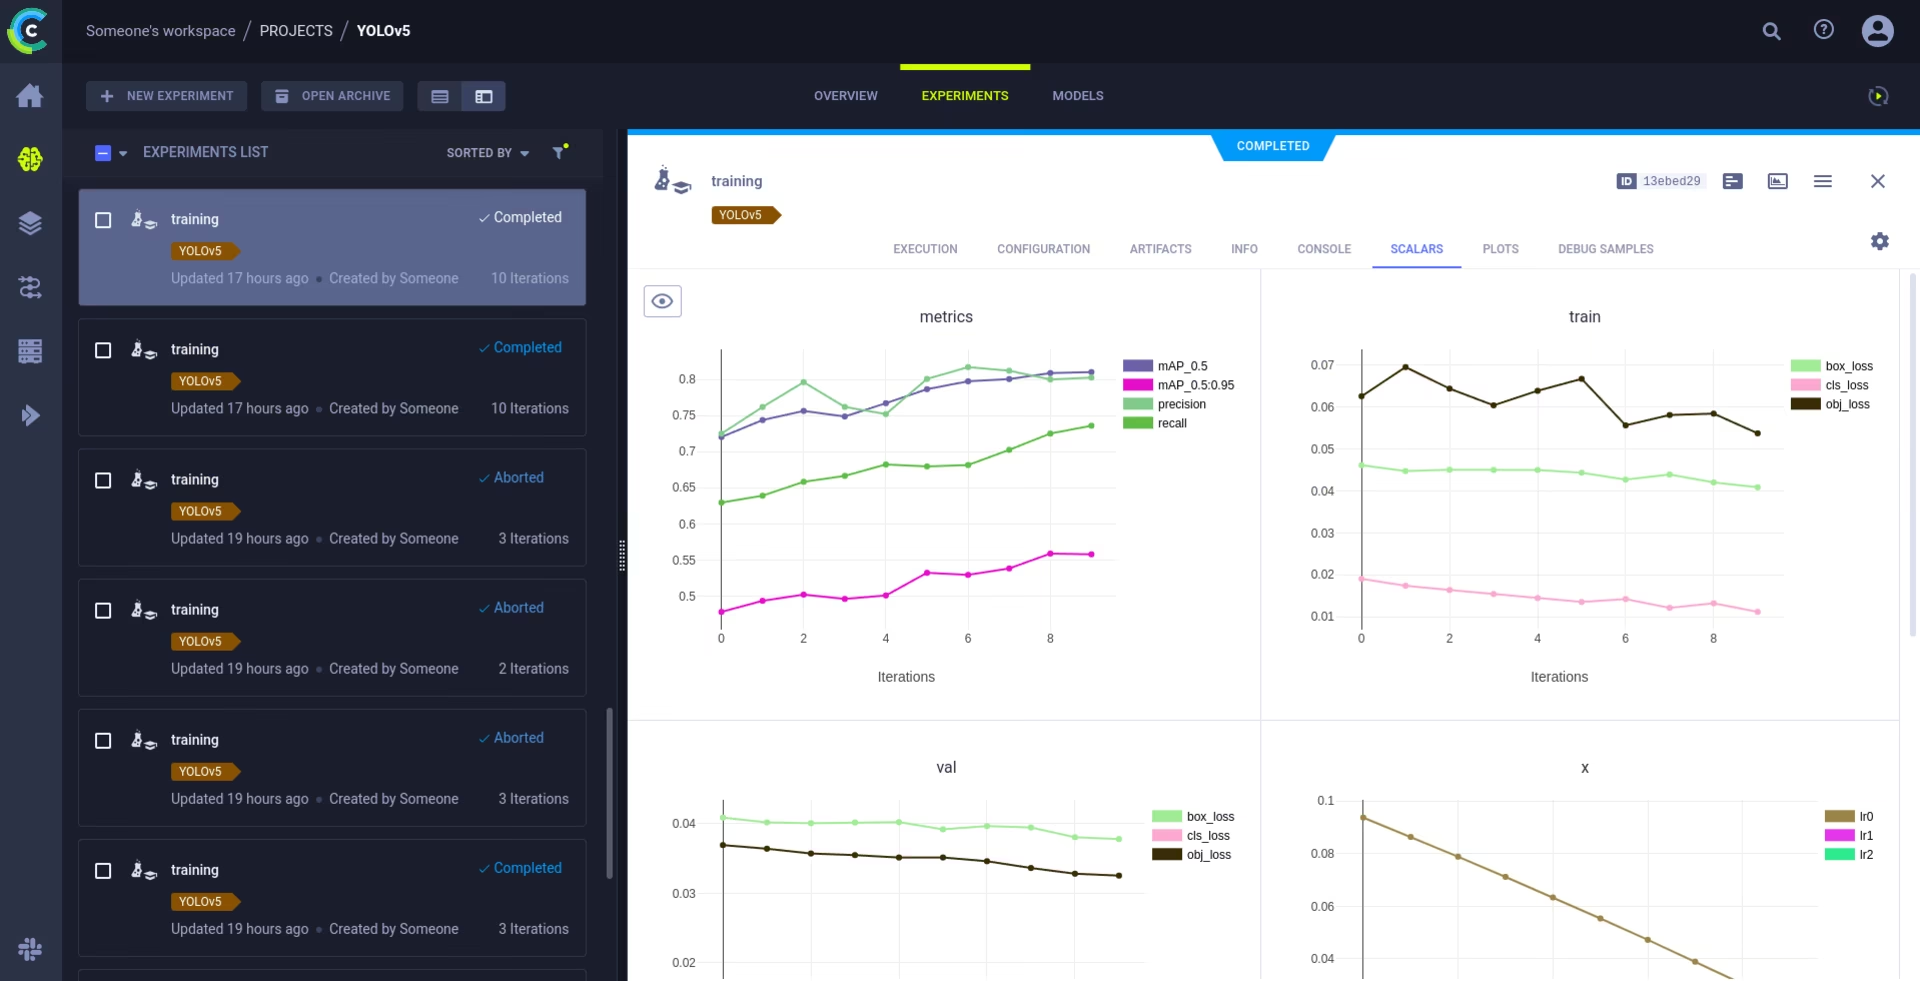
A integração com ClearML permite um acompanhamento detalhado de experiências, a gestão de versões de conjuntos de dados e até a execução remota de tarefas de treino. Ativa ClearML com estes passos:
- Instale o pacote:
pip install clearml - Inicialize o ClearML: execute
clearml-inituma vez para se conectar ao servidor ClearML (auto-hospedado ou no plano gratuito).
ClearML regista automaticamente os detalhes das experiências, os carregamentos de modelos, as comparações, as alterações não consolidadas ao código e os pacotes instalados, garantindo a reprodutibilidade total. Podes agendar tarefas de treino em agentes remotos e gerir versões de conjuntos de dados com ClearML Data.
Registro local#
Os resultados do treinamento são registrados automaticamente usando o TensorBoard e salvos como arquivos CSV no diretório do experimento correspondente (por exemplo, runs/train/exp). Os dados registrados incluem:
- Perda e métricas de desempenho do treinamento e da validação.
- Imagens de amostra mostrando as transformações aplicadas (como mosaicos).
- Rótulos de referência junto com as previsões do modelo para inspeção visual.
- Métricas de avaliação importantes, como curvas de precisão-revocação (PR).
- Matrizes de confusão para uma análise detalhada do desempenho por classe.
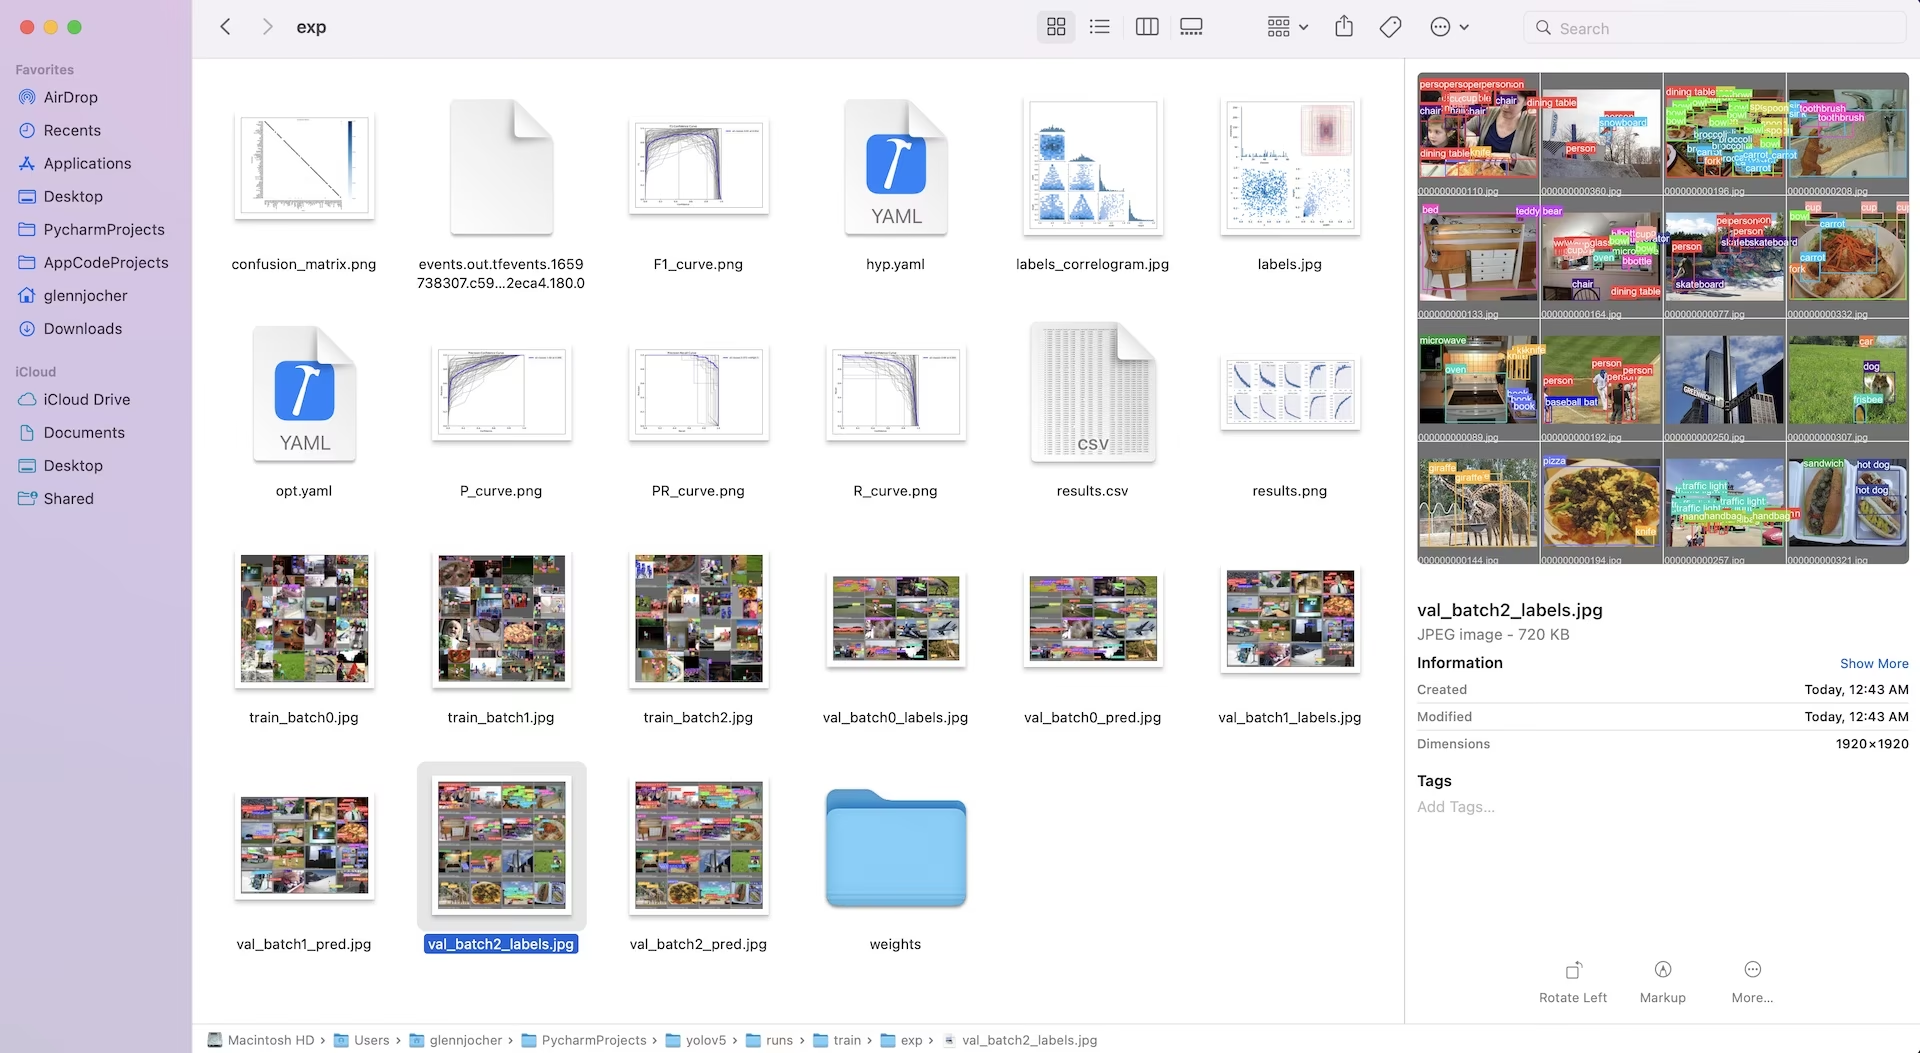
O arquivo results.csv é atualizado após cada época e, ao fim do treinamento, é plotado como results.png. Você também pode plotar manualmente qualquer arquivo results.csv usando a função utilitária fornecida:
from utils.plots import plot_results

# Plotar resultados de um diretório específico de execução do treinamento
plot_results("runs/train/exp/results.csv")  # Isso vai gerar 'results.png' no mesmo diretório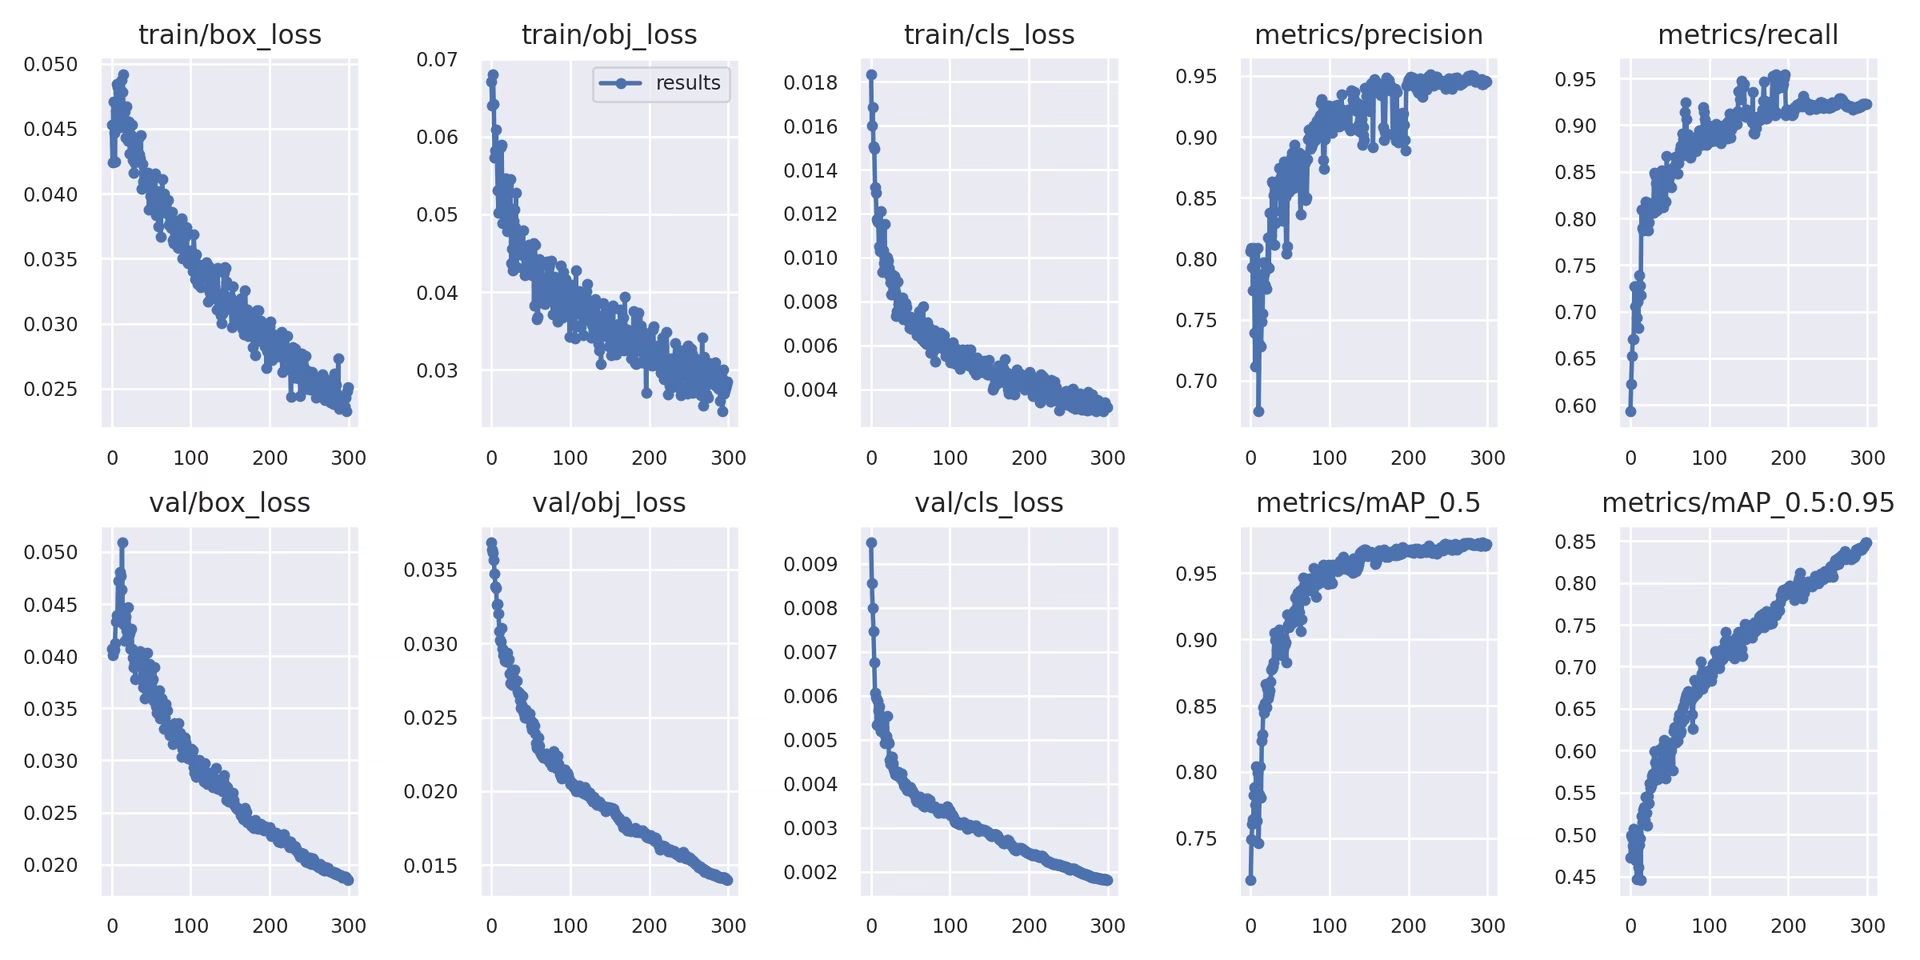
5. Próximas etapas#
Após a conclusão bem-sucedida do treinamento, o checkpoint do modelo com melhor desempenho (best.pt) é salvo e fica pronto para implantação ou refinamento adicional. Algumas próximas etapas possíveis:
- Execute a inferência em novas imagens ou vídeos usando o modelo treinado por meio da CLI ou do Python.
- Execute
val.pypara avaliar a precisão e a capacidade de generalização do modelo em diferentes divisões dos dados (por exemplo, um conjunto de teste separado). - Exporte o modelo para vários formatos de implantação, como ONNX, TensorFlow SavedModel ou TensorRT, para obter inferência otimizada em diversas plataformas.
- Use a evolução de hiperparâmetros para tentar obter ganhos adicionais de desempenho.
- Continue aprimorando seu modelo seguindo nossas dicas para obter os melhores resultados de treinamento e adicionando iterativamente dados mais diversificados e desafiadores com base na análise de desempenho.
Ambientes compatíveis#
A Ultralytics oferece ambientes prontos para uso, equipados com dependências essenciais como CUDA, cuDNN, Python e PyTorch, para facilitar o início.
- Notebooks gratuitos com GPU:
- Plataformas na nuvem:
- Google Cloud: Guia de início rápido do GCP
- Amazon AWS: Guia de início rápido do AWS
- Microsoft Azure: Guia de início rápido do AzureML
- Configuração local:
- Docker: Guia de início rápido do Docker
- Docker: Guia de início rápido do Docker


Estado do projeto#

Este emblema indica que todos os testes de integração contínua (CI) das GitHub Actions do YOLOv5 foram concluídos com êxito. Estes testes de CI abrangem as funcionalidades principais, incluindo treino, validação, inferência, exportação e benchmarks, nos sistemas operativos macOS, Windows e Ubuntu. Os testes são executados automaticamente a cada 24 horas e após cada confirmação de código.
Perguntas frequentes#
Treinar o YOLOv5 em um conjunto de dados personalizado envolve várias etapas importantes:
- Prepara o teu conjunto de dados: reúne imagens e anota-as. Certifica-te de que as anotações estão no formato YOLO exigido. Organiza as imagens e as etiquetas nos diretórios
train/eval/(e, opcionalmente,test/). Considera utilizar modelos como Google Gemini, SAM2 ou YOLO-World para auxiliar ou automatizar o processo de etiquetagem (consulta a secção 1.2). - Configure seu ambiente: clone o repositório do YOLOv5 e instale as dependências usando
pip install -r requirements.txt.git clone https://github.com/ultralytics/yolov5 cd yolov5 pip install -r requirements.txt - Crie a configuração do conjunto de dados: defina os caminhos do conjunto de dados, o número de classes e os nomes das classes em um arquivo
dataset.yaml. - Inicie o treinamento: execute o script
train.py, informando os caminhos para seudataset.yaml, os pesos pré-treinados desejados (por exemplo,yolov5s.pt), o tamanho da imagem, o tamanho do lote e o número de épocas.python train.py --img 640 --batch 16 --epochs 100 --data path/to/your/dataset.yaml --weights yolov5s.pt
- Prepara o teu conjunto de dados: reúne imagens e anota-as. Certifica-te de que as anotações estão no formato YOLO exigido. Organiza as imagens e as etiquetas nos diretórios
A Ultralytics Platform abrange todo o ciclo de vida do desenvolvimento de modelos YOLO, muitas vezes sem necessidade de escrever código. Entre as principais vantagens estão:
- Treino simplificado: treina modelos em ambientes na nuvem pré-configurados através de uma interface Web.
- Gestão integrada de dados: carrega, cria versões e gere os teus conjuntos de dados na plataforma.
- Monitoramento em tempo real: acompanhe o progresso do treinamento e visualize as métricas de desempenho à medida que chegam.
- Recursos de colaboração: facilite o trabalho em equipe com recursos compartilhados, ferramentas de gerenciamento de projetos e compartilhamento fácil de modelos.
- Implantação sem código: implante os modelos treinados diretamente em vários destinos.
Para ver um passo a passo prático, confira nossa publicação no blog: Como treinar seus modelos personalizados com a Ultralytics Platform.
Quer você faça as anotações manualmente ou use ferramentas automatizadas (como as mencionadas na Seção 1.2), os rótulos finais devem estar no formato YOLO específico exigido pelo YOLOv5:
- Crie um arquivo
.txtpara cada imagem. O nome do arquivo deve corresponder ao nome da imagem (por exemplo,image1.jpgcorresponde aimage1.txt). Coloque esses arquivos em um diretóriolabels/, paralelo ao diretórioimages/(por exemplo,../datasets/mydataset/labels/train/). - Cada linha de um arquivo
.txtrepresenta uma anotação de objeto e segue o formato:class_index center_x center_y width height. - As coordenadas (
center_x,center_y,width,height) devem ser normalizadas (valores entre 0.0 e 1.0) em relação às dimensões da imagem. - Os índices das classes começam em zero (a primeira classe é
0, a segunda é1etc.).
Muitas ferramentas de anotação manual oferecem exportação direta para o formato YOLO. Se você usar modelos automatizados, precisará de scripts ou processos para converter os resultados (por exemplo, coordenadas de caixas delimitadoras, máscaras de segmentação) para esse formato de texto normalizado específico. Garanta que a estrutura final do conjunto de dados siga o exemplo fornecido no guia. Para saber mais, consulte nosso Guia de coleta e anotação de dados.
- Crie um arquivo
A Ultralytics oferece licenças flexíveis, adaptadas a diferentes necessidades:
- Licença AGPL-3.0: esta licença de código aberto é adequada para pesquisas acadêmicas, projetos pessoais e situações em que o cumprimento das obrigações de código aberto é aceitável. Ela exige que as modificações e obras derivadas também sejam disponibilizadas sob a AGPL-3.0. Consulte os detalhes da licença AGPL-3.0.
- Licença Enterprise: uma licença comercial destinada a empresas que integram o YOLOv5 a produtos ou serviços proprietários. Essa licença elimina as obrigações de código aberto da AGPL-3.0, permitindo a distribuição de código fechado. Acesse nossa página de licenciamento para saber mais ou solicitar uma Licença Enterprise.
Escolha a licença que melhor se alinhe às necessidades e ao modelo de distribuição do seu projeto.
Comentários
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.