Integração com ClearML#

Sobre o ClearML#
ClearML é uma plataforma de MLOps de código aberto, criada para simplificar os fluxos de trabalho de aprendizado de máquina e economizar tempo de engenharia.
- 🔨 Acompanha cada execução de treinamento do YOLOv5 no gerenciador de experimentos.
- 🔧 Versiona e acessa os teus dados de treinamento personalizados com a ferramenta de versionamento de dados integrada do ClearML.
- 🔦 Treina e monitora remotamente as execuções do YOLOv5 usando o ClearML Agent.
- 🔬 Encontra o melhor mAP com a otimização de hiperparâmetros do ClearML.
- 🔭 Transforma o teu modelo YOLOv5 treinado em uma API com alguns comandos usando o ClearML Serving.
Usa quantas dessas ferramentas quiseres — começa apenas com o gerenciador de experimentos ou encadeia tudo num fluxo completo.
🦾 Configuração inicial#
O ClearML precisa se comunicar com um servidor para acompanhar os teus experimentos e dados. Tens duas opções:
- Inscreve-te no serviço hospedado gratuito do ClearML, ou
- Implanta o teu próprio servidor ClearML — ele é de código aberto, por isso continua sendo uma opção viável até para dados confidenciais.
Em seguida, instala o pacote Python clearml e conecta o SDK ao teu servidor:
pip install clearmlGera as credenciais em Configurações → Espaço de trabalho → Criar novas credenciais (no canto superior direito da interface do ClearML) e, em seguida, executa:
clearml-initSegue as instruções. Pronto — a configuração está concluída.
🚀 Treinar YOLOv5 com ClearML#
Para ativar o acompanhamento de experimentos, instala o pacote pip do ClearML, caso ainda não o tenhas instalado:
pip install clearmlIsso ativará a integração com o script de treinamento do YOLOv5. A partir de agora, todas as execuções de treinamento serão registradas e armazenadas pelo gerenciador de experimentos do ClearML.
Para personalizar os nomes do projeto e da tarefa, passa --project e --name para train.py. Os padrões são YOLOv5 e Training. O ClearML usa / como delimitador de subprojeto, por isso evita / nos nomes personalizados dos projetos.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheOu usa nomes personalizados:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheCada execução registra:
- Código-fonte e alterações não confirmadas
- Pacotes instalados
- Hiperparâmetros
- Checkpoints do modelo (usa
--save-period npara salvar a cadanépocas) - Saída do console
- Valores escalares (mAP_0.5, mAP_0.5:0.95, precisão, revocação, perdas, taxas de aprendizado)
- Detalhes da máquina, tempo de execução e data de criação
- Gráficos gerados, como o correlograma de rótulos e a matriz de confusão
- Imagens com caixas delimitadoras por época
- Visualizações de mosaicos por época
- Imagens de validação por época
Tudo aparece na interface do ClearML para que possas monitorar o treinamento num só lugar. Adiciona colunas personalizadas (por exemplo, mAP_0.5) para ordenar pelo modelo com melhor desempenho ou seleciona vários experimentos para compará-los lado a lado.
Continua lendo para saber mais sobre otimização de hiperparâmetros e execução remota.
🔗 Gerenciamento de versões de conjuntos de dados#
Versionar os dados separadamente do código facilita obter a versão mais recente e garante a reprodutibilidade completa. Este repositório aceita um ID de versão do conjunto de dados, obtém os dados automaticamente se estiverem ausentes e registra o ID como parâmetro da tarefa, para que saibas sempre quais dados foram usados em cada experimento.
Preparar o conjunto de dados#
O repositório YOLOv5 é compatível com muitos conjuntos de dados por meio de arquivos de configuração YAML. Por padrão, os conjuntos de dados são baixados para a pasta ../datasets, relativa à raiz do repositório. Após baixar coco128, a estrutura de pastas será:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Qualquer conjunto de dados serve, desde que preserves essa estrutura.
Em seguida, copia o arquivo YAML do conjunto de dados para a pasta raiz do conjunto de dados — o ClearML lê esse arquivo para usar o conjunto de dados corretamente. Podes criar o teu próprio YAML seguindo o exemplo de estrutura e garantindo que ele define path, train, test, val, nc e names.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Enviar o conjunto de dados#
Para registrar o conjunto de dados como um conjunto de dados versionado no ClearML, entra na pasta raiz e executa:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync é uma forma abreviada da sequência a seguir, que também podes executar explicitamente:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Treinar com um conjunto de dados do ClearML#
Com o conjunto de dados registrado, indica o ID dele ao treinamento:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Otimização de hiperparâmetros#
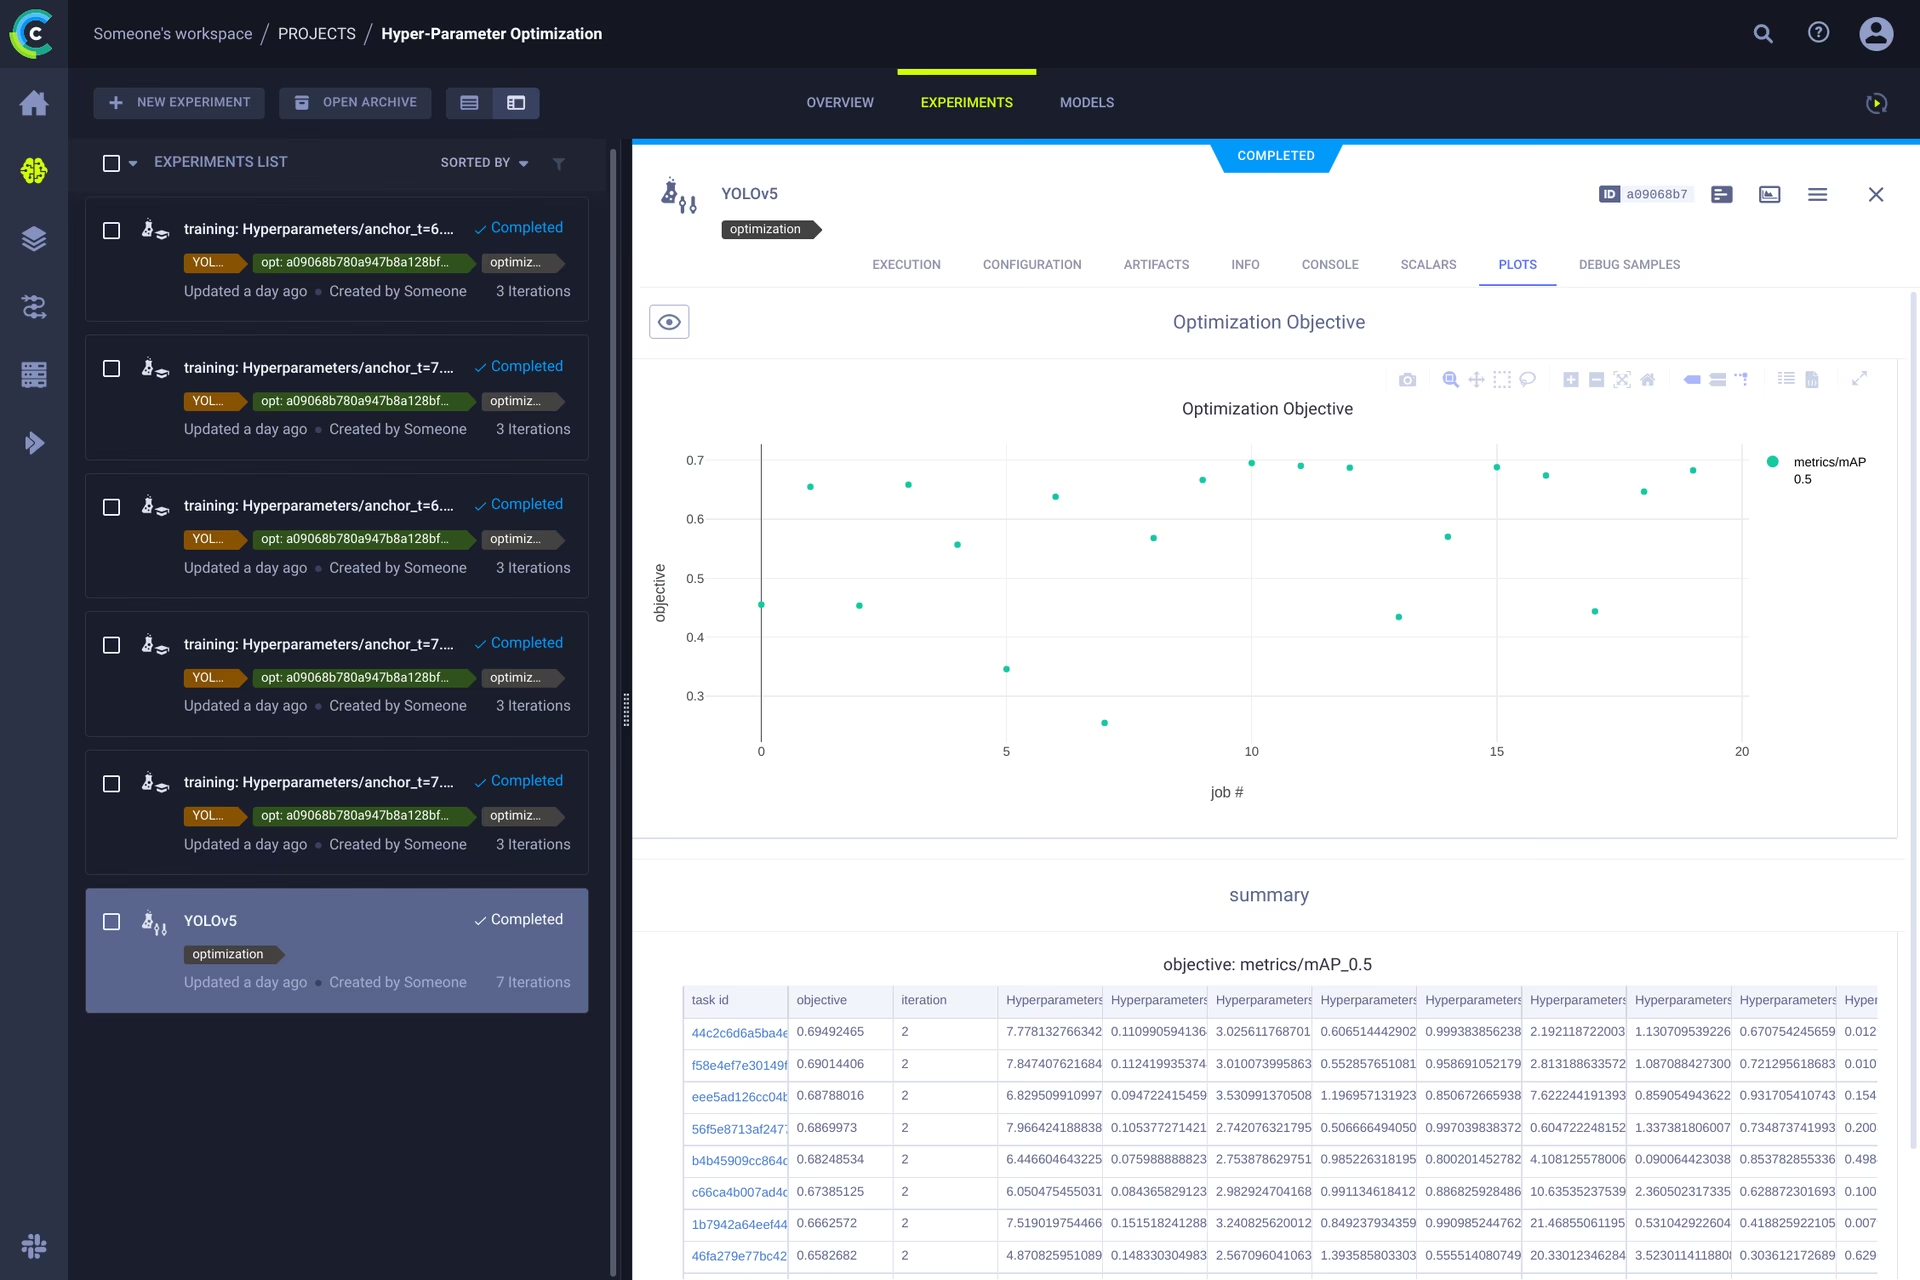
Com experimentos e dados versionados, podes usá-los como base para outras tarefas. Como cada experimento monitorado registra o ambiente completo — código, pacotes instalados e configuração —, as execuções são totalmente reproduzíveis. O ClearML permite clonar um experimento, alterar os parâmetros e executá-lo novamente de forma automática, o que é a base da otimização de hiperparâmetros (HPO).
Para executar HPO localmente, usa o script incluído. Primeiro, verifica se existe uma tarefa de treinamento no gerenciador de experimentos — o script a clona e varia os hiperparâmetros.
Preenche o ID da tarefa modelo em utils/loggers/clearml/hpo.py e, em seguida, executa:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Para executar as tentativas em agentes remotos, substitui optimizer.start_locally() por optimizer.start() e define execution_queue na chamada HyperParameterOptimizer como a fila que os teus agentes monitoram.
🤯 Execução remota (avançado)#
Executar HPO localmente é prático, mas muitas vezes vais querer executar experimentos em hardware mais potente — uma máquina com GPU local ou uma instância na nuvem. Esse é o papel do ClearML Agent:
Cada experimento monitorado contém tudo o que é necessário para reproduzi-lo em outra máquina (pacotes instalados, alterações não confirmadas e configuração). Um agente do ClearML monitora uma fila, recebe as tarefas, recria o ambiente, executa o trabalho e transmite os valores escalares e gráficos de volta ao gerenciador de experimentos.
Transforma qualquer máquina — uma VM na nuvem, uma máquina local com GPU ou um laptop — num agente do ClearML com:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Clonar, editar e enfileirar#
Com um agente em execução, podes atribuir tarefas a ele diretamente pela interface:
- 🪄 Clica com o botão direito num experimento e clona-o.
- 🎯 Edita os hiperparâmetros.
- ⏳ Clica com o botão direito na tarefa clonada e adiciona-a à fila desejada.
Executar uma tarefa remotamente#
Também podes marcar um script em execução para execução remota de forma programática, adicionando task.execute_remotely() depois de instanciar o logger do ClearML. Adiciona a linha destacada a train.py:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ ADICIONA ESTA LINHA
    # ...
    # Processa o link do artefato do conjunto de dados personalizado
    data_dict = loggers.remote_dataset
# ...
Após essa alteração, a execução do script de treinamento prossegue até essa linha, empacota o código e o envia para a fila.
Dimensionamento automático de workers#
O ClearML inclui dimensionadores automáticos que iniciam máquinas remotas na AWS, no GCP ou no Azure quando há experimentos pendentes numa fila, transformam-nas em agentes do ClearML e as desligam quando o trabalho termina — assim, pagas apenas pela computação que está realmente em execução.
Assiste ao vídeo de introdução abaixo:
Saiba mais#
Para saber mais sobre a integração do ClearML com os modelos Ultralytics, consulta o nosso guia de integração do ClearML e descobre como podes aprimorar o teu fluxo de trabalho de MLOps com outras ferramentas de acompanhamento de experimentos.
Perguntas frequentes#
Não. O serviço hospedado gratuito em app.clear.ml funciona imediatamente após
clearml-init. A hospedagem própria é opcional e costuma ser a escolha quando os dados não podem sair da tua rede.O YOLOv5 ativa a integração sempre que o pacote
clearmlestá disponível para importação; por isso, desinstala-o compip uninstall clearmlpara desativar o acompanhamento durante uma execução.Regista o conjunto de dados com
clearml-data synce, em seguida, passa o respetivo ID como argumento de dados:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. O ID é registado na tarefa para que cada experiência saiba exatamente que dados utilizou.Sim. Inicia um
clearml-agent daemonem cada máquina e, em seguida, coloca na fila experiências clonadas a partir da interface ou editautils/loggers/clearml/hpo.pypara chamaroptimizer.start()comexecution_queuedefinido, para que o otimizador envie as tentativas para a fila.