Conjunto de dados COCO#
O conjunto de dados COCO (Objetos comuns em contexto) é um conjunto de dados em grande escala para detecção de objetos, segmentação e legendagem. Ele foi desenvolvido para incentivar a pesquisa em uma ampla variedade de categorias de objetos e é usado com frequência para avaliar modelos de visão computacional. É um conjunto de dados essencial para pesquisadores e desenvolvedores que trabalham com tarefas de detecção de objetos, segmentação e estimativa de pose.
Assista: Visão geral do conjunto de dados COCO do Ultralytics
Modelos COCO pré-treinados#
| Modelo | tamanho (pixels) | mAPval 50-95 | mAPval 50-95(e2e) | Velocidade CPU ONNX (ms) | Velocidade T4 TensorRT10 (ms) | parâmetros (M) | FLOPs (B) |
|---|---|---|---|---|---|---|---|
| YOLO26n | 640 | 40.9 | 40.1 | 38.9 ± 0.7 | 1.7 ± 0.0 | 2.4 | 5.5 |
| YOLO26s | 640 | 48.6 | 47.8 | 87.2 ± 0.9 | 2.5 ± 0.0 | 9.5 | 20.9 |
| YOLO26m | 640 | 53.1 | 52.5 | 220.0 ± 1.4 | 4.7 ± 0.1 | 20.4 | 68.4 |
| YOLO26l | 640 | 55.0 | 54.4 | 286.2 ± 2.0 | 6.2 ± 0.2 | 24.8 | 86.8 |
| YOLO26x | 640 | 57.5 | 56.9 | 525.8 ± 4.0 | 11.8 ± 0.2 | 55.7 | 194.4 |
Principais funcionalidades#
- O COCO contém 330 mil imagens, das quais 200 mil têm anotações para tarefas de detecção de objetos, segmentação e legendagem.
- O conjunto de dados abrange 80 categorias de objetos, incluindo objetos comuns, como carros, bicicletas e animais, além de categorias mais específicas, como guarda-chuvas, bolsas e equipamentos esportivos.
- As anotações incluem caixas delimitadoras de objetos, máscaras de segmentação e legendas para cada imagem.
- O COCO fornece métricas de avaliação padronizadas, como precisão média (mAP) e revocação média (AR), para detecção de objetos e segmentação, sendo adequado para comparar o desempenho dos modelos.
Estrutura do conjunto de dados#
O conjunto de dados COCO está dividido em três subconjuntos:
- Train2017: 118.287 imagens para treinar modelos de detecção de objetos, segmentação e geração de legendas.
- Val2017: 5.000 imagens usadas para validação durante o treinamento do modelo.
- Test2017: 20.288 imagens test-dev usadas para avaliar modelos treinados. As anotações de ground truth deste subconjunto não estão disponíveis publicamente, e os resultados são enviados ao servidor de avaliação do COCO para avaliação de desempenho.
Aplicações#
O conjunto de dados COCO é amplamente utilizado para treinar e avaliar modelos de aprendizado profundo em detecção de objetos (como Ultralytics YOLO, Faster R-CNN e SSD), segmentação de instâncias (como Mask R-CNN) e detecção de pontos-chave (como OpenPose). A variedade de categorias de objetos, o grande número de imagens anotadas e as métricas de avaliação padronizadas fazem deste conjunto de dados um recurso essencial para pesquisadores e profissionais de visão computacional.
As anotações exportadas de ferramentas de rotulagem no formato COCO JSON seguem essa mesma estrutura. Para treinar com os teus próprios dados no formato COCO, consulta Converter anotações COCO para YOLO.
YAML do conjunto de dados#
Um ficheiro YAML é usado para definir a configuração do conjunto de dados. Contém informações sobre os caminhos, as classes e outros dados relevantes do conjunto. No caso do conjunto de dados COCO, o ficheiro coco.yaml é mantido em https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO 2017 dataset https://cocodataset.org by Microsoft
# Documentation: https://docs.ultralytics.com/datasets/detect/coco
# Example usage: yolo train data=coco.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco ← downloads here (20.3 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco # dataset root dir
train: train2017.txt # train images (relative to 'path') 118287 images
val: val2017.txt # val images (relative to 'path') 5000 images
test: test-dev2017.txt # 20288 of 40670 images, submit via https://cocodataset.org/#detection-eval

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: |
  from pathlib import Path

  from ultralytics.utils import ASSETS_URL
  from ultralytics.utils.downloads import download

  # Download labels
  segments = True  # segment or box labels
  dir = Path(yaml["path"])  # dataset root dir
  urls = [ASSETS_URL + ("/coco2017labels-segments.zip" if segments else "/coco2017labels.zip")]  # labels
  download(urls, dir=dir.parent)

  # Download data (test2017.zip excluded: ground truth is withheld, only used for the eval-server test-dev split)
  urls = [
      "http://images.cocodataset.org/zips/train2017.zip",  # 19G, 118k images
      "http://images.cocodataset.org/zips/val2017.zip",  # 1G, 5k images
  ]
download(urls, dir=dir / "images", threads=3)Uso#
Os dados de treino e validação do COCO2017 (20,3 GB) são descarregados automaticamente na primeira vez que inicias o treinamento. Para treinar um modelo YOLO26n com COCO durante 100 épocas, com um tamanho de imagem de 640, podes usar os seguintes exemplos de código. Para ver a lista completa de argumentos disponíveis, consulta a página de Treinamento do modelo. Também podes executar o treinamento com COCO na nuvem usando a Ultralytics Platform.
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="coco.yaml", epochs=100, imgsz=640)
Imagens de exemplo e anotações#
O conjunto de dados COCO contém uma variedade de imagens com diferentes categorias de objetos e cenas complexas. Eis alguns exemplos de imagens do conjunto, com as respetivas anotações:
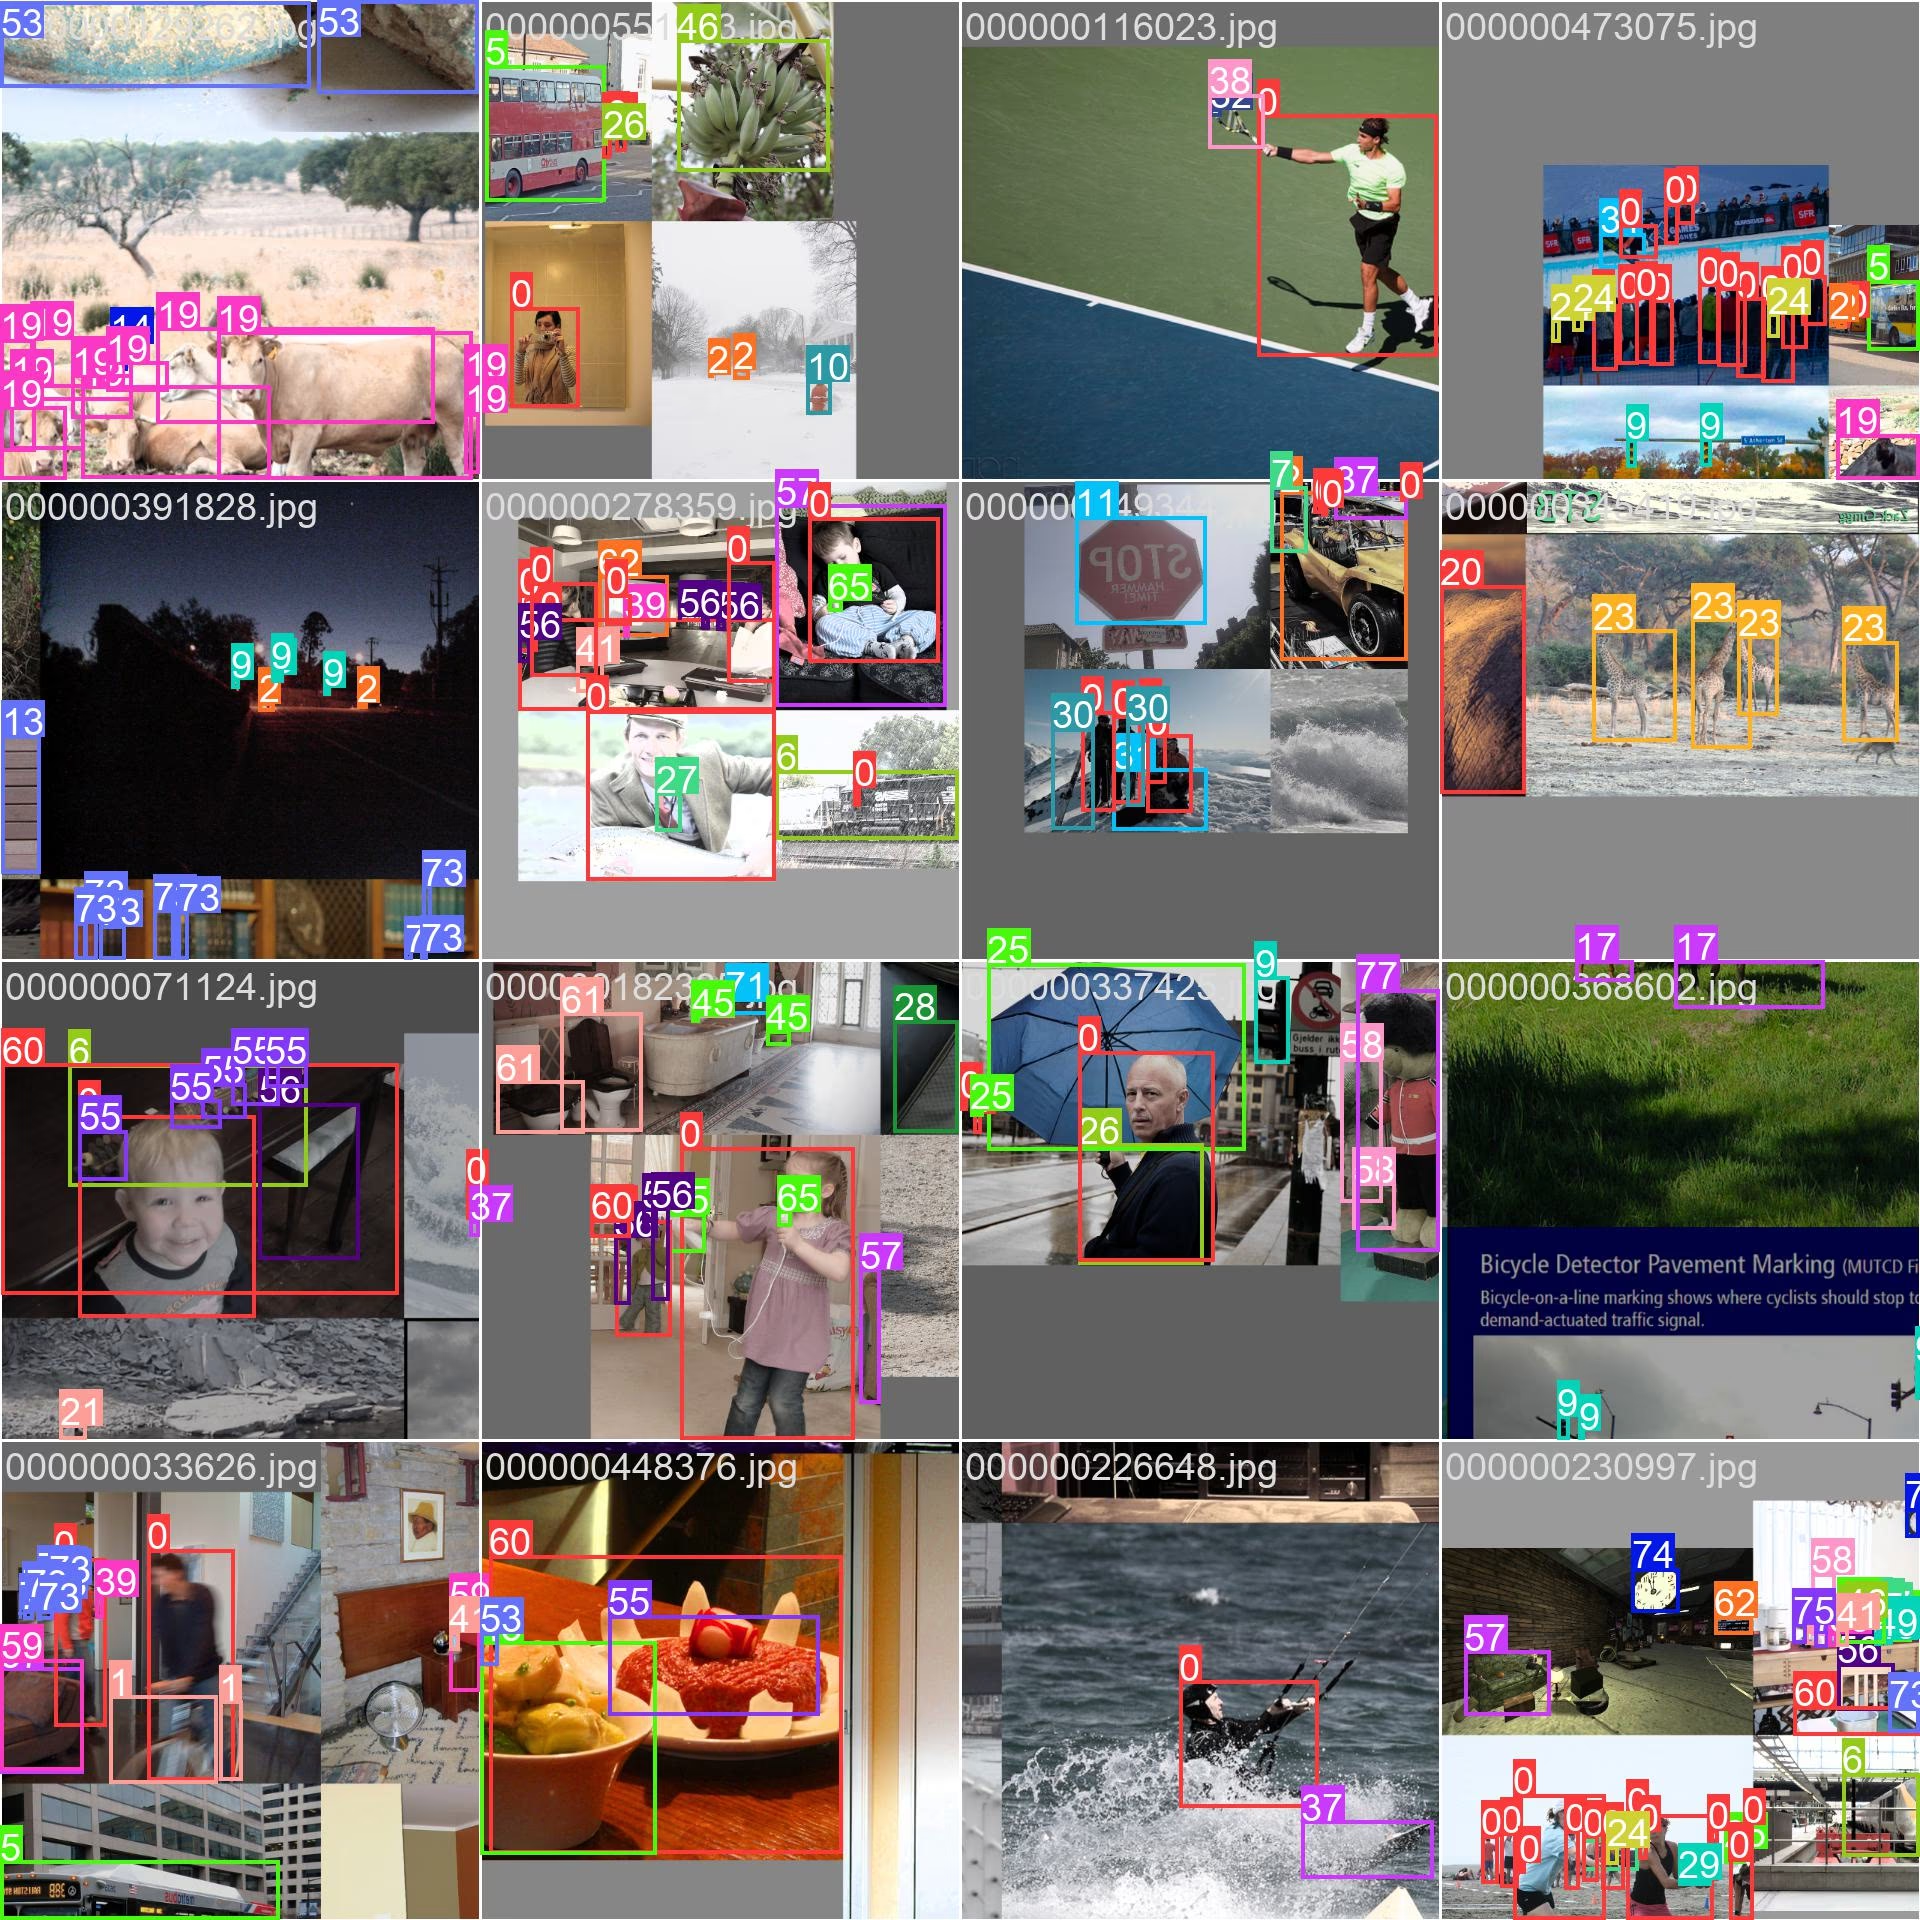
- Imagem em mosaico: esta imagem mostra um lote de treinamento composto por imagens do conjunto de dados organizadas em mosaico. A criação de mosaicos é uma técnica usada durante o treinamento que combina várias imagens numa só para aumentar a variedade de objetos e cenas em cada lote de treinamento. Isso ajuda a melhorar a capacidade do modelo de generalizar para diferentes tamanhos de objetos, proporções e contextos.
O exemplo mostra a variedade e a complexidade das imagens do conjunto de dados COCO, bem como os benefícios de usar a criação de mosaicos durante o processo de treinamento.
Citações e agradecimentos#
Se usares o conjunto de dados COCO no teu trabalho de pesquisa ou desenvolvimento, cita o seguinte artigo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Gostaríamos de agradecer ao COCO Consortium por criar e manter este valioso recurso para a comunidade de visão computacional. Para saber mais sobre o conjunto de dados COCO e os seus criadores, visita o site do conjunto de dados COCO.
Perguntas frequentes#
O conjunto de dados COCO (Objetos Comuns em Contexto (COCO)) é um conjunto de dados de grande escala usado para detecção de objetos, segmentação e geração de legendas. Contém 330 mil imagens com anotações detalhadas para 80 categorias de objetos, sendo essencial para avaliar e treinar modelos de visão computacional. Pesquisadores usam o COCO devido à diversidade de categorias e às métricas de avaliação padronizadas, como a Precisão Média Precision (mAP).
Para treinar um modelo YOLO26 usando o conjunto de dados COCO, podes usar os seguintes exemplos de código:
Exemplo de treinofrom ultralytics import YOLO # Carregar um modelo model = YOLO("yolo26n.pt") # carregue um modelo pré-treinado (recomendado para treinamento) # Treinar o modelo results = model.train(data="coco.yaml", epochs=100, imgsz=640)Consulta a página de treinamento para saber mais sobre os argumentos disponíveis.
O conjunto de dados COCO inclui:
- 330 mil imagens, das quais 200 mil têm anotações para detecção de objetos, segmentação e geração de legendas.
- 80 categorias de objetos, desde itens comuns, como carros e animais, até itens específicos, como bolsas e equipamentos desportivos.
- Métricas de avaliação padronizadas (mAP e Average Recall) para detecção de objetos e segmentação.
- Técnica de criação de mosaicos nos lotes de treinamento para melhorar a generalização do modelo a diferentes tamanhos e contextos de objetos.
Podes descarregar os modelos YOLO26 pré-treinados com o conjunto de dados COCO através dos links indicados na documentação. Alguns exemplos:
Estes modelos variam em tamanho, mAP e velocidade de inferência, oferecendo opções para diferentes requisitos de desempenho e recursos.
O conjunto de dados COCO está dividido em três subconjuntos:
- Train2017: 118.287 imagens para treinamento.
- Val2017: 5.000 imagens para validação durante o treinamento.
- Test2017: 20.288 imagens test-dev para avaliar modelos treinados. Os resultados devem ser enviados ao servidor de avaliação do COCO para avaliação de desempenho.
O ficheiro de configuração YAML do conjunto de dados está disponível em coco.yaml e define os caminhos, as classes e os detalhes do conjunto.