Estratégias de coleta e anotação de dados para visão computacional
A recolha e a anotação de dados são as duas etapas fundamentais de qualquer projeto de visão computacional: recolhes imagens ou vídeos representativos e, em seguida, rotulas-os para que um modelo possa aprender com eles. A qualidade destes dados determina diretamente o desempenho do modelo, por isso, é importante definir as classes, obter dados de fontes sem enviesamento e manter a consistência das anotações antes de iniciar qualquer treino.
Assista: Como criar estratégias eficazes de coleta e anotação de dados para visão computacional 🚀
Este guia aborda como configurar classes e coletar dados, o que é anotação de dados, além dos tipos e formatos de anotação disponíveis, e estratégias eficientes de rotulagem — com cada decisão alinhada aos objetivos do seu projeto.
Configuração de classes e coleta de dados#
A coleta de imagens e vídeos para um projeto de visão computacional se resume a três decisões: quantas classes definir, onde obter os dados e como manter o conjunto de dados livre de vieses.
Como escolher as classes certas para o seu projeto#
Uma das primeiras perguntas ao iniciar um projeto de visão computacional é quantas classes incluir. Você precisa definir a composição das classes, ou seja, as diferentes categorias ou rótulos que quer que o modelo reconheça e diferencie. O número de classes deve ser determinado pelos objetivos específicos do seu projeto.
Por exemplo, se você quer monitorar o trânsito, suas classes podem incluir "carro", "caminhão", "ônibus", "motocicleta" e "bicicleta". Já para rastrear itens em uma loja, suas classes podem ser "frutas", "vegetais", "bebidas" e "lanches". Definir as classes com base nos objetivos do seu projeto ajuda a manter o conjunto de dados relevante e focado.
Ao definir suas classes, outra distinção importante é escolher entre uma contagem de classes ampla ou detalhada. 'Contagem' se refere ao número de classes distintas de seu interesse. Essa decisão influencia a granularidade dos seus dados e a complexidade do seu modelo. Veja os aspectos a considerar em cada abordagem:
- Contagem ampla de classes: são categorias abrangentes e inclusivas, como "veículo" e "não veículo". Elas simplificam a anotação e exigem menos recursos computacionais, mas fornecem menos informações detalhadas, o que pode limitar a eficácia do modelo em cenários complexos.
- Contagem detalhada de classes: inclui mais categorias com distinções mais específicas, como "sedã", "SUV", "caminhonete" e "motocicleta". Elas capturam informações mais detalhadas, melhorando a precisão e o desempenho do modelo. No entanto, sua anotação consome mais tempo e trabalho, além de exigir mais recursos computacionais.
Começar com classes mais específicas pode ser muito útil, principalmente em projetos complexos nos quais os detalhes são importantes. Classes mais específicas permitem coletar dados mais detalhados, obter insights mais profundos e estabelecer distinções mais claras entre categorias. Isso não só melhora a precisão do modelo, como também facilita ajustá-lo posteriormente, se necessário, economizando tempo e recursos.
Fontes de dados#
Você pode usar conjuntos de dados públicos ou coletar seus próprios dados personalizados. Conjuntos de dados públicos, como os disponíveis no Kaggle e no Google Dataset Search Engine, oferecem dados padronizados e bem anotados, sendo ótimos pontos de partida para treinar e validar modelos.
Por outro lado, a coleta de dados personalizados permite adaptar o conjunto de dados às suas necessidades específicas. Você pode capturar imagens e vídeos com câmeras ou drones, buscar imagens na web ou usar dados internos existentes da sua organização. Os dados personalizados dão a você mais controle sobre a qualidade e a relevância dos dados. Combinar fontes de dados públicas e personalizadas ajuda a criar um conjunto de dados diversificado e abrangente.
Como evitar vieses na coleta de dados#
Há viés quando determinados grupos ou cenários são sub-representados ou super-representados no conjunto de dados. Isso resulta em um modelo que tem bom desempenho em alguns dados, mas desempenho ruim em outros. É fundamental evitar vieses em IA para que seu modelo de visão computacional tenha bom desempenho em vários cenários.
Veja como evitar vieses durante a coleta de dados:
- Fontes diversas: colete dados de várias fontes para capturar diferentes perspectivas e cenários.
- Representação equilibrada: inclua uma representação equilibrada de todos os grupos relevantes. Por exemplo, considere diferentes idades, gêneros e etnias.
- Monitoramento contínuo: revise e atualize regularmente seu conjunto de dados para identificar e corrigir vieses que possam surgir.
- Técnicas de mitigação de vieses: use métodos como sobreamostragem de classes sub-representadas, aumento de dados e algoritmos que consideram a equidade.
Seguir essas práticas ajuda a criar um modelo mais robusto e justo, capaz de generalizar bem em aplicações reais.
O que é anotação de dados?#
A anotação de dados é o processo de rotular dados para torná-los utilizáveis no treinamento de modelos de aprendizado de máquina. Em visão computacional, isso significa rotular imagens ou vídeos com as informações que o modelo precisa aprender. Sem dados devidamente anotados, os modelos não conseguem aprender com precisão as relações entre as entradas e as saídas.
Tipos de anotação de dados#
Dependendo dos requisitos específicos de uma tarefa de visão computacional, há diferentes tipos de anotação de dados. Veja alguns exemplos:
- Caixas delimitadoras: caixas retangulares desenhadas ao redor dos objetos em uma imagem, usadas principalmente em tarefas de detecção de objetos. Essas caixas são definidas pelas coordenadas dos cantos superior esquerdo e inferior direito.
- Polígonos: contornos detalhados dos objetos, que permitem uma anotação mais precisa do que as caixas delimitadoras. Os polígonos são usados em tarefas como segmentação de instâncias, nas quais o formato do objeto é importante.
- Máscaras: máscaras binárias em que cada pixel pertence a um objeto ou ao plano de fundo. As máscaras são usadas em tarefas de segmentação semântica para fornecer detalhes ao nível do pixel.
- Pontos-chave: pontos específicos marcados em uma imagem para identificar locais de interesse. Os pontos-chave são usados em tarefas como estimativa de pose e detecção de pontos de referência faciais.
- Caixas delimitadoras orientadas: retângulos que incluem um ângulo de rotação, usados em tarefas de OBB, nas quais os objetos aparecem em orientações arbitrárias, como em imagens aéreas.
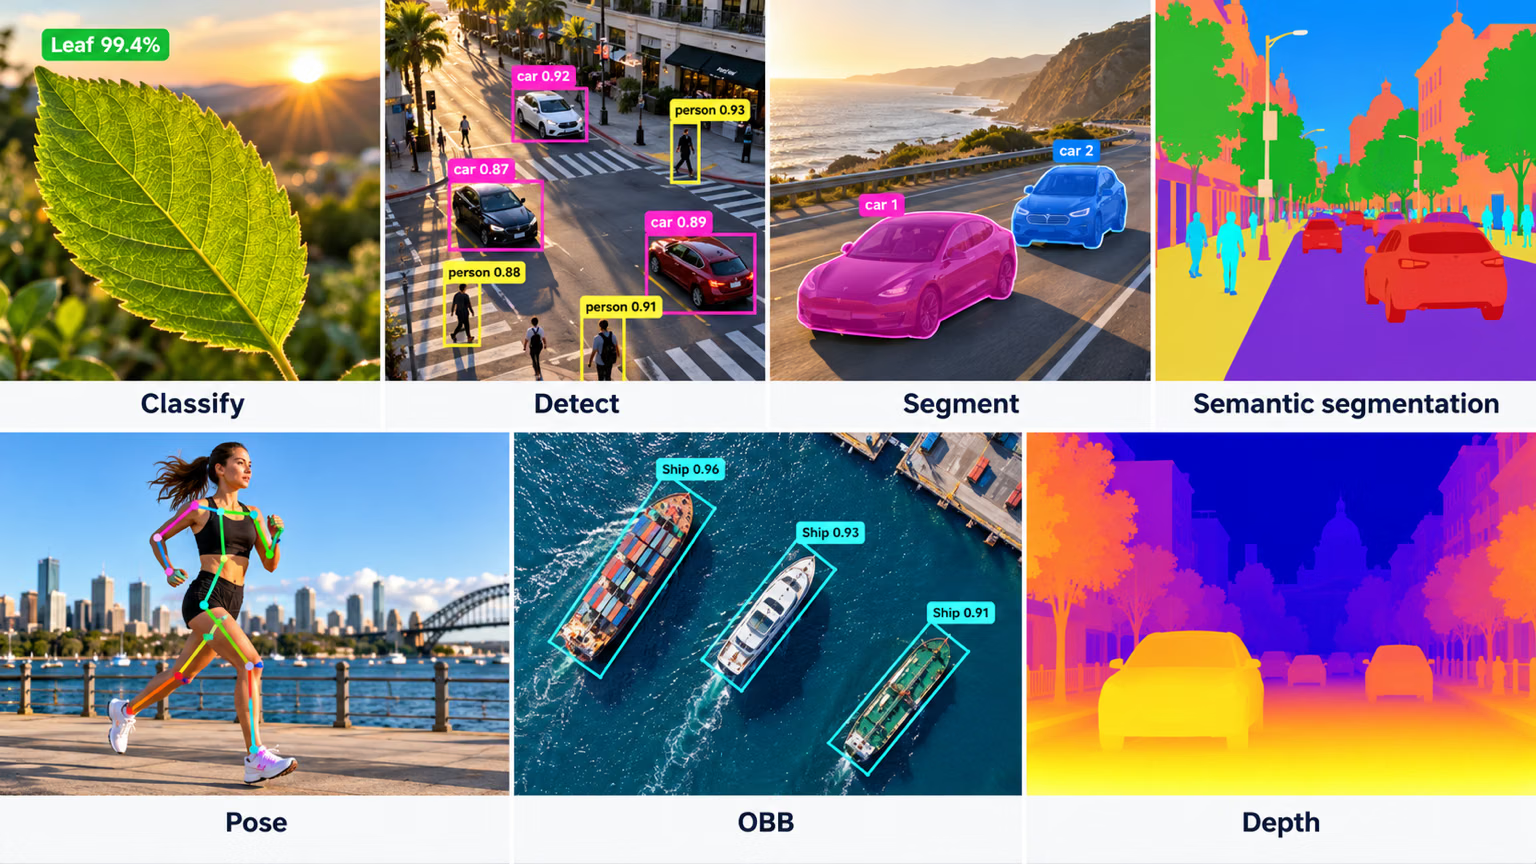
Formatos comuns de anotação#
Depois de selecionar um tipo de anotação, é importante escolher o formato adequado para armazenar e compartilhar as anotações. Os formatos mais comuns são:
| Formato | Estrutura de arquivos | Usos comuns |
|---|---|---|
| COCO | Um único arquivo JSON | Detecção de objetos, segmentação de instâncias, detecção de pontos-chave, objetos de fundo e segmentação panóptica, legendagem de imagens |
| Pascal VOC | Um arquivo XML por imagem | Detecção de objetos |
| YOLO | Um arquivo .txt por imagem | Detecção de objetos, segmentação, pose e caixas orientadas |
O formato YOLO armazena uma linha por objeto, com índices de classe a começar em 0. Para a deteção de objetos, a linha é class x_center y_center width height com coordenadas normalizadas de 0–1. Numa linha de segmentação, a caixa é substituída pelos pontos normalizados do polígono do objeto; já uma linha de pose mantém a caixa e acrescenta as coordenadas dos pontos-chave, com uma indicação de visibilidade para cada ponto-chave quando o conjunto de dados declara kpt_shape: [n, 3]. Uma linha OBB armazena class x1 y1 x2 y2 x3 y3 x4 y4 usando coordenadas normalizadas dos vértices.
Se sua ferramenta de anotação exportar COCO JSON, você pode convertê-lo em rótulos YOLO .txt ou treinar diretamente com o JSON usando uma classe de conjunto de dados personalizada.
Como definir diretrizes de anotação#
Depois de escolher o tipo e o formato da anotação, a próxima etapa é estabelecer regras de rotulagem claras e objetivas. Essas regras servem como um roteiro para manter a consistência e a precisão ao longo do processo de anotação. Os principais aspectos dessas regras incluem:
- Clareza e detalhes: certifique-se de que suas instruções sejam claras. Use exemplos e ilustrações para mostrar o que é esperado.
- Consistência: mantenha a uniformidade das anotações. Defina critérios padrão para anotar diferentes tipos de dados, para que todas as anotações sigam as mesmas regras.
- Redução de vieses: mantenha a neutralidade. Treine-se para ser objetivo e minimizar vieses pessoais, garantindo anotações justas.
- Eficiência: Usa ferramentas e fluxos de trabalho que automatizam tarefas repetitivas, tornando o processo de anotação mais rápido e eficiente.
Revisar e atualizar regularmente suas regras de rotulagem ajuda a manter as anotações precisas, consistentes e alinhadas aos objetivos do seu projeto.
Ferramentas de anotação#
Uma boa ferramenta de anotação permite rotular todos os tipos necessários para sua tarefa, aplica diretrizes consistentes e exporta rótulos em um formato pronto para treinamento. A Ultralytics Platform oferece um editor de anotações integrado que abrange detecção, segmentação de instâncias, segmentação semântica, classificação, pose e OBB, com anotação inteligente com tecnologia SAM que transforma um único clique em uma máscara para tarefas de detecção, segmentação de instâncias, segmentação semântica e OBB. Como as anotações são salvas no formato esperado por cada tarefa — linhas YOLO .txt para as tarefas espaciais e pastas de classes para classificação —, seu conjunto de dados rotulado vai diretamente para o treinamento, sem precisar de conversão.
Qualidade da anotação: precisão, exatidão e valores atípicos#
Antes de anotar em grande escala, é útil entender a exatidão, a precisão, os valores atípicos e o controle de qualidade, para não rotular os dados de forma contraproducente.
Entenda a exatidão e a precisão#
É importante entender a diferença entre exatidão e precisão e como esses conceitos se relacionam com a anotação. Exatidão indica o quanto os dados anotados se aproximam dos valores verdadeiros. Ela nos ajuda a medir o quanto os rótulos refletem situações reais. Precisão indica a consistência das anotações. Ela verifica se você atribui o mesmo rótulo ao mesmo objeto ou característica em todo o conjunto de dados. Uma exatidão e uma precisão elevadas resultam em modelos mais bem treinados, pois reduzem o ruído e melhoram a capacidade do modelo de generalizar a partir dos dados de treinamento.
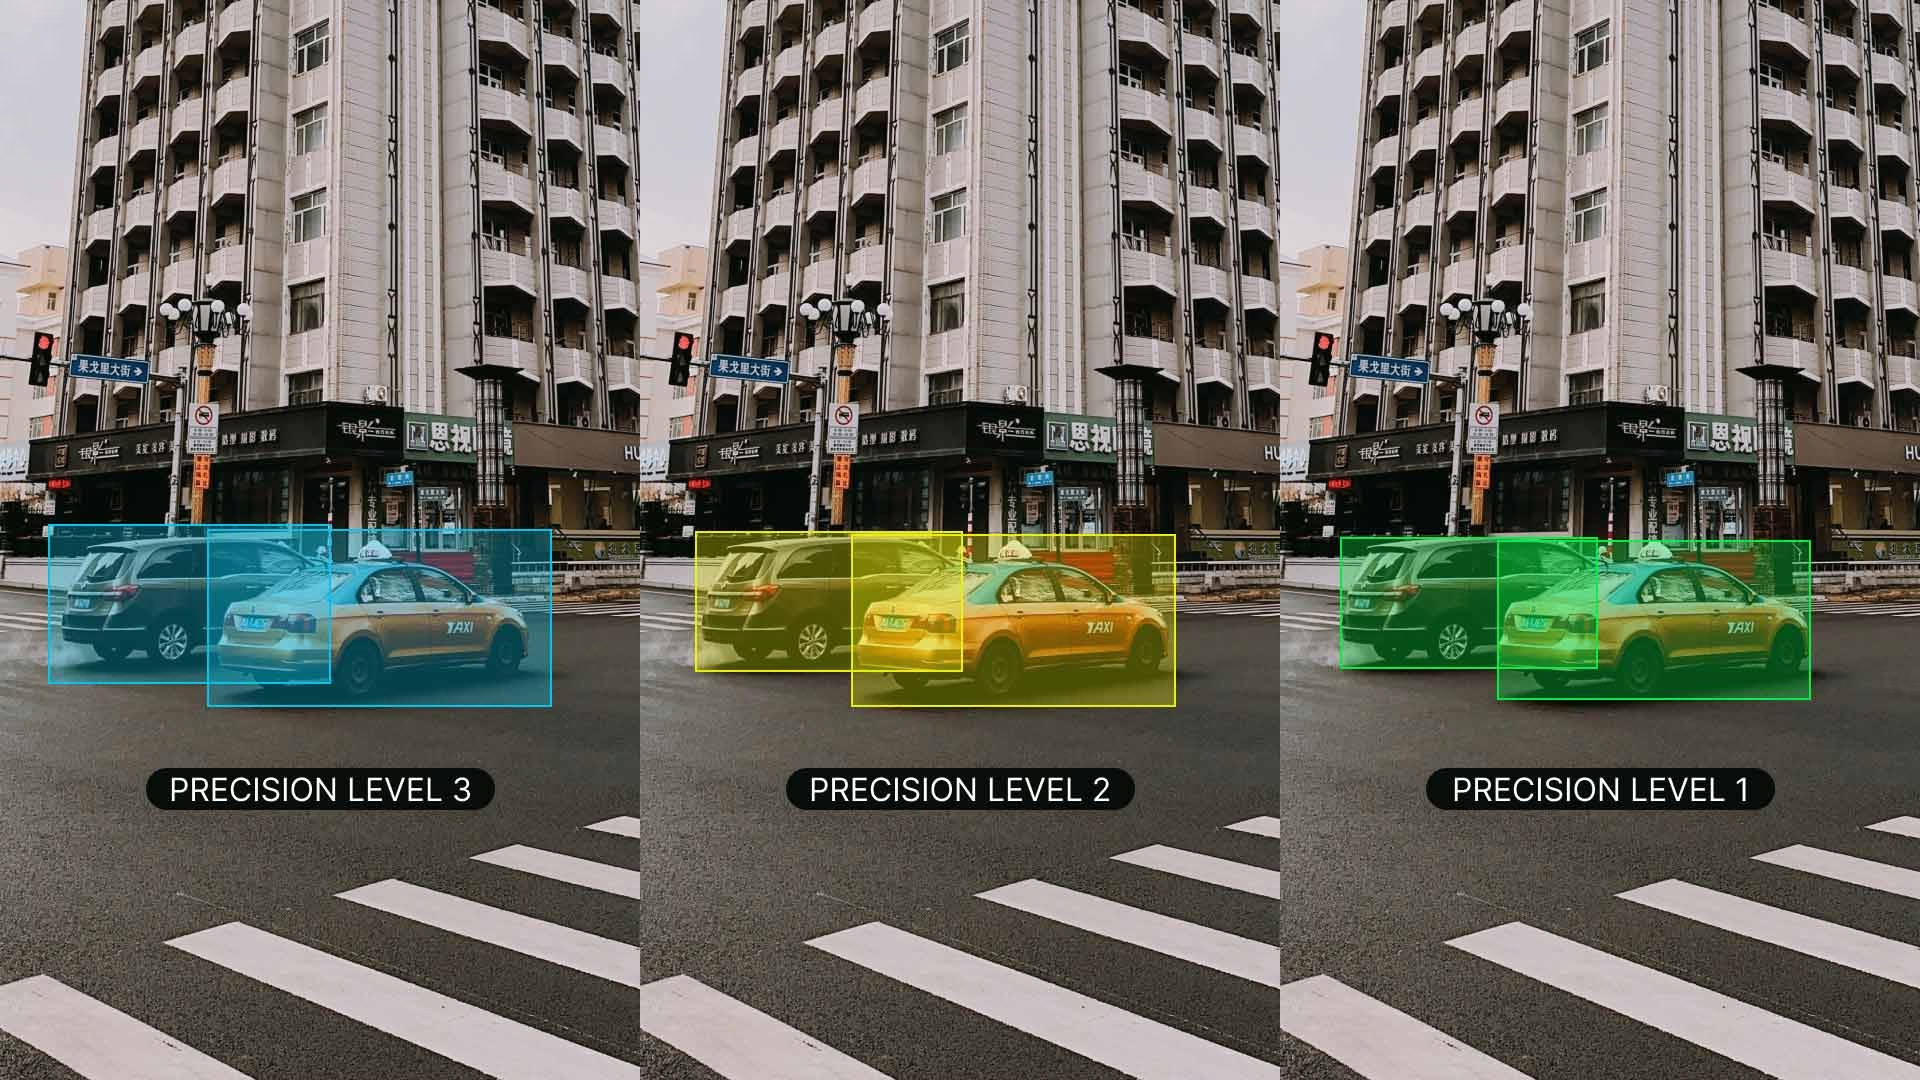
Identificação de valores atípicos#
Valores atípicos são pontos de dados que se desviam bastante das demais observações no conjunto de dados. No contexto das anotações, um valor atípico pode ser uma imagem rotulada incorretamente ou uma anotação que não corresponde ao restante do conjunto de dados. Valores atípicos são preocupantes porque podem distorcer o processo de aprendizado do modelo, levando a previsões imprecisas e a uma generalização ruim.
Você pode usar vários métodos para detectar e corrigir valores atípicos:
- Técnicas estatísticas: para detectar valores atípicos em características numéricas, como valores de pixel, coordenadas de caixas delimitadoras ou tamanhos de objetos, você pode usar métodos como diagramas de caixa, histogramas ou escores z.
- Técnicas visuais: para identificar anomalias em características categóricas, como classes de objetos, cores ou formatos, use métodos visuais, como gráficos de imagens, rótulos ou mapas de calor.
- Métodos algorítmicos: Usa ferramentas como algoritmos de agrupamento (por exemplo, agrupamento K-means, DBSCAN) e de detecção de anomalias para identificar valores atípicos com base em padrões de distribuição dos dados.
Controle de qualidade dos dados anotados#
Assim como em outros projetos técnicos, o controle de qualidade é essencial para dados anotados. É recomendável verificar regularmente as anotações para garantir que sejam precisas e consistentes. Isso pode ser feito de algumas maneiras diferentes:
- Revisar amostras dos dados anotados
- Usar ferramentas automatizadas para identificar erros comuns
- Pedir para outra pessoa conferir as anotações
Se trabalhas com várias pessoas, a consistência entre diferentes anotadores é importante. Uma boa concordância entre anotadores significa que as diretrizes são claras e que todos as seguem da mesma forma. Isso mantém todos alinhados e garante a consistência das anotações.
Durante a revisão, se encontrar erros, corrija-os e atualize as diretrizes para evitar problemas futuros. Dê feedback aos anotadores e ofereça treinamento regular para ajudar a reduzir erros. Um processo sólido para lidar com erros mantém seu conjunto de dados preciso e confiável.
Estratégias eficientes de rotulagem de dados#
Para tornar o processo de rotulagem de dados mais simples e eficaz, considera implementar estas estratégias:
- Diretrizes claras de anotação: fornece instruções detalhadas com exemplos para garantir que todos os anotadores interpretem as tarefas da mesma forma. Por exemplo, ao rotular aves, especifica se é necessário incluir a ave inteira ou apenas partes específicas.
- Verificações regulares de qualidade: define referências e usa métricas específicas para rever o trabalho, mantendo padrões elevados com feedback contínuo.
- Usa ferramentas de pré-anotação: muitas plataformas modernas de anotação oferecem funcionalidades de pré-anotação assistidas por IA que podem acelerar significativamente o processo, gerando automaticamente anotações iniciais que as pessoas podem depois aperfeiçoar.
- Implementa a aprendizagem ativa: Esta abordagem prioriza a rotulagem das amostras mais informativas primeiro, o que pode reduzir o número total de anotações necessárias sem comprometer o desempenho do modelo.
- Processamento em lotes: agrupa imagens semelhantes para anotação, de modo a manter a consistência e melhorar a eficiência.
Estas estratégias podem ajudar a manter anotações de alta qualidade e, ao mesmo tempo, reduzir o tempo e os recursos necessários para o processo de rotulagem.
Conclusão#
Recolher dados diversos e imparciais e anotá-los de forma consistente com as ferramentas certas é a base de um modelo fiável de visão computacional. Com o conjunto de dados recolhido e rotulado, continua com o guia sobre etapas de um projeto de visão computacional para avançar para o treino e a avaliação. Se surgirem dúvidas pelo caminho, pergunta à comunidade no repositório do Ultralytics no GitHub ou no servidor do Ultralytics no Discord.
Perguntas frequentes#
Para minimizar os enviesamentos, recolhe dados de fontes diversas, garante uma representação equilibrada de todos os grupos relevantes (como diferentes idades, géneros e etnias), revê e atualiza regularmente o conjunto de dados para detetar enviesamentos emergentes e aplica técnicas de mitigação, como sobreamostragem de classes sub-representadas, aumento de dados e algoritmos que têm em conta a equidade. Evitar enviesamentos desta forma permite que o modelo de visão computacional tenha um bom desempenho em vários cenários do mundo real e melhora a sua capacidade de generalização.
Define diretrizes de rotulagem claras e objetivas, com instruções, exemplos e ilustrações detalhados, e aplica-as uniformemente a todos os tipos de dados, para que todas as anotações sigam as mesmas regras. Forma os anotadores para que mantenham a neutralidade e reduzam os enviesamentos pessoais, revê e atualiza as diretrizes regularmente e usa verificações automatizadas de consistência e feedback entre anotadores para manter a precisão elevada e alinhada com os objetivos do projeto.
Algumas centenas de objetos anotados por classe são suficientes para começar a experimentar aprendizagem por transferência, mas, para obter um desempenho fiável no mundo real, a Ultralytics recomenda pelo menos 1.500 imagens e 10.000 instâncias rotuladas por classe. Combina um conjunto de dados suficientemente grande com um cronograma de treino razoável — cerca de 300 épocas é um ponto de partida comum, que deves reduzir se o modelo começar a sobreajustar cedo — e mantém as anotações rigorosas e alinhadas com os objetivos específicos do projeto. Consulta estratégias de treino detalhadas no guia de treino do YOLO26.
Sim. A Ultralytics Platform inclui um editor de anotações integrado que suporta caixas delimitadoras, polígonos, pontos-chave, caixas orientadas e rótulos de classificação num único espaço de trabalho. A anotação inteligente com tecnologia SAM acelera a rotulagem de tarefas de deteção, segmentação de instâncias, segmentação semântica e OBB, gerando máscaras com um único clique; os conjuntos de dados de pose podem usar modelos de pose YOLO para anotação inteligente, enquanto a classificação é anotada manualmente. As anotações são armazenadas no formato esperado por cada tarefa — linhas
.txtdo YOLO para as tarefas espaciais e pastas de classes para a classificação — prontas para o treino.Escolhe o tipo de anotação de acordo com a tarefa que pretendes treinar. As caixas delimitadoras são as mais rápidas de desenhar e são tudo o que a deteção de objetos exige. Os polígonos e as máscaras demoram consideravelmente mais tempo por objeto, mas são necessários para a segmentação de instâncias quando a forma exata de um objeto é importante. Os pontos-chave são adequados para a estimativa de pose e a deteção de pontos de referência; as caixas orientadas são adequadas para tarefas OBB, como imagens aéreas, nas quais um retângulo alinhado com os eixos incluiria demasiado fundo. Anotar para a tarefa mais específica de que realmente precisas mantém o esforço de rotulagem proporcional ao resultado.


Comentários16
Faz uma pergunta, partilha os teus resultados ou ajuda alguém.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(editado)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(editado)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1