O conjunto de dados PASCAL VOC (Classes de objetos visuais) é um benchmark clássico de detecção de objetos, com 20 classes de objetos do cotidiano. A configuração VOC.yaml da Ultralytics combina as divisões trainval de VOC2007 e VOC2012 em um conjunto de treinamento com 16,551 imagens, faz a validação nas 4,952 imagens de teste do VOC2007 anotadas publicamente e baixa tudo automaticamente (2.8 GB) na primeira utilização.
Assista: Como treinar Ultralytics YOLO no conjunto de dados Pascal VOC | Detecção de objetos | Visão computacional 🚀
Os desafios PASCAL VOC ocorreram de 2005 a 2012 e moldaram a forma como os modelos de detecção de objetos são avaliados: o benchmark abrange tarefas de classificação de imagens, detecção e segmentação, além de popularizar a precisão média (mAP) como métrica padrão de detecção. A configuração VOC.yaml da Ultralytics usa as anotações de detecção e converte as caixas delimitadoras XML originais para o formato YOLO durante o download.
20 classes de objetos do cotidiano: pessoa; seis animais (pássaro, gato, vaca, cachorro, cavalo, ovelha); sete veículos (avião, bicicleta, barco, ônibus, carro, motocicleta, trem); e seis objetos de interior (garrafa, cadeira, mesa de jantar, planta em vaso, sofá, monitor de TV).
Duas gerações de desafios combinadas: o treinamento combina VOC2007 trainval (5,011 imagens) com VOC2012 trainval (11,540 imagens).
Avaliação padronizada: décadas de resultados de referência publicados para o VOC fazem dele um ponto de referência conveniente para comparar modelos de detecção.
Pronto para YOLO: o script de download busca os arquivos compactados e converte as anotações automaticamente — sem preparação manual.
VOC2007 test, usado para avaliação durante o treinamento
Teste
4,952
As mesmas imagens de teste do VOC2007 — a configuração não define uma divisão separada reservada para teste
As anotações de teste do VOC2007 foram disponibilizadas publicamente após o desafio daquele ano, o que permite que essa divisão sirva como conjunto de validação rotulado. As anotações de teste do VOC2012 continuam reservadas — os resultados só podem ser avaliados por meio do servidor oficial de avaliação PASCAL — e, por isso, não fazem parte desta configuração.
Objetos difíceis excluídos
O conversor automático ignora os objetos marcados com difficult nas anotações XML originais do VOC, portanto, as contagens de instâncias por classe diferem ligeiramente das estatísticas oficiais do VOC.
Explore o VOC na Ultralytics Platform para navegar pelas imagens com suas sobreposições de anotações, ver a distribuição das classes e os mapas de calor das caixas delimitadoras na aba Gráficos e clonar o conjunto para treinar seu próprio modelo na nuvem.
O PASCAL VOC foi o principal benchmark para pesquisas sobre detecção de objetos nos anos anteriores ao maior conjunto de dados COCO: detectores como Faster R-CNN e SSD publicaram seus resultados originais nele, e os modelos Ultralytics YOLO podem ser treinados nele diretamente. Atualmente, ele continua popular para:
Avaliar novas arquiteturas de detecção em relação a um longo histórico de resultados de referência publicados
Experimentos rápidos e trabalhos acadêmicos — com 16,551 imagens de treinamento, o treinamento é muito mais rápido do que no COCO
O VOC é baixado automaticamente na primeira vez que você treina — três arquivos compactados que totalizam 2,8 GB — e requer cerca de 6 GB de espaço livre em disco durante a extração e a conversão.
Para treinar um modelo YOLO26n no conjunto de dados VOC durante 100 épocas, com tamanho de imagem 640, podes utilizar os seguintes exemplos de código.
Exemplo de treino
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo - o conjunto de dados será transferido automaticamente na primeira execução
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
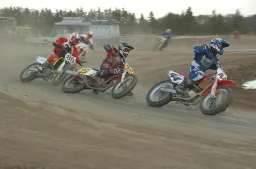
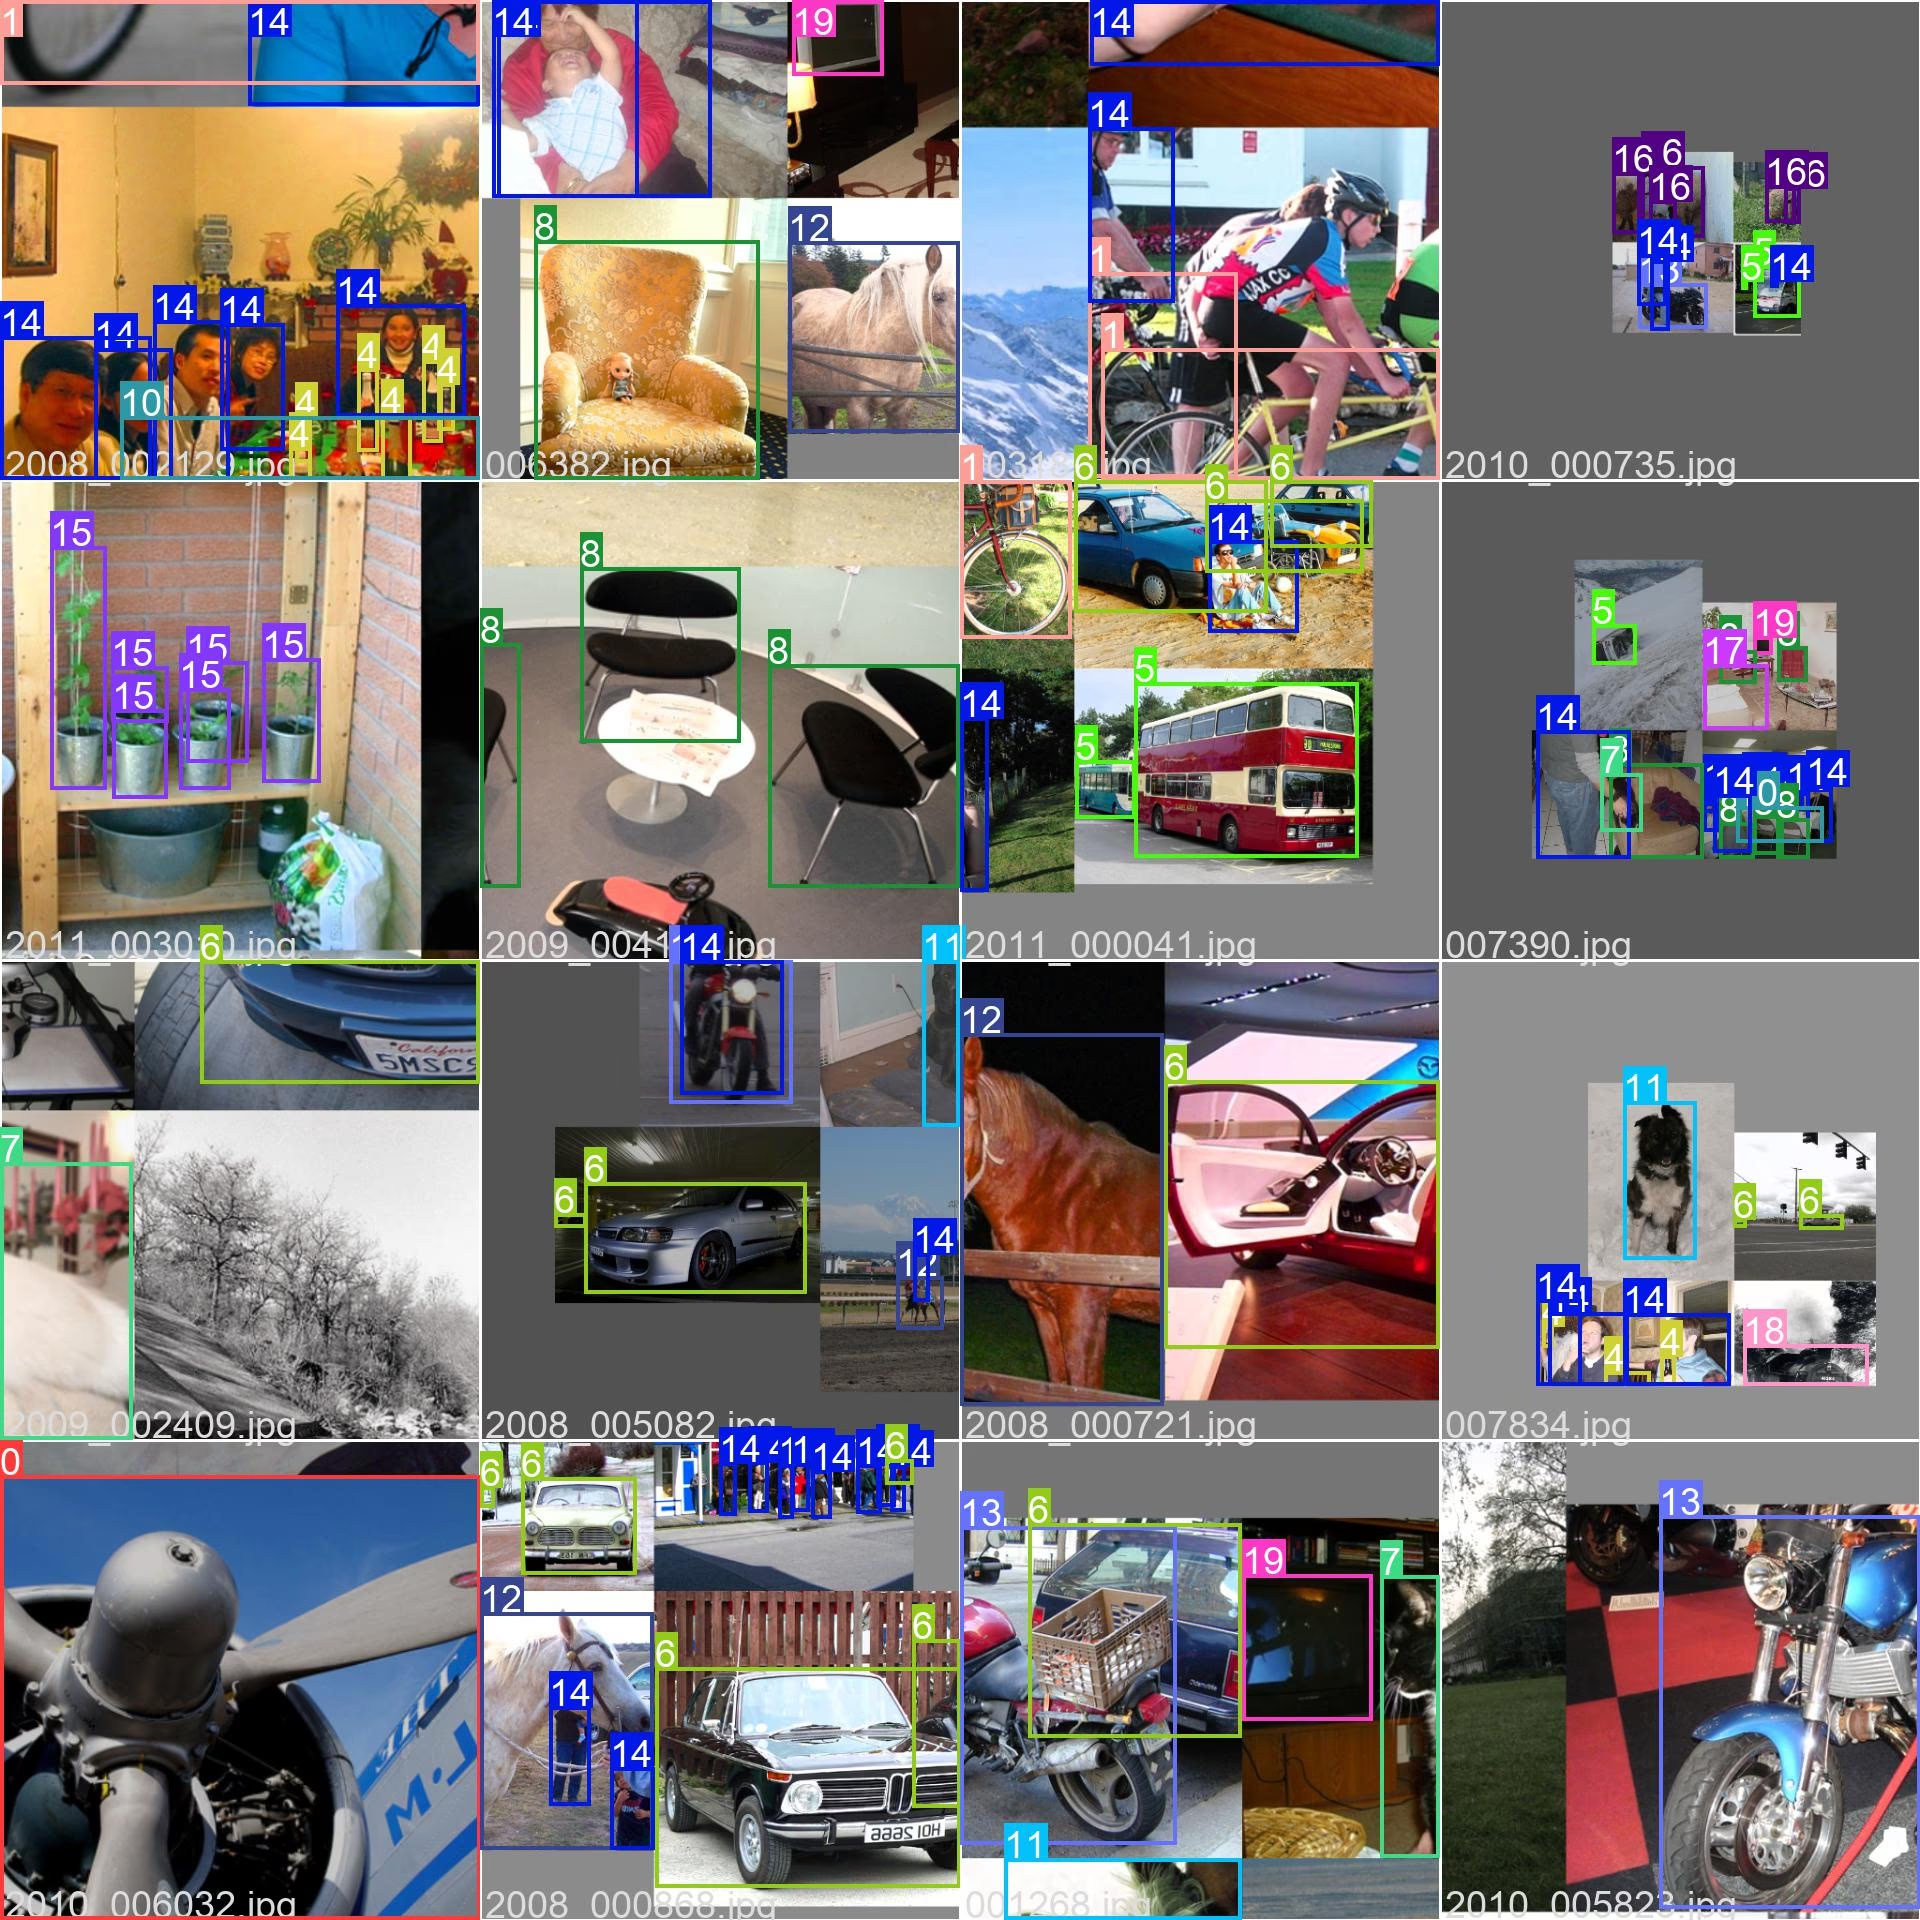
A imagem abaixo mostra um lote de treinamento em mosaico do conjunto de dados VOC. A criação de mosaicos combina várias imagens em uma única amostra de treinamento, aumentando a variedade de objetos, escalas e contextos de cena que o modelo vê em cada lote — consulte o guia de aumento de dados do YOLO para saber mais.
Se você usar o conjunto de dados VOC em suas pesquisas ou no seu trabalho de desenvolvimento, cite o artigo a seguir:
Citação
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Gostaríamos de agradecer ao Consórcio PASCAL VOC por criar e manter este valioso recurso para a comunidade de visão computacional. Para saber mais sobre o conjunto de dados VOC e seus criadores, acesse o site do conjunto de dados PASCAL VOC.
PASCAL VOC é usado para treinar e avaliar modelos de detecção de objetos em 20 classes de objetos do quotidiano, como pessoa, carro, cão e cadeira. Por ser compacto, totalmente rotulado e apoiado por anos de resultados de referência publicados, é uma escolha frequente para validar novas arquiteturas, realizar experiências em trabalhos académicos e fazer estudos rápidos de aprendizagem por transferência.
A configuração VOC da Ultralytics contém 21.503 imagens: 16.551 para treinamento (VOC2007 trainval + VOC2012 trainval) e 4.952 para validação (o conjunto de teste VOC2007). Todas as divisões compartilham as mesmas 20 classes. Consulte a Estrutura do conjunto de dados para ver a discriminação completa.
O VOC é baixado automaticamente na primeira vez que você treina com data="VOC.yaml" — não é necessário fazer nada manualmente. O script obtém três arquivos compactados (2,8 GB) dos recursos de lançamento do Ultralytics GitHub e converte as anotações XML para o formato YOLO.
Treine um modelo YOLO26n no VOC por 100 épocas com um tamanho de imagem de 640:
Exemplo de treino
from ultralytics import YOLO

# Carregar um modelo
model = YOLO("yolo26n.pt")  # carregue um modelo pré-treinado (recomendado para treinamento)

# Treinar o modelo
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
Os dois desafios compartilham as mesmas 20 classes, mas incluem imagens diferentes. O VOC2007 oferece 5.011 imagens de trainval, além de um conjunto de teste com 4.952 imagens cujas anotações são públicas; o VOC2012 oferece 11.540 imagens de trainval, enquanto as anotações de teste são restritas e avaliadas apenas pelo servidor oficial de avaliação. A configuração VOC.yaml da Ultralytics combina os dois conjuntos trainval para treinamento e valida com o conjunto de teste VOC2007.
VOC é menor e mais simples: 20 classes e 21.503 imagens, em comparação com as 80 classes e 330 mil imagens do COCO. Os resultados de VOC são tradicionalmente apresentados como mAP a 0,5 IoU, enquanto COCO calcula a média de mAP em limiares de IoU de 0,5 a 0,95. VOC permite treinar muito mais rapidamente e é adequado para experiências rápidas; o conjunto de dados COCO é o padrão para benchmarking em escala de produção.
Não — VOC.yaml é uma configuração exclusiva de detecção: o conversor extrai caixas delimitadoras das anotações XML do VOC, mas não converte as máscaras de segmentação incluídas no benchmark original. Para treinar um modelo de segmentação de instâncias, usa um conjunto de dados com rótulos poligonais, como COCO-Seg, com um modelo YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
Os cookies nos ajudam a saber quais documentos, modelos e recursos são úteis para você, para que possamos continuar aprimorando-os. Escolha o que compartilhar em ou leia nossa Política de privacidade.


mengdxiran
 Glenn JocherUltralytics
YustasDev