Краткое руководство: NVIDIA DGX Spark с Ultralytics YOLO26
В этом руководстве описано развёртывание Ultralytics YOLO26 на NVIDIA DGX Spark — компактном настольном суперкомпьютере NVIDIA для ИИ. В руководстве также приведены результаты тестирования YOLO11 в разных форматах экспорта на этой системе.
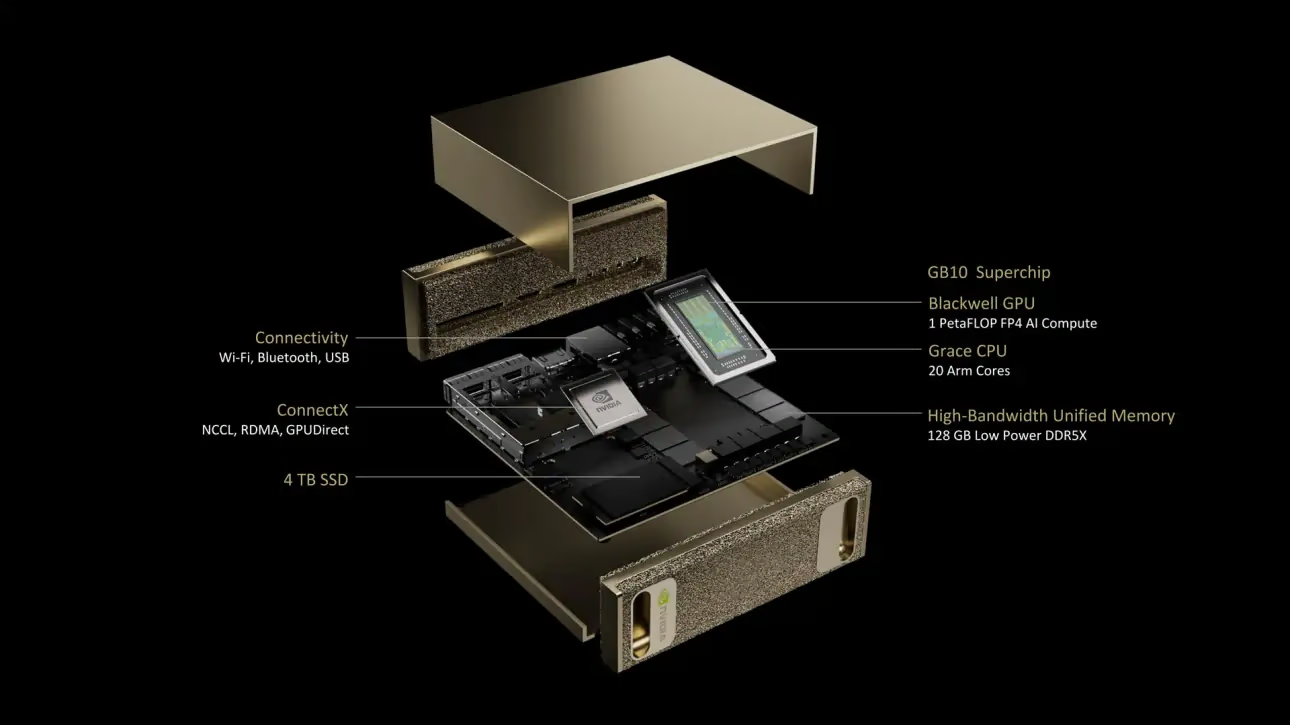
Это руководство проверено на NVIDIA DGX Spark Founders Edition с DGX OS на базе Ubuntu. Оно также должно работать с последними выпусками DGX OS.
Что такое NVIDIA DGX Spark?#
NVIDIA DGX Spark — компактный настольный суперкомпьютер для ИИ на базе суперкристалла NVIDIA GB10 Grace Blackwell. Он обеспечивает до 1 петафлопа вычислительной производительности для ИИ с точностью FP4 и предназначен для разработчиков, исследователей и специалистов по данным, которым нужны мощные возможности ИИ в формате настольного компьютера.
Смотри: Как добиться до 1000 FPS с Ultralytics YOLO26 на NVIDIA DGX Spark | TensorRT и инференс с пакетной обработкой
Основные характеристики#
| Характеристика | Описание |
|---|---|
| Производительность ИИ | До 1 PFLOP (FP4) |
| GPU | Архитектура NVIDIA Blackwell с тензорными ядрами 5-го поколения и RT-ядрами 4-го поколения |
| CPU | 20-ядерный процессор Arm (10 Cortex-X925 + 10 Cortex-A725) |
| Память | 128 ГБ унифицированной системной памяти LPDDR5x, 256-битный интерфейс, 4266 МГц, пропускная способность 273 ГБ/с |
| Хранилище | NVMe M.2 на 1 ТБ или 4 ТБ с самошифрованием |
| Сеть | 1x RJ-45 (10 GbE), интеллектуальная сетевая карта ConnectX-7, Wi-Fi 7, Bluetooth 5.4 |
| Подключение | 4x USB Type-C, 1x HDMI 2.1a, многоканальный звук HDMI |
| Обработка видео | 1x NVENC, 1x NVDEC |
DGX OS#
NVIDIA DGX OS — специализированный дистрибутив Linux, обеспечивающий стабильную, проверенную и поддерживаемую основу операционной системы для запуска приложений ИИ, машинного обучения и аналитики на системах DGX. В него входят:
- Надёжная основа Linux, оптимизированная для рабочих нагрузок ИИ
- Предварительно настроенные драйверы и системные параметры для оборудования NVIDIA
- Обновления безопасности и средства обслуживания системы
- Совместимость с широкой программной экосистемой NVIDIA
DGX OS выпускается по регулярному графику: обновления обычно выходят дважды в год (примерно в феврале и августе), а между основными выпусками предоставляются дополнительные исправления безопасности.
Панель управления DGX#
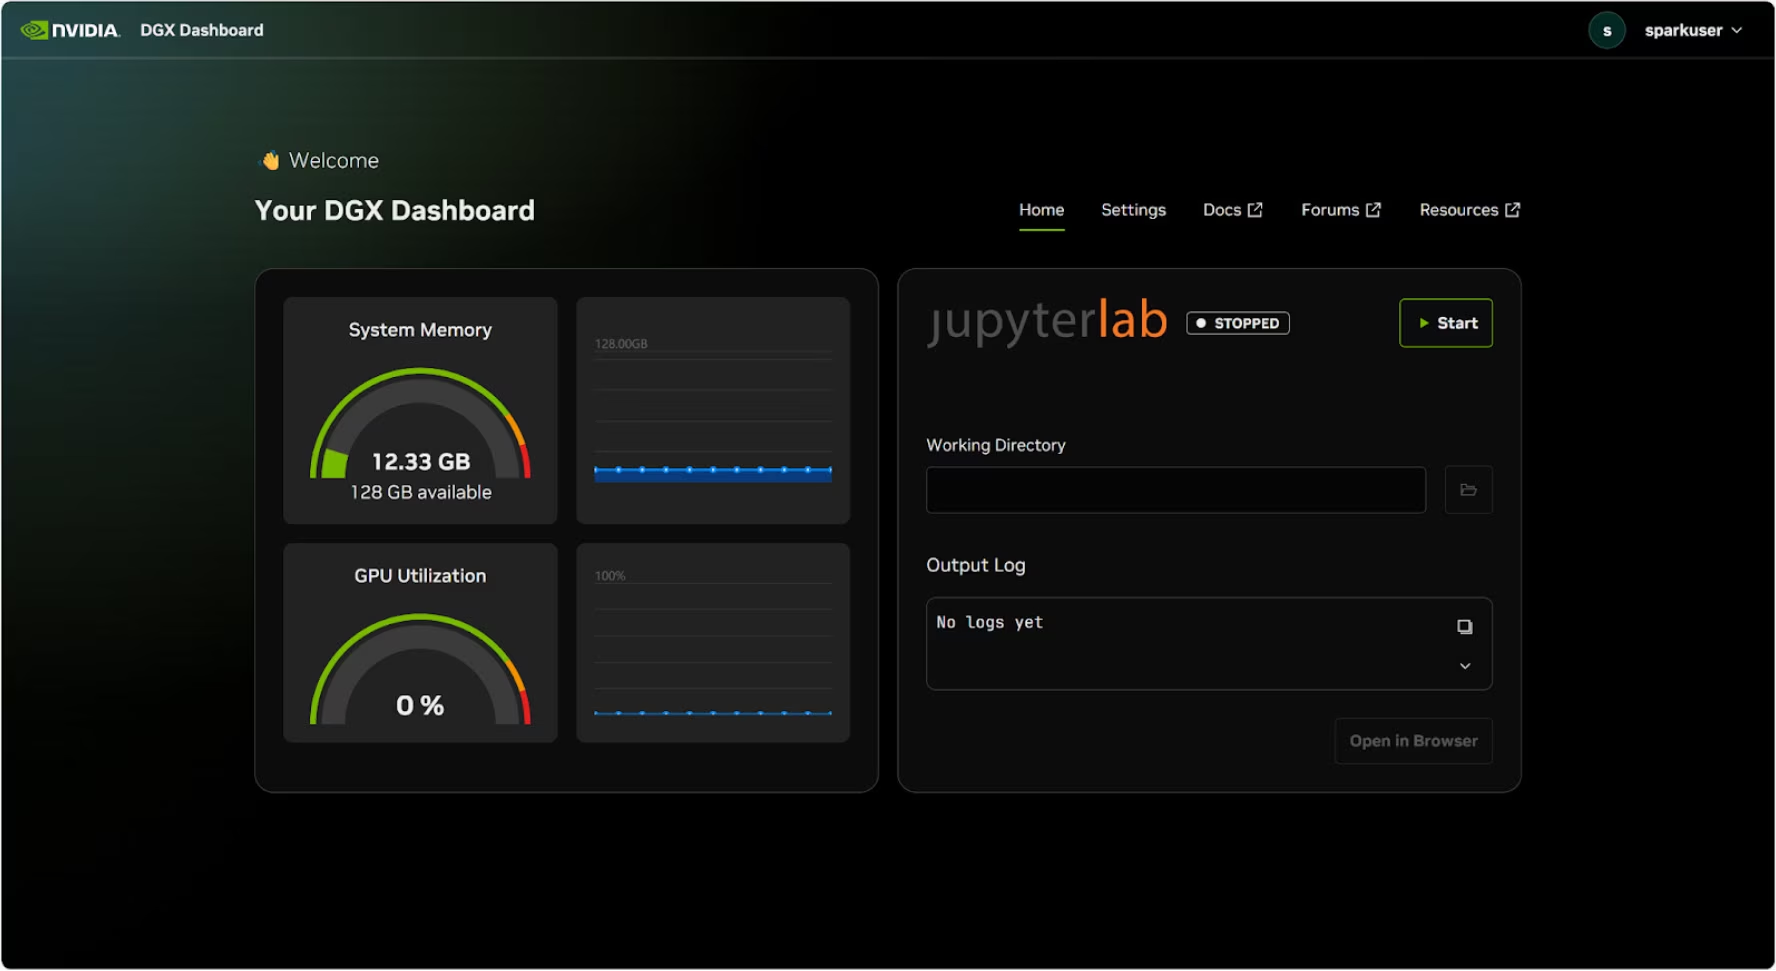
В DGX Spark встроена панель управления DGX, которая предоставляет:
- Мониторинг системы в реальном времени: обзор текущих рабочих показателей системы
- Обновления системы: возможность устанавливать обновления прямо из панели управления
- Настройки системы: изменение имени устройства и других параметров
- Встроенный JupyterLab: доступ к локальным ноутбукам Jupyter для разработки
Доступ к панели управления#
Нажми кнопку «Показать приложения» в левом нижнем углу рабочего стола Ubuntu, затем выбери «Панель управления DGX», чтобы открыть её в браузере.
Панель управления включает встроенный экземпляр JupyterLab, который при запуске автоматически создаёт виртуальное окружение и устанавливает рекомендуемые пакеты. Для каждого аккаунта пользователя выделяется отдельный порт для доступа к JupyterLab.
Быстрый старт с Docker#
Самый быстрый способ начать работу с Ultralytics YOLO26 на NVIDIA DGX Spark — запустить готовые образы Docker. Образ NVIDIA ARM64 поддерживает DGX Spark с DGX OS.
t=ultralytics/ultralytics:latest-nvidia-arm64
sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all $t
Указанный выше запрос устройства CDI применим к DGX Spark под управлением DGX OS. Сведения о требованиях к хост-системе и ограничении TensorRT для рабочих нагрузок PyTorch на Jetson AGX Thor см. в отдельном руководстве по NVIDIA Jetson.
В этом образе используются NVIDIA PyTorch 26.10, CUDA 13.4 и TensorRT 11.4. Обнови драйвер хоста DGX OS до версии, поддерживаемой NVIDIA PyTorch 26.10, и пересобирай движки TensorRT после смены образа или целевого GPU.
После этого перейди к разделу Использование TensorRT на NVIDIA DGX Spark.
Начни с нативной установки#
Чтобы установить систему без Docker, выполни следующие шаги.
Установка пакета Ultralytics#
Здесь мы установим пакет Ultralytics на DGX Spark. Зависимости для экспорта устанавливаются автоматически при первом экспорте модели, поэтому здесь достаточно базового пакета. Это руководство посвящено экспорту в NVIDIA TensorRT, поскольку TensorRT обеспечивает максимальную производительность на DGX Spark.
-
Обнови список пакетов, установи pip и обнови его до последней версии
sudo apt update sudo apt install python3-pip -y pip install -U pip -
Установи пакет
ultralyticsчерез pippip install ultralytics -
Перезагрузи устройство
sudo reboot
Установка PyTorch и Torchvision#
Приведённая выше команда ultralytics устанавливает PyTorch и Torchvision. Однако пакеты, установленные через pip, могут быть не полностью оптимизированы для архитектуры ARM64 с CUDA 13 в DGX Spark. Поэтому мы рекомендуем установить версии, совместимые с CUDA 13:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130При запуске PyTorch 2.9.1 на NVIDIA DGX Spark при инициализации CUDA может появиться следующее UserWarning (например, при запуске yolo checks, yolo predict и т. д.):
UserWarning: Found GPU0 NVIDIA GB10 which is of cuda capability 12.1.
Minimum and Maximum cuda capability supported by this version of PyTorch is (8.0) - (12.0)
Это предупреждение можно спокойно игнорировать.
Установи onnxruntime-gpu#
В актуальных выпусках ONNX Runtime GPU доступны колёса Linux ARM64, в том числе для Python 3.12. В Docker-образе NVIDIA ARM64 устанавливается официальный пакет; для нативной установки с CUDA 13 используй:
pip install onnxruntime-gpuИспользование TensorRT на NVIDIA DGX Spark#
Из всех поддерживаемых Ultralytics форматов экспорта моделей TensorRT обеспечивает наивысшую производительность инференса на NVIDIA DGX Spark и поэтому является нашей основной рекомендацией для развёртывания.
Преобразование модели в TensorRT и запуск инференса#
Модель YOLO26n в формате PyTorch преобразуется в TensorRT, после чего экспортированная модель используется для инференса.
from ultralytics import YOLO

# Загрузи модель YOLO26n в формате PyTorch
model = YOLO("yolo26n.pt")

# Экспортируй модель в TensorRT FP16
model.export(format="engine", quantize=16)  # создаёт 'yolo26n.engine'

# Загрузи экспортированную модель TensorRT
trt_model = YOLO("yolo26n.engine")

# Выполнить инференс
results = trt_model("https://ultralytics.com/images/bus.jpg")
Результаты тестирования YOLO11 на NVIDIA DGX Spark#
Команда Ultralytics провела тесты производительности YOLO11 в нескольких форматах моделей, сравнив скорость и точность: PyTorch, TorchScript, ONNX, OpenVINO, TensorRT, TF SavedModel, TF GraphDef, TF Lite, MNN, NCNN и ExecuTorch. Тесты выполнялись на NVIDIA DGX Spark с точностью FP32 и стандартным размером входного изображения 640.
Подробная сравнительная таблица#
В таблице ниже приведены результаты тестирования пяти разных моделей (YOLO11n, YOLO11s, YOLO11m, YOLO11l, YOLO11x) в нескольких форматах. Для каждой комбинации указаны статус, размер, метрика mAP50-95(B) и время инференса.
| Формат | Статус | Размер на диске (МБ) | mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.4 | 0.5071 | 2.67 |
| TorchScript | ✅ | 10.5 | 0.5083 | 2.62 |
| ONNX | ✅ | 10.2 | 0.5074 | 5.92 |
| OpenVINO | ✅ | 10.4 | 0.5058 | 14.95 |
| TensorRT (FP32) | ✅ | 12.8 | 0.5085 | 1.95 |
| TensorRT (FP16) | ✅ | 7.0 | 0.5068 | 1.01 |
| TensorRT (INT8) | ✅ | 18.6 | 0.4880 | 1.62 |
| TF SavedModel | ✅ | 25.7 | 0.5076 | 36.39 |
| TF GraphDef | ✅ | 10.3 | 0.5076 | 41.06 |
| TF Lite | ✅ | 10.3 | 0.5075 | 64.36 |
| MNN | ✅ | 10.1 | 0.5075 | 12.14 |
| NCNN | ✅ | 10.2 | 0.5041 | 12.31 |
| ExecuTorch | ✅ | 10.2 | 0.5075 | 27.61 |
Тестирование проведено с Ultralytics 8.3.249
Воспроизведение наших результатов#
Чтобы воспроизвести приведённые выше тесты Ultralytics для всех форматов экспорта моделей, выполни этот код:
from ultralytics import YOLO

# Загрузи модель YOLO26n в формате PyTorch
model = YOLO("yolo26n.pt")

# Сравнение скорости и точности YOLO26n на наборе данных COCO128 для всех форматов экспорта
results = model.benchmark(data="coco128.yaml", imgsz=640)
Учти, что результаты бенчмарков могут различаться в зависимости от конкретной конфигурации оборудования и программного обеспечения системы, а также от текущей нагрузки на систему во время запуска бенчмарков. Для получения наиболее надёжных результатов используй набор данных с большим количеством изображений, например data='coco.yaml' (5000 валидационных изображений).
Точность TensorRT для YOLO26 на DGX Spark#
При размере пакета 1 на DGX Spark TensorRT INT8 работает медленнее, чем FP16, для YOLO26n и YOLO26s и примерно так же быстро для YOLO26m (разница не превышает 2% как при валидации, так и по времени вычислений на GPU в trtexec). Точность INT8 также ниже на 1,1–1,8 mAP, поэтому для этих моделей лучше выбрать FP16. В таблице YOLO11 выше видна та же закономерность: TensorRT (INT8) работает медленнее TensorRT (FP16) для всех пяти моделей.
| Модель | Формат | Размер на диске (МБ) | mAP50-95(B) | Время инференса (мс/изобр.) |
|---|---|---|---|---|
| YOLO26n | TensorRT (FP16) | 6.7 | 0.4032 | 0.79 |
| YOLO26n | TensorRT (INT8) | 28.4 | 0.3849 | 1.43 |
| YOLO26s | TensorRT (FP16) | 20.3 | 0.4793 | 1.49 |
| YOLO26s | TensorRT (INT8) | 34.4 | 0.4644 | 1.73 |
| YOLO26m | TensorRT (FP16) | 41.1 | 0.5266 | 2.70 |
| YOLO26m | TensorRT (INT8) | 45.0 | 0.5156 | 2.74 |
Точность и скорость получены при валидации на COCO val2017 (5000 изображений) с размером изображения 640 и размером пакета 1. Движки INT8 откалиброваны на COCO128. Тестирование выполнено с Ultralytics 8.4.192 в ultralytics/ultralytics:latest-nvidia-arm64 (NVIDIA PyTorch 26.08, TensorRT 11.2.1.2, ModelOpt 0.45.0).
Рекомендации по работе с NVIDIA DGX Spark#
При работе с NVIDIA DGX Spark следуй этим рекомендациям, чтобы добиться максимальной производительности YOLO26.
-
Следи за производительностью системы
Используй инструменты мониторинга NVIDIA, чтобы отслеживать загрузку GPU и CPU:
nvidia-smi -
Оптимизируй использование памяти
Благодаря 128 ГБ объединённой памяти DGX Spark может обрабатывать большие размеры пакетов и модели. Для увеличения пропускной способности попробуй повысить размер пакета:
from ultralytics import YOLO model = YOLO("yolo26n.engine") results = model.predict(source="path/to/images", batch=16) -
Используй TensorRT FP16
При размере пакета 1 на DGX Spark INT8 работает медленнее, чем FP16, для YOLO26n и YOLO26s, не быстрее для YOLO26m и обеспечивает меньшую точность (см. раздел Точность TensorRT для YOLO26 на DGX Spark):
yolo export model=yolo26n.pt format=engine quantize=16 # FP16
Обновления системы (Founders Edition)#
Поддержание актуального состояния DGX Spark Founders Edition важно для производительности и безопасности. NVIDIA предлагает два основных способа обновить ОС системы, драйверы и встроенное ПО.
Через панель управления DGX (рекомендуется)#
Рекомендуемый способ установки системных обновлений с обеспечением совместимости — использовать панель управления DGX. С её помощью можно:
- Просматривать доступные обновления системы
- Устанавливать исправления безопасности и обновления системы
- Управлять обновлениями драйверов и встроенного ПО NVIDIA
Обновление системы вручную#
Опытные пользователи могут устанавливать обновления вручную через терминал:
sudo apt update
sudo apt dist-upgrade
sudo fwupdmgr refresh
sudo fwupdmgr upgrade
sudo rebootПеред обновлением убедись, что система подключена к надёжному источнику питания, а критически важные данные сохранены в резервной копии.
Следующие шаги#
Дополнительные материалы и помощь см. в документации Ultralytics YOLO26.
Часто задаваемые вопросы#
Развернуть Ultralytics YOLO26 на NVIDIA DGX Spark несложно. Для быстрой настройки можно использовать готовый Docker-образ или установить необходимые пакеты вручную. Подробные инструкции для обоих способов приведены в разделах Быстрый старт с Docker и Начало работы с нативной установкой.
Модели YOLO быстро работают на DGX Spark благодаря суперчипу GB10 Grace Blackwell. Формат TensorRT обеспечивает наилучшую производительность инференса. Ознакомься с разделом Подробная сравнительная таблица, чтобы узнать результаты тестирования YOLO11 на DGX Spark для моделей разных размеров и форматов, и с разделом Точность TensorRT для YOLO26 на DGX Spark, где приведены результаты для YOLO26 FP16 и INT8.
Для развёртывания моделей YOLO26 на DGX Spark рекомендуется TensorRT: он обеспечивает самый быстрый инференс среди поддерживаемых форматов экспорта, используя тензорные ядра GPU Blackwell с точностью FP16 или INT8.
DGX Spark обеспечивает до 1 PFLOP производительности ИИ и оснащён 128 ГБ объединённой памяти, тогда как NVIDIA Jetson AGX Thor обеспечивает 2070 TFLOPS и имеет 128 ГБ памяти. DGX Spark — настольный суперкомпьютер для ИИ, а устройства Jetson — встраиваемые системы, оптимизированные для развёртывания на периферии.
Для задач PyTorch
ultralytics/ultralytics:latest-nvidia-arm64поддерживает DGX Spark с DGX OS и Thor с JetPack 7.1. Входящий в комплект TensorRT 11.4 не поддерживает JetPack, поэтому для рабочих процессов TensorRT на Jetson необходимо использовать среду выполнения TensorRT 10.x, поддерживаемую соответствующей версией JetPack. См. требования к Docker для Jetson.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.