Потокобезопасный инференс с моделями YOLO
Чтобы безопасно запускать инференс Ultralytics YOLO в потоках Python, создавай отдельный экземпляр модели YOLO в каждом потоке, а не используй один экземпляр совместно. Совместное использование одного экземпляра модели приводит к состояниям гонки, которые повреждают внутреннее состояние модели и вызывают непредсказуемые результаты, поскольку модуль threading в Python одновременно запускает потоки с одним и тем же объектом. В этом руководстве объясняется, почему совместное использование не работает, приводится безопасный шаблон с отдельным экземпляром для каждого потока и рассматривается декоратор ThreadingLocked для случаев, когда экземпляр необходимо использовать совместно.
Перейди к разделу почему совместное использование модели не работает, потокобезопасному шаблону или декоратору ThreadingLocked.
Смотри: Как выполнять потокобезопасный инференс с моделями Ultralytics YOLO в Python | Многопоточность 🚀
Основы потоков Python#
Потоки Python позволяют программе выполнять несколько операций одновременно. Однако глобальная блокировка интерпретатора Python (GIL) означает, что в каждый момент времени только один поток может выполнять байт-код Python.
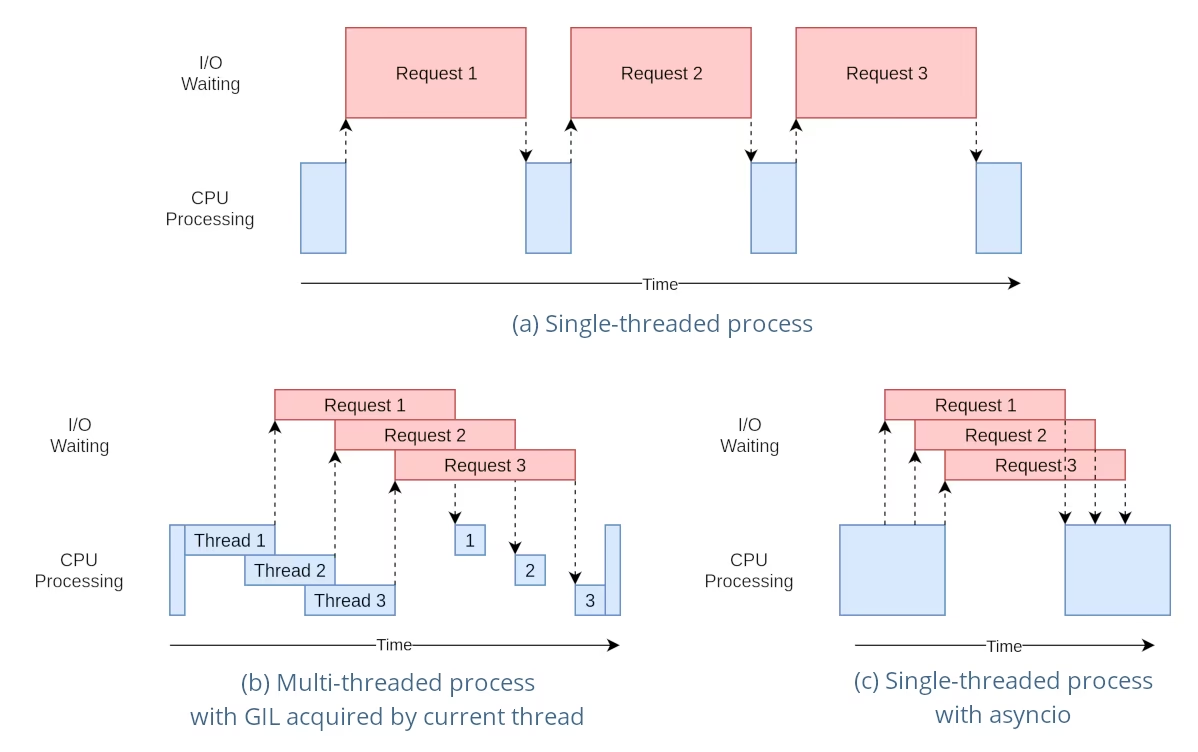
Хотя это может показаться ограничением, потоки всё же обеспечивают конкурентное выполнение, особенно для операций, ограниченных вводом-выводом, и операций, освобождающих GIL, например тех, которые выполняют базовые библиотеки C, используемые YOLO.
Риски совместного использования экземпляров модели#
Создание модели YOLO вне потоков и совместное использование её экземпляра несколькими потоками может привести к состояниям гонки: внутреннее состояние модели будет изменяться непоследовательно из-за одновременного доступа. Это особенно проблематично, если модель или её компоненты хранят состояние, не рассчитанное на потокобезопасное использование.
Небезопасный пример: один экземпляр модели#
При использовании потоков в Python важно распознавать шаблоны, которые могут привести к проблемам конкурентного выполнения. Вот чего следует избегать: совместного использования одного экземпляра модели YOLO26 несколькими потоками.
# Небезопасно: совместное использование одного экземпляра модели в нескольких потоках
from threading import Thread

from ultralytics import YOLO

# Создание экземпляра модели вне потока
shared_model = YOLO("yolo26n.pt")

def predict(image_path):
    """Predicts objects in an image using a preloaded YOLO model, take path string to image as argument."""
    results = shared_model.predict(image_path)
    # Обработать результаты

# Запуск потоков, использующих один и тот же экземпляр модели
Thread(target=predict, args=("image1.jpg",)).start()
Thread(target=predict, args=("image2.jpg",)).start()
В примере выше оба потока используют общий shared_model. Каждый вызов predict сохраняет собственные аргументы, такие как conf, iou и imgsz, но вызовы с одним и тем же предиктором выполняются по очереди, блокируясь на его блокировке, поэтому потоки почти не получают преимуществ от параллельной работы. Состояние экземпляра, например состояние трекера, словари set_classes YOLOE или подсказки SAM, FastSAM и YOLOE, по-прежнему общее для всех потоков, поэтому для таких задач выделяй каждому потоку собственный экземпляр.
Безопасный пример: отдельный экземпляр для каждого потока#
Можно использовать несколько отдельных экземпляров модели, если у каждого потока есть собственный экземпляр, которым он не делится с другими потоками. Неважно, что приведенные ниже экземпляры создаются до запуска потоков: небезопасно только совместное использование одного экземпляра несколькими потоками.
# Безопасно: каждый поток использует собственный экземпляр модели
from threading import Thread

from ultralytics import YOLO

# Создание отдельной модели для каждого потока
model_1 = YOLO("yolo26n.pt")
model_2 = YOLO("yolo26n.pt")

def predict(model, image_path):
    """Runs prediction on an image using a specified YOLO model, returning the results."""
    results = model.predict(image_path)
    # Обработать результаты

# Каждый поток использует отдельный экземпляр модели
Thread(target=predict, args=(model_1, "image1.jpg")).start()
Thread(target=predict, args=(model_2, "image2.jpg")).start()
Поскольку каждый поток работает со своим экземпляром, у потоков нет общего состояния модели, которое они могли бы повредить. Создание экземпляра модели внутри каждого потока, как показано далее, — самый простой способ гарантировать, что экземпляр не будет случайно использоваться совместно.
Потокобезопасный инференс#
Чтобы выполнять потокобезопасный инференс, создавай отдельную модель YOLO в каждом потоке. Так у каждого потока будет собственный изолированный экземпляр модели, что исключит риск состояний гонки.
Потокобезопасный пример#
Вот как создать модель YOLO в каждом потоке для безопасного параллельного инференса:
# Безопасно: создание отдельного экземпляра модели в каждом потоке
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Predict on an image using a new YOLO model instance in a thread-safe manner; takes image path as input."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Обработать результаты

# Запуск потоков, каждый из которых использует собственный экземпляр модели
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
В этом примере каждый поток создает собственный экземпляр YOLO. Это не позволяет потокам влиять на состояние модели друг друга и гарантирует, что каждый поток выполняет инференс безопасно, без непредвиденного взаимодействия с другими потоками.
Использование декоратора ThreadingLocked#
В Ultralytics есть декоратор ThreadingLocked, который помогает обеспечить потокобезопасное выполнение функций. Декоратор использует блокировку, чтобы функцию с этим декоратором в каждый момент времени мог выполнять только один поток.
from ultralytics import YOLO
from ultralytics.utils import ThreadingLocked

# Создание экземпляра модели
model = YOLO("yolo26n.pt")

# Добавление декоратора к функции предсказания для обеспечения потокобезопасности
@ThreadingLocked()
def thread_safe_predict(image_path):
    """Thread-safe prediction using a shared model instance."""
    results = model.predict(image_path)
    return results

# Теперь эту функцию можно безопасно вызывать из нескольких потоков
Декоратор ThreadingLocked особенно полезен, когда нужно совместно использовать экземпляр модели между потоками, но при этом важно, чтобы к нему одновременно обращался только один поток.
Совместное использование одного экземпляра модели с блокировкой экономит память по сравнению с загрузкой модели в каждом потоке, но снижает конкурентность, поскольку потоки по очереди ждут освобождения блокировки. Если памяти достаточно и нужна максимальная параллельность, используй отдельный экземпляр для каждого потока. Если объем памяти, необходимый модели, становится узким местом, используй ThreadingLocked.
Заключение#
При использовании моделей YOLO с threading в Python выделяй каждому потоку отдельный экземпляр модели и никогда не используй один экземпляр в нескольких потоках. Проще всего гарантировать это, создавая модель внутри потока, который её использует: так ты избежишь состояний гонки и обеспечишь надежное выполнение задач инференса.
Для более сложных сценариев и дальнейшей оптимизации производительности многопоточного инференса используй параллелизм на основе процессов с помощью multiprocessing или очередь задач с отдельными рабочими процессами.
Часто задаваемые вопросы#
Чтобы избежать состояний гонки при использовании моделей Ultralytics YOLO в многопоточной среде Python, создавай отдельный экземпляр модели YOLO в каждом потоке. Так у каждого потока будет изолированный экземпляр модели, что исключает одновременное изменение её состояния.
Пример:
from threading import Thread from ultralytics import YOLO def thread_safe_predict(image_path): """Predict on an image in a thread-safe manner.""" local_model = YOLO("yolo26n.pt") results = local_model.predict(image_path) # Обработать результаты Thread(target=thread_safe_predict, args=("image1.jpg",)).start() Thread(target=thread_safe_predict, args=("image2.jpg",)).start()Чтобы безопасно выполнять многопоточный инференс моделей YOLO в Python, придерживайся следующих рекомендаций:
- Создавай модели YOLO в каждом потоке, а не используй один экземпляр совместно несколькими потоками.
- Для параллельной обработки используй модуль
multiprocessingPython, чтобы избежать проблем, связанных с глобальной блокировкой интерпретатора (GIL). - Помни, что базовые библиотеки C, используемые YOLO (PyTorch, OpenCV), автоматически освобождают GIL при интенсивных вычислениях, поэтому потоки всё равно могут выполнять инференс одновременно.
- Если тебя беспокоит расход памяти, используй декоратор
ThreadingLockedдля совместно используемых экземпляров модели.
Пример потокобезопасного создания экземпляра модели:
from threading import Thread

from ultralytics import YOLO

def thread_safe_predict(image_path):
    """Runs inference in a thread-safe manner with a new YOLO model instance."""
    local_model = YOLO("yolo26n.pt")
    results = local_model.predict(image_path)
    # Обработать результаты

# Запуск нескольких потоков
Thread(target=thread_safe_predict, args=("image1.jpg",)).start()
Thread(target=thread_safe_predict, args=("image2.jpg",)).start()
Дополнительные сведения см. в разделе о потокобезопасном инференсе.
У каждого потока должен быть собственный экземпляр модели YOLO, чтобы избежать состояний гонки. Когда один экземпляр модели используется несколькими потоками, одновременный доступ может привести к непредсказуемому поведению и изменению внутреннего состояния модели. Отдельные экземпляры изолируют потоки и делают многопоточные задачи надежными и безопасными.
Подробные инструкции см. в разделах «Небезопасный пример: один экземпляр модели» и «Потокобезопасный пример».
Глобальная блокировка интерпретатора Python (GIL) позволяет только одному потоку за раз выполнять байт-код Python, что может снизить производительность многопоточных задач с высокой нагрузкой на CPU. Однако конкурентное выполнение всё же возможно для операций, ограниченных вводом-выводом, или процессов, использующих библиотеки, которые освобождают GIL, например базовые библиотеки C, используемые YOLO. Для повышения производительности рассмотрите параллелизм на основе процессов с помощью модуля
multiprocessingPython.Подробнее о потоках в Python читай в разделе «Основы потоков Python».
Да, модуль
multiprocessingPython — более безопасный и зачастую эффективный способ параллельного инференса моделей YOLO. Параллелизм на основе процессов создает отдельные области памяти, позволяет не зависеть от глобальной блокировки интерпретатора (GIL) и снижает риск проблем при конкурентном выполнении. Каждый процесс работает независимо со своим экземпляром модели YOLO.


Комментарии12
Задай вопрос, поделись результатами или помоги кому-нибудь.
amani784
I used a YOLOv8 model optimized with TensorRT on an AWS machine with a Tesla T4 GPU to detect people in multiple videos. The model is loaded once per process using an initializer function. To improve performance, I parallelized the video processing using 4 processes from the multiprocessing module, where each process handles one video and performs inference using model.predict() on frames sampled at regular intervals. However, this approach led to a decrease in overall performance, with slower processing time per frame and reduced FPS. Is this normal, and if not, what is the solution?
warptengood
I have a few questions:
- Does the rules about thread-safety apply in the same way to TensorRT/ONNX inference of YOLO?
- Should I have the shared model for all threads when using TensorRT YOLO? (In case the answer for the 1st question is 'No'.)
- Is it true that it is better to have
streamparameter to be set toFalsewhen performing inference on TensorRT (inpredict()) - How
torch.cuda.Stream()affects the performance of multi-threading/multi-processing when used onpredict()/track()functions? - Should I have any sort of warm up for TensorRT inference before utilizing a model in any thread/process? (Like making inference on dummy input)
P.S: I want to thank all the Ultralytics team for their kindness and open-mindedness when it comes to help and support their community. You guys are always eager to help. And I don't care if it is some AI agent that's replying or a real person, I am very grateful for you for what you guys doing :D
 Glenn JocherUltralytics
@KenesYerassyl Thank you for your great questions about thread safety with TensorRT/ONNX models. Let me address each one:
-
Yes, the thread-safety principles apply similarly to TensorRT/ONNX models, but with important distinctions. TensorRT engines have their own memory management which can introduce additional concurrency concerns.
-
For TensorRT models, it's generally safer to use separate engine instances per thread or use a thread locking mechanism like our
ThreadingLockeddecorator. TensorRT engines maintain internal state during inference that can cause issues with concurrent access. -
Setting
stream=Falsefor TensorRT inference is often beneficial as it ensures complete processing of each input before handling another, which can help avoid resource conflicts in multi-threaded environments. -
Using
torch.cuda.Stream()with multi-threading can improve performance by allowing parallel execution of CUDA operations across different streams. However, you need to carefully manage synchronization points to prevent race conditions. Each thread should ideally use a separate CUDA stream. -
Yes, warming up TensorRT models is highly recommended. The first inference typically takes longer due to CUDA context initialization and memory allocations. Running inference on a dummy input before deploying in production or multi-threaded environments ensures consistent performance.
Thank you for your kind words about our team! We're committed to supporting the community with helpful resources and guidance.
-
Thank you very much for such a comprehensive reply!
mrbulb
Hello, is there any example code that uses Python's multiprocessing for YOLO model inference?
 Paula DerrengerUltralytics
@mrbulb for using Python's multiprocessing with YOLO model inference, you should instantiate a separate YOLO model within each process to avoid race conditions. This ensures each process has its own isolated model instance. For detailed guidance, please refer to our Thread-Safe Inference with YOLO Models page. If you need a specific code example, feel free to ask!
farrostaufiqur
how to use results differently for each thread?
- Paula DerrengerUltralytics
To use results differently for each thread, ensure each thread instantiates its own YOLO model instance. This prevents race conditions and ensures thread safety. For more details, please refer to our Thread-Safe Inference with YOLO Models guide.
ghost
Hello. Thanks for the info. I have a question, If I run in two terminals the same python script, but to two different videos, both processes still suffer from GIL ?
- Glenn JocherUltralytics
@cawilchesp running the same Python script in two separate terminals for different videos won't suffer from GIL issues, as each process has its own Python interpreter and memory space. This effectively bypasses the GIL, allowing true parallel execution. For more details, you can check out our guide on thread-safe inference: https://docs.ultralytics.com/guides/yolo-thread-safe-inference/.
abysshal
So what is the best practice for single-threaded processing with asyncio? For example, gunicron+gevent+flask is used to deal with highly concurrent requests, and only one Yolo model instance will be created in each worker process. Here we do not handle threads manually, we only provide the predict function for callback from gevent. Then will the predict function of the same model instance be called again on the next request when it is not completed due to an I/O wait operation on the current request? How we handle this safely? Does it matter if cpu of gpu is used for inference?
- Glenn JocherUltralytics(изменено)
@abysshal when using an asynchronous server like Gunicorn with Gevent and Flask, you're dealing with a cooperative multitasking environment. In such an environment, the context switches occur at well-defined points, typically I/O operations or explicit yield points. This means that your predict function will not be preempted in the middle of execution by another request unless it hits an I/O wait or a yield.
Here's how you can handle this safely:
-
Single Model Instance: Since you're creating only one YOLO model instance per worker process, you need to ensure that the predict function is designed to be re-entrant. This means that if the function is called again while a previous call is waiting for I/O, it should not cause any conflicts or unexpected behavior.
-
Asyncio Compatibility: If you're using asyncio, you should ensure that the predict function and any other code that might run concurrently are compatible with asyncio's event loop. This means using
awaitfor I/O-bound operations and ensuring that any libraries you use within the predict function are also compatible with asyncio. -
Thread Safety: Even though you're not manually handling threads, the underlying implementation of some libraries (like PyTorch) may use threads for certain operations. A single Ultralytics
YOLOmodel instance is not thread-safe, so do not share one instance across threads. Use one instance per thread or worker, or wrap the shared call with theThreadingLockeddecorator (see the thread-safe inference guide). -
Resource Locking: If there are shared resources that need to be accessed or modified during the predict function, you should use appropriate locking mechanisms to prevent race conditions. However, in an async environment, you should use async-compatible locks like
asyncio.Lock. -
CPU vs. GPU Inference: The choice between CPU and GPU can affect performance but should not affect the thread safety or the async behavior of your application. However, if you're using a GPU, you need to ensure that the library you're using for YOLO supports concurrent model inference on the GPU without conflicts.
-
Testing: Test your application under load to ensure that it behaves correctly with concurrent requests. You can use tools like
locustorab(Apache Bench) to simulate high concurrency and check for any race conditions or deadlocks.
In summary, when using Gunicorn with Gevent and Flask, you should ensure that your predict function is re-entrant and compatible with asyncio, use async-compatible locks if necessary, and test your application under load. The choice of CPU or GPU should not affect the thread safety of your application, but you should ensure that your YOLO model library supports concurrent inference on your chosen hardware.
1 -