Пошаговое руководство по обучению моделей YOLO26 с IBM Watsonx
Для масштабируемых решений в области компьютерного зрения нужна инфраструктура для данных, обучения и развертывания. IBM Watsonx — платформа для ИИ и данных, поддерживающая разработку, развертывание и управление моделями ИИ. Она охватывает весь жизненный цикл ИИ и интегрируется с сервисами IBM Cloud.
Ты можешь обучать модели Ultralytics YOLO26 с помощью IBM Watsonx. Эта платформа подходит предприятиям, которым нужно эффективно обучать модели, настраивать их для конкретных задач и повышать производительность моделей с помощью надежных инструментов и удобной среды. В этом руководстве описано обучение YOLO26 с IBM Watsonx — от настройки среды до оценки обученных моделей.
Что такое IBM Watsonx?#
Watsonx — облачная платформа IBM для коммерческого генеративного ИИ и научных данных. Три компонента IBM Watsonx — watsonx.ai, watsonx.data и watsonx.governance — вместе образуют комплексную и надежную платформу ИИ, способную ускорить проекты по решению бизнес-задач. Она предоставляет инструменты для создания, обучения и развертывания моделей машинного обучения, а также упрощает подключение к различным источникам данных.
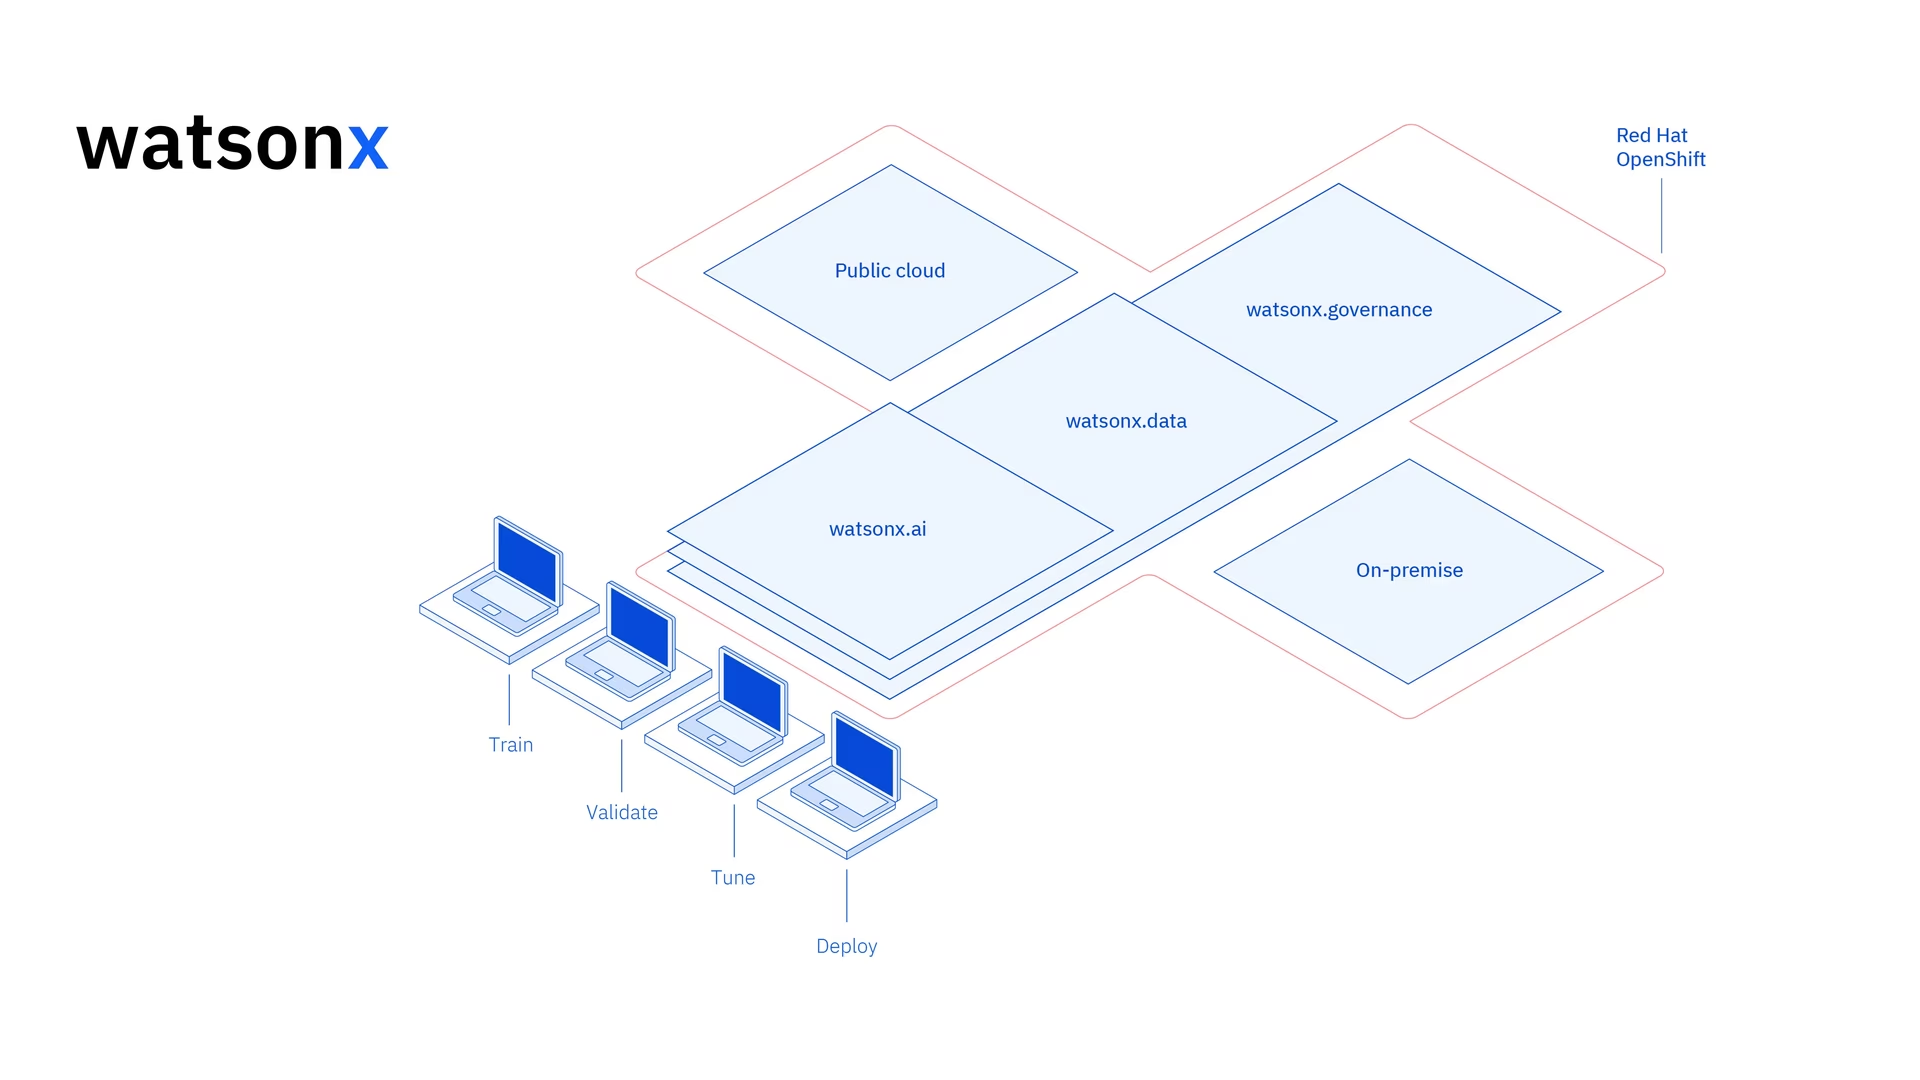
Интерфейс и возможности совместной работы поддерживают разработку, управление и развертывание моделей. IBM Watsonx применяется в компьютерном зрении, предиктивной аналитике, обработке естественного языка и других приложениях ИИ.
Основные возможности IBM Watsonx#
IBM Watsonx состоит из трех основных компонентов: watsonx.ai, watsonx.data и watsonx.governance. Каждый компонент отвечает за отдельный аспект ИИ и управления данными.
Watsonx.ai#
Watsonx.ai предоставляет инструменты для разработки ИИ и доступ к пользовательским моделям, поддерживаемым IBM, сторонним моделям, таким как Llama 3, и собственным моделям Granite от IBM. В него входят Prompt Lab для экспериментов с запросами к ИИ и Tuning Studio для повышения производительности моделей на размеченных данных. Кроме того, доступны комплексные инструменты для автоматизации жизненного цикла моделей ИИ и подключения к различным API и библиотекам.
Watsonx.data#
Watsonx.data поддерживает развёртывание как в облаке, так и локально. Удобная консоль обеспечивает централизованный доступ к данным в разных средах и упрощает их изучение с помощью стандартного SQL. Платформа оптимизирует нагрузки с помощью эффективных движков запросов, таких как Presto и Spark, ускоряет анализ данных с помощью семантического слоя на основе ИИ, включает векторную базу данных для повышения релевантности ИИ и поддерживает открытые форматы данных, упрощая обмен аналитическими данными и данными ИИ.
Watsonx.governance#
Watsonx.governance упрощает обеспечение соответствия требованиям, автоматически выявляя изменения в нормативных актах и обеспечивая соблюдение политик. Он связывает требования с внутренними данными о рисках и предоставляет актуальные паспорта ИИ. Платформа помогает управлять рисками с помощью оповещений и инструментов для выявления таких проблем, как предвзятость и дрейф. Она также автоматизирует мониторинг и документирование жизненного цикла ИИ, упорядочивает разработку ИИ с помощью реестра моделей и упрощает совместную работу благодаря удобным панелям мониторинга и инструментам отчетности.
Как обучить YOLO26 с помощью IBM Watsonx#
Ты можешь использовать IBM Watsonx, чтобы ускорить процесс обучения модели YOLO26.
Предварительные требования#
Чтобы создать проект watsonx.ai, тебе нужна учетная запись IBM Cloud, а для загрузки набора данных также понадобится учетная запись Kaggle.
Шаг 1. Настрой среду#
Для начала создай учётную запись IBM, чтобы использовать Jupyter Notebook. Войди в watsonx.ai, используя учётную запись IBM Cloud.
Затем создай проект watsonx.ai и Jupyter Notebook.
После этого откроется среда ноутбука, в которой ты сможешь загрузить набор данных. С помощью кода из этого руководства ты можешь обучить простую модель обнаружения объектов.
Шаг 2. Установи и импортируй нужные библиотеки#
Затем установи и импортируй необходимые библиотеки Python.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Подробные инструкции и рекомендации по установке смотри в руководстве по установке Ultralytics. Если при установке пакетов, необходимых для YOLO26, возникнут сложности, решения и советы найдешь в руководстве по распространенным проблемам.
После этого импортируй необходимые пакеты.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Шаг 3. Загрузи данные#
В этом руководстве мы воспользуемся набором данных о морском мусоре, доступным на Kaggle (он также доступен как Trash-ICRA19 на Ultralytics Platform). На этом наборе данных мы дообучим модель YOLO26 для обнаружения и классификации мусора и биологических объектов на подводных изображениях.
Мы можем загрузить набор данных прямо в ноутбук с помощью API Kaggle. Для начала создай бесплатную учётную запись Kaggle. После этого сгенерируй ключ API. Инструкции по его созданию приведены в разделе «API credentials» документации API Kaggle.
Скопируй и вставь своё имя пользователя Kaggle и ключ API в приведённый ниже код. Затем запусти код, чтобы установить API и загрузить набор данных в Watsonx.
# Install kaggle
pip install kaggle
После установки Kaggle мы можем загрузить набор данных в Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
После загрузки набора данных мы вывели на экран и сохранили рабочую директорию. Мы также вывели ее содержимое, чтобы убедиться, что набор данных "trash_ICRA19" загрузился правильно.
Если среди содержимого каталога есть «trash_ICRA19», значит, набор данных загрузился успешно. Ты должен увидеть три файла или каталога: файл config.yaml, каталог videos_for_testing и каталог dataset. Каталог videos_for_testing нам не понадобится — можешь его удалить.
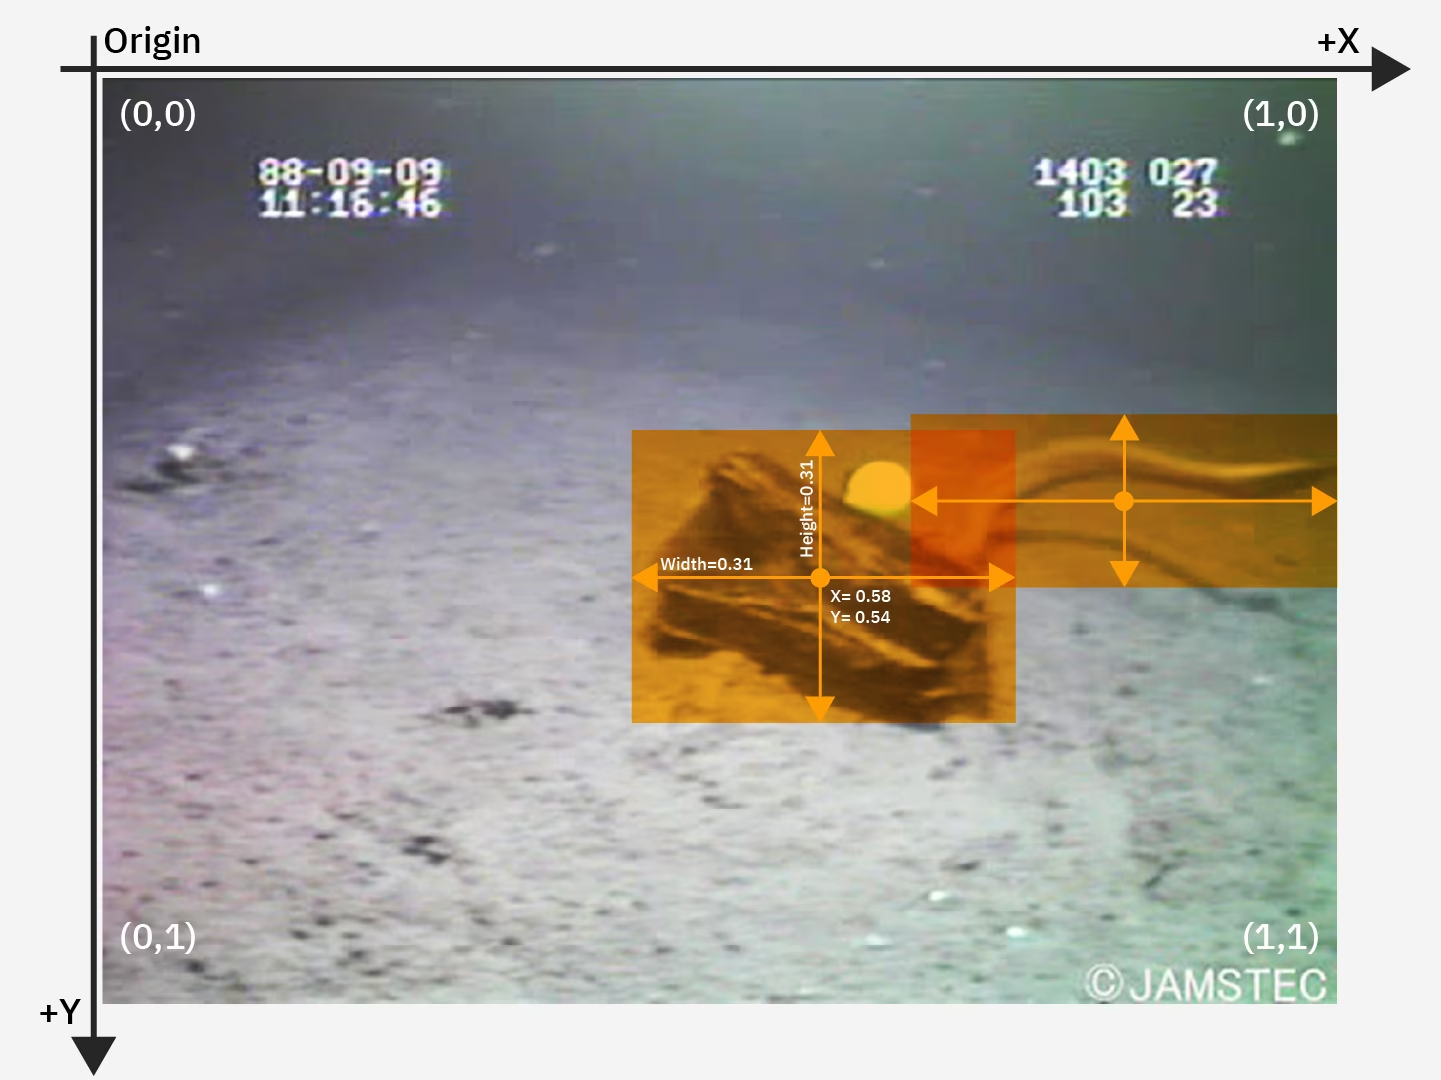
Для обучения модели обнаружения объектов мы используем файл config.yaml и содержимое директории набора данных. Вот пример изображения из нашего набора данных о морском мусоре.
Шаг 4. Предобработай данные#
Все метки в наборе данных о морском мусоре уже имеют формат YOLO .txt. Однако нам нужно перестроить директории изображений и меток, чтобы модель могла их найти. Сейчас загруженный набор данных имеет следующую структуру директорий:
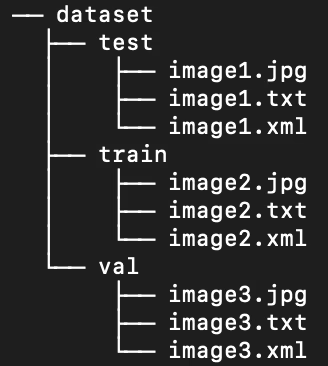
По умолчанию модели YOLO требуют отдельные поддиректории images и labels в каждом разделе train/val/test. Нам нужно перестроить директории в следующую структуру:
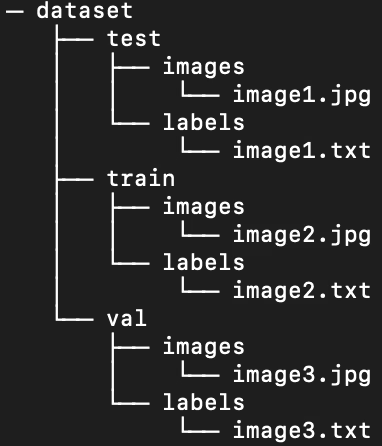
Чтобы перестроить директории набора данных, можно выполнить следующий скрипт:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Далее нужно изменить файл YAML с описанием набора данных. Именно такую конфигурацию мы укажем в файле .yaml. Нумерация идентификаторов классов начинается с 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Выполни следующий скрипт, чтобы удалить текущее содержимое config.yaml и заменить его конфигурацией, соответствующей новой структуре директорий набора данных. Скрипт автоматически использует переменную work_dir, определенную ранее, поэтому перед запуском убедись, что она указывает на твой набор данных. Не меняй определения поддиректорий train, val и test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Шаг 5. Обучи модель YOLO26#
Выполни следующую команду, чтобы дообучить предварительно обученную модель YOLO26n.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueРассмотрим подробнее параметры команды обучения модели:
- detect: задача компьютерного зрения, для которой ты используешь указанную модель YOLO и набор данных.
- train: режим, указывающий цель загрузки выбранной модели и данных. Позже, когда мы будем проверять качество модели, воспользуемся режимом
predict. - epochs: количество проходов YOLO26 по всему набору данных.
- batch: размер батча при обучении — количество изображений, обрабатываемых моделью перед обновлением ее параметров.
- plots: Указывает YOLO создавать и сохранять графики метрик обучения и оценки нашей модели.
Чтобы подробно разобраться в процессе обучения модели и лучших практиках, обратись к руководству по обучению модели YOLO26. Это руководство поможет извлечь максимум пользы из экспериментов и эффективно использовать YOLO26.
Шаг 6: тестирование модели#
Теперь можно запустить инференс, чтобы проверить производительность дообученной модели:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueЭта команда создает предсказанные метки для каждого изображения в тестовой выборке, а также новые файлы изображений, на которых предсказанные ограничивающие рамки наложены поверх исходного изображения.
Предсказанные метки .txt для каждого изображения сохраняются с помощью аргумента save_txt=True, а выходные изображения с наложенными ограничивающими рамками создаются с помощью аргумента save=True. Параметр conf=0.5 указывает модели игнорировать все предсказания с уверенностью ниже 50%.
Наконец, iou=.5 задает порог подавления немаксимумов (NMS): рамки одного класса, перекрывающие рамку с более высокой оценкой более чем на 50%, отбрасываются. Это позволяет уменьшить количество дублирующихся рамок для одного объекта. Мы можем загрузить изображения с наложенными предсказанными ограничивающими рамками, чтобы посмотреть, как модель справляется с обработкой нескольких изображений.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Приведённый выше код отображает десять изображений из тестовой выборки с предсказанными ограничивающими рамками, а также метками названий классов и значениями уверенности.
Шаг 7: оценка модели#
Мы можем построить графики точности и полноты модели для каждого класса. Эти визуализации сохраняются в директории запуска обучения ({work_dir}/runs/detect/train/). Оценка точности отображается в BoxP_curve.png:
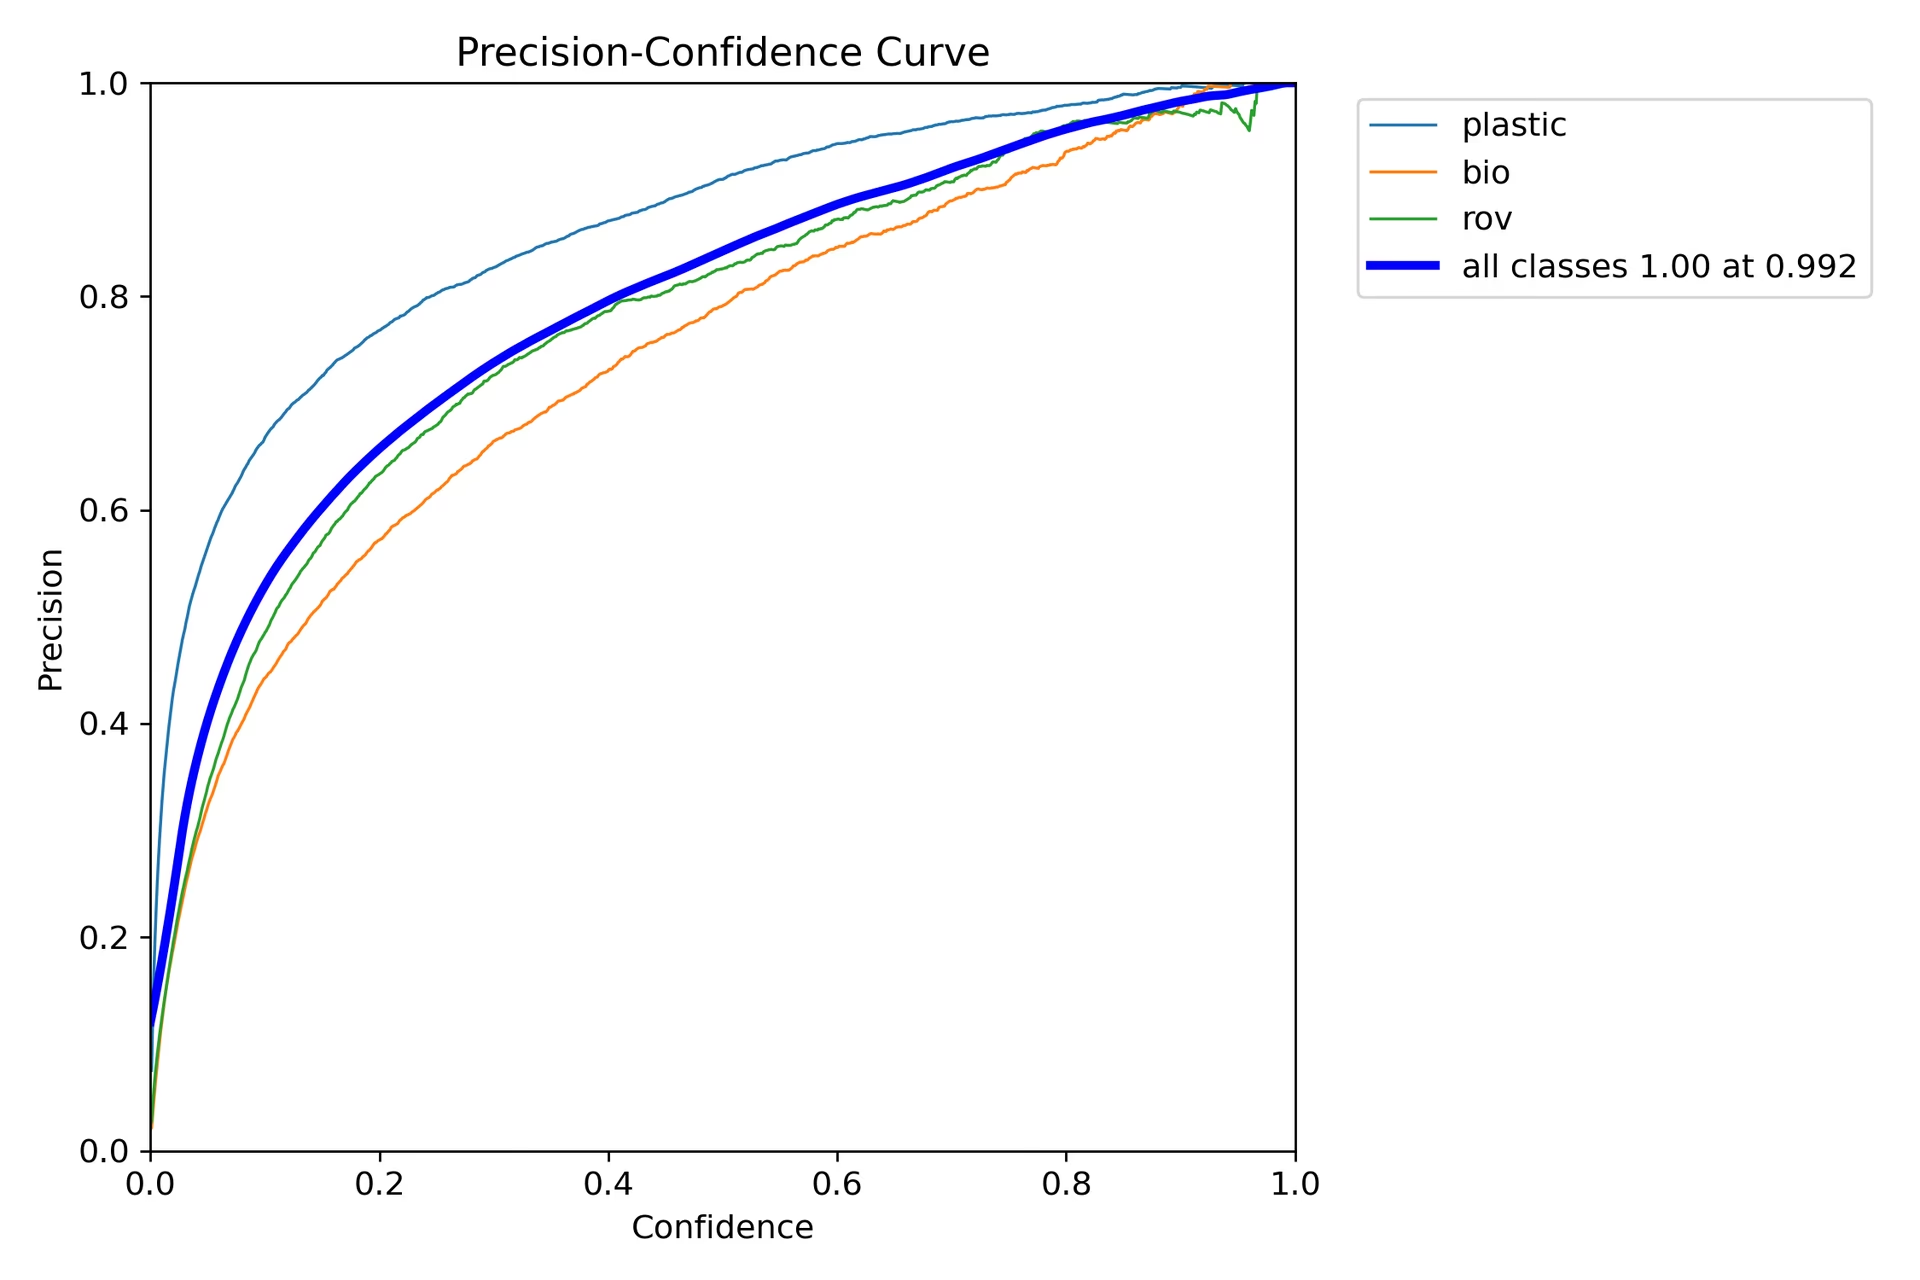
На графике видно, что точность растет по мере увеличения порога уверенности предсказаний. Однако после двух эпох точность модели еще не вышла на плато при каком-либо значении порога уверенности.
На графике полноты (BoxR_curve.png) видна обратная тенденция:
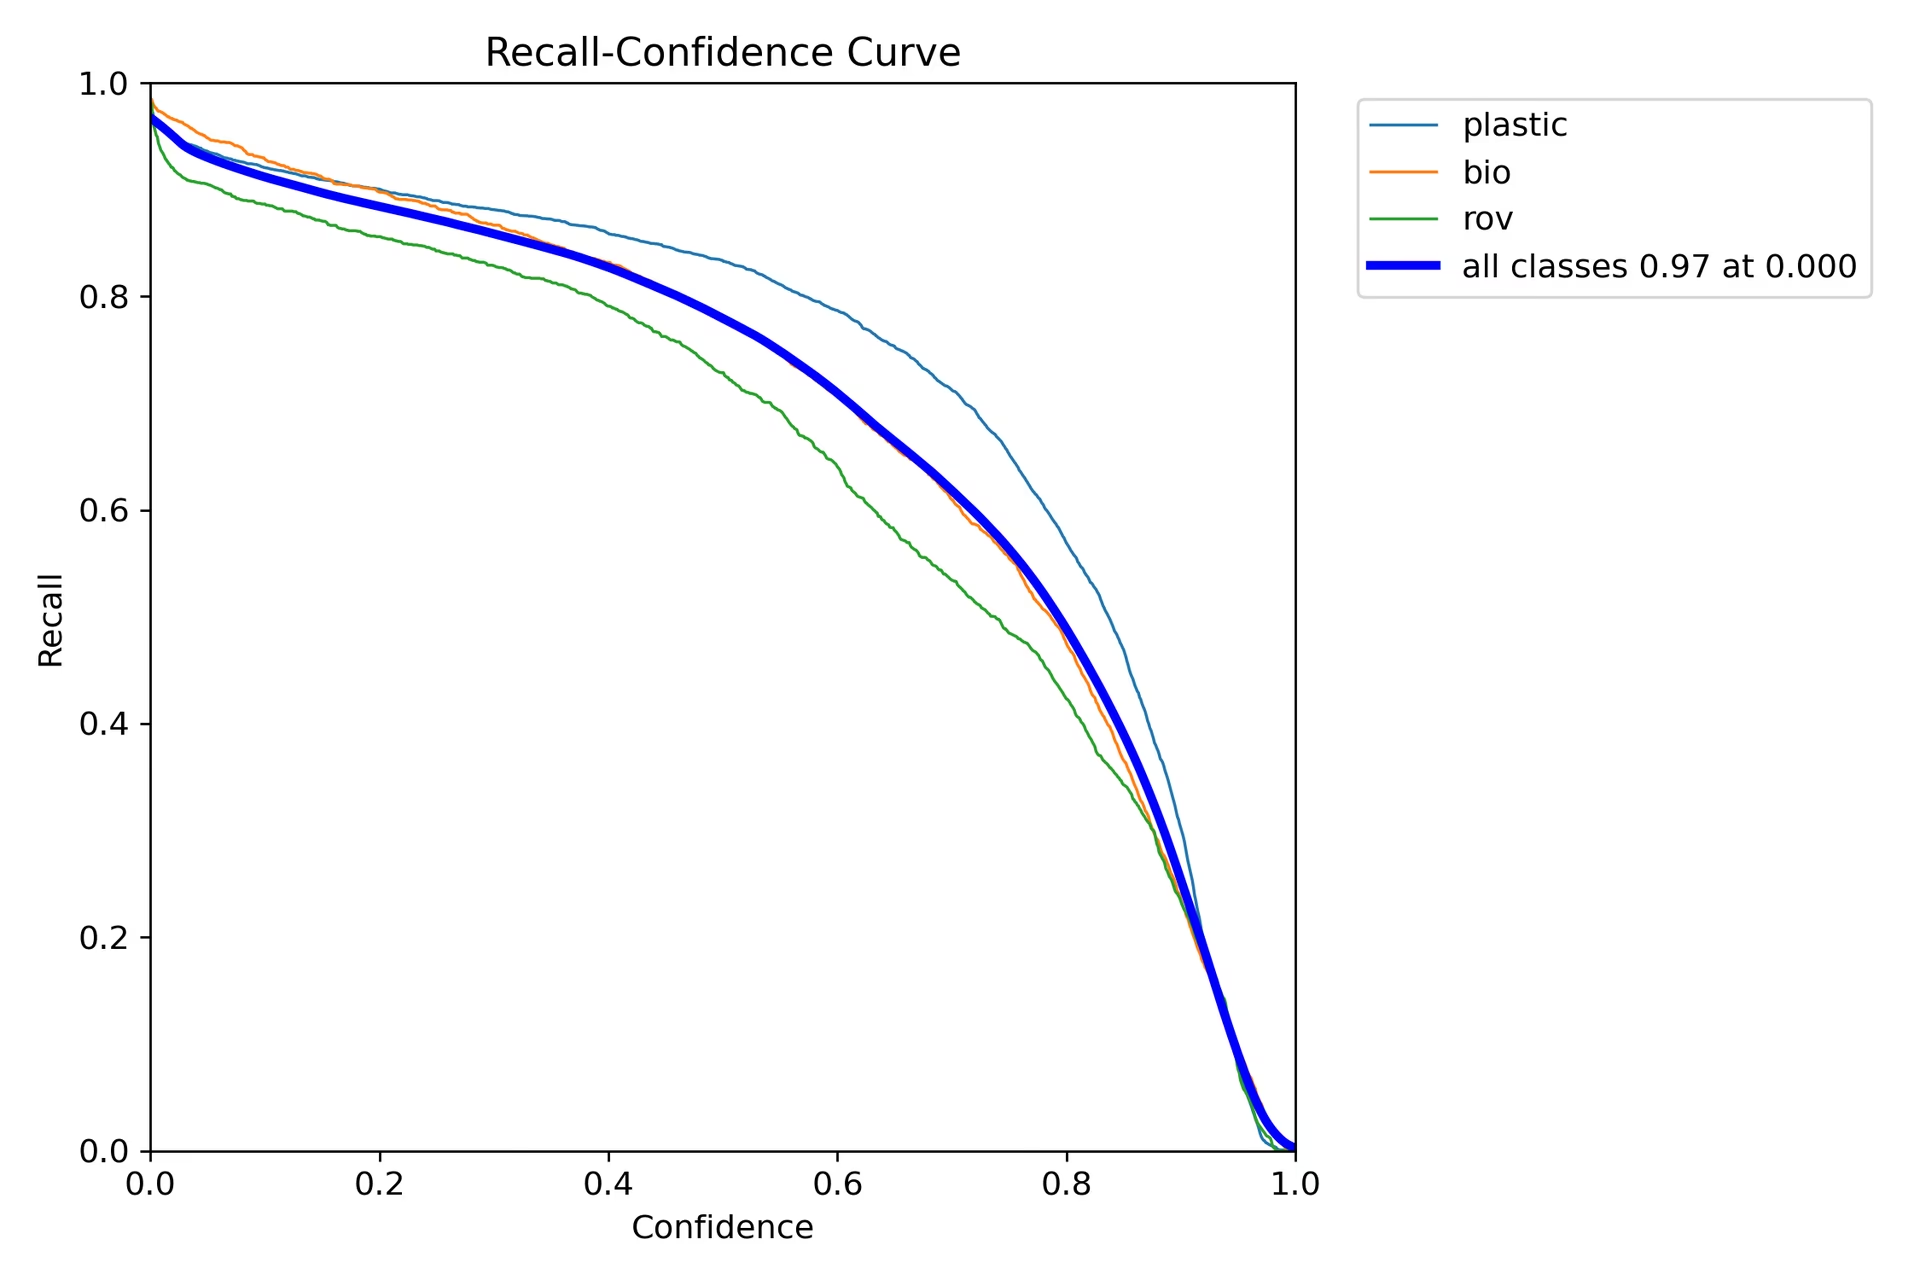
В отличие от точности, полнота максимальна при низких порогах уверенности и падает с ростом порога. Это наглядно показывает компромисс между точностью и полнотой.
Шаг 8. Вычисление пересечения над объединением#
Точность локализации можно измерить, вычислив пересечение над объединением (IoU) между предсказанной ограничивающей рамкой и эталонной ограничивающей рамкой одного и того же объекта.
Итоги#
Мы рассмотрели ключевые функции IBM Watsonx и то, как обучить с его помощью модель YOLO26. IBM Watsonx также предоставляет инструменты для создания моделей, управления данными и обеспечения соответствия требованиям.
Подробности об использовании см. в официальной документации IBM Watsonx.
Часто задаваемые вопросы#
Чтобы обучить модель YOLO26 с помощью IBM Watsonx, выполни следующие шаги:
- Настрой среду: Создай аккаунт IBM Cloud и настрой проект Watsonx.ai. Используй Jupyter Notebook в качестве среды для написания кода.
- Установи библиотеки: Установи необходимые библиотеки, например
torch,opencvиultralytics. - Загрузи данные: Используй API Kaggle, чтобы загрузить набор данных в Watsonx.
- Предварительно обработай данные: Организуй набор данных в требуемой структуре каталогов и обнови файл конфигурации
.yaml. - Обучение модели: используй интерфейс командной строки YOLO, чтобы обучить модель с такими параметрами, как
epochsиbatch. - Протестируй и оцени: Запусти инференс, чтобы протестировать модель, и оцени её производительность с помощью таких метрик, как точность и полнота.
Подробные инструкции см. в нашем руководстве по обучению модели YOLO26.
IBM Watsonx предлагает несколько ключевых возможностей для обучения моделей ИИ:
- Watsonx.ai: предоставляет инструменты для разработки ИИ, включая доступ к пользовательским моделям, поддерживаемым IBM, и сторонним моделям, таким как Llama 3. Включает Prompt Lab и Tuning Studio для комплексного управления жизненным циклом ИИ.
- Watsonx.data: Поддерживает облачные и локальные развёртывания, предлагая централизованный доступ к данным, эффективные движки запросов, такие как Presto и Spark, и семантический слой на базе ИИ.
- Watsonx.governance: Автоматизирует обеспечение соответствия требованиям, управляет рисками с помощью оповещений и предоставляет инструменты для обнаружения таких проблем, как предвзятость и дрейф. Также включает панели мониторинга и инструменты отчётности для совместной работы.
Подробнее см. в официальной документации IBM Watsonx.
IBM Watsonx подходит для обучения Ultralytics YOLO26, поскольку его инструменты охватывают весь жизненный цикл ИИ. К основным преимуществам относятся:
- Масштабируемость: Легко масштабируй обучение моделей с помощью сервисов IBM Cloud.
- Интеграция: подключение к различным источникам данных и API.
- Удобный интерфейс: Упрощает разработку благодаря интуитивно понятному интерфейсу для совместной работы.
- Расширенные инструменты: используй Prompt Lab и Tuning Studio для повышения производительности моделей.
Чтобы предварительно обработать набор данных для обучения YOLO26 на IBM Watsonx:
- Организуй каталоги: Убедись, что набор данных соответствует структуре каталогов YOLO: изображения и метки должны находиться в отдельных подкаталогах для разделов train/val/test.
- Обнови файл .yaml: Измени файл конфигурации
.yaml, указав новую структуру каталогов и названия классов. - Запусти скрипт предварительной обработки: Используй скрипт Python, чтобы реорганизовать набор данных и соответствующим образом обновить файл
.yaml.
Вот пример скрипта для организации набора данных:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Подробнее см. в нашем руководстве по предварительной обработке данных.
Перед началом обучения модели YOLO26 на IBM Watsonx подготовь следующее:
- Аккаунт IBM Cloud: Создай аккаунт IBM Cloud, чтобы получить доступ к Watsonx.ai.
- Аккаунт Kaggle: Для загрузки наборов данных понадобится аккаунт Kaggle и ключ API.
- Jupyter Notebook: Настрой среду Jupyter Notebook в Watsonx.ai для написания кода и обучения моделей.
Подробнее о настройке среды см. в нашем руководстве по установке Ultralytics.


Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.