Экспорт моделей YOLO26 в ONNX
ONNX (открытый формат обмена нейросетями) — это открытый формат моделей, который поддерживается большинством сред выполнения для инференса. При экспорте модели Ultralytics YOLO26 с помощью format="onnx" создаётся один файл .onnx, который работает с ONNX Runtime на CPU, графических процессорах NVIDIA и AMD, устройствах с чипами Apple и устройствах Windows.
Краткий обзор#
| Свойство | Описание |
|---|---|
Аргумент format | onnx |
| Результат | yolo26n.onnx, один файл с именами классов, задачей и размером изображения, сохранёнными в метаданных; yolo26n_int8.onnx для экспорта откалиброванной модели quantize=8 |
| Поддерживаемые устройства | CPU, графические процессоры NVIDIA (CUDA), графические процессоры AMD (MIGraphX), устройства с чипами Apple (провайдер выполнения Core ML) и устройства Windows ML |
| Среда выполнения | ONNX Runtime или OpenCV DNN с dnn=True |
| Точность | FP32, FP16, INT8. YOLO26n занимает 9.9 MB в FP32, 5.0 MB в FP16 и 3.1 MB в INT8 |
| Среда для экспорта | Linux, macOS или Windows, с графическим процессором или без него |
Ultralytics Platform может экспортировать обученную модель в ONNX за тебя, поэтому локальная среда для экспорта не нужна.
Быстрый старт#
Установи пакет Ultralytics. При первом экспорте будут установлены onnx, onnxslim и onnxruntime, если они отсутствуют (onnxruntime-gpu, если экспортировать с device=0 на графическом процессоре NVIDIA).
pip install ultralyticsДругие способы установки описаны в руководстве по установке. Затем экспортируй модель и загрузи экспортированный файл, чтобы запустить инференс или проверить точность.
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортировать модель в формат ONNX
model.export(format="onnx")  # создаёт 'yolo26n.onnx'

# Экспорт ONNX-модели с квантованием INT8 и калибровочными данными
model.export(format="onnx", quantize=8, data="coco8.yaml") # создает 'yolo26n_int8.onnx'from ultralytics import YOLO
# Загрузи экспортированную модель ONNX
model = YOLO("yolo26n.onnx")
# Выполнить инференс
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Загрузи экспортированную модель ONNX
model = YOLO("yolo26n.onnx")
# Проверить точность на наборе данных COCO8
metrics = model.val(data="coco8.yaml")Поддерживаемые задачи#
Экспорт в ONNX поддерживает все семь задач Ultralytics с моделями YOLOv8, YOLO11 и YOLO26: обнаружение объектов, сегментацию, семантическую сегментацию, оценку глубины, классификацию, оценку позы и OBB. Семантическая сегментация и оценка глубины доступны только в YOLO26 — единственном семействе, в котором есть соответствующие выходные головы.
Аргументы экспорта#
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
format | str | 'onnx' | Целевой формат экспортируемой модели, определяющий совместимость с различными средами развертывания. |
imgsz | int или tuple | 640 | Размер входного изображения модели: целое число для квадратных изображений или кортеж (height, width). Если значение не задано, при экспорте используется размер, на котором обучалась модель из чекпойнта. В официальных чекпойнтах YOLO26 используется 640 для моделей обнаружения объектов, сегментации, оценки позы и семантических моделей, предобученных на ADE20K; 1024 для OBB и семантических моделей, предобученных на Cityscapes; 768 для оценки глубины и 224 для классификации. |
quantize | int или str | None | Точность квантования: 16 (FP16; при экспорте для CPU входы и выходы остаются FP32, а при экспорте для GPU они тоже становятся FP16) или 8 (статическое квантование INT8 с помощью ONNX Runtime и калибровочных изображений из data, в результате создаётся модель _int8.onnx); значение 32 или отсутствие параметра означает FP32. Чекпойнт, обученный с quantize=8, экспортируется в INT8, если quantize не задан или равен 8 (для других значений возникает ошибка): создаются узлы Q/DQ на основе имеющихся в чекпойнте диапазонов, без калибровки и с обычным именем .onnx. Заменяет устаревшие флаги half/int8. |
data | str | None | YAML-файл датасета, используемый для калибровки INT8; для классификации вместо него указывают каталог датасета или имя встроенного датасета. Если параметр не задан вместе с quantize=8, Ultralytics выбирает стандартный калибровочный датасет для задачи модели; контрольной точке, обученной с quantize=8, он не требуется. |
fraction | float, int или list | 1.0 | Подмножество для калибровки, заданное как доля, количество изображений или [train, val, test] отношения/количества. Если список содержит два элемента, test остаётся без изменений, а 0 пропускает его. |
dynamic | bool | False | Делает пакет, высоту и ширину входных данных динамическими осями, поэтому один файл принимает разные размеры пакета (до размера экспорта batch с nms=True) и изображения. См. экспорт с динамическими размерами. |
simplify | bool | True | Упрощает граф модели с помощью onnxslim. |
opset | int | None | Задаёт версию opset ONNX для совместимости с разными парсерами и средами выполнения ONNX. Если значение не задано, используется opset 18 (меньше при PyTorch < 2.4), но не выше установленной версии onnx. См. минимальную версию opset. |
nms | bool, необязательно | None | Выбирает исходный вывод (None, по умолчанию), встроенный NMS (True) или голову без NMS (False). См. формат вывода. |
batch | int | 1 | Размер пакета экспортированной модели. При статическом экспорте этот размер фиксируется во входной форме. При использовании dynamic=True и nms=True укажи наибольший размер пакета, который планируешь использовать. |
device | str | None | Устройство для экспорта: cpu (по умолчанию, в том числе на машине с GPU), 0 для графического процессора CUDA или mps для устройств с чипами Apple. Результат меняется только при quantize=16; см. входы FP16. |
Аргументы, общие для всех форматов, описаны в документации по режиму экспорта.
Квантование INT8#
Для чекпойнтов, обученных без обучения с учетом квантования, quantize=8 применяет статическое квантование ONNX Runtime только к узлам Conv, Gemm и MatMul. Все остальные узлы остаются в формате с плавающей запятой, включая операции, которые формируют output0: координаты рамок (в пикселях) и оценки классов (от 0 до 1) находятся в одном тензоре, поэтому единый масштаб INT8 для него округлил бы все оценки классов до нуля. Начиная с opset 13 веса квантуются отдельно для каждого канала. Если самостоятельно запускаешь quantize_static для экспортированной модели FP32, исключи те же узлы и задай per_channel=True:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
Здесь calibration_reader — это onnxruntime.quantization.CalibrationDataReader, который возвращает {"images": array} с размером пакета модели после предобработки для инференса: с добавлением полей до нужного размера при сохранении пропорций (для классификации — с изменением размера и обрезкой по центру), в формате RGB, NCHW, float32 в диапазоне 0–1.
Модель INT8 сохраняет типы входных и выходных данных модели FP32, поэтому код инференса, написанный для модели FP32, запускает её без изменений. Файл INT8 в три-четыре раза меньше файла FP32, но в тестах производительности на GPU и CPU с ONNX Runtime модель работала медленнее, чем FP32. Перед выбором точности измерь задержку на целевом оборудовании.
Формат вывода#
Экспортированная модель принимает один вход с именем images и формой (batch, 3, height, width), в формате RGB и с масштабированием до диапазона 0–1. Тип входа — float32, кроме экспортированных для GPU моделей, созданных с помощью quantize=16: они принимают float16. Аргумент nms задаёт расположение output0. Ниже указаны формы для модели обнаружения YOLO26n с 80 классами, экспортированной при imgsz=640:
nms | Форма output0 | Содержимое |
|---|---|---|
None (по умолчанию) | (1, 84, 8400) | Для каждого из 8400 якорей: центр рамки по x, центр по y, ширина и высота в пикселях входного изображения, затем оценки 80 классов. Примени NMS самостоятельно. |
True | (1, 300, 6) | NMS выполняется внутри модели. Каждая строка имеет форму x1, y1, x2, y2, score, class; строки после последнего обнаружения заполнены нулями. |
False | (1, 300, 6) | Голова без NMS. Каждая строка имеет форму x1, y1, x2, y2, score, class; этап NMS отсутствует. Отфильтруй строки по оценке самостоятельно. |
Для остальных задач используются тот же вход и следующие выходы. Формы указаны для официальных чекпойнтов YOLO26n при размере экспорта по умолчанию; для семантической сегментации указан чекпойнт Cityscapes yolo26n-sem.pt:
| Задача | imgsz по умолчанию | Выход с nms=None | Выход с nms=False или nms=True |
|---|---|---|---|
| Обнаружение | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Сегментация | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| Семантическая | 1024 | output0 (1, 1024, 1024), uint8 — индекс класса для каждого пикселя | То же, что и nms=None |
| Глубина | 768 | output0 (1, 1, 768, 768), карта глубины | То же, что и nms=None |
| Классификация | 224 | output0 (1, 1000), вероятности классов после softmax | То же, что nms=None, для nms=False; nms=True вызывает ошибку |
| Поза | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 значений рамки, затем 17 ключевых точек по 3 значения |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (радианы) |
В строках сегментации после значений рамки содержатся 32 коэффициента маски, а output1 содержит прототипы маски. В моделях FP32 и INT8 все выходы имеют тип float32, кроме карты семантических классов.
При использовании nms=True порог уверенности conf (по умолчанию 0.25), порог IoU iou (по умолчанию 0.5), agnostic_nms и max_det (по умолчанию 300) фиксируются в графе при экспорте. Более низкое значение conf во время инференса не вернёт детекции, уже удалённые графом, поэтому для изменения этих значений выполни экспорт заново. max_det и agnostic_nms также применяются к nms=False: max_det=100 задаёт для output0 форму (1, 100, 6).
YOLO("yolo26n.onnx") считывает расположение данных из метаданных файла, поэтому эти формы нужны только при запуске модели в собственном коде. Метаданные также доступны в коде в виде строк: names, task, imgsz, stride, batch, end2end и args.
import ast

import onnxruntime as ort

meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"])  # {0: 'person', 1: 'bicycle', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]Разверни#
YOLO("yolo26n.onnx") запускает модель с ONNX Runtime и выбирает провайдер выполнения на основе аргумента device. На машине с графическим процессором CUDA используется GPU, если device не задан.
device | Провайдер выполнения |
|---|---|
cpu | CPUExecutionProvider |
0 на графическом процессоре NVIDIA | CUDAExecutionProvider из пакета onnxruntime-gpu, который устанавливается при первом использовании |
0 на графическом процессоре AMD ROCm | MIGraphXExecutionProvider; см. Инференс на графических процессорах AMD с MIGraphX |
mps на устройствах с чипами Apple | CoreMLExecutionProvider для узлов со статическими формами; узлы с динамическими формами запускаются на CPUExecutionProvider |
Строка журнала Using ONNX Runtime 1.31.1 with CUDAExecutionProvider показывает активный провайдер. Поведение во время инференса зависит от способа экспорта модели:
- Статический экспорт (по умолчанию): модель всегда запускается с параметрами экспорта
imgszиbatch, которые Ultralytics считывает из метаданных файла. Переданный вpredictпараметрimgszигнорируется. Большие пакеты разбиваются на блоки размером с пакет экспорта, а меньшие дополняются, поэтому поддерживается любое количество изображений. - Динамический экспорт (
dynamic=True):predictпринимает любое значениеimgsz, кратное шагу модели. Размер пакета может меняться, но приnms=Trueон ограничен значениемbatch, использованным при экспорте, поэтому укажи наибольший размер пакета, который планируешь использовать. - Память GPU: при
CUDAExecutionProviderстатическая модель использует привязку ввода-вывода ONNX Runtime, которая хранит входные и выходные тензоры на GPU. Динамическая модель при каждом вызове копирует их через память CPU. - Потоки CPU: Ultralytics ограничивает число потоков ONNX Runtime внутри операций до 8 или до числа физических ядер CPU, доступных процессу, если оно меньше. Чтобы задать другое число, используй переменную среды
ORT_INTRA_OP_NUM_THREADS.
Передай dnn=True в predict или val, чтобы запускать модель на CPU с OpenCV DNN вместо ONNX Runtime. OpenCV DNN поддерживает меньше параметров экспорта; см. Ограничения и устранение неполадок.
Чтобы запускать модель вне пакета Ultralytics, воспользуйся следующими ресурсами:
- API ONNX Runtime для Python: загрузка и запуск модели ONNX в Python.
- Провайдеры выполнения ONNX Runtime: аппаратные бэкенды, например CUDA, TensorRT, OpenVINO, Core ML и DirectML.
- Примеры Ultralytics: инференс с ONNX Runtime на Python, C++ и Rust, а также инференс с OpenCV DNN на Python.
- Triton Inference Server: предоставление модели ONNX по HTTP или gRPC с помощью NVIDIA Triton.
- Развёртывание на периферийных устройствах: руководства по ONNX Runtime для устройств IoT и периферийного оборудования.
Инференс Windows ML#
В Windows 11 24H2 (сборка 26100) или новее с Python 3.10+ установи onnxruntime-windowsml в отдельное окружение, чтобы Windows ML мог выбирать провайдеры выполнения для твоего оборудования. Установи его вместо других сборок ONNX Runtime, а затем используй ту же экспортированную модель .onnx с YOLO("model.onnx"). Бэкенд сохраняет количество потоков PyTorch и переданные параметры сессии, включая явную политику выбора провайдера. Если политика не задана, Windows ML выбирает оборудование для максимальной производительности, даже если устройство PyTorch — cpu. Прежде чем выбирать эту среду выполнения, измерь задержку предсказания на своём устройстве; она необязательна и по умолчанию не устанавливается.
На интегрированных GPU, которые используют питание совместно с CPU, простаивающие потоки PyTorch при предобработке и постобработке могут замедлять инференс Windows ML. Перед предсказанием вызови torch.set_num_threads(1), чтобы уменьшить эту задержку. Это влияет на весь процесс, поэтому другие модели PyTorch в этом процессе тоже будут работать в одном потоке.
import torch

from ultralytics import YOLO

torch.set_num_threads(1)  # необязательно, измерь на своём устройстве
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")
Инференс на GPU AMD с MIGraphX#
Ultralytics запускает экспортированные модели ONNX на графических процессорах AMD через провайдер выполнения MIGraphX для ONNX Runtime. В системе ROCm (HIP) с Python 3.11 или новее и архитектурой x86-64 бэкенд ONNX при первом использовании устанавливает плагин onnxruntime-ep-migraphx и автоматически выбирает MIGraphXExecutionProvider, не требуя изменений в коде; поддерживаются все задачи YOLO26. Предварительные требования, установку, использование, тесты производительности и кэш скомпилированных программ см. в руководстве по инференсу на графических процессорах AMD.
Ограничения и устранение неполадок#
- Минимальная версия opset: экспорт завершается ошибкой
ONNX export requires opset>=N, если значениеopsetслишком мало для модели. Минимум —7для классификации,9для обнаружения объектов, сегментации, семантической сегментации, оценки позы и OBB,11для оценки глубины, а также для моделей обнаружения объектов, сегментации, оценки позы и OBB, экспортированных сnms=True, и16для RT-DETR. - Входы FP16: модель FP16, экспортированная на GPU (
quantize=16 device=0), ожидает тензоры входных данных FP16 в собственном коде. Модель FP16, экспортированная на CPU, сохраняет входы и выходы FP32 и выполняет преобразование внутри графа.YOLO()передаёт обоим вариантам правильный тип входных данных — и на GPU, и на CPU. - Имя файла INT8:
quantize=8создаёт файлyolo26n_int8.onnxи удаляет промежуточный файл FP32, поэтому для инференса загружай файл_int8. Исключение — чекпойнт, обученный сquantize=8: при его экспорте узлы Q/DQ записываются вyolo26n.onnx, а калибровка пропускается. - Размер калибровки INT8: при экспорте чекпойнта, не обученного с
quantize=8, появляется предупреждение, если в калибровочной выборке меньше 300 изображений. По умолчанию для калибровки используется выборкаval, а вcoco8.yamlвсего 4 проверочных изображения, поэтому для модели, которую планируешь развернуть, используй собственный набор данных. - Встроенный NMS: для
nms=Trueтребуется PyTorch 1.13 или новее. Для классификации возникает ошибка'nms=True' is not valid for classification models, а для моделей семантической сегментации, оценки глубины и RT-DETR параметр игнорируется с предупреждением. - Голова без NMS: для
nms=Falseнужна модель с головой без NMS, например YOLO26 или YOLOv10. Для других моделей, например YOLO11, при экспорте появится предупреждениеThis model has no one-to-one head; using one-to-many outputs, а в файл будет записан исходный выход(1, 84, 8400). - GPU не используется: если в журнале указано
CUDA requested but CUDAExecutionProvider not available. Using CPU..., в установленной сборке ONNX Runtime нет рабочего провайдера CUDA. Установиonnxruntime-gpuвместоonnxruntimeи проверь, что версии CUDA и cuDNN в нём соответствуют системе. - OpenCV DNN: в OpenCV 4.14.0
dnn=Trueзапускает модели с настройками по умолчанию,nms=False, INT8 и FP16, экспортированные для GPU. Не удаётся загрузить модели, экспортированные сnms=True, сdynamic=Trueили сquantize=16на CPU. - Динамические формы с NMS: если объединяешь
dynamic=Trueсnms=True, также задай дляbatchнаибольший размер пакета, который планируешь использовать. При значении1дляbatchэкспорт выдаст предупреждение. - Упрощение графа: если
onnxslimзавершается ошибкой, при экспорте выводится предупреждение, а модель сохраняется без упрощения. - Версия IR: экспортёр ограничивает версию IR ONNX значением 10, чтобы файл можно было загружать в более старых версиях ONNX Runtime. При экспорте с настройками по умолчанию и opset 18 используется версия IR 8.
Другие ошибки описаны в руководстве по распространённым проблемам.
Бенчмарки#
YOLO26n работает с ONNX Runtime на CPU (Intel Xeon CPU @ 2.00 GHz) до 43% быстрее, чем YOLO11n. На странице модели YOLO26 указана скорость ONNX на CPU для каждой модели и всех задач, кроме семантической сегментации.
Смотри: Сравнение инференса Ultralytics YOLO26 и Ultralytics YOLO11 в ONNX | YOLO26 обеспечивает инференс примерно на 43% быстрее 🚀
FP32, FP16 и INT8 с ONNX Runtime#
В таблицах ниже сравниваются PyTorch и модели YOLO26 для обнаружения объектов в форматах ONNX FP32, FP16 и INT8, запущенные с CUDAExecutionProvider для ONNX Runtime. Все значения для GPU измерены на одном графическом процессоре NVIDIA RTX PRO 6000 Blackwell Server Edition.
Миллисекунды на изображение; меньше — лучше. Для каждой модели жирным выделен самый быстрый формат.
| Модель | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n на CPU (AMD EPYC 9655, PyTorch и ONNX Runtime — по 8 потоков; процессор отличается от использованного для таблиц моделей YOLO26):
| Показатель | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| Задержка (мс/изображение) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50–95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 уменьшил размер файла вдвое при снижении mAP не более чем на 0.1 относительно FP32 и работал на GPU до 1.4 раза быстрее FP32, но на CPU ускорения не было.
- INT8 обеспечил наименьший размер файла, но снизил mAP на 2.2–3.0 и работал медленнее FP32 и на GPU, и на CPU.
Измерения выполнены с ultralytics 8.4.211, ONNX Runtime 1.30.0, PyTorch 2.15.0 и CUDA 13.2 при batch=1 13 ноября 2026 года. Задержка относится к этапу инференса, который показывает val, и не включает предобработку и постобработку.
Об ONNX#
ONNX — это общественный проект, который начали Facebook и Microsoft и который сейчас развивается при участии таких организаций, как IBM, Amazon и Google. Он определяет общий набор операторов и формат файлов для моделей машинного обучения, благодаря чему модель, обученная в одном фреймворке, например PyTorch, может работать во многих средах выполнения и на различных аппаратных платформах.
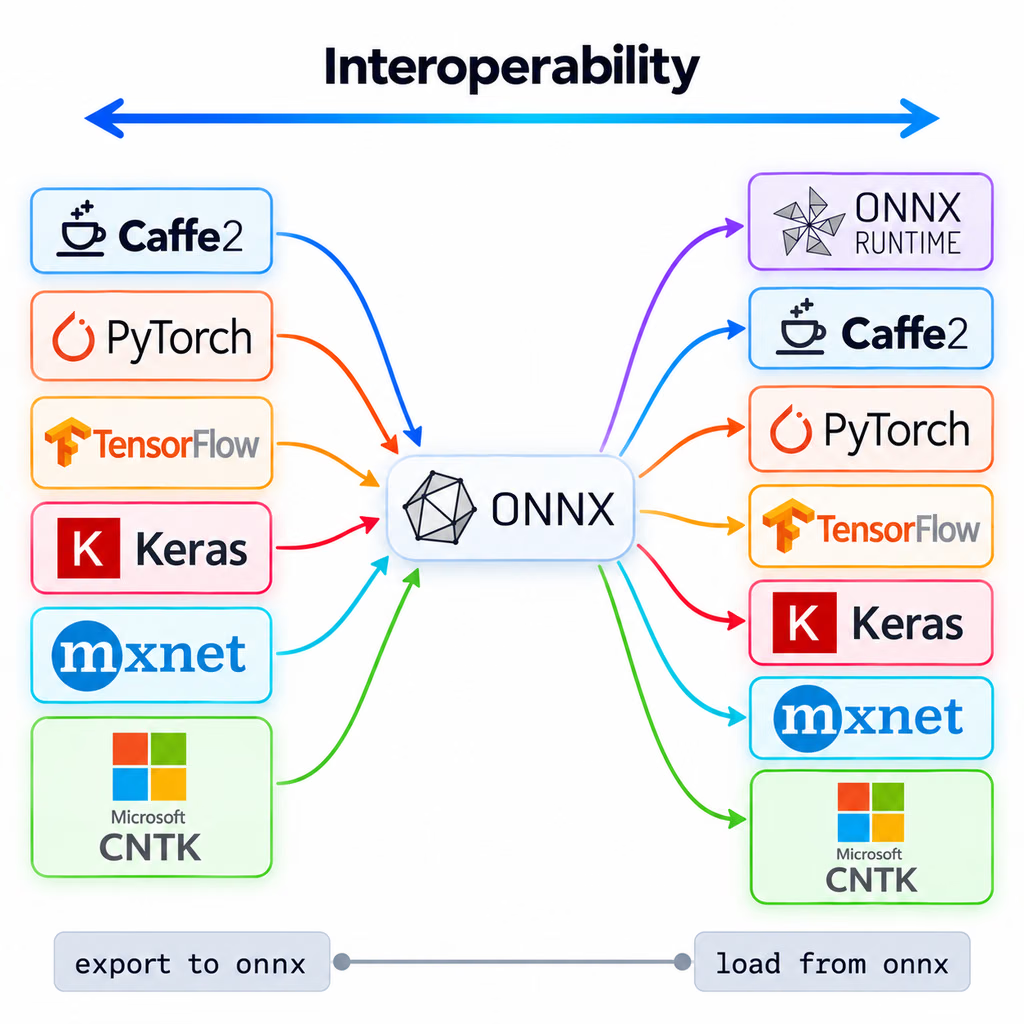
ONNX Runtime — кроссплатформенный движок инференса для моделей ONNX. Его провайдеры выполнения используют специализированные для конкретного оборудования библиотеки, чтобы запускать модель на CPU, GPU и выделенных ускорителях.
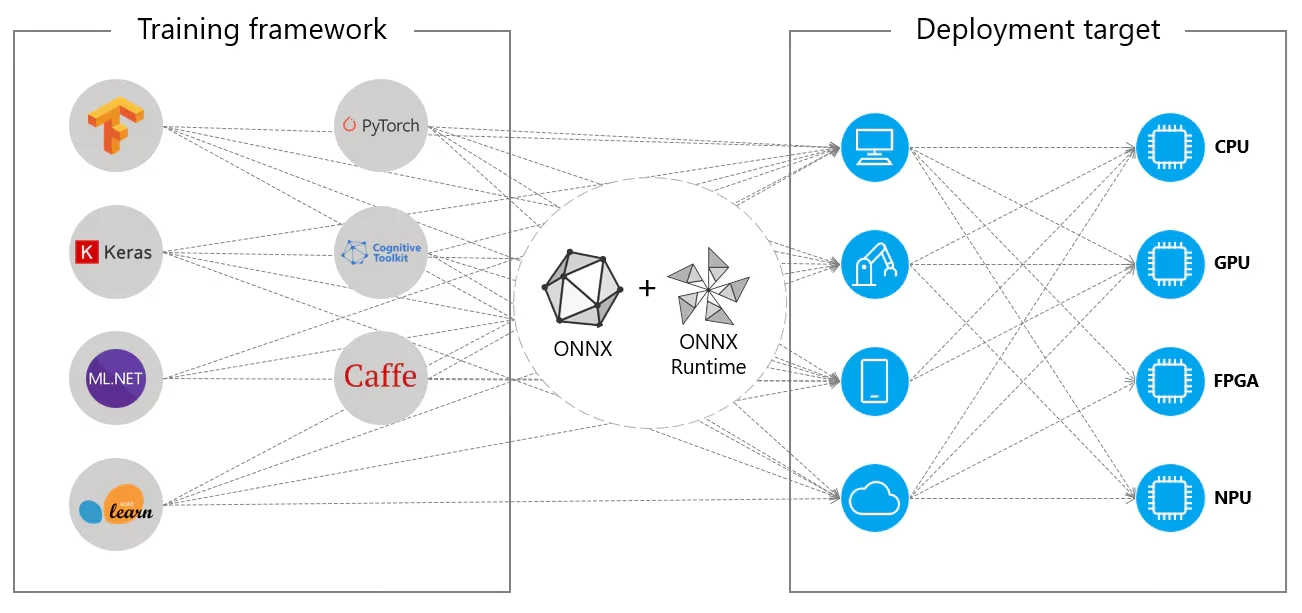
ONNX также служит промежуточным этапом для других форматов экспорта Ultralytics, включая TensorRT, и входным форматом для инструментальных цепочек производителей NPU, таких как Huawei Ascend, Qualcomm QNN и Rockchip RKNN. Спецификацию смотри в документации ONNX.
Часто задаваемые вопросы#
Не указывай
opset, если среде выполнения не нужна конкретная версия. В таком случае экспортер использует opset18в PyTorch 2.4 и новее, opset17в PyTorch от 1.13 до 2.3, более низкий opset в старых версиях PyTorch и никогда не превышает версию, поддерживаемую установленным пакетомonnx. По умолчанию используется opset не выше 18, поскольку провайдер CUDA в ONNX Runtime выполняет некоторые операторы opset 19 и новее, напримерResize, на CPU. Задай более низкое значение, напримерopset=12, если старая среда выполнения или конвертер отклоняет значение по умолчанию. Значение не может быть ниже минимального opset для модели.Это зависит от аргумента
nms, с которым ты выполнил экспорт. Экспорт по умолчанию возвращает необработанные предсказания, для которых нужны фильтрация по уверенности и NMS. Экспорт сnms=Falseилиnms=Trueвозвращает доmax_det(по умолчанию 300) финальных детекций на изображение в форматеx1, y1, x2, y2, score, classи в пикселях входного изображения, поэтому достаточно отфильтровать результаты по оценке и масштабировать рамки обратно до размеров исходного изображения. Строки OBB содержатcenter x, center y, width, heightвместо координат углов, а также угол. Формы тензоров смотри в разделе Формат выходных данных.Чтение выходных данных без NMS с помощью ONNX Runtime# Сначала выполни экспорт: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # экспортировано с nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # предварительно обработанное изображение detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # оставить строки выше порога уверенностиЗадай
dynamic=True. Тогда входimagesбудет иметь форму(batch, 3, height, width), причем размер пакета, высота и ширина задаются динамически, а выход детекции по умолчанию (nms=None)output0имеет форму(batch, 84, anchors), поэтому при инференсе один и тот же файл поддерживает разные размеры пакетов и изображений. При использованииnms=Trueразмер пакета ограничен значениемbatch, заданным при экспорте. Высота и ширина должны быть кратны шагу модели, который для официальных чекпойнтов YOLO26, кроме моделей классификации, равен 32. Динамическая модель не использует IO binding на CUDA и не загружается в OpenCV DNN, поэтому при фиксированном размере входных данных оставь статический экспорт по умолчанию.Экспорт с динамическими размерамиfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)Используй ONNX, если один файл должен работать на разном оборудовании или если машина для развертывания отличается от машины, на которой ты выполняешь экспорт. Используй TensorRT, чтобы добиться минимальной задержки на конкретном GPU NVIDIA: движок TensorRT собирается для одной архитектуры GPU и одной версии TensorRT и не переносим на другие платформы. Другие варианты смотри в руководстве по развертыванию моделей.


Комментарии77
Задай вопрос, поделись результатами или помоги кому-нибудь.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(изменено)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(изменено)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(изменено)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
