Краткое руководство: Seeed Studio reCamera с Ultralytics YOLO26
reCamera была представлена сообществу ИИ на YOLO Vision 2024 (YV24) — ежегодном гибридном мероприятии Ultralytics. Она в первую очередь предназначена для периферийных приложений ИИ, обеспечивая обработку ИИ непосредственно на устройстве и простое развертывание.
Благодаря поддержке различных аппаратных конфигураций и ресурсов с открытым исходным кодом устройство хорошо подходит для создания прототипов и развертывания решений компьютерного зрения на периферии.
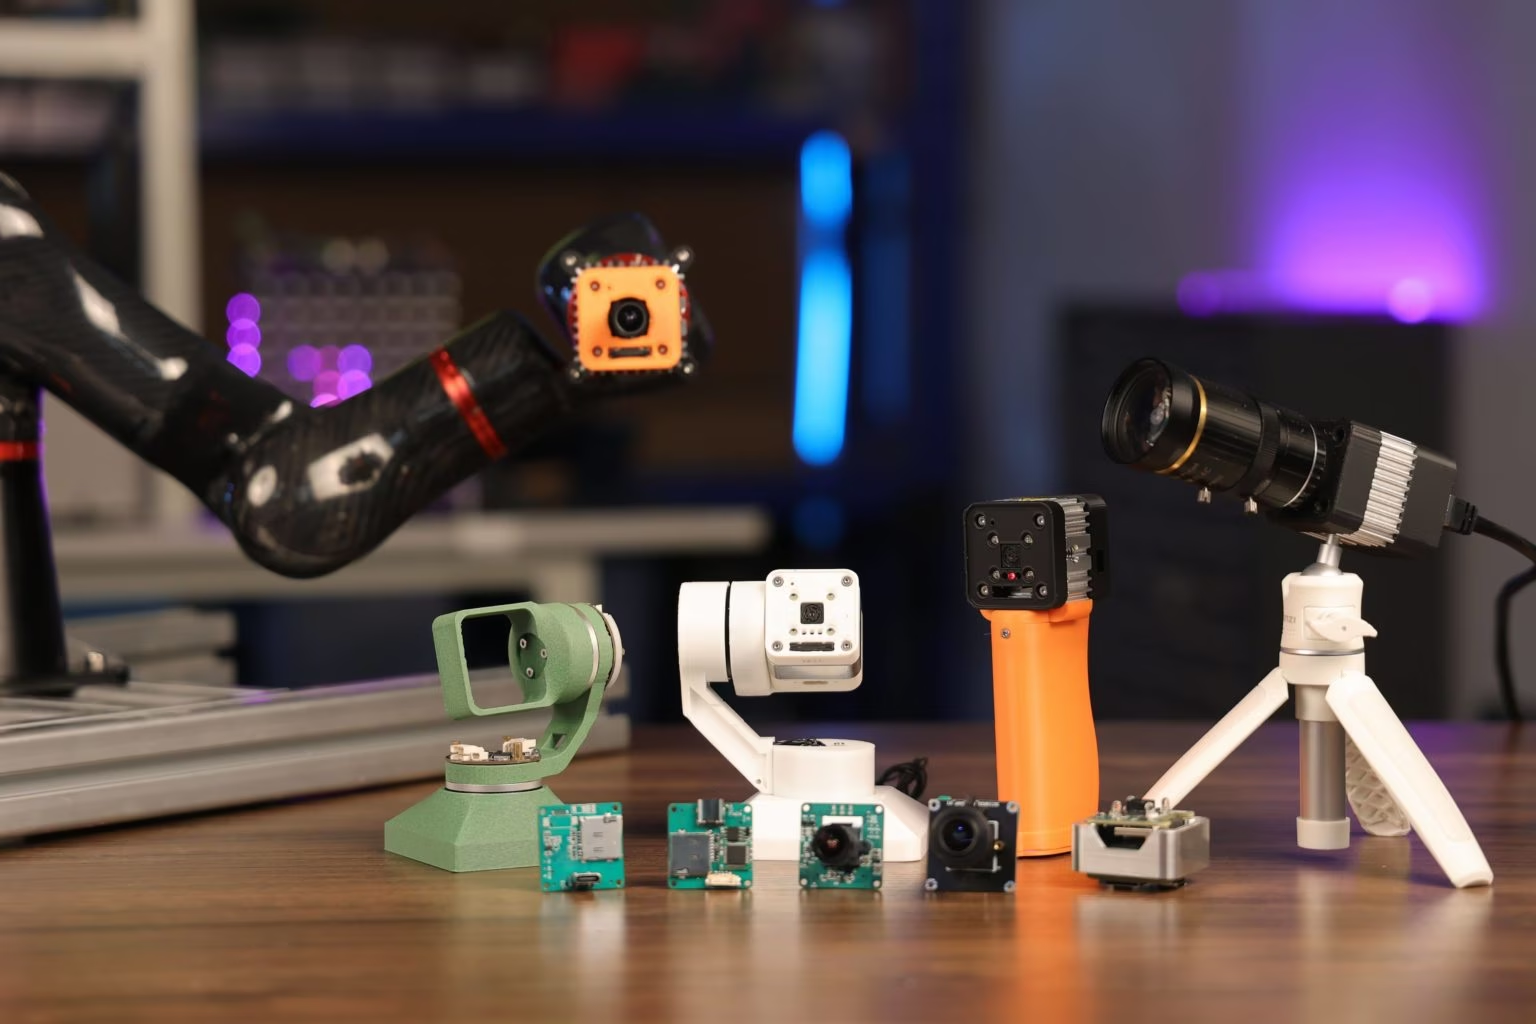
Почему стоит выбрать reCamera?#
Серия reCamera специально создана для периферийных приложений ИИ с учетом потребностей разработчиков. К ее ключевым особенностям относятся:
-
Производительность на базе RISC-V: устройство оснащено процессором SG200X на архитектуре RISC-V, обеспечивающим эффективную работу задач периферийного ИИ. Благодаря производительности в 1 трлн операций в секунду (1 TOPS) он справляется с такими задачами, как обнаружение объектов в реальном времени.
-
Оптимизированные видеотехнологии: поддерживаются современные стандарты сжатия видео, включая H.264 и H.265, что позволяет уменьшить требования к хранилищу и пропускной способности без потери качества. Такие функции, как HDR, трехмерное шумоподавление и коррекция объектива, сохраняют качество изображения даже в сложных условиях.
-
Энергоэффективная двухпроцессорная архитектура: пока SG200X выполняет сложные задачи ИИ, менее мощный 8-битный микроконтроллер отвечает за простые операции, экономя энергию. Поэтому reCamera подходит для устройств с батарейным питанием и систем с низким энергопотреблением.
-
Модульная и модернизируемая конструкция: reCamera имеет модульную структуру и состоит из трёх основных компонентов: основной платы, платы сенсора и базовой платы. Такая конструкция позволяет разработчикам заменять или модернизировать компоненты по мере развития проектов.
Быстрая настройка оборудования reCamera#
Перейди на страницу Начало работы с reCamera и выбери своё устройство (например, reCamera серии 2002, Gimbal или HQ POE), чтобы открыть краткое руководство по начальной настройке устройства, в том числе подключению к сети и доступу к веб-интерфейсу Node-RED для быстрого просмотра результатов обнаружения.
Инференс с использованием предустановленных моделей YOLO#
На reCamera уже предустановлены четыре модели Ultralytics YOLO, и ты можешь выбрать нужную модель на панели Node-RED.
Шаг 1. Если reCamera подключена к сети, введи её IP-адрес в веб-браузере, чтобы открыть панель Node-RED. Если reCamera подключена к ПК через USB, введи 192.168.42.1. По умолчанию загружается модель обнаружения.
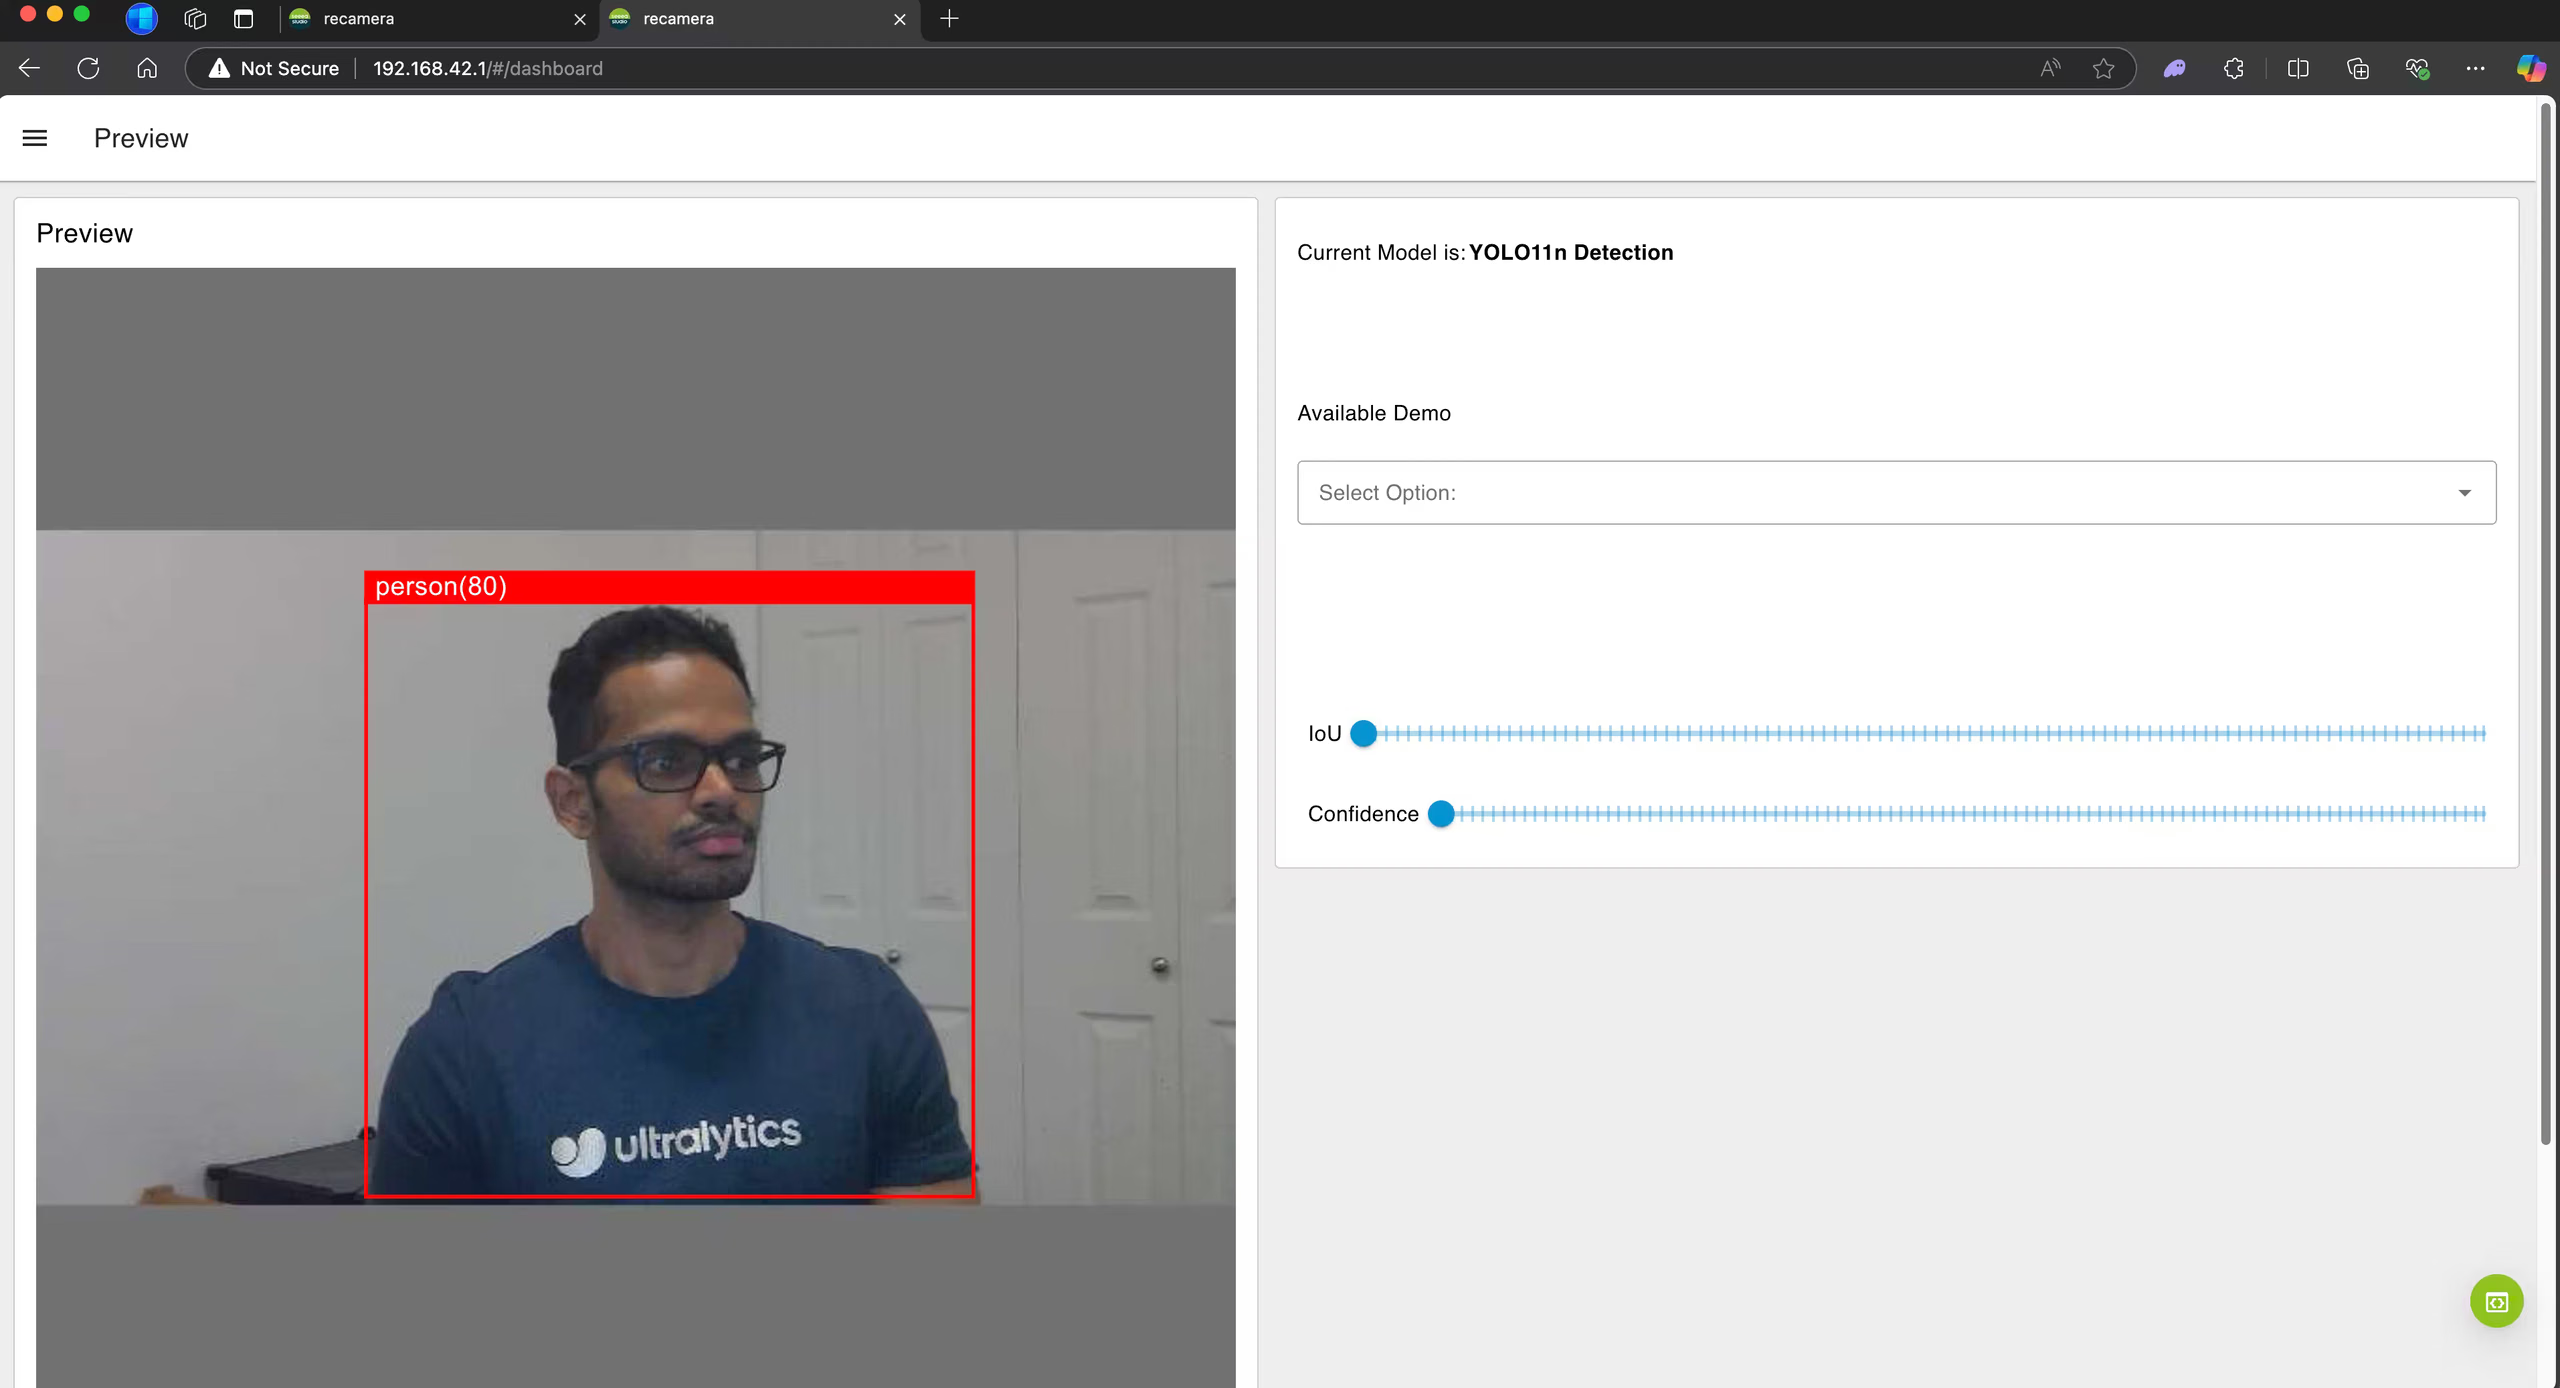
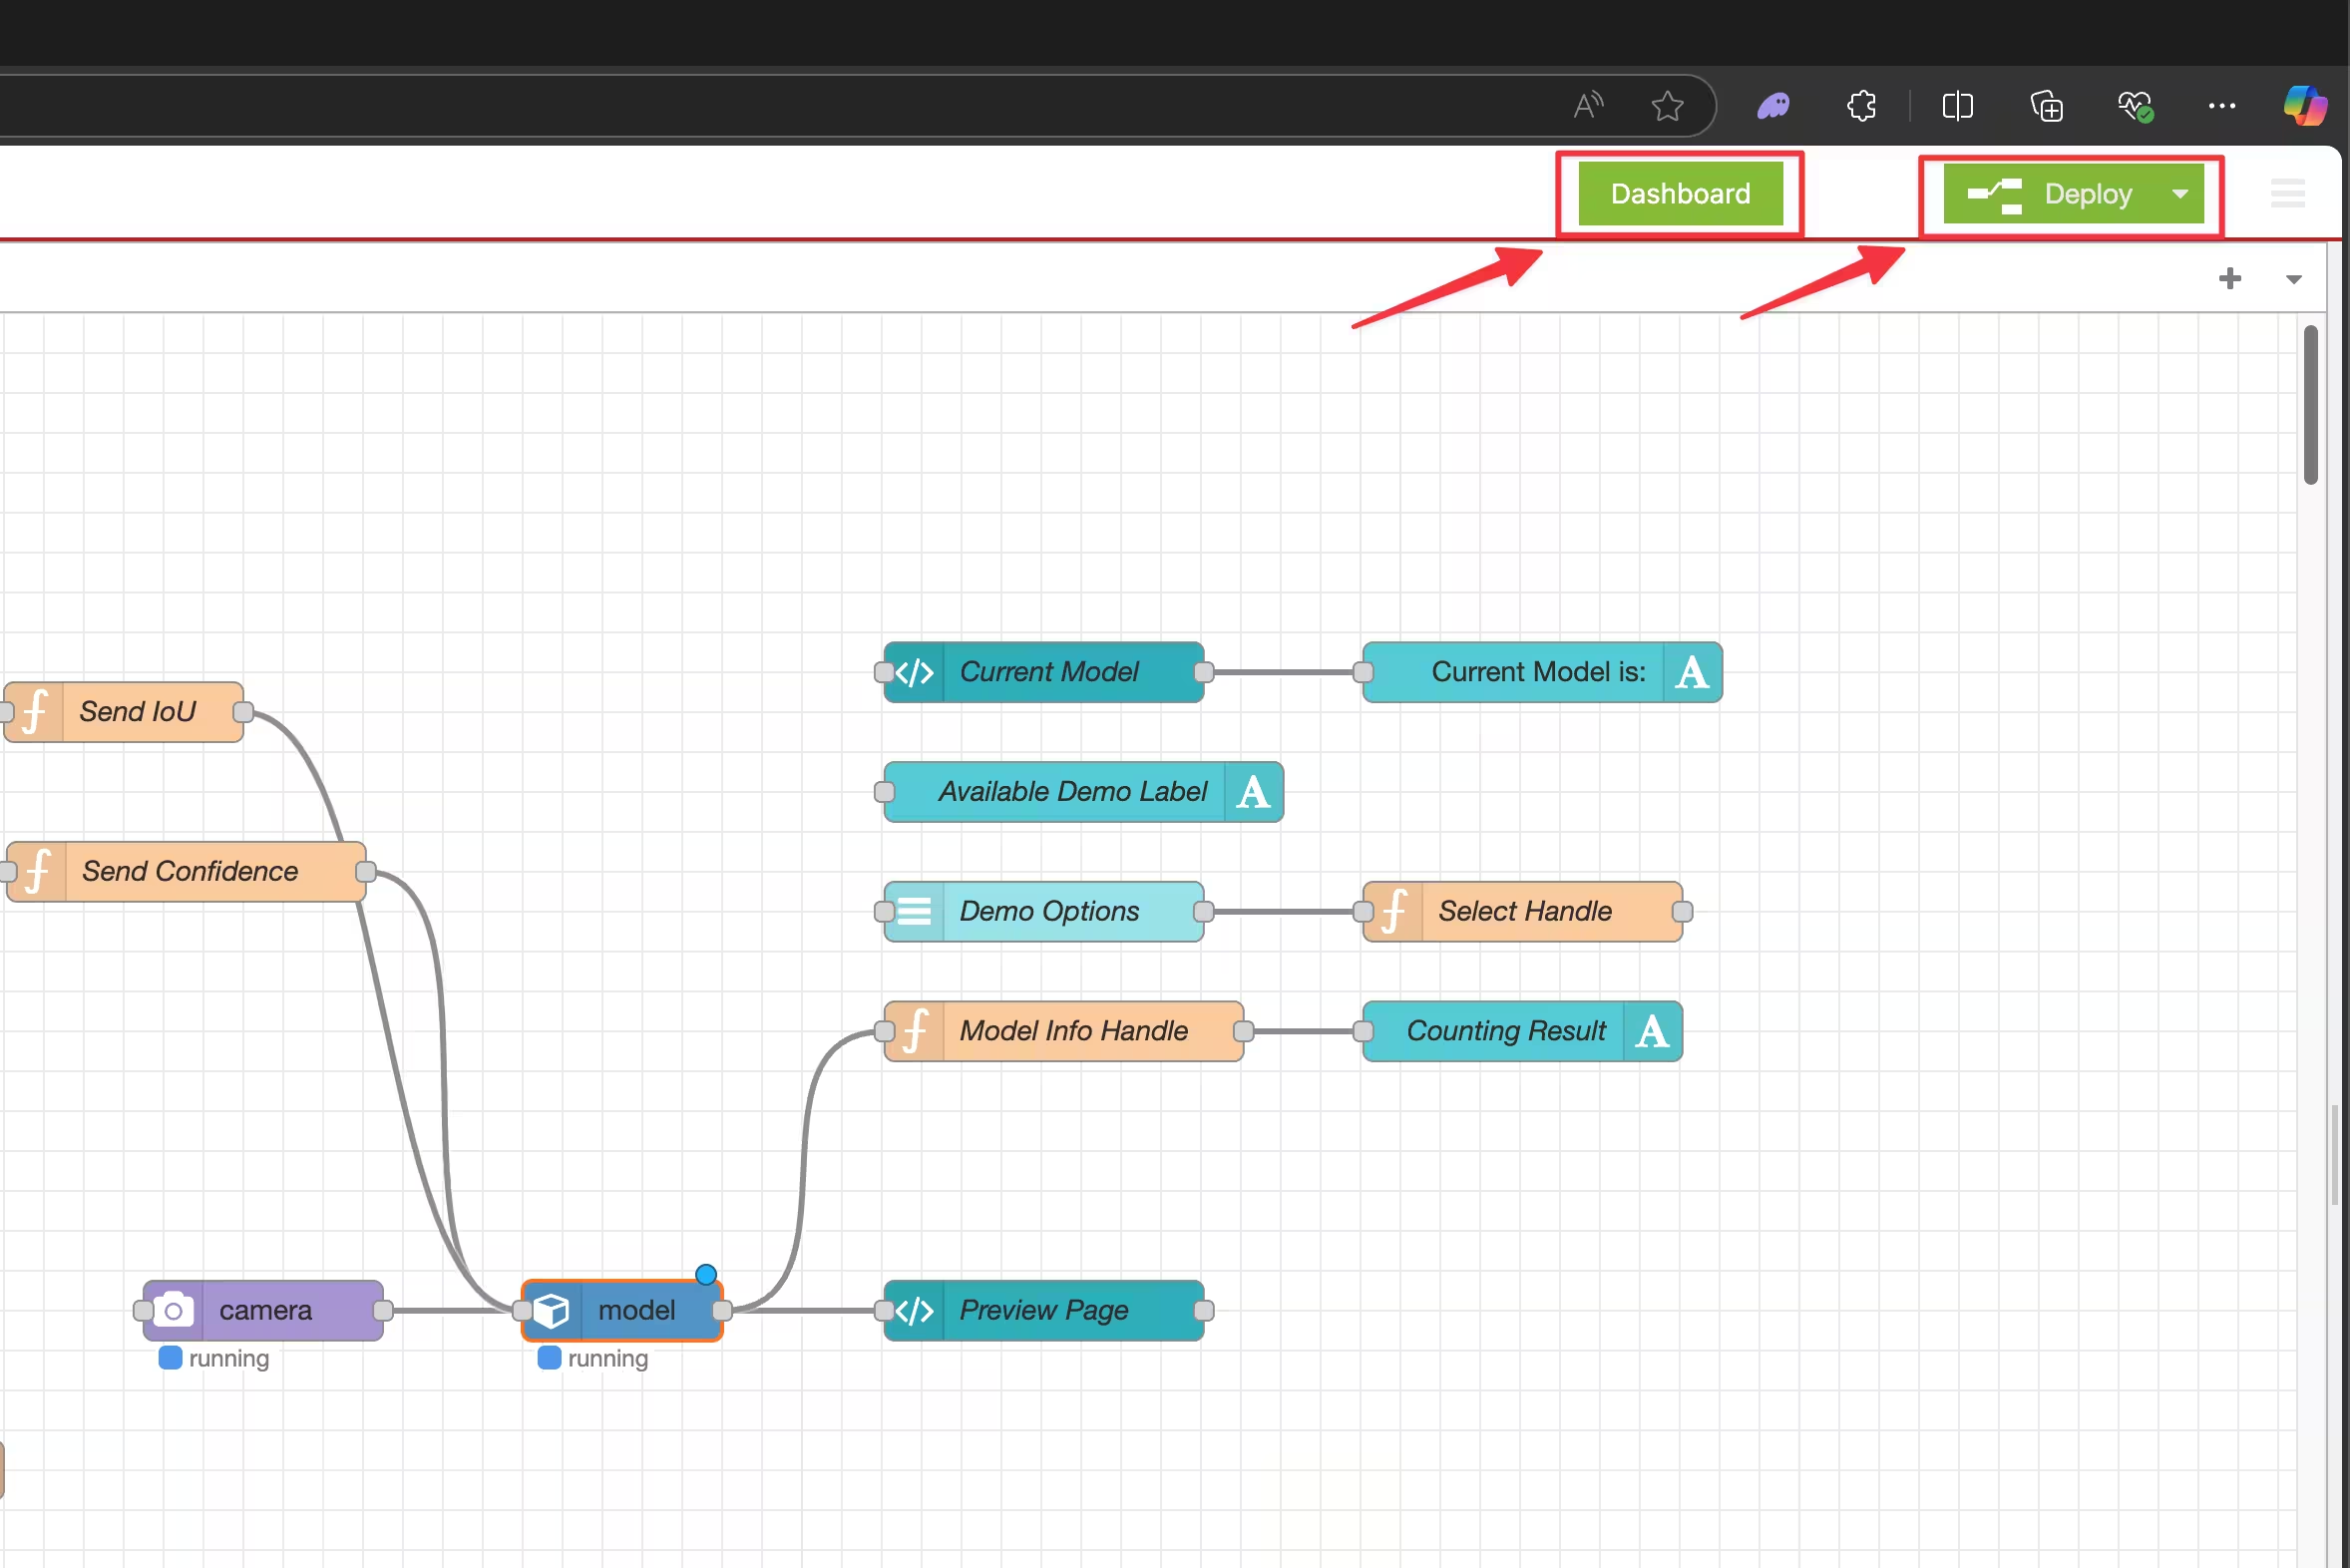
Шаг 2. Нажми на зелёный кружок в правом нижнем углу, чтобы открыть редактор потоков Node-RED.
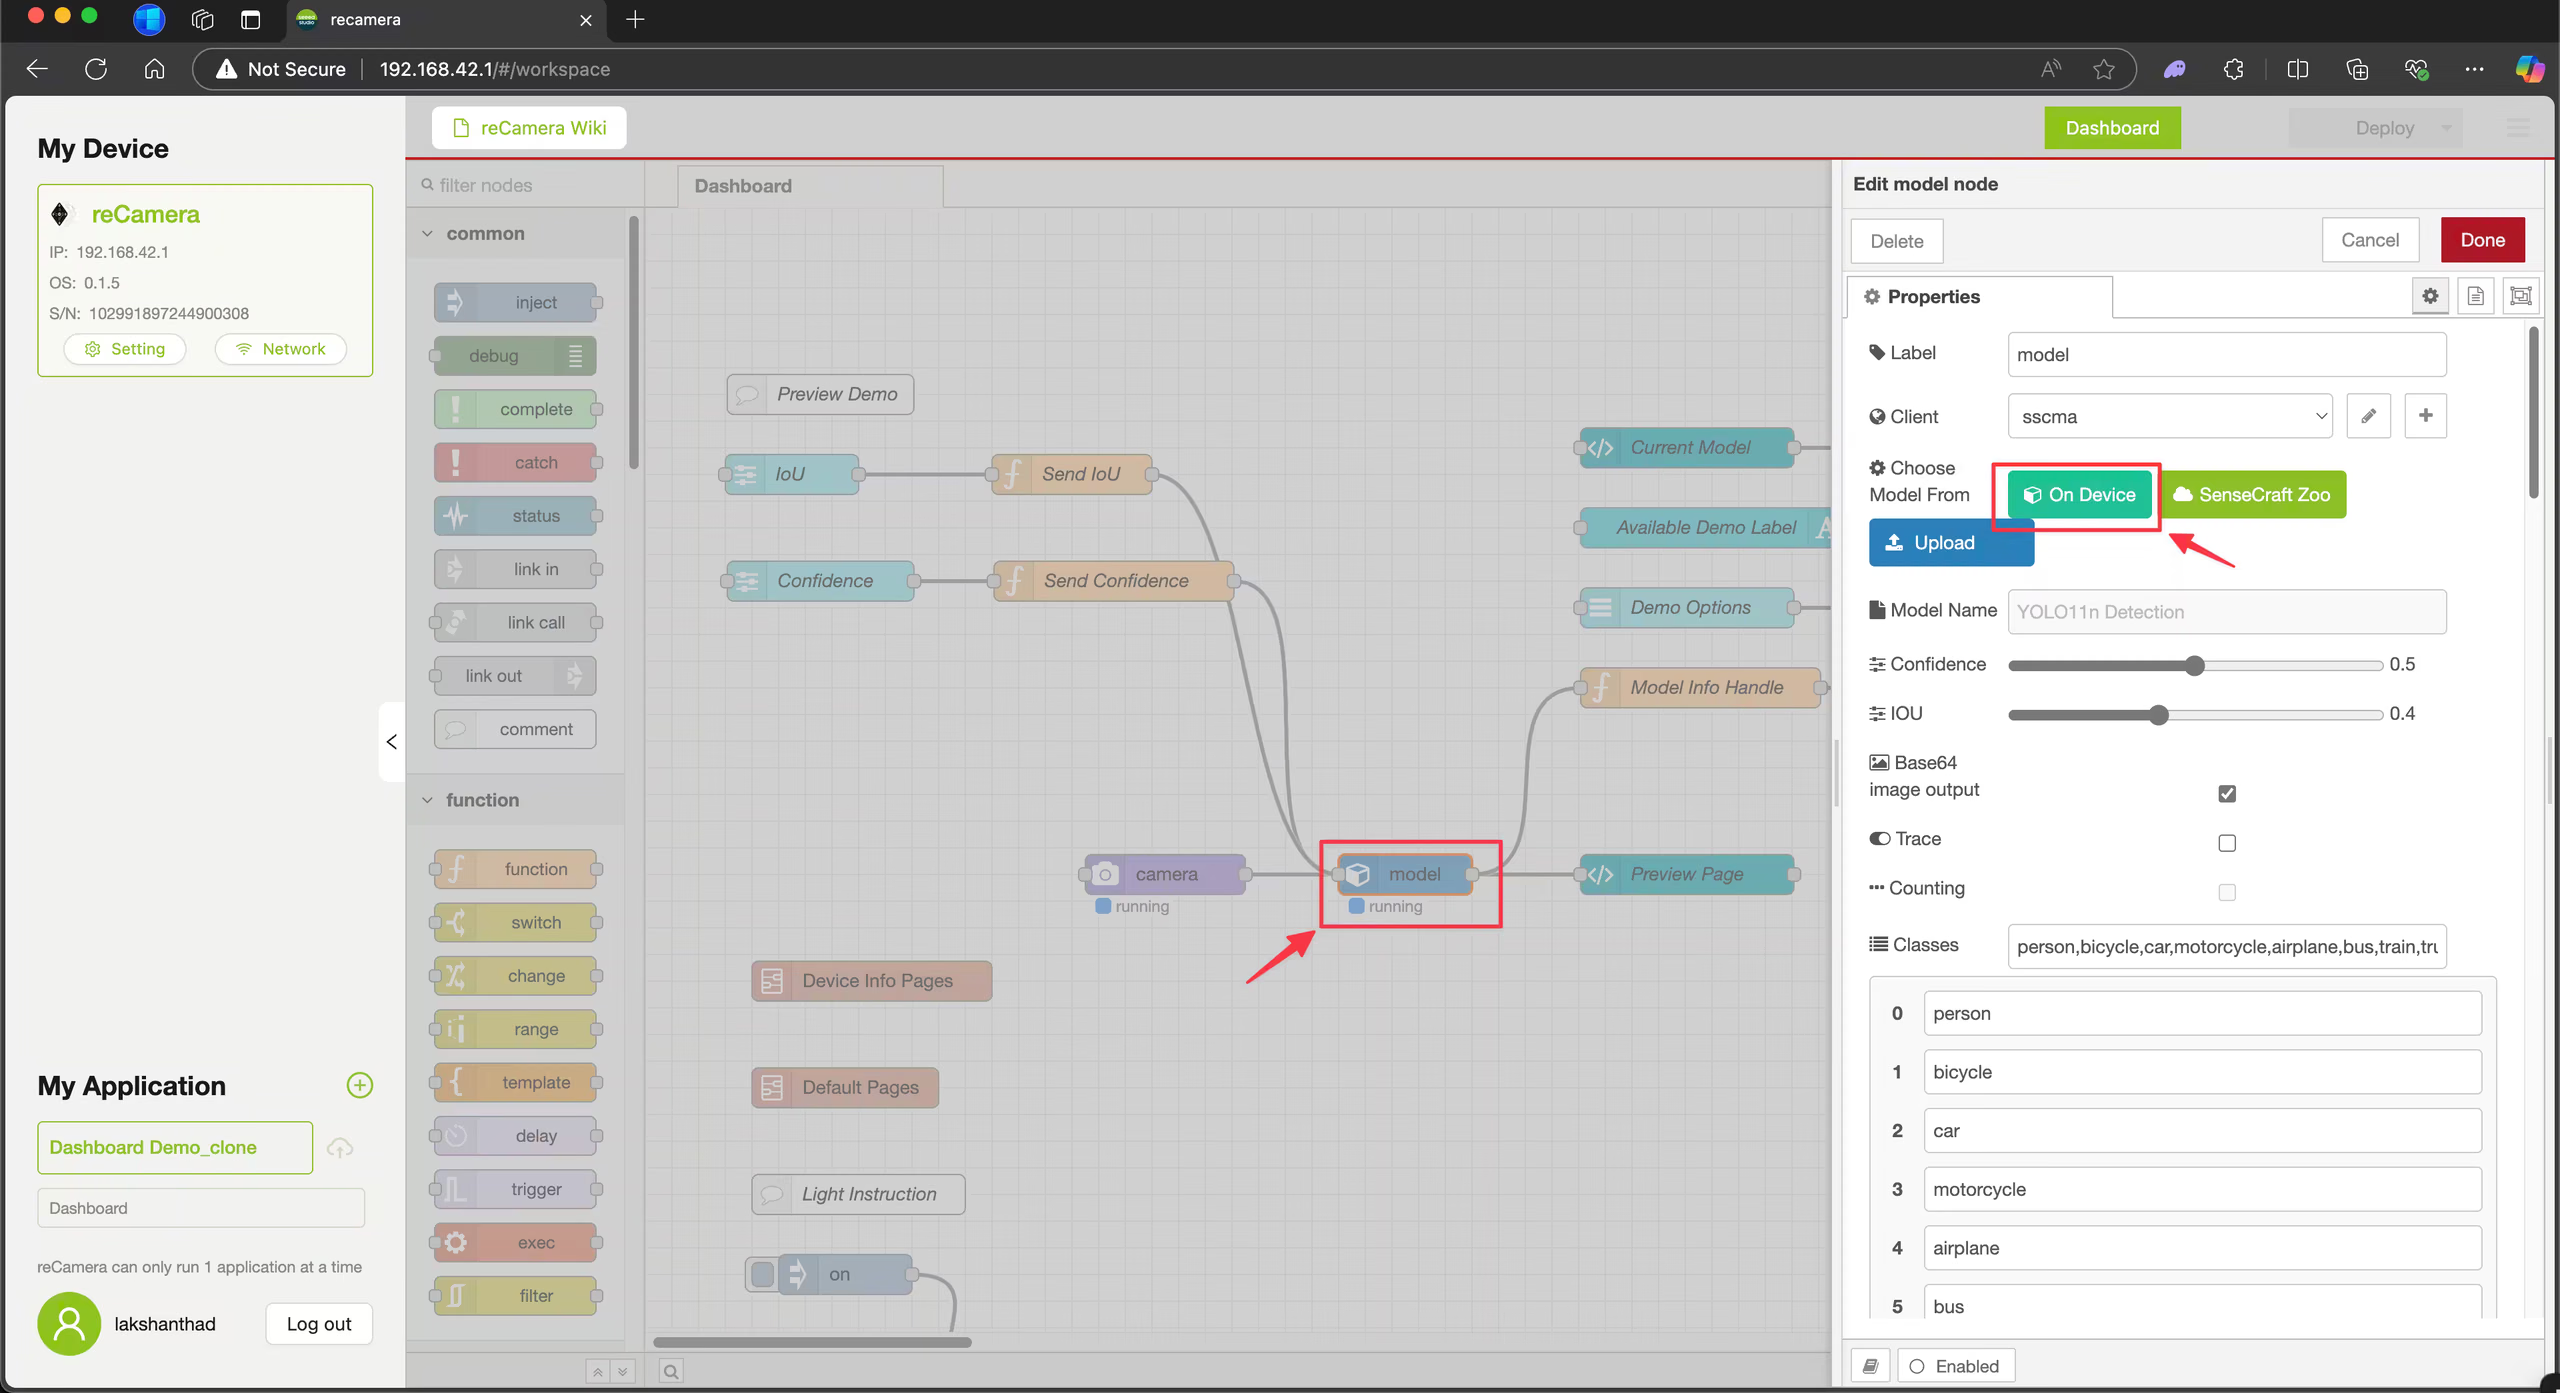
Шаг 3. Нажми на узел model, а затем на On Device.
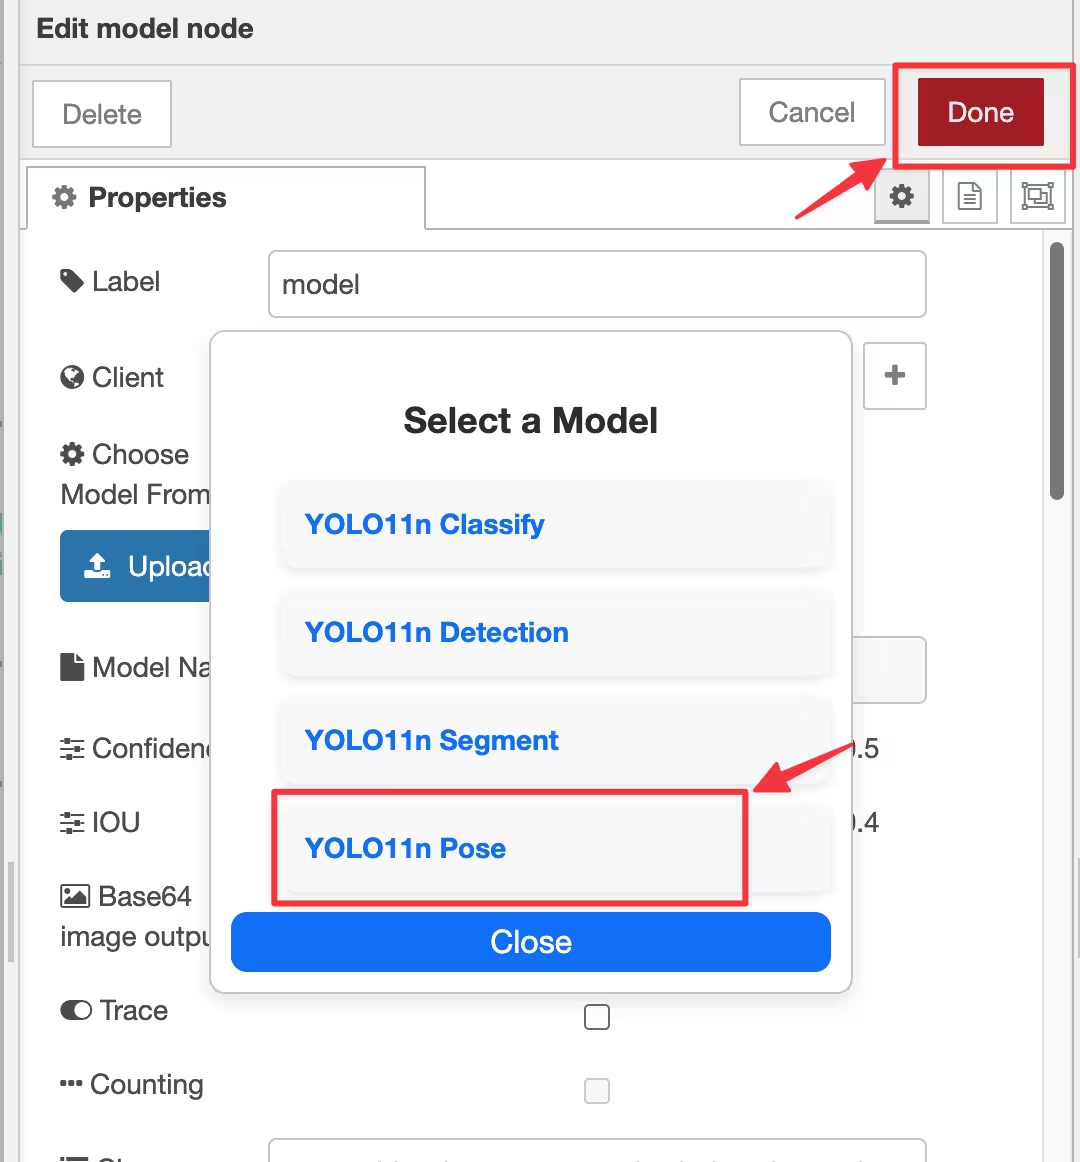
Шаг 4. Выбери одну из четырёх предустановленных моделей и нажми Done. В этом примере выбрана модель оценки позы.
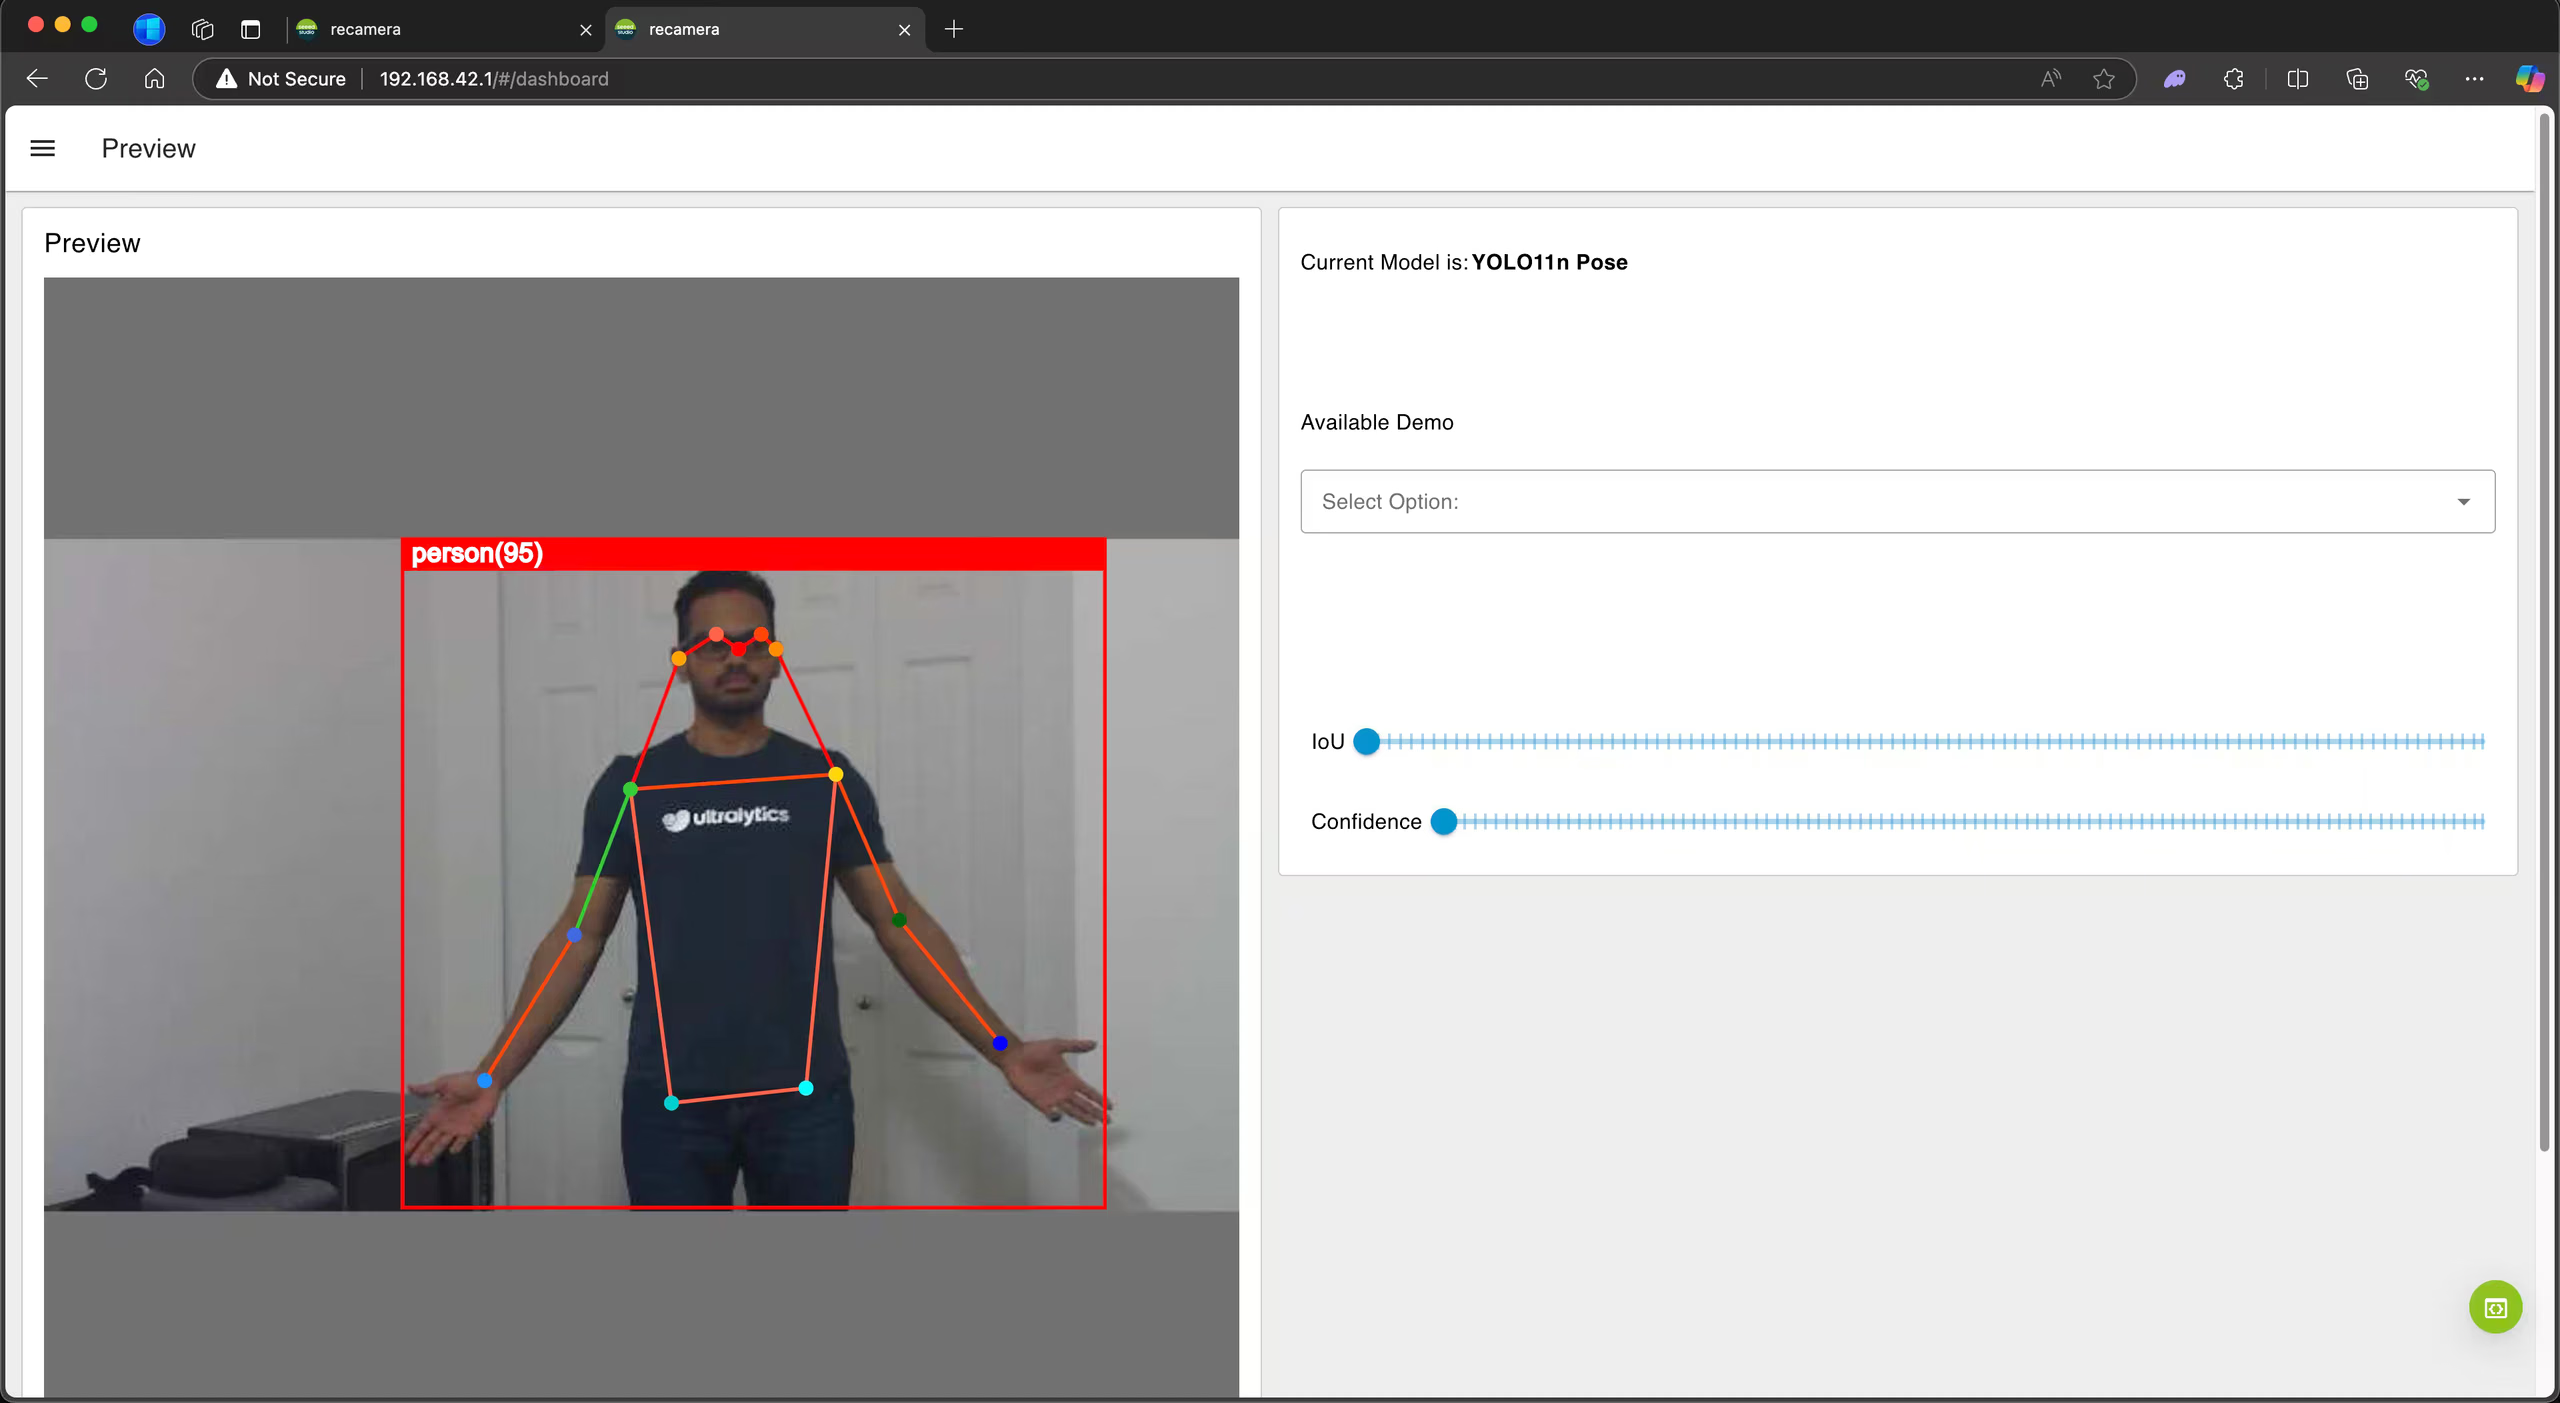
Шаг 5. Нажми Deploy, а после завершения развертывания нажми Dashboard.
Теперь на панели отображается модель оценки позы, работающая с видеопотоком камеры.
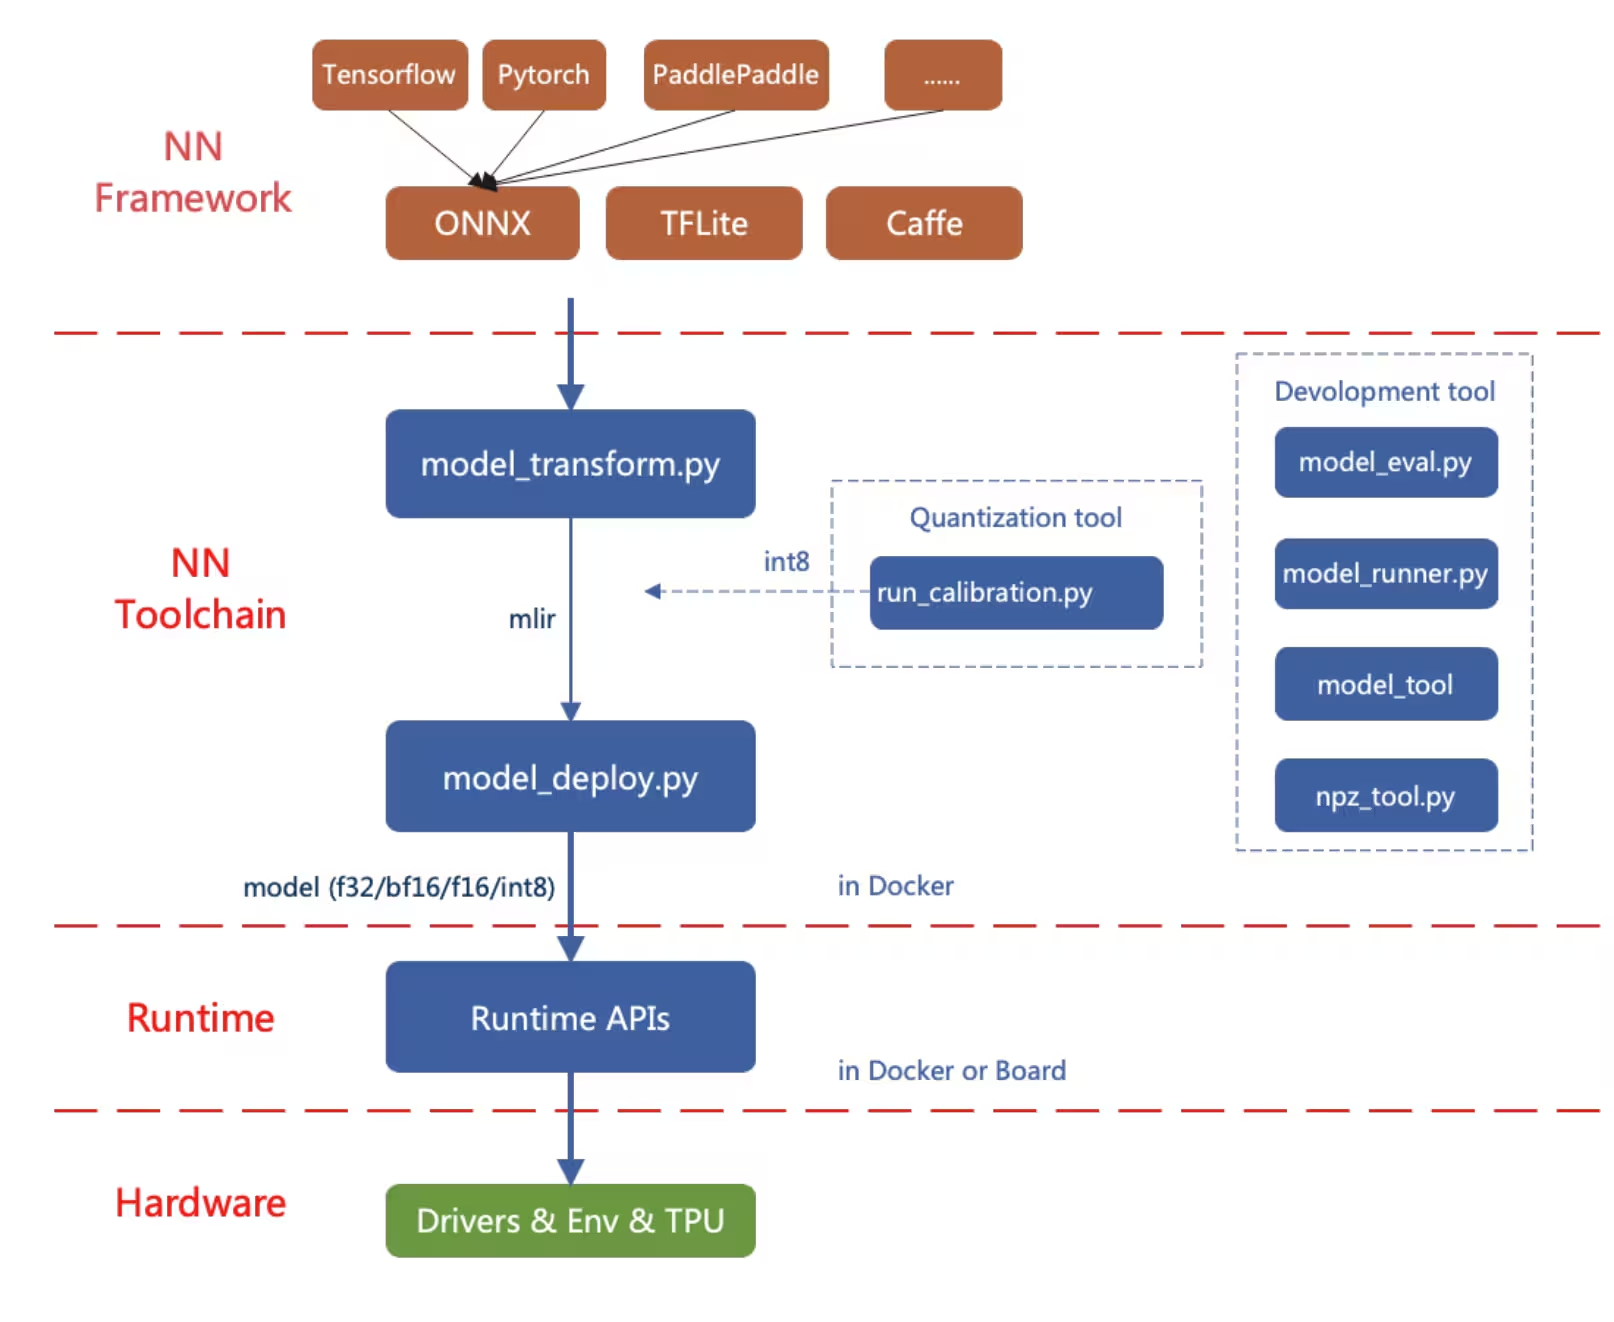
Экспорт в cvimodel: преобразование модели YOLO26#
Чтобы использовать модель YOLO26, обученную на собственных данных, с reCamera, выполни следующие действия.
Сначала в ходе преобразования модель PyTorch экспортируется в ONNX, затем преобразуется в формат модели MLIR, а в конце MLIR преобразуется в cvimodel для выполнения инференса на устройстве.
Экспорт в ONNX#
Экспортируй модель Ultralytics YOLO26 в формат ONNX.
Установка#
Чтобы установить необходимые пакеты, выполни команду:
pip install ultralyticsПодробные инструкции и рекомендации по установке смотри в руководстве по установке Ultralytics. Если при установке пакетов, необходимых для YOLO26, возникнут сложности, решения и советы найдешь в руководстве по распространенным проблемам.
Использование#
from ultralytics import YOLO

# Загрузи модель YOLO26
model = YOLO("yolo26n.pt")

# Экспортировать модель в формат ONNX
model.export(format="onnx", opset=14)  # создаёт 'yolo26n.onnx'
Подробнее о процессе экспорта смотри на странице документации Ultralytics об экспорте.
Экспорт ONNX в MLIR и cvimodel#
Получив модель ONNX, перейди на страницу Преобразование и квантование моделей ИИ, чтобы преобразовать модель ONNX в MLIR, а затем в cvimodel.
Практическое применение reCamera#
Встроенное компьютерное зрение reCamera и модульная конструкция делают её подходящей для широкого спектра реальных задач.
-
Обнаружение падений: reCamera предназначена для применения в сфере безопасности и здравоохранения. Она может обнаруживать падения в реальном времени, поэтому хорошо подходит для ухода за пожилыми людьми, больниц и промышленных объектов, где критически важна быстрая реакция.
-
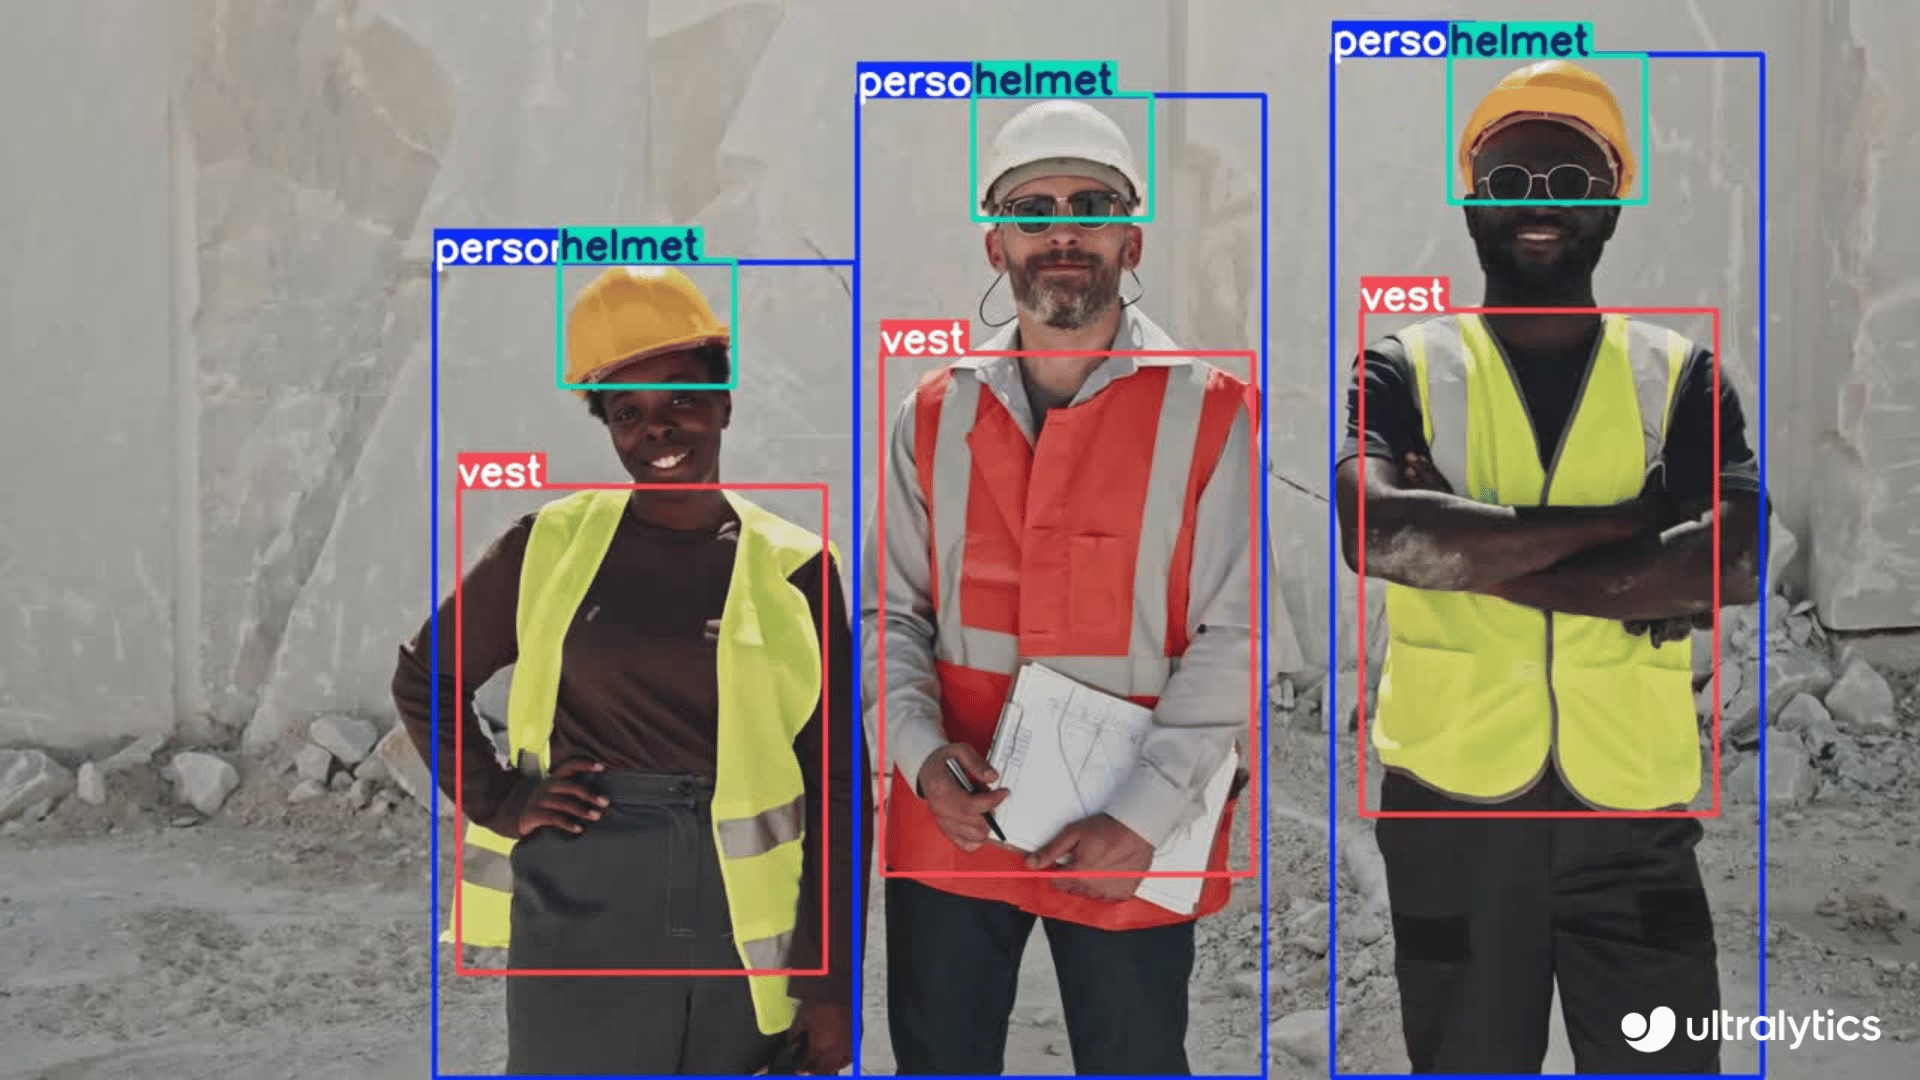
Обнаружение средств индивидуальной защиты: reCamera помогает обеспечивать безопасность на рабочем месте, контролируя использование СИЗ в реальном времени. Она определяет, носят ли работники каски, перчатки и другие средства защиты, снижая риски в промышленной среде.
-
Обнаружение пожара: возможности обработки данных reCamera в реальном времени хорошо подходят для обнаружения пожара на промышленных и жилых объектах и позволяют заблаговременно предупреждать о потенциальных катастрофах.
-
Обнаружение отходов: устройство также можно использовать для обнаружения отходов при экологическом мониторинге и управлении отходами с YOLO11.
-
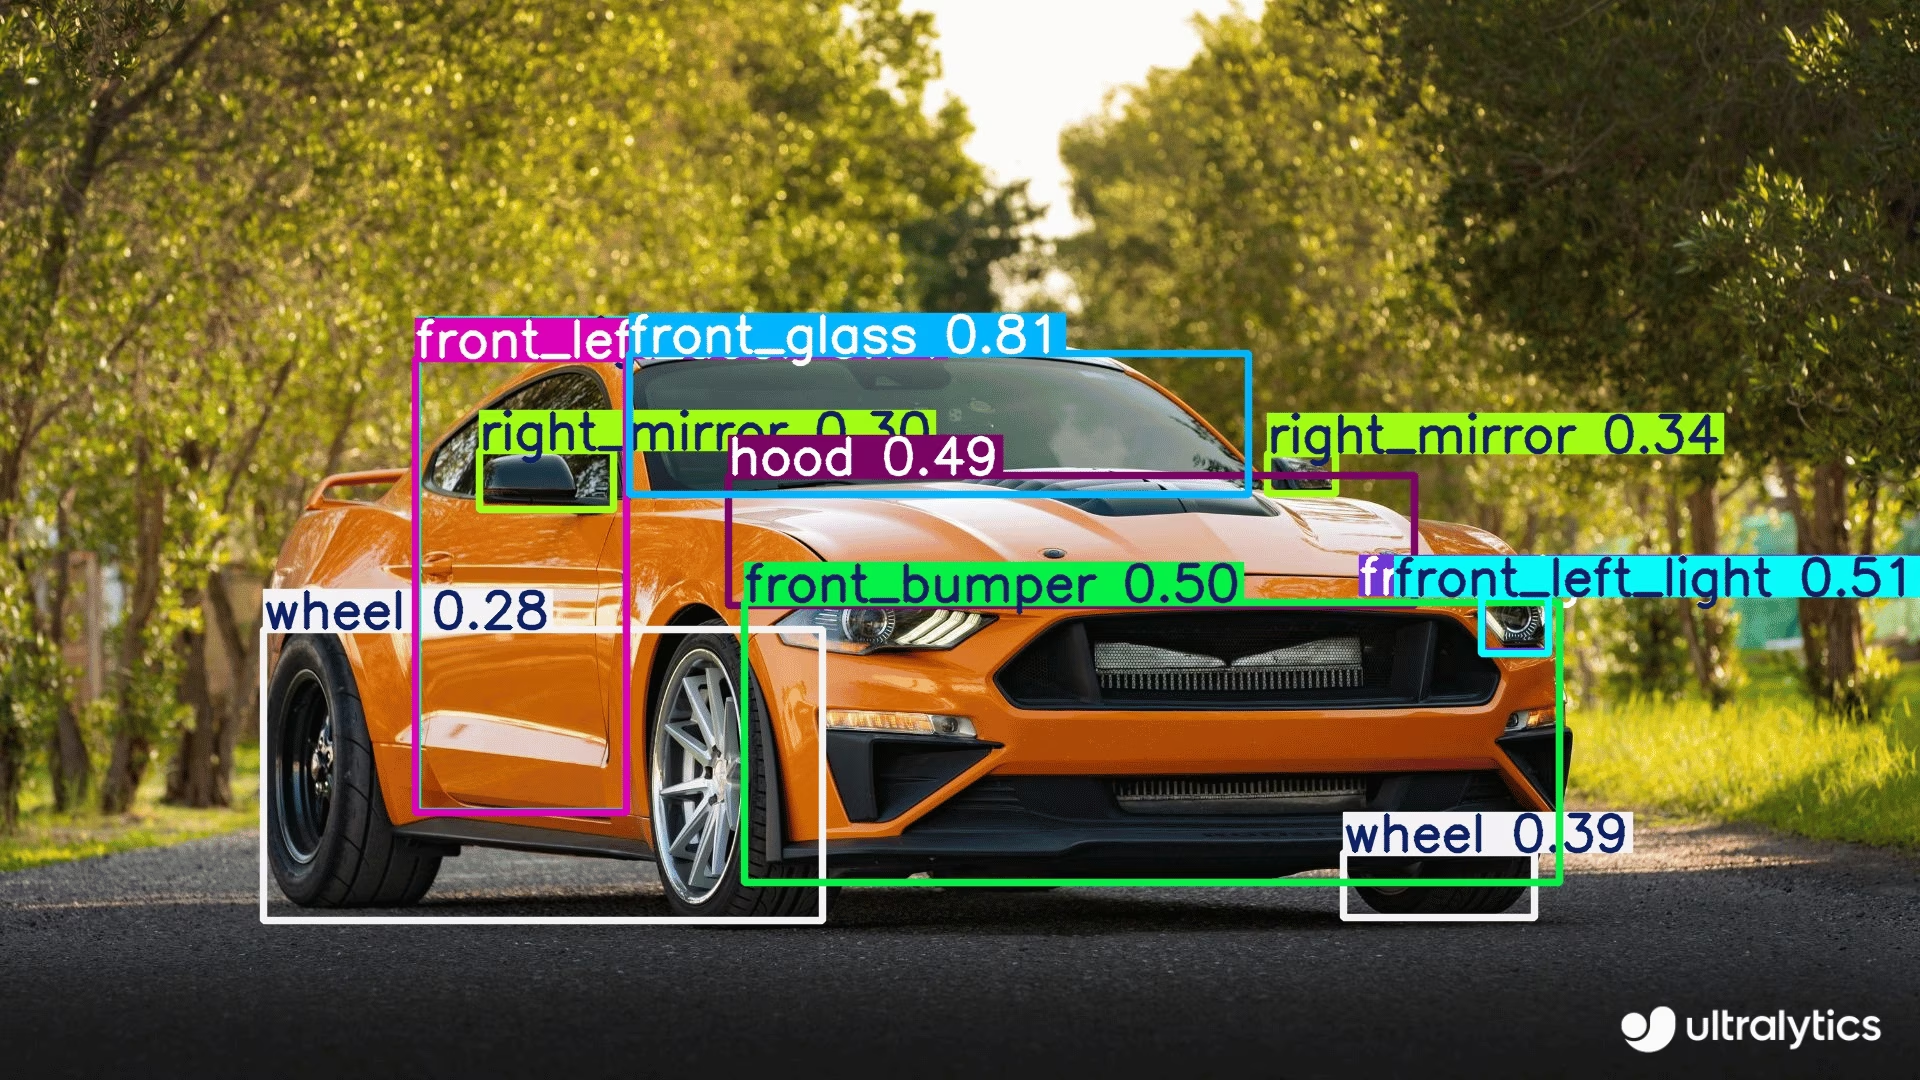
Обнаружение автомобильных деталей: в автомобильной промышленности и производстве reCamera помогает обнаруживать и анализировать детали автомобилей для контроля качества, мониторинга сборочной линии и управления запасами.
Часто задаваемые вопросы#
Чтобы впервые настроить reCamera, выполни следующие действия:
- Подключи reCamera к источнику питания
- Подключи устройство к сети, воспользовавшись страницей Начало работы с reCamera (выбери устройство, чтобы открыть краткое руководство по началу работы)
- Открой веб-интерфейс Node-RED, введя IP-адрес устройства в браузере (или используй
192.168.42.1, если подключение выполняется через USB) - Сразу используй предустановленные модели YOLO через панель управления
Да, на reCamera можно использовать собственные модели YOLO26. Для этого:
- Экспортируй модель PyTorch в формат ONNX с помощью
model.export(format="onnx", opset=14) - Преобразуй модель ONNX в формат MLIR
- Преобразуй MLIR в формат cvimodel для выполнения инференса на устройстве
- Загрузи преобразованную модель на reCamera
Подробные инструкции см. в руководстве Преобразование и квантование моделей ИИ.
- Экспортируй модель PyTorch в формат ONNX с помощью
В отличие от традиционных IP-камер, которым для обработки данных требуется внешнее оборудование, reCamera:
- Выполняет обработку с помощью ИИ прямо на устройстве благодаря процессору RISC-V SG200X
- Обеспечивает вычислительную мощность 1 TOPS для приложений периферийного ИИ в реальном времени
- Имеет модульную конструкцию, позволяющую обновлять компоненты и настраивать устройство
- Поддерживает передовые видеотехнологии, такие как сжатие H.264/H.265, HDR-изображение и шумоподавление 3D
- Предустановленные модели Ultralytics YOLO готовы к использованию
Благодаря этим возможностям reCamera представляет собой автономное решение для приложений периферийного ИИ, которому не требуется дополнительное внешнее оборудование для обработки данных.


Комментарии50
Задай вопрос, поделись результатами или помоги кому-нибудь.
tcpipchip
we wrote a book and trainned to yolo26 on ultralytics...i recall that works
 Glenn JocherUltralytics
Yes, a custom-trained
YOLO26model can run onreCamerausing theONNX -> MLIR -> cvimodelworkflow in the reCamera guide; if you hit a blocker, please share the exact step and full error here so the Ultralytics team can help.
HanJammer
This site mentions recamera comes with YOLO26 (which is why I bought two of them) yet YOLO11 is installed (which is visible on screenshots as well) and I can't load YOLO26 - how to do that? I can't find reliable guide :(
Ah nevermind, I think I got it, still it would be better not to advertise the camera "reCamera comes pre-installed with four Ultralytics YOLO26 models" which is basically not true.
I whipped out some 'single click' tool to convert YOLO26 onnx-es which makes it a bit easier... I need to test it a bit, for now it supports the base model. Perhaps I will push it to my github later this week.
This is fantastic.
When you finish it, i will add to the BOOK.
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
Here is the first version of the converter util (it's just GUI and few scripts over the actual workflow). For now it was tested with a base detection model under Windows. More to come.
https://github.com/HanJammer/reCamera_YOLO26
Video presentation here: https://youtu.be/XgPjyj2U8YQ
wow!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
i will test soon!
- Glenn JocherUltralytics
Thanks for sharing this; for anyone testing, the supported path today is still the reCamera integration guide together with Seeed’s model conversion guide, and we’ll review the docs wording around preinstalled models since some devices appear to ship with YOLO11 rather than YOLO26.
@glenn-jocher Have you a recamera ?
- Glenn JocherUltralytics
I don’t personally keep a reCamera on my desk, but the workflow in the Seeed Studio reCamera guide is the supported path; if you have a specific setup or export question, please drop it here and the Ultralytics team can take a look.
I tested on recamera with my trainned pose keypoint model... Same problem...no keypoint
Need to test on yolo8 on tdl sdk
- Glenn JocherUltralytics
Thanks for checking this; for custom pose models on reCamera, please drop the exact export and conversion steps here in the discussion so the Ultralytics team can take a look, since keypoints should work only after a correct
ONNX -> MLIR -> cvimodelpipeline as outlined in the reCamera guide and Seeed’s conversion guide, and it’s worth first confirming your exportedONNXmodel still produces keypoints before converting.
did you do calibration ? where the images to me to the calibration :(
- Glenn JocherUltralytics
Calibration isn’t done in the Ultralytics export step; for reCamera, you export to ONNX first with the reCamera guide, then calibration happens during Seeed’s ONNX→MLIR→
cvimodelflow using a small representative set of your own images, as described in Seeed’s Convert and Quantize AI Models guide. If you hit an error in that step, please drop the full log here and we’ll take a look.
still waiting...
send me your cvimodel too...yolo11 and yolo8
please, send me arguments used in your scripts...
did you train keypoints on animals and persons, right ?
tiruvijayakumar
NOO, i didnt train on animals, i trained on these classes for pose detection for persons using yolov11n-pose.pt weights. I fine‑tuned the YOLOv11n‑pose.pt model on my custom classes:
Running Walking Golf Skate Horse riding Kicking Diving I just uploaded animal detection model to justify that custom model deployment with quantization for object detection(yolo11n.pt) on recamera has no issues, it was another cvi model which i had no issues, it worked PERFECTLY. i only issue what i am facing is the pose detection quantized model where i am not able to see the keypoints on the inference output but bounding box is drawn along with predicted class label refer below:
now just trying to train the model for pose detection using yolov8 and then i would try quantizing the model and check if the keypoints are shown in the inference output
- Glenn JocherUltralytics
Thanks, that helps narrow it down — since detection
cvimodels work and only the quantized pose model loses keypoints, this looks more like a pose conversion or postprocessing issue in the ONNX → MLIR →cvimodelstep than a training problem. Please keep the details here so the Ultralytics team can see them, and share the exact conversion commands and full text logs from the reCamera guide and Seeed model conversion guide, plus whether the same pre-quantized ONNX shows keypoints before conversion. i ran predictions on ultralytics hub on the .pt model format, i attached the whole problem scenario and image content :https://github.com/orgs/ultralytics/discussions/22090?sort=new#discussioncomment-16346206 Any ways uploading the prediction on ultralytics hub in this thread also :
so on the model.pt file inference shows this data, this confirms that pose estimation model works. { "images": [ { "shape": [ 426, 640 ], "speed": { "preprocess": 1.41517, "inference": 130.14456, "postprocess": 0.99221 }, "results": [ { "name": "Kicking", "class": 5, "confidence": 0.80929, "box": { "x1": 0.26068, "y1": 0.10738, "x2": 0.55882, "y2": 0.85426 }, "keypoints": { "x": [ 0.41923001408576965, 0.42656999826431274, 0.4166699945926666, 0.45181000232696533, 0.42857998609542847, 0.488209992647171, 0.43380001187324524, 0.543470025062561, 0.41604000329971313, 0.5516700148582458, 0.4164600074291229, 0.46198999881744385, 0.4427199959754944, 0.357340008020401, 0.427839994430542, 0.29197001457214355, 0.43891000747680664 ], "y": [ 0.2315099984407425, 0.21907000243663788, 0.21740999817848206, 0.21602000296115875, 0.21322999894618988, 0.2783600091934204, 0.2824600040912628, 0.3255299925804138, 0.35097000002861023, 0.32879000902175903, 0.3619599938392639, 0.5179499983787537, 0.5104399919509888, 0.6517800092697144, 0.6389099955558777, 0.7586100101470947, 0.7324900031089783 ], "visible": [ 0.9994300007820129, 0.9990299940109253, 0.9990000128746033, 0.999019980430603, 0.9988300204277039, 0.9995700120925903, 0.9996600151062012, 0.998960018157959, 0.9992700219154358, 0.9985499978065491, 0.997439980506897, 0.9995700120925903, 0.9995700120925903, 0.9988800287246704, 0.9989299774169922, 0.982990026473999, 0.9852499961853027 ] } } ] } ], "metadata": { "imageCount": 1, "functionTimeAlive": 78321.917, "functionTimeCall": 0.138, "model": "best.pt", "version": { "ultralytics": "8.4.30", "torch": "2.11.0+cpu", "torchvision": "0.26.0+cpu", "python": "3.14.3" } }, "networkTime": 1.214 }
I didnt capture the conversion commands and text logs during the onnx->mlir->cvimodel, would repeat the same steps and paste the images in this thread itself.
Exported the yolov11n-pose.pt(finetuned) on google colab to onnx format
Uploaded the model on netron to view the structure, onnx is in the format IRv9 ,opset v20(would downgrade it). Classes are running, walking, golf-swing, skateboarding, riding-horse and kicking
Seeed studio guide for downgrading
Initial structure of workspace folder
Step1: pull sopho/tpuc_dev:v3.1
Step2: starting the container
Step3: installing onnx
Step4: Clone Downgrade Script
Step5: Downgrade Script settings IR v8 and Opset v17
Step6: Install TPU-MLIR tools inside container:
Step7: clone tpu-mlir
Step8: setup environment tpu-mlir(long step)
Step9: according to seeed studio guide, i have to include outputs before the model's head as the parameter for this particular step model_transform
--model_name yolo11n
--model_def yolo11n.onnx
--input_shapes "[[1,3,640,640]]"
--mean "0.0,0.0,0.0"
--scale "0.0039216,0.0039216,0.0039216"
--keep_aspect_ratio
--pixel_format rgb
--output_names "/model.23/cv2.0/cv2.0.2/Conv_output_0,/model.23/cv3.0/cv3.0.2/Conv_output_0,/model.23/cv2.1/cv2.1.2/Conv_output_0,/model.23/cv3.1/cv3.1.2/Conv_output_0,/model.23/cv2.2/cv2.2.2/Conv_output_0,/model.23/cv3.2/cv3.2.2/Conv_output_0"
--test_input ../image/dog.jpg
--test_result yolo11n_top_outputs.npz
--mlir yolo11n.mlir i have the onnx file, could someone of the team help me identify the outputs before the model's head? @glenn-jocher here is the onnx file https://drive.google.com/file/d/1UF25DK2zXx0GCWdcx55SPYHL71SylDeg/view?usp=sharing
and some animal pictures...