RT-DETR от Baidu: детектор объектов реального времени на основе Vision Transformer
Обзор#
RT-DETR (Real-Time Detection Transformer), разработанная Baidu, — сквозная модель обнаружения объектов, обеспечивающая работу в реальном времени и высокую точность. Модель основана на DETR — системе обнаружения объектов на трансформерах, которая не использует NMS. Для достижения скорости работы в реальном времени в ней используются свёрточная базовая сеть и эффективный гибридный кодировщик. RT-DETR эффективно обрабатывает признаки разных масштабов, разделяя взаимодействие внутри масштаба и объединение признаков между масштабами. Модель легко адаптируется: скорость инференса можно гибко настраивать, используя разное число слоев декодера без повторного обучения. Лучше всего RT-DETR работает на ускоренных бэкендах, например CUDA с TensorRT.
Смотри: Как использовать RT-DETR от Baidu для обнаружения объектов | Инференс и бенчмаркинг с Ultralytics
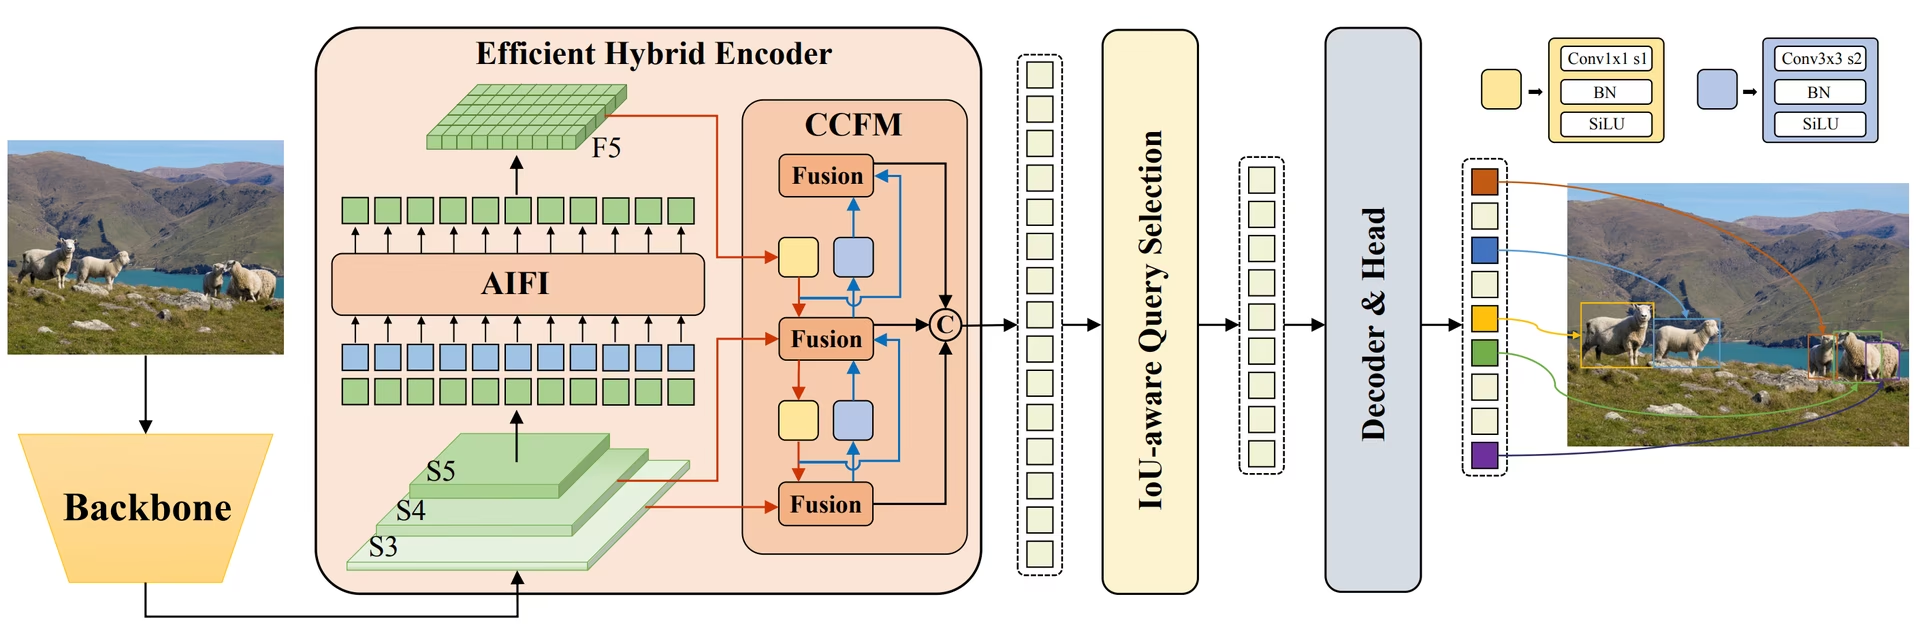 Обзор RT-DETR от Baidu. На схеме архитектуры RT-DETR показаны три последних этапа бэкбона {S3, S4, S5}, которые служат входом энкодера. Эффективный гибридный энкодер преобразует многомасштабные признаки в последовательность признаков изображения с помощью взаимодействия признаков внутри масштаба (AIFI) и модуля слияния признаков между масштабами (CCFM). Для выбора фиксированного числа признаков изображения, которые будут начальными запросами объектов для декодера, используется выбор запросов с учётом IoU. Затем декодер со вспомогательными головами предсказания итеративно оптимизирует запросы объектов, чтобы генерировать рамки и оценки уверенности (источник).
Основные особенности#
- Эффективный гибридный кодировщик: RT-DETR от Baidu использует эффективный гибридный кодировщик, который обрабатывает признаки разных масштабов, разделяя взаимодействие внутри масштаба и объединение признаков между масштабами. Такая архитектура на основе трансформеров снижает вычислительные затраты и обеспечивает обнаружение объектов в реальном времени.
- Выбор запросов с учетом IoU: RT-DETR от Baidu улучшает инициализацию запросов объектов благодаря выбору запросов с учетом IoU. Это позволяет модели сосредоточиться на наиболее важных объектах в сцене и повысить точность обнаружения.
- Адаптируемая скорость инференса: RT-DETR от Baidu позволяет гибко регулировать скорость инференса, выбирая разные слои декодера без повторного обучения. Благодаря такой адаптивности модель подходит для практического применения в различных сценариях обнаружения объектов в реальном времени.
- Архитектура без NMS: RT-DETR основан на DETR и не требует постобработки с помощью подавления немаксимумов, что упрощает конвейер обнаружения и потенциально повышает его эффективность.
- Обнаружение без якорей: Как детектор без якорей, RT-DETR упрощает процесс обнаружения и может лучше обобщать данные разных наборов.
Предварительно обученные модели#
Python API Ultralytics предоставляет предварительно обученные модели RT-DETR на PaddlePaddle разных размеров:
- RT-DETR-L: 53,0% AP на COCO val2017, 114 FPS на GPU T4
- RT-DETR-X: 54,8% AP на COCO val2017, 74 FPS на GPU T4
В июле 2024 года Baidu выпустила RTDETRv2 — усовершенствованную версию исходной архитектуры.
Примеры использования#
В примерах ниже показаны простые способы обучения и инференса RT-DETR. Модели также можно обучать на облачных GPU с помощью платформы Ultralytics.
from ultralytics import RTDETR

# Загрузи предварительно обученную на COCO модель RT-DETR-l
model = RTDETR("rtdetr-l.pt")

# Показать информацию о модели (необязательно)
model.info()

# Обучить модель на демонстрационном наборе данных COCO8 в течение 100 эпох
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Выполни инференс изображения 'bus.jpg' с помощью модели RT-DETR-l
results = model("path/to/bus.jpg")Задай deterministic=False при обучении RT-DETR на CUDA с PyTorch 2.0 или более поздней версии. В механизме deformable attention используется F.grid_sample, у которого нет детерминированного обратного прохода CUDA, поэтому deterministic=True не обеспечивает воспроизводимость запуска и может снизить пропускную способность обучения. seed по-прежнему управляет инициализацией весов, порядком данных и выборкой аугментаций.
Предварительно обученные веса RT-DETR поддерживают две настройки времени инференса, которые позволяют снизить задержку без повторного обучения:
eval_idx: прекращает декодирование раньше. Для декодера из 6 слоёв по умолчанию укажи индекс, начинающийся с нуля (0–5).eval_idx=5использует все слои, аeval_idx=3— 4 слоя. На GPU T4 с TensorRT v10.11 RT-DETR-L повышает производительность с 8,0 мс / 52,7 mAP до 7,4 мс / 52,5 mAP при использовании 4 слоёв.num_queries: уменьшает число запросов объектов (по умолчанию: 300). Снижение до 100 позволяет достичь 7,4 мс / 51,7 mAP на COCO в той же конфигурации. На наборах данных, где на изображении меньше объектов, падение mAP обычно меньше, но значение должно быть выше максимального ожидаемого числа объектов на изображении.
Обе настройки могут снизить mAP — перед развёртыванием проверь этот компромисс на своём наборе данных.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Выбери одну или обе настройки после проверки компромисса между скоростью и точностью.
head.decoder.eval_idx = 3  # Используй 4 из 6 слоёв декодера.
head.num_queries = 100  # Используй меньше запросов объектов.

results = rtdetr("path/to/image.jpg")

# При экспорте используются те же настройки декодера и запросов, в том числе при экспорте в TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)
Поддерживаемые задачи и режимы#
В этой таблице представлены типы моделей, соответствующие предварительно обученные веса, задачи, поддерживаемые каждой моделью, а также поддерживаемые режимы (обучение, валидация, предсказание, экспорт), обозначенные эмодзи ✅.
| Тип модели | Предобученные веса | Поддерживаемые задачи | Обучение | Валидация | Инференс | Экспорт |
|---|---|---|---|---|---|---|
| RT-DETR Large | rtdetr-l.pt | Обнаружение объектов | ✅ | ✅ | ✅ | ✅ |
| RT-DETR Extra-Large | rtdetr-x.pt | Обнаружение объектов | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml и rtdetr-resnet101.yaml поставляются только в виде архитектур YAML. Ultralytics выпускает предварительно обученные веса только для rtdetr-l и rtdetr-x. Создай варианты ResNet из YAML (например, RTDETR("rtdetr-resnet50.yaml")) и обучи их или выполни дообучение по необходимости.
Оптимальные сценарии применения#
RT-DETR особенно хорошо подходит для приложений, которым нужны и высокая точность, и работа в реальном времени:
- Автономное вождение: надежное восприятие окружающей среды в системах беспилотного вождения, где критически важны скорость и точность.
- Продвинутая робототехника: позволяет роботам выполнять сложные задачи, требующие точного распознавания объектов и взаимодействия с ними в динамичной среде.
- Медицинская визуализация: применение в здравоохранении, где точность обнаружения объектов может иметь решающее значение для диагностики.
- Системы видеонаблюдения: подходят для задач безопасности, требующих мониторинга в реальном времени и высокой точности обнаружения. Подробнее о системах охранной сигнализации.
- Анализ спутниковых изображений: позволяет подробно анализировать изображения высокого разрешения, для которых важно понимание глобального контекста. Подробнее о компьютерном зрении для спутниковых изображений.
Цитирование и благодарности#
Если ты используешь RT-DETR от Baidu в исследованиях или разработке, процитируй исходную статью:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Для RTDETRv2 можно процитировать статью 2024 года:
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Благодарим Baidu и команду PaddlePaddle за создание и поддержку этого ценного ресурса для сообщества компьютерного зрения. Мы высоко ценим их работу над детектором объектов реального времени RT-DETR на основе трансформеров.
Часто задаваемые вопросы#
RT-DETR от Baidu (Real-Time Detection Transformer) — детектор объектов реального времени на основе Transformer. Он эффективно обрабатывает многоуровневые признаки, разделяя взаимодействие внутри масштабов и объединение между масштабами с помощью эффективного гибридного энкодера. Благодаря выбору запросов с учётом IoU модель сосредотачивается на наиболее важных объектах, повышая точность обнаружения. Скорость инференса можно адаптировать без повторного обучения, изменяя число слоёв декодера, поэтому RT-DETR подходит для различных сценариев обнаружения объектов в реальном времени.
Используй Python API Ultralytics, чтобы загрузить предварительно обученные модели RT-DETR в формате PaddlePaddle. Например, вот как загрузить модель RT-DETR-l, предварительно обученную на COCO, дообучить её и запустить инференс:
Примерfrom ultralytics import RTDETR # Загрузи предварительно обученную на COCO модель RT-DETR-l model = RTDETR("rtdetr-l.pt") # Показать информацию о модели (необязательно) model.info() # Обучить модель на демонстрационном наборе данных COCO8 в течение 100 эпох results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Выполни инференс изображения 'bus.jpg' с помощью модели RT-DETR-l results = model("path/to/bus.jpg")RT-DETR от Baidu объединяет эффективный гибридный кодировщик и выбор запросов с учетом IoU, что позволяет снизить вычислительные затраты и сохранить высокую точность. Возможность регулировать скорость инференса за счет использования разного числа слоев декодера без повторного обучения обеспечивает гибкость, полезную для приложений реального времени на ускоренных бэкендах, например CUDA с TensorRT. Архитектура на основе трансформеров также позволяет учитывать более широкий контекст, чем традиционные детекторы на основе CNN.
RT-DETR от Baidu позволяет гибко настраивать скорость инференса, используя разное число слоев декодера без повторного обучения. Благодаря этому можно выбирать баланс между скоростью и точностью для задач обнаружения объектов в реальном времени: используй меньше слоев декодера для более быстрой обработки с небольшой потерей точности или все слои для максимально точных предсказаний. Эта функция особенно полезна при развертывании моделей на устройствах с разными вычислительными возможностями.
Нет. Для RT-DETR
max_detограничивает число предсказаний, возвращаемых после инференса, но не увеличивает число запросов объектов, создаваемых декодером. В предварительно обученных контрольных точках RT-DETR от Ultralytics используется 300 запросов объектов, поэтому модель не может вернуть больше 300 обнаружений на изображение, даже если задать дляmax_detбольшее значение.Используй
max_det, чтобы сократить число возвращаемых обнаружений, например доmax_det=100, если нужны только менее многочисленные предсказания с высокой уверенностью. Если на изображении в твоём наборе данных может быть больше 300 объектов, обучи собственную модель RT-DETR с большим числом запросов декодера (nq) в YAML-файле модели. Изменить это значение в предварительно обученной контрольной точке после обучения — не то же самое: чтобы научить модель обрабатывать дополнительные запросы, её нужно переобучить.Да, модели RT-DETR поддерживают режимы обучения, валидации, предсказания и экспорта в Ultralytics. Фреймворк Ultralytics предоставляет единый API для разных архитектур моделей, поэтому RT-DETR использует тот же рабочий процесс, что и модели YOLO.


Комментарии148
Задай вопрос, поделись результатами или помоги кому-нибудь.
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗