SAM 2: модель сегментации всего 2

SAM 2, преемница Segment Anything Model (SAM) от Meta, — это единая модель для сегментации объектов по запросу как на изображениях, так и в видео. Её единая архитектура с поддержкой запросов обеспечивает обработку в реальном времени и обобщение без примеров.
Модели SAM 2.1 лежат в основе функции интеллектуальной разметки на платформе Ultralytics, где сегментация по кликам ускоряет разметку наборов данных. Подробности см. в руководстве по разметке.
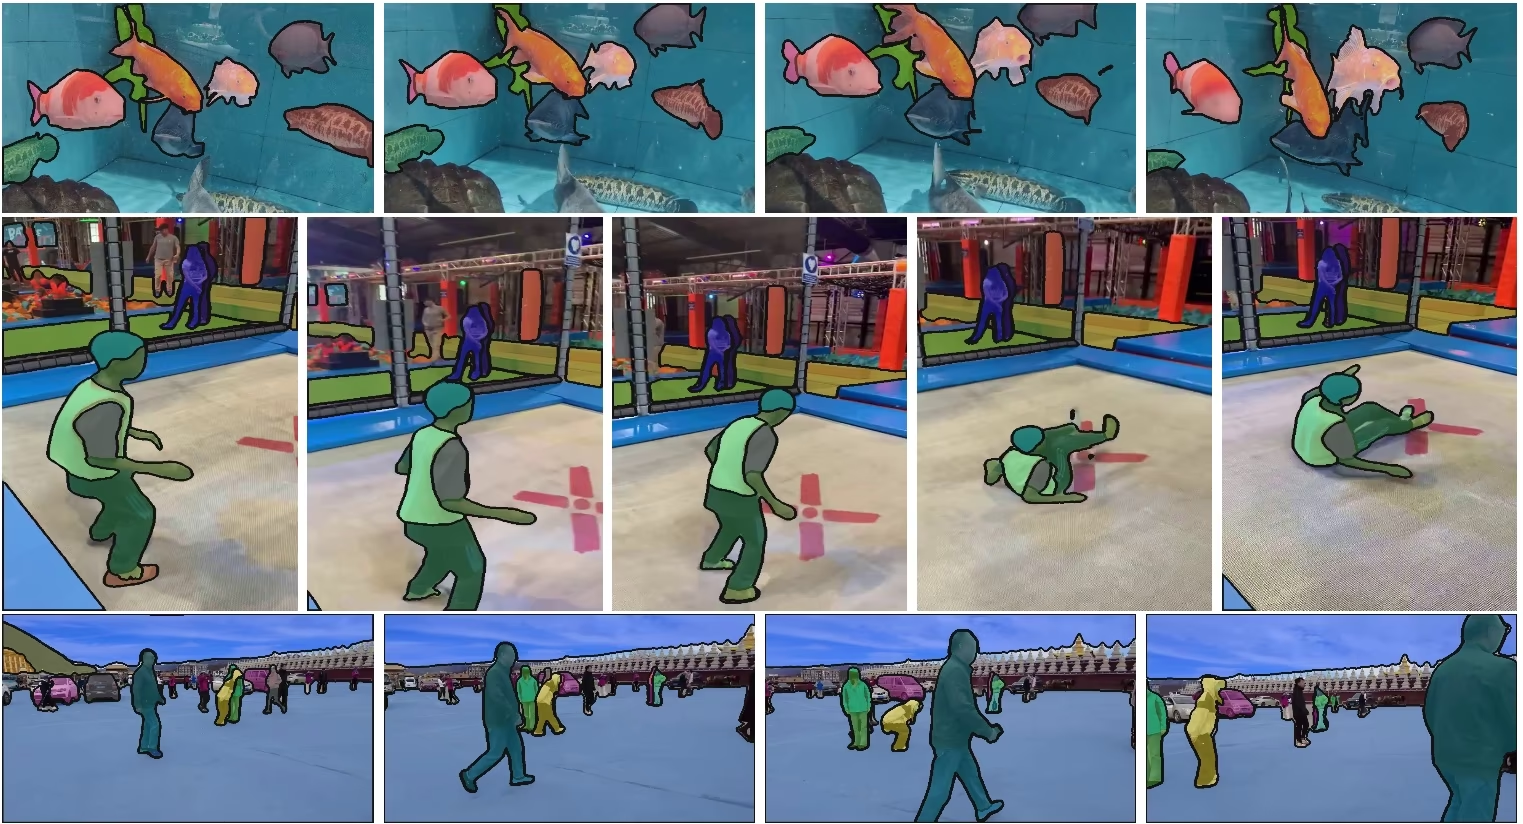
Основные особенности#
Смотри: Как запустить инференс Meta SAM2 с помощью Ultralytics | Пошаговое руководство
Унифицированная архитектура модели#
SAM 2 объединяет возможности сегментации изображений и видео в одной модели. Это упрощает развёртывание и обеспечивает стабильную производительность для разных типов данных. В модели используется гибкий интерфейс на основе запросов, позволяющий задавать интересующие объекты с помощью точек, ограничивающих рамок или масок.
Производительность в реальном времени#
Модель обеспечивает инференс в реальном времени, обрабатывая около 44 кадров в секунду. Поэтому SAM 2 подходит для приложений, которым нужна мгновенная обратная связь, например для видеомонтажа и дополненной реальности.
Zero-shot-генерализация#
SAM 2 может сегментировать объекты, с которыми раньше не сталкивалась, демонстрируя высокую способность к обобщению в режиме zero-shot. Это особенно полезно в разнообразных или меняющихся визуальных областях, где заранее заданные категории могут не охватывать все возможные объекты.
Интерактивное уточнение#
Пользователи могут итеративно уточнять результаты сегментации, добавляя запросы и точно контролируя результат. Такая интерактивность важна для уточнения результатов в таких приложениях, как аннотирование видео или медицинская визуализация.
Расширенная обработка визуальных сложностей#
В SAM 2 предусмотрены механизмы для решения распространённых задач сегментации видео, таких как перекрытие объектов и их повторное появление. Модель использует механизм памяти для отслеживания объектов между кадрами, обеспечивая непрерывность даже тогда, когда объекты временно скрываются, выходят из кадра и снова появляются в сцене.
Чтобы подробнее узнать об архитектуре и возможностях SAM 2, ознакомься с исследовательской статьёй о SAM 2.
Производительность и технические характеристики#
По данным Meta, SAM 2 превосходит предыдущие модели по нескольким метрикам:
| Показатель | SAM 2 | Предыдущий SOTA |
|---|---|---|
| Интерактивная сегментация видео | Лучший результат | - |
| Требуется взаимодействий с человеком | В 3 раза меньше | Базовый уровень |
| Точность сегментации изображений | Выше | SAM |
| Скорость инференса | В 6 раз быстрее | SAM |
Архитектура модели#
Основные компоненты#
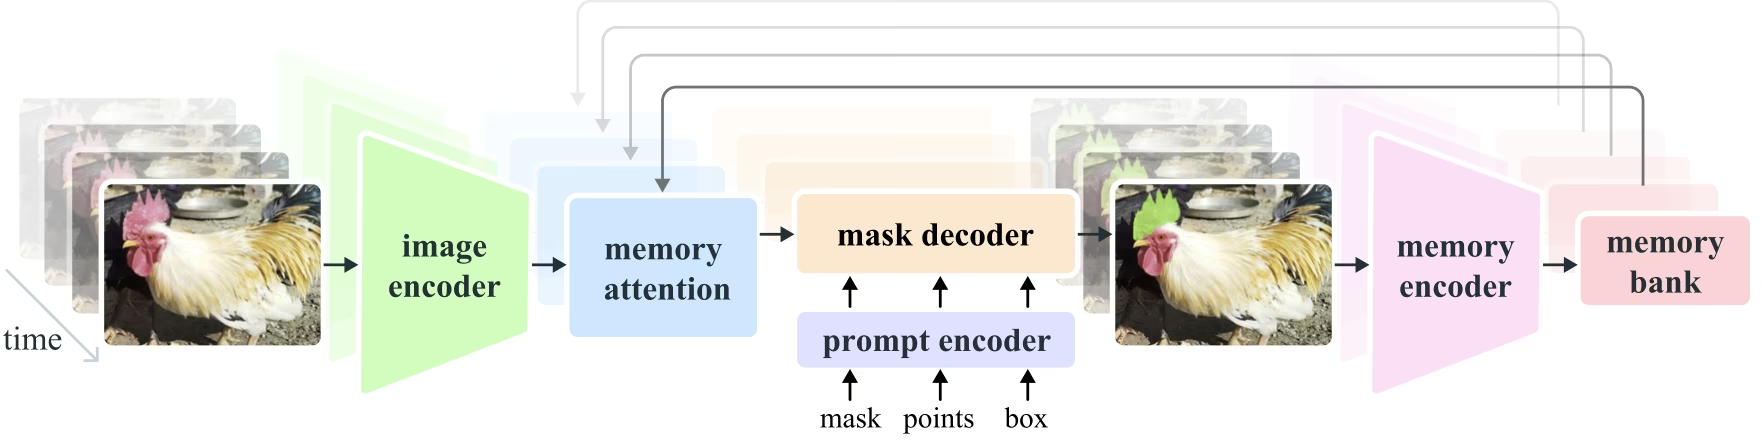
- Кодировщик изображений и видео: использует архитектуру на основе трансформера для извлечения высокоуровневых признаков из изображений и видеокадров. Этот компонент отвечает за понимание визуального содержимого на каждом временном шаге.
- Кодировщик подсказок: обрабатывает подсказки пользователя (точки, рамки, маски), чтобы направлять процесс сегментации. Благодаря этому SAM 2 адаптируется к вводу пользователя и находит целевые объекты в сцене.
- Механизм памяти: включает кодировщик памяти, банк памяти и модуль внимания к памяти. Вместе эти компоненты сохраняют и используют информацию из предыдущих кадров, позволяя модели стабильно выполнять отслеживание объектов во времени.
- Декодер масок: генерирует итоговые маски сегментации на основе закодированных признаков изображения и подсказок. При обработке видео он также использует контекст памяти, чтобы точно отслеживать объекты между кадрами.
Механизм памяти и обработка перекрытий#
Механизм памяти позволяет SAM 2 учитывать временные зависимости и перекрытия в видеоданных. По мере движения и взаимодействия объектов SAM 2 записывает их признаки в банк памяти. Когда объект перекрывается, модель может использовать эти данные, чтобы предсказать его положение и внешний вид после повторного появления. Специальная голова для обработки перекрытий работает со случаями, когда объекты не видны, и предсказывает вероятность того, что объект перекрыт.
Разрешение неоднозначности при создании нескольких масок#
В неоднозначных ситуациях, например при перекрытии объектов, SAM 2 может создавать несколько вариантов масок. Это помогает представить сложные сцены, в которых одна маска может не охватывать нужный объект.
Датасет SA-V#
Датасет SA-V, созданный для обучения SAM 2, — один из крупнейших и самых разнообразных доступных датасетов для сегментации видео. Он включает:
- Более 51 000 видео: снятых в 47 странах, что позволяет охватить широкий спектр сценариев из реального мира.
- Более 600 000 аннотаций масок: подробные пространственно-временные аннотации масок, называемые «масклетами», охватывают целые объекты и их части.
- Масштаб датасета: в датасете в 4,5 раза больше видео и в 53 раза больше аннотаций, чем в крупнейших датасетах сегментации видео предыдущего поколения.
Бенчмарки#
Сегментация объектов на видео#
Для SAM 2 опубликованы следующие результаты на основных бенчмарках сегментации видео:
| Датасет | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Интерактивная сегментация#
На задачах интерактивной сегментации SAM 2 показывает следующие результаты:
| Датасет | NoC@90 | AUC |
|---|---|---|
| DAVIS Interactive | 1.54 | 0.872 |
Установка#
SAM 2 входит в пакет ultralytics. Установи его с помощью следующей команды; веса SAM 2 автоматически загрузятся при первом использовании.
pip install ultralyticsКак использовать SAM 2: универсальная сегментация изображений и видео#
В таблице ниже перечислены доступные модели SAM 2, их предварительно обученные веса, поддерживаемые задачи и совместимость с различными режимами работы: обучением, валидацией, инференсом и экспортом.
| Тип модели | Предобученные веса | Поддерживаемые задачи | Обучение | Валидация | Инференс | Экспорт |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Сегментация экземпляров | ❌ | ❌ | ✅ | ❌ |
Примеры предсказаний SAM 2#
SAM 2 можно использовать для самых разных задач, включая редактирование видео в реальном времени, медицинскую визуализацию и автономные системы. Способность сегментировать как статические, так и динамические визуальные данные делает её универсальным инструментом для исследователей и разработчиков.
Сегментация с помощью подсказок#
Используй подсказки, чтобы сегментировать конкретные объекты на изображениях или видео.
from ultralytics import SAM

# Загрузить модель
model = SAM("sam2.1_b.pt")

# Показать информацию о модели (необязательно)
model.info()

# Выполнить инференс с подсказкой в виде bboxes
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Выполнить инференс с одной точкой
results = model(points=[900, 370], labels=[1])

# Выполнить инференс с несколькими точками
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Выполнить инференс с подсказкой в виде нескольких точек для каждого объекта
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Выполнить инференс с подсказкой в виде отрицательных точек
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Сегментировать всё#
Сегментируй всё содержимое изображения или видео без специальных подсказок.
from ultralytics import SAM

# Загрузить модель
model = SAM("sam2.1_b.pt")

# Показать информацию о модели (необязательно)
model.info()

# Выполнить инференс
model("path/to/video.mp4")- В этом примере показано, как использовать SAM 2 для сегментации всего содержимого изображения или видео, если не заданы подсказки (bboxes/точки/маски).
Сегментация видео и отслеживание объектов#
Сегментируй всё содержимое видео с помощью специальных подсказок и отслеживай объекты.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Выполнить инференс с одной точкой
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Выполнить инференс с несколькими точками
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Выполнить инференс с подсказкой в виде нескольких точек для каждого объекта
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Выполнить инференс с подсказкой в виде отрицательных точек
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Динамическая интерактивная сегментация и отслеживание#
SAM2DynamicInteractivePredictor — расширение SAM 2, не требующее обучения и обеспечивающее динамическое взаимодействие с несколькими кадрами и возможности непрерывного обучения. Этот предиктор поддерживает обновление запросов в реальном времени и управление памятью для более точного отслеживания последовательности изображений. По сравнению с исходной SAM 2, SAM2DynamicInteractivePredictor перестраивает процесс инференса, чтобы максимально эффективно использовать предварительно обученные модели SAM 2 без дополнительного обучения.
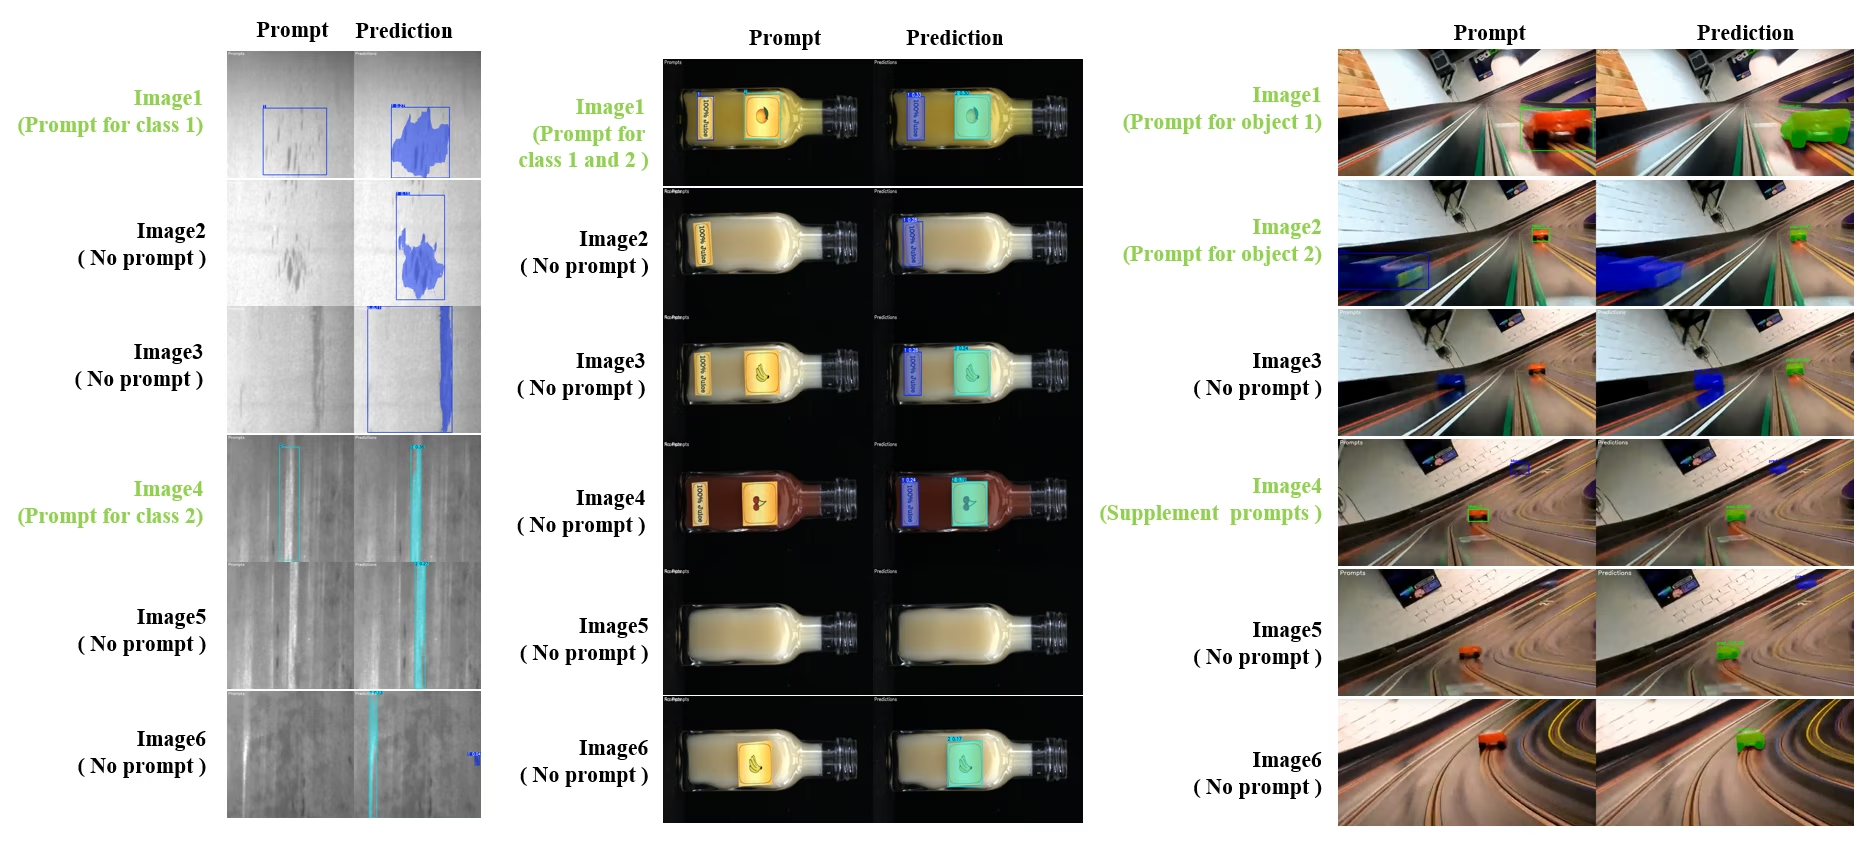
Основные особенности#
Предусмотрено три улучшения:
- Динамическое взаимодействие: добавляй запросы для новых, ещё не отслеживаемых экземпляров в последующих кадрах в любой момент обработки видео
- Непрерывное обучение: добавляй подсказки для существующих экземпляров, чтобы со временем повысить производительность модели
- Поддержка независимых изображений: обрабатывай несколько независимых изображений (не обязательно из одной видеопоследовательности), используя общую память и отслеживая объекты между изображениями
Основные возможности#
- Гибкие подсказки: принимает в качестве подсказок ограничивающие рамки, точки и маски
- Управление банком памяти: поддерживает динамический банк памяти для хранения состояний объектов между кадрами
- Отслеживание нескольких объектов: позволяет одновременно отслеживать несколько объектов, каждому из которых присваивается собственный ID
- Обновления в реальном времени: позволяет добавлять подсказки во время инференса, не обрабатывая предыдущие кадры повторно
- Обработка отдельных изображений: обрабатывай отдельные изображения с общим контекстом памяти, чтобы обеспечивать согласованность объектов между изображениями
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Задать категорию с помощью подсказки в виде рамки
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Найти этот конкретный объект на новом изображении
results = predictor(source="image2.jpg")

# Добавить новую категорию с новым ID объекта
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Новый объект
    obj_ids=[1],  # Новый ID объекта
    update_memory=True,  # Добавить в память
)
# Выполнить инференс
results = predictor(source="image5.jpg")

# Добавить уточняющие промпты в ту же категорию, чтобы повысить точность
# Это помогает, когда внешний вид объекта значительно меняется
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Точка уточнения
    labels=[1],  # Положительная точка
    obj_ids=[1],  # Тот же ID объекта
    update_memory=True,  # Обновить память новыми данными
)
# Выполнить инференс на новом изображении
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor предназначен для работы с моделями SAM 2 и поддерживает добавление категорий и их уточнение с помощью всех промптов с ограничивающей рамкой, точкой и маской, которые SAM 2 поддерживает изначально. Это особенно полезно в сценариях, где объекты появляются или меняются со временем, например при аннотировании видео или интерактивном редактировании.
Аргументы#
| Название | Значение по умолчанию | Тип данных | Описание |
|---|---|---|---|
max_obj_num | 3 | int | Заданное максимальное количество категорий |
update_memory | False | bool | Обновлять ли память новыми промптами |
obj_ids | None | List[int] | Список ID объектов, соответствующих промптам |
Варианты использования#
SAM2DynamicInteractivePredictor идеально подходит для:
- Рабочих процессов аннотирования видео, в которых во время последовательности появляются новые объекты
- Интерактивного редактирования видео, требующего добавления и уточнения объектов в реальном времени
- Систем видеонаблюдения, которым необходимо динамически отслеживать объекты
- Медицинской визуализации для отслеживания анатомических структур во временных рядах
- Автономных систем, которым нужны адаптивное обнаружение и отслеживание объектов
- Наборов данных из нескольких изображений для согласованной сегментации объектов на независимых изображениях
- Анализа коллекций изображений, когда нужно отслеживать объекты в разных сценах
- Междоменной сегментации с использованием памяти из различных визуальных контекстов
- Полуавтоматического аннотирования для эффективного создания наборов данных с минимальным участием человека
Сравнение SAM и YOLO#
Здесь мы сравниваем модели SAM 2 от Meta, включая самую маленькую модель SAM2-t, с моделями сегментации Ultralytics, в том числе с YOLO26:
| Модель | Размер (МБ) | Параметры (M) | Скорость (CPU) (мс/изобр.) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s с бэкбоном YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (в 11.0 раз меньше) | 3.4 (в 11.4 раза меньше) | 24.8 (в 945 раз быстрее) |
| Ultralytics YOLO11n-seg | 6.2 (в 12.6 раза меньше) | 2.9 (в 13.4 раза меньше) | 24.3 (в 964 раза быстрее) |
| Ultralytics YOLO26n-seg | 6.7 (в 11.7 раза меньше) | 2.7 (в 14.4 раза меньше) | 25.2 (в 930 раз быстрее) |
Это сравнение показывает существенные различия в размере и скорости моделей вариантов SAM и моделей сегментации YOLO. Хотя SAM предоставляет уникальные возможности автоматической сегментации, модели YOLO, особенно YOLOv8n-seg, YOLO11n-seg и YOLO26n-seg, значительно компактнее, быстрее и эффективнее используют вычислительные ресурсы.
Скорость SAM измерялась с помощью PyTorch, скорость YOLO — с помощью ONNX Runtime. Тесты проводились на Apple M4 Air 2025 года с 16 ГБ оперативной памяти с использованием torch==2.10.0, ultralytics==8.4.31 и onnxruntime==1.24.4. Чтобы воспроизвести этот тест:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Профилировать SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Профилирование FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Профилировать модели YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # Голова YOLO26 без NMS; ничего не делает для YOLOv8/YOLO11
    model = YOLO(onnx_path)
    model(ASSETS)
Автоматическое аннотирование: эффективное создание наборов данных#
Автоматическая разметка объединяет SAM 2 с предварительно обученной моделью обнаружения, чтобы быстро создавать датасеты сегментации без масштабной ручной разметки. На платформе Ultralytics также доступна автоматическая разметка в браузере с размещёнными моделями компьютерного зрения; сравни их точность обнаружения, стоимость и скорость в таблице лидеров VLM.
Как автоматически аннотировать данные с помощью SAM 2#
Смотри: Автоматическая разметка с моделью Meta Segment Anything 2 с помощью Ultralytics | Разметка данных
Чтобы автоматически разметить датасет с помощью детектора YOLO26x и SAM 2, воспользуйся этим примером:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
data | str | обязательно | Путь к каталогу с изображениями, которые нужно аннотировать или сегментировать. |
det_model | str | 'yolo26x.pt' | Путь к модели обнаружения YOLO для первоначального обнаружения объектов. |
sam_model | str | 'sam_b.pt' | Путь к модели SAM для сегментации (поддерживаются веса SAM, SAM 2, MobileSAM и SAM 3). |
device | str | '' | Вычислительное устройство (например, 'cuda:0', 'cpu' или '' для автоматического определения устройства). |
conf | float | 0.25 | Порог уверенности модели обнаружения YOLO для фильтрации слабых детекций. |
iou | float | 0.5 | Порог IoU для подавления немаксимумов, чтобы отфильтровать перекрывающиеся рамки. |
imgsz | int | 640 | Размер входных изображений (при необходимости округляется вверх до ближайшего числа, кратного 32). |
max_det | int | 300 | Максимальное число детекций на изображение для экономии памяти. |
classes | list[int] | None | Список индексов классов для обнаружения (например, [0, 1] для человека и велосипеда). |
output_dir | str | None | Каталог для сохранения аннотаций (по умолчанию: соседний каталог <data>_auto_annotate_labels). |
Эта функция преобразует папку с неразмеченными изображениями в датасет сегментации с минимальными усилиями по ручной разметке.
Ограничения#
Несмотря на свои преимущества, SAM 2 имеет некоторые ограничения:
- Стабильность отслеживания: SAM 2 может терять объекты из виду при обработке длинных последовательностей или значительном изменении ракурса.
- Путаница между объектами: иногда модель может путать похожие объекты, особенно в переполненных сценах.
- Эффективность при работе с несколькими объектами: эффективность сегментации снижается при одновременной обработке нескольких объектов из-за отсутствия взаимодействия между ними.
- Точность детализации Accuracy: модель может упускать мелкие детали, особенно у быстро движущихся объектов. Дополнительные промпты могут частично решить эту проблему, но плавность во времени не гарантируется.
Цитирование и благодарности#
Если ты используешь SAM 2 в исследованиях или разработке, укажи ссылку на него в следующем формате:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Благодарим Meta AI за то, что компания выпустила эту модель и этот датасет для сообщества ИИ.
Часто задаваемые вопросы#
SAM 2 — преемник модели Meta «Сегментация всего» (SAM), которая позволяет задавать запросы и сегментировать объекты как на изображениях, так и в видео. По сравнению с оригинальной SAM модель SAM 2 получила несколько улучшений, в том числе:
- Единая архитектура модели: объединяет возможности сегментации изображений и видео в одной модели.
- Работа в реальном времени: обрабатывает около 44 кадров в секунду и подходит для приложений, требующих немедленной обратной связи.
- Обобщение в режиме zero-shot: сегментирует объекты, с которыми модель раньше не сталкивалась, что полезно в различных визуальных областях.
- Интерактивное уточнение: позволяет итеративно уточнять результаты сегментации с помощью дополнительных промптов.
- Расширенная обработка визуальных сложностей: справляется с типичными задачами сегментации видео, например с перекрытием объектов и их повторным появлением.
Подробнее об архитектуре и возможностях SAM 2 читай в исследовательской статье о SAM 2.
SAM 2 поддерживает сегментацию видео в реальном времени благодаря интерфейсу с запросами и быстрому выполнению инференса. Вот простой пример:
Сегментация с помощью подсказокИспользуй подсказки, чтобы сегментировать конкретные объекты на изображениях или видео.
from ultralytics import SAM

# Загрузить модель
model = SAM("sam2_b.pt")

# Показать информацию о модели (необязательно)
model.info()

# Сегментация с промптом в виде ограничивающей рамки
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Сегментация с промптом в виде точки
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Подробные инструкции смотри в разделе Как использовать SAM 2.
SAM 2 обучается на датасете SA-V — одном из крупнейших и наиболее разнообразных доступных датасетов для сегментации видео. Датасет SA-V включает:
- Более 51 000 видео: снятых в 47 странах, что позволяет охватить широкий спектр сценариев из реального мира.
- Более 600 000 аннотаций масок: подробные пространственно-временные аннотации масок, называемые «масклетами», охватывают целые объекты и их части.
- Масштаб набора данных: в нем в 4.5 раза больше видео и в 53 раза больше аннотаций, чем в крупнейших предыдущих наборах данных, что обеспечивает беспрецедентное разнообразие и сложность.
Благодаря этому датасету SAM 2 показывает высокие результаты на основных бенчмарках сегментации видео и лучше обобщает данные в режиме zero-shot.
В SAM 2 предусмотрен механизм памяти для обработки временных зависимостей и перекрытий объектов в видео. Механизм памяти состоит из следующих компонентов:
- Кодировщик памяти и банк памяти: сохраняют признаки из предыдущих кадров.
- Модуль внимания к памяти: использует сохраненную информацию, чтобы последовательно отслеживать объекты с течением времени.
- Голова обработки перекрытий: специально обрабатывает ситуации, когда объекты не видны, и прогнозирует вероятность перекрытия объекта.
Этот механизм обеспечивает непрерывность отслеживания, даже когда объекты временно скрываются, покидают сцену или возвращаются в нее. Подробнее смотри в разделе Механизм памяти и обработка перекрытий.
Модели SAM 2, такие как SAM2-t и SAM2-b от Meta, обеспечивают мощную сегментацию в режиме zero-shot, но значительно превосходят модели YOLO по размеру и уступают им в скорости. Например, YOLO26n-seg примерно в 24 раза меньше и более чем в 1145 раз быстрее, чем SAM2-b на CPU. SAM 2 отлично подходит для универсальной сегментации на основе промптов и в режиме zero-shot, а YOLO26 оптимизирована для скорости, эффективности и приложений реального времени. Благодаря сквозному инференсу без NMS YOLO26 лучше подходит для развертывания в условиях ограниченных ресурсов.


Комментарии150
Задай вопрос, поделись результатами или помоги кому-нибудь.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(изменено)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(изменено)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(изменено)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(изменено)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.