SAM 3: сегментация любых объектов по концепциям
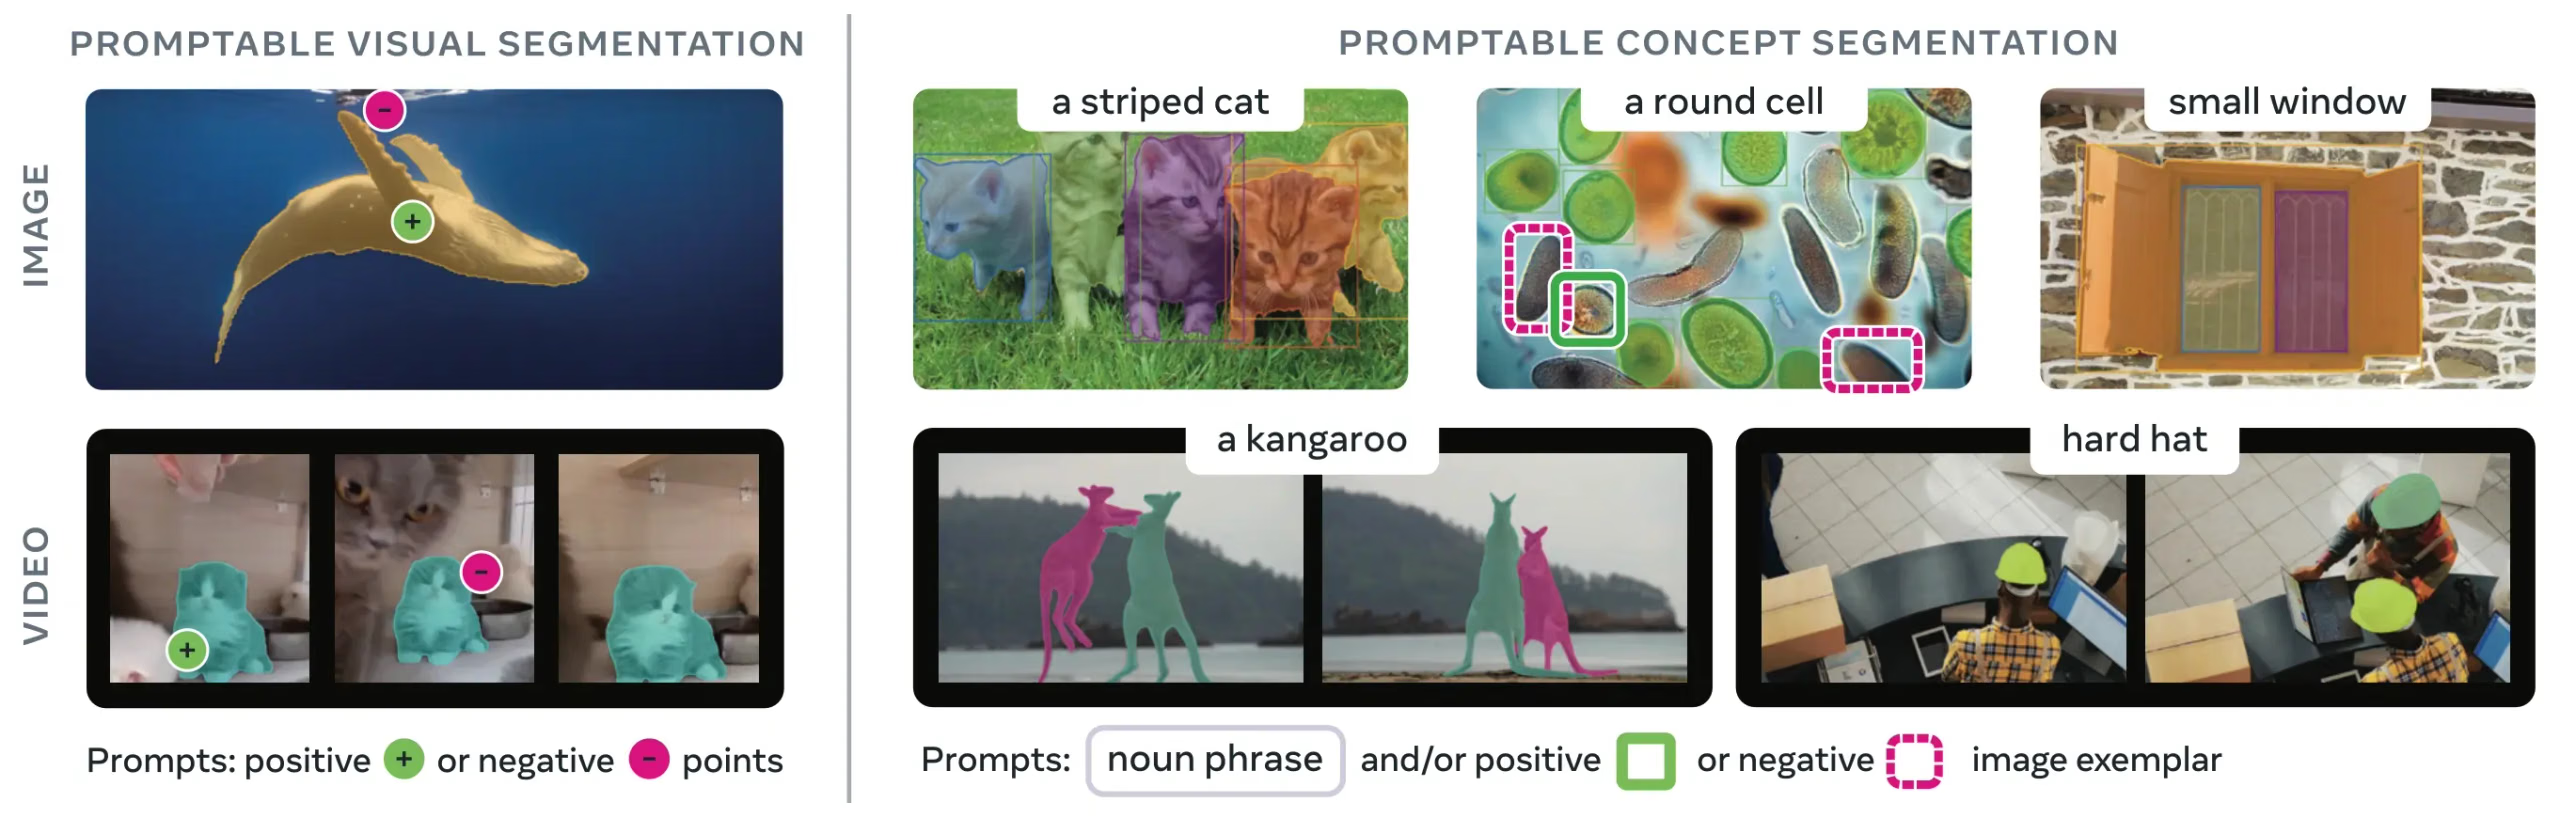
SAM 3 (Segment Anything Model 3) — это базовая модель Meta для сегментации понятий по запросу (PCS). Созданная на основе SAM 2, SAM 3 предлагает новую возможность: обнаруживать, сегментировать и отслеживать все экземпляры визуального понятия, заданного текстовым запросом, примером изображения или и тем и другим. В отличие от предыдущих версий SAM, которые сегментируют один объект на запрос, SAM 3 может находить и сегментировать все вхождения понятия в изображениях и видео, что соответствует задачам сегментации экземпляров с открытым словарём в современных системах сегментации экземпляров.
Смотри: Как использовать Meta Segment Anything 3 с Ultralytics | Сегментация изображений и видео по текстовому запросу
SAM 3 полностью интегрирована в пакет ultralytics, который изначально поддерживает сегментацию концепций по текстовым запросам, запросам с примерами изображений и отслеживание в видео. Для предсказаний на изображениях поддерживается более новая контрольная точка SAM 3.1.
Обзор#
SAM 3 обеспечивает двукратный прирост производительности по сравнению с существующими системами в сегментации понятий по запросу, сохраняя и улучшая возможности SAM 2 для интерактивной визуальной сегментации. Модель особенно хорошо справляется с сегментацией с открытым словарём: пользователь может задать понятие простой именной фразой (например, «жёлтый школьный автобус» или «полосатая кошка») либо предоставить примеры изображений целевого объекта. В Ultralytics SAM 3 работает в режиме predict; для отслеживания предусмотрены отдельные предикторы видео.
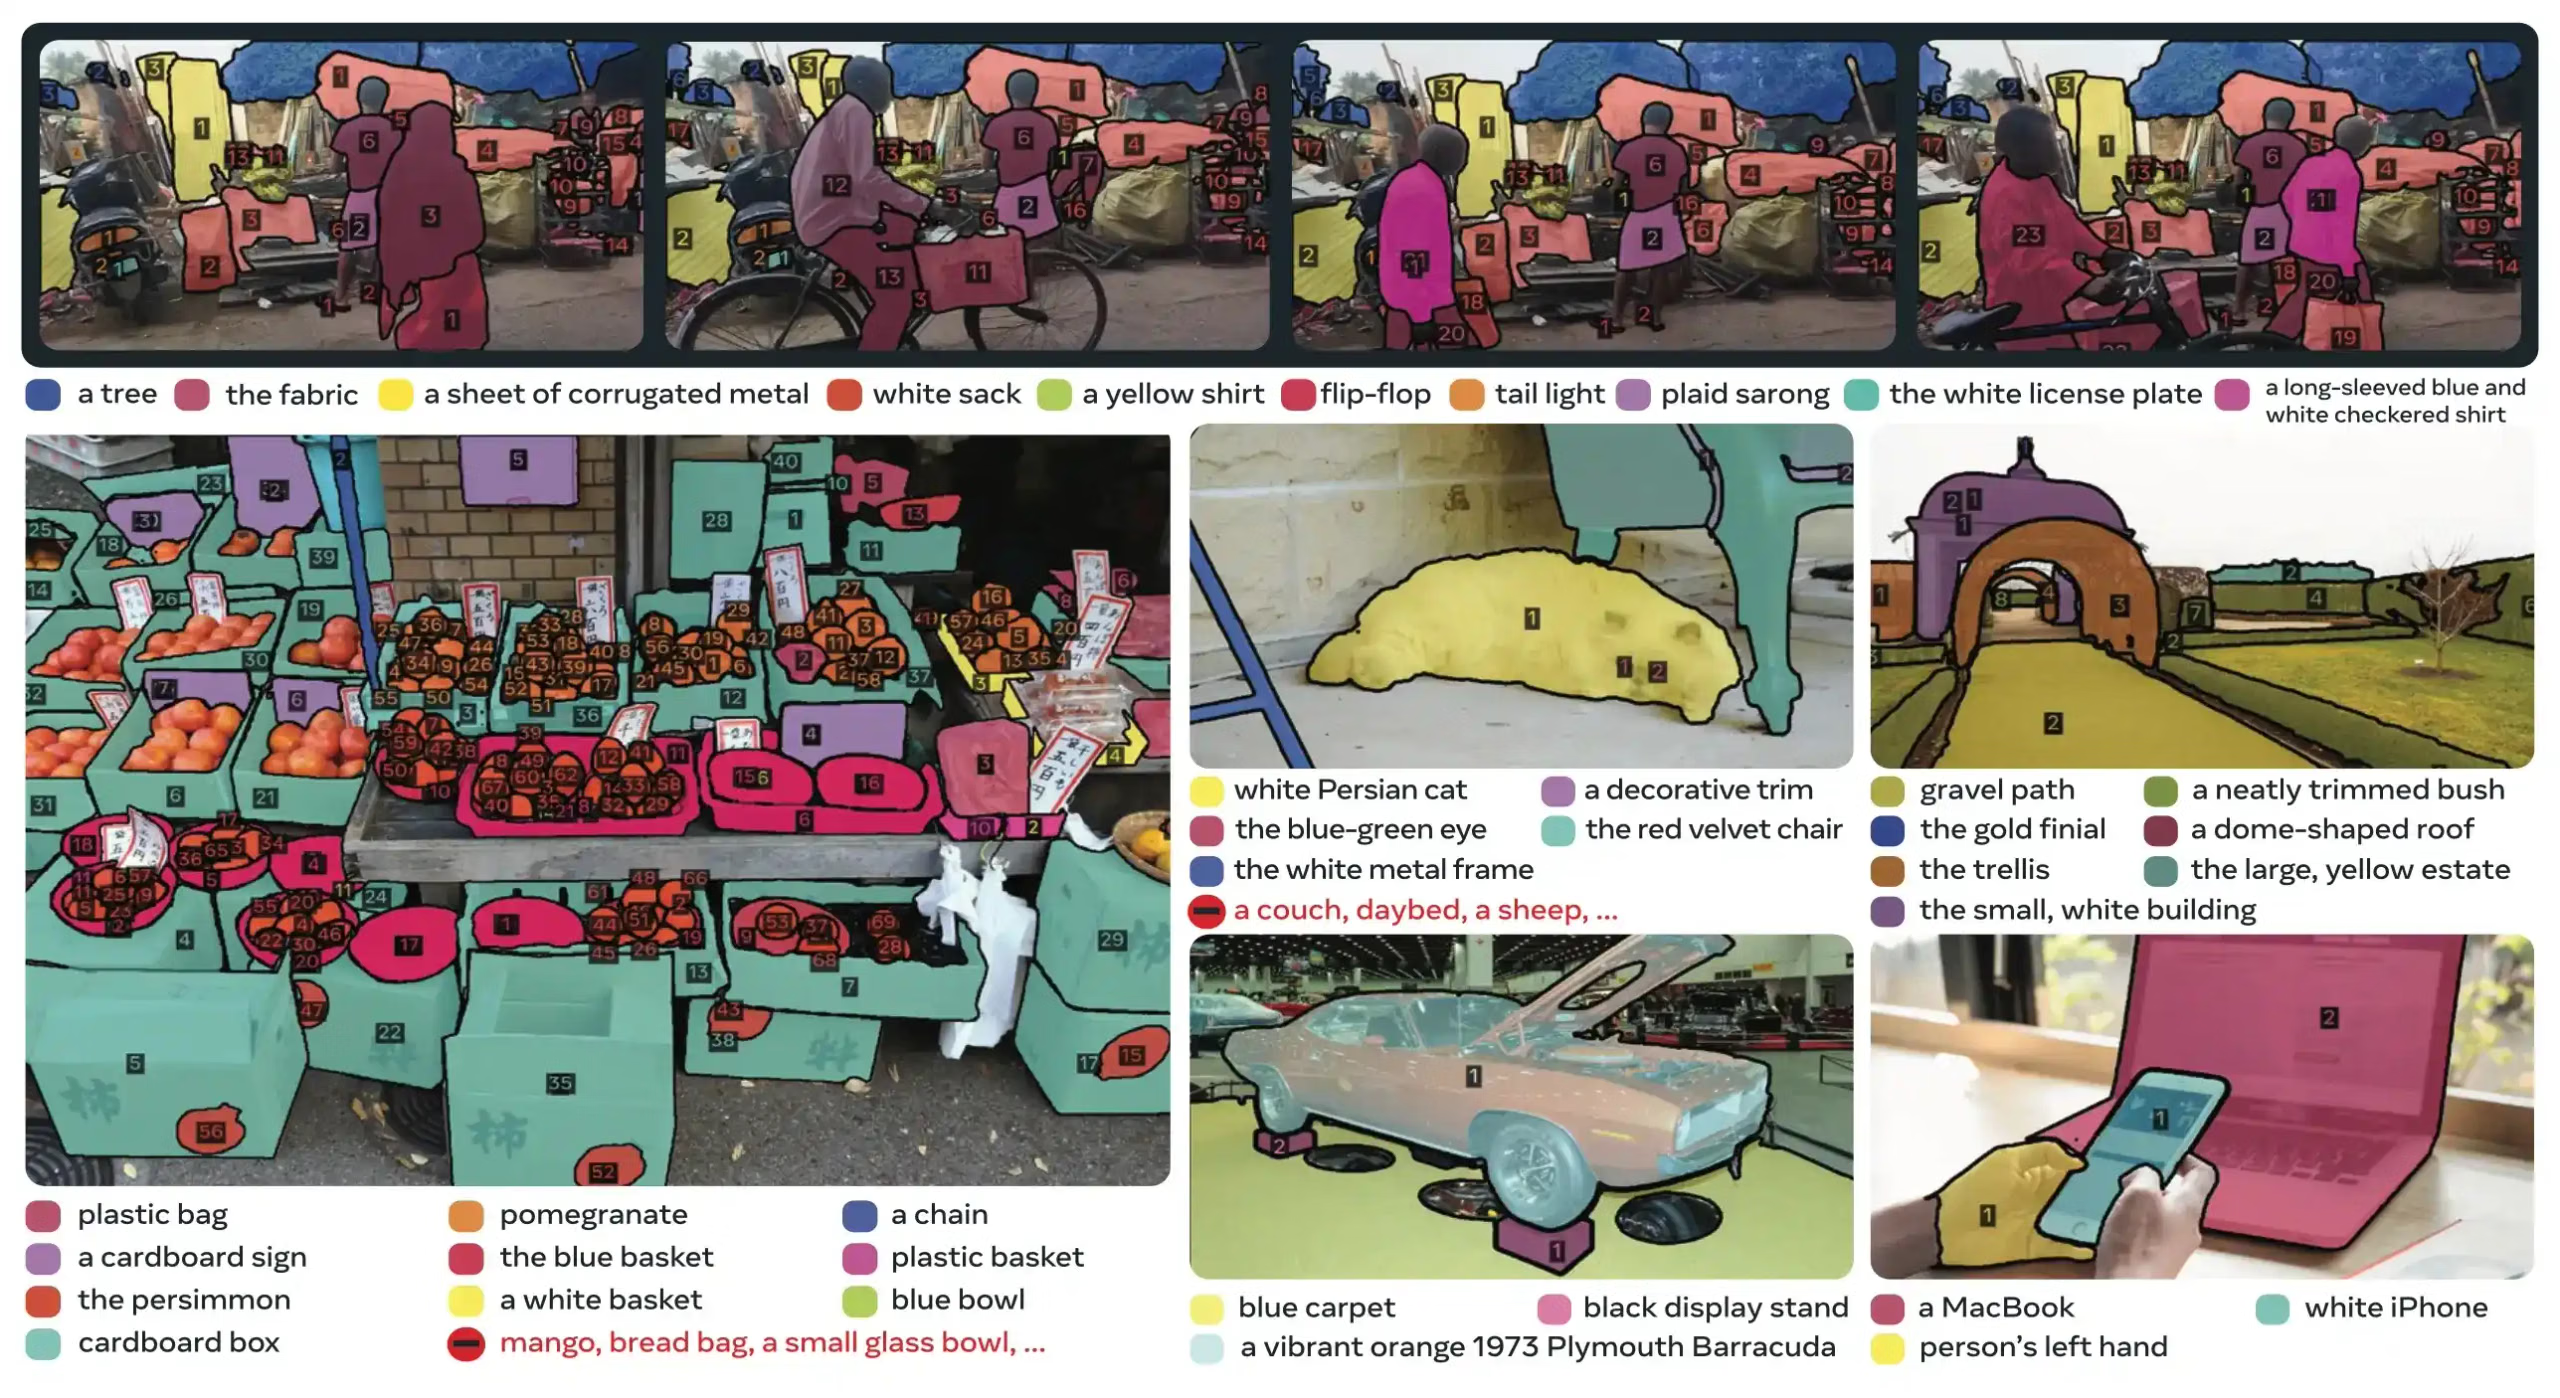
Что такое сегментация концепций по запросам (PCS)?#
На входе задачи PCS — запрос с понятием, а на выходе — маски сегментации с уникальными идентификаторами для всех соответствующих экземпляров объектов. Запросы с понятием могут быть такими:
- Текст: простые именные фразы, например «красное яблоко» или «человек в шляпе», как в обучении с нулевым числом примеров
- Примеры изображений: ограничивающие прямоугольники вокруг примеров объектов (положительных или отрицательных), позволяющие быстро обобщать знания
- Комбинированный запрос: одновременно текст и примеры изображений для точного управления
Это отличается от традиционных визуальных запросов (точек, прямоугольников и масок), которые сегментируют только один конкретный экземпляр объекта, как стало принято благодаря исходному семейству SAM.
Основные показатели производительности#
| Показатель | Результат SAM 3 |
|---|---|
| Mask AP на LVIS без дообучения | 47.0 (против предыдущего лучшего результата 38.5, улучшение на +22%) |
| Бенчмарк SA-Co | В 2 раза лучше существующих систем |
| Скорость инференса (GPU H200) | 30 мс на изображение с более чем 100 обнаруженными объектами |
| Производительность на видео | Почти в реальном времени при отслеживании ~5 объектов одновременно |
| Бенчмарк MOSEv2 VOS | 60.1 J&F (+25.5% по сравнению с SAM 2.1, +17% по сравнению с предыдущим лучшим результатом) |
| Интерактивное уточнение | Улучшение CGF1 на +18.6 после 3 запросов с примерами |
| Отставание от человеческих показателей | Достигает 88% от расчётной нижней границы на SA-Co/Gold |
Контекст о показателях моделей и компромиссах при внедрении см. в материалах об оценке моделей и показателях производительности YOLO.
SAM 3.1#
Выпущенная Meta 27 марта 2026 года SAM 3.1 — новая контрольная точка SAM 3, в которой появилась функция Object Multiplex — подход к отслеживанию нескольких объектов в видео с общей памятью. Вместо независимой обработки каждого отслеживаемого объекта SAM 3.1 группирует объекты в корзины фиксированной ёмкости и обрабатывает их совместно. По данным Meta, это обеспечивает ускорение примерно в 7 раз при обработке 128 объектов на одном GPU H100. Детектор изображений и голова интерактивных запросов с точками сохраняют архитектуру SAM 3.
| Бенчмарк | Показатель | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (тестовая выборка) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (тестовая выборка) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (тестовая выборка) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (валидационная выборка) | J&F | 78.4 | 79.6 |
| DAVIS17 (валидационная выборка) | J&F | 92.2 | 92.7 |
| SA-V (тестовая выборка) | J&F | 84.4 | 85.1 |
| YTVOS19 (валидационная выборка) | G | 89.7 | 89.3 |
| MOSEv2 (валидационная выборка) | J&Ḟ | 60.3 | 62.3 |
Ultralytics загружает контрольную точку SAM 3.1 (sam3.1_multiplex.pt) в предикторы изображений SAM 3: SAM("sam3.1_multiplex.pt") для запросов с точками и прямоугольниками, а также SAM3SemanticPredictor для текстовых запросов и запросов с примерами. Отслеживание видео с помощью Object Multiplex пока не поддерживается, поэтому продолжай использовать sam3.pt вместе с SAM3VideoPredictor и SAM3VideoSemanticPredictor.
Архитектура#
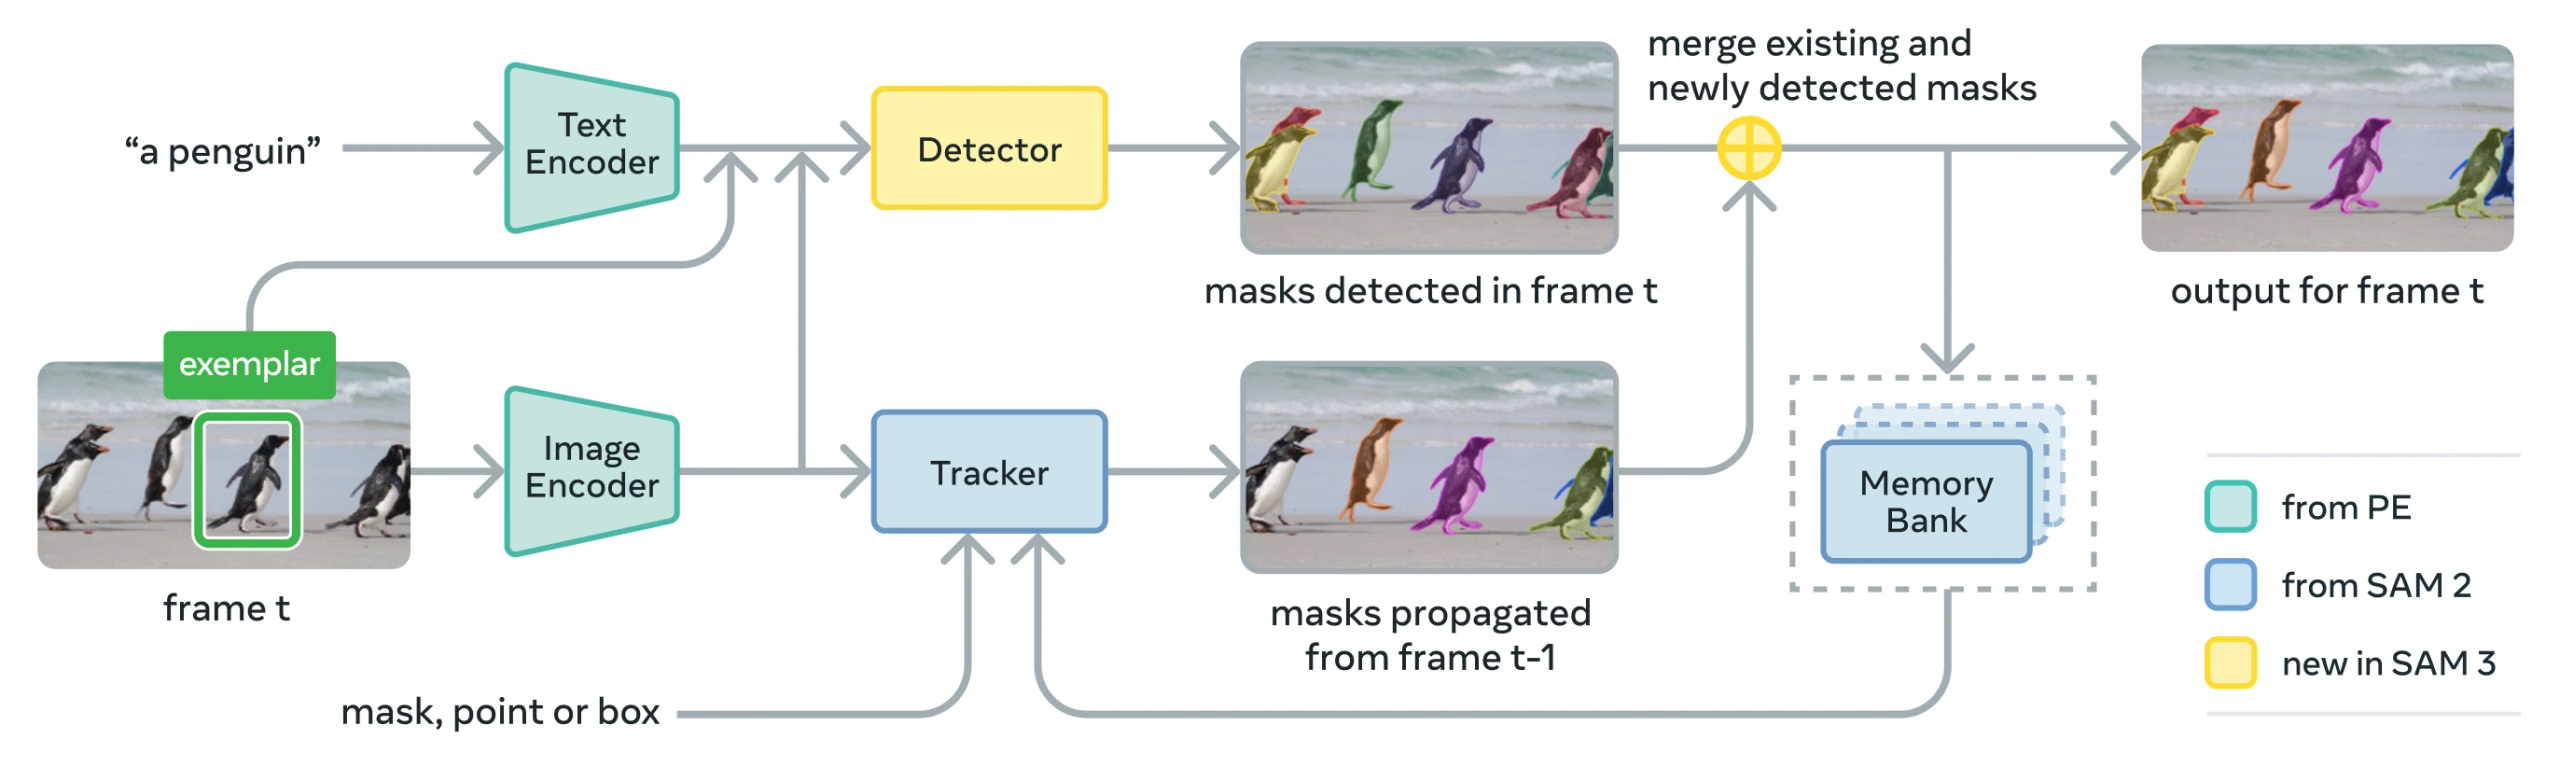
SAM 3 состоит из детектора и трекера, использующих общую зрительную основу Perception Encoder (PE). Такая разделённая конструкция исключает конфликты между задачами и позволяет обнаруживать объекты на изображениях и отслеживать их в видео. Интерфейс совместим с использованием Ultralytics через Python и CLI.
Основные компоненты#
-
Детектор: архитектура на основе DETR для обнаружения концепций на изображениях
- Текстовый кодировщик для запросов в виде именных фраз
- Кодировщик примеров для запросов на основе изображений
- Кодировщик слияния, который настраивает признаки изображения с учётом запросов
- Новая голова присутствия, которая разделяет распознавание («что») и локализацию («где»)
- Голова масок для создания масок сегментации экземпляров
-
Трекер: сегментация видео на основе памяти, унаследованная от SAM 2
- Кодировщик запросов, декодер масок, кодировщик памяти
- Банк памяти для хранения внешнего вида объектов между кадрами
-
Токен присутствия: обучаемый глобальный токен, предсказывающий, присутствует ли целевая концепция на изображении или кадре; он повышает точность обнаружения, отделяя распознавание от локализации.
Ключевые инновации#
- Разделение распознавания и локализации: голова наличия предсказывает присутствие концепта в целом, а запросы предложений отвечают только за локализацию, что позволяет избежать конфликтующих целей.
- Единые концептуальные и визуальные подсказки: одна модель поддерживает PCS (подсказки-концепты) и PVS (визуальные подсказки, например клики и рамки, как в SAM 2).
- Интерактивное уточнение по примерам: пользователи могут добавлять положительные или отрицательные примеры изображений, чтобы постепенно уточнять результаты; модель обобщает их на похожие объекты, а не просто исправляет отдельные экземпляры.
- Временное устранение неоднозначности: для обработки окклюзий, перегруженных сцен и сбоев трекинга в видео используются оценки обнаружения masklet и периодическая повторная подача подсказок — в соответствии с лучшими практиками сегментации экземпляров и трекинга.
Датасет SA-Co#
SAM 3 обучается на датасете Segment Anything with Concepts (SA-Co) — самом крупном и разнообразном датасете сегментации Meta на сегодняшний день, который выходит за рамки распространённых бенчмарков, таких как COCO и LVIS.
Данные для обучения#
| Компонент датасета | Описание | Масштаб |
|---|---|---|
| SA-Co/HQ | Высококачественные изображения с аннотациями, созданными людьми с помощью четырёхэтапного конвейера обработки данных | 5,2 млн изображений, 4 млн уникальных именных фраз |
| SA-Co/SYN | Синтетический датасет с разметкой, созданной ИИ без участия людей | 38 млн именных фраз, 1,4 млрд масок |
| SA-Co/EXT | 15 внешних датасетов, дополненных сложными отрицательными примерами | Зависит от источника |
| SA-Co/VIDEO | Видеоаннотации с временным трекингом | 52,5 тыс. видео, 24,8 тыс. уникальных именных фраз |
Данные бенчмарка#
Оценочный бенчмарк SA-Co содержит 214 тыс. уникальных фраз для 126 тыс. изображений и видео — это более чем в 50 раз больше концептов, чем в существующих бенчмарках. В него входят:
- SA-Co/Gold: 7 предметных областей с тройной разметкой для определения границ производительности человека
- SA-Co/Silver: 10 предметных областей с одиночной разметкой, выполненной человеком
- SA-Co/Bronze и SA-Co/Bio: 9 существующих датасетов, адаптированных для сегментации концептов
- SA-Co/VEval: бенчмарк для видео с 3 предметными областями (SA-V, YT-Temporal-1B, SmartGlasses)
Инновации в конвейере обработки данных#
Масштабируемый конвейер обработки данных SAM 3 с участием людей и модели обеспечивает вдвое большую пропускную способность разметки благодаря следующим решениям:
- ИИ-аннотаторы: модели на основе Llama предлагают различные именные фразы, включая сложные негативные примеры
- ИИ-верификаторы: дообученные мультимодальные большие языковые модели проверяют качество масок и полноту разметки почти на уровне человека
- Активный поиск: направляет усилия людей на сложные случаи сбоев, с которыми ИИ не справляется
- На основе онтологии: использует обширную онтологию, основанную на данных Wikidata, для охвата понятий
Установка#
Установи пакет ultralytics или обнови его до последней версии:
pip install -U ultralyticsВ отличие от других моделей Ultralytics, веса SAM 3 (sam3.pt) не скачиваются автоматически. Сначала запроси доступ к весам модели на странице модели SAM 3 на Hugging Face, а после одобрения скачай с этой страницы sam3.pt. Помести скачанный файл sam3.pt в рабочую директорию или укажи полный путь при загрузке модели.
Доступ к весам SAM 3.1 (sam3.1_multiplex.pt) предоставляется таким же образом на странице модели SAM 3.1. Везде, где в приведённых ниже примерах для изображений используется sam3.pt, укажи sam3.1_multiplex.pt.
Если при предсказании возникает указанная выше ошибка, значит, у тебя установлена неправильная версия пакета clip. Установи правильный пакет clip, выполнив следующую команду:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Как использовать SAM 3: универсальность сегментации концептов#
SAM 3 поддерживает задачи сегментации концептов с подсказками (PCS) и сегментации визуальных объектов с подсказками (PVS) с помощью разных интерфейсов предиктора:
Поддерживаемые задачи и модели#
| Тип задачи | Типы подсказок | Результат |
|---|---|---|
| Сегментация концептов (PCS) | Текст (именные фразы), примеры изображений | Все экземпляры, соответствующие концепту |
| Визуальная сегментация (PVS) | Точки, рамки, маски | Отдельный экземпляр объекта (в стиле SAM 2) |
| Интерактивное уточнение | Постепенно добавляй или удаляй примеры и клики | Уточнённая сегментация с повышенной точностью |
Примеры сегментации концептов#
Сегментация с помощью текстовых подсказок#
Находи и сегментируй все экземпляры концепта по его текстовому описанию. Для текстовых подсказок нужен интерфейс SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Инициализация предиктора с конфигурацией
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Использование FP16 для ускорения инференса
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Однократная настройка изображения для нескольких запросов
predictor.set_image("path/to/image.jpg")

# Запрос с несколькими текстовыми подсказками
results = predictor(text=["person", "bus", "glasses"])

# Поддерживаются описательные фразы
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Запрос с одним концептом
results = predictor(text=["a person"])
Сегментация с помощью примеров изображений#
Используй ограничивающие рамки как визуальные подсказки, чтобы находить все похожие экземпляры. Для сопоставления по концептам также нужен SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Инициализация предиктора
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Настройка изображения
predictor.set_image("path/to/image.jpg")

# Передача примеров с ограничивающими рамками для сегментации похожих объектов
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Несколько ограничивающих рамок в качестве примеров одного визуального концепта
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Инференс на основе признаков для повышения эффективности#
Извлеки признаки изображения один раз и используй их повторно для нескольких запросов сегментации — это повысит эффективность.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Инициализация предикторов
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Извлечение признаков с помощью первого предиктора
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Настройка второго предиктора и повторное использование признаков
predictor2.setup_model()

# Инференс с текстовой подсказкой и общими признаками
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Инференс с подсказкой в виде ограничивающей рамки и общими признаками
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Визуализация результатов
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Сегментация концептов в видео#
Трекинг концептов в видео с помощью ограничивающих рамок#
Обнаруживай экземпляры объектов и отслеживай их между кадрами видео с помощью подсказок в виде ограничивающих рамок.
from ultralytics.models.sam import SAM3VideoPredictor

# Создание предиктора для видео
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Трекинг объектов с помощью подсказок в виде ограничивающих рамок
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Обработка и отображение результатов
for r in results:
    r.show()  # Отображение кадра с масками сегментации
Трекинг концептов с помощью текстовых подсказок#
Отслеживай все экземпляры концептов, заданных текстом, между кадрами видео.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Инициализация семантического предиктора для видео
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Трекинг концептов с помощью текстовых подсказок
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# Обработать результаты
for r in results:
    r.show()  # Отображение кадра с отслеживаемыми объектами

# Альтернатива: трекинг с помощью подсказок в виде ограничивающих рамок
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Положительные метки
    stream=True,
)
Визуальные подсказки (совместимость с SAM 2)#
SAM 3 полностью обратно совместима с визуальными подсказками SAM 2 для сегментации отдельных объектов:
Базовый интерфейс SAM работает точно так же, как SAM 2: он сегментирует только конкретную область, указанную визуальными подсказками (точками, рамками или масками).
from ultralytics import SAM

model = SAM("sam3.pt")

# Подсказка с одной точкой — сегментирует объект в указанном месте
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Подсказка с несколькими точками — сегментирует один объект с несколькими точечными подсказками
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Подсказка с рамкой — сегментирует объект внутри ограничивающей рамки
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()Использование SAM("sam3.pt") с визуальными подсказками (точками/рамками/масками) позволит сегментировать только конкретный объект в указанном месте, как и в SAM 2. Чтобы сегментировать все экземпляры концепции, используй SAM3SemanticPredictor с текстовыми подсказками или подсказками с примерами, как показано выше.
Тесты производительности#
Сегментация изображений#
SAM 3 показывает передовые результаты на нескольких бенчмарках, в том числе на реальных датасетах, таких как LVIS и COCO для сегментации:
| Бенчмарк | Показатель | SAM 3 | Предыдущий лучший результат | Улучшение |
|---|---|---|---|---|
| LVIS (zero-shot) | AP масок | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34,3 (OWLv2) | +89.5% |
| COCO (zero-shot) | AP рамок | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (семантическая сегментация) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (семантическая сегментация) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Изучи доступные наборы данных Ultralytics для быстрых экспериментов: наборы данных Ultralytics.
Производительность сегментации видео#
SAM 3 значительно превосходит SAM 2 и предыдущие лучшие модели на видеобенчмарках, таких как DAVIS 2017 и YouTube-VOS:
| Бенчмарк | Показатель | SAM 3 | SAM 2.1 L | Улучшение |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Адаптация по нескольким примерам#
SAM 3 адаптируется к новым областям по нескольким примерам, что важно для рабочих процессов ИИ, ориентированного на данные:
| Бенчмарк | AP с 0 примерами | AP с 10 примерами | Предыдущий лучший результат (10 примеров) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Эффективность интерактивного уточнения#
Подсказки SAM 3 на основе концепций с примерами сходятся к результату гораздо быстрее, чем визуальные подсказки:
| Добавленные подсказки | Оценка CGF1 | Прирост относительно только текста | Прирост относительно базового уровня PVS |
|---|---|---|---|
| Только текст | 46.4 | базовый уровень | базовый уровень |
| +1 пример | 57.6 | +11.2 | +6.7 |
| +2 примера | 62.2 | +15.8 | +9.7 |
| +3 примера | 65.0 | +18.6 | +11.2 |
| +4 примера | 65.7 | +19.3 | +11.5 (плато) |
Точность подсчёта объектов#
SAM 3 точно считает объекты, сегментируя все их экземпляры; такая возможность часто требуется для подсчёта объектов:
| Бенчмарк | Точность | MAE | относительно лучшей MLLM |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
Сравнение SAM 3, SAM 2 и YOLO#
Здесь мы сравниваем возможности SAM 3 с SAM 2 и моделями YOLO26:
| Возможность | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Сегментация концепций | ✅ Все экземпляры по текстовым подсказкам/примерам | ❌ Не поддерживается | ❌ Не поддерживается |
| Визуальная сегментация | ✅ Один экземпляр (совместим с SAM 2) | ✅ Один экземпляр | ✅ Все экземпляры |
| Возможность работы без примеров | ✅ Открытый словарь | ✅ Геометрические подсказки | ❌ Закрытый набор классов |
| Интерактивное уточнение | ✅ Примеры и щелчки | ✅ Только щелчки | ❌ Не поддерживается |
| Отслеживание видео | ✅ Несколько объектов с идентификаторами | ✅ Несколько объектов | ✅ Несколько объектов |
| AP масок LVIS (zero-shot) | 47.0 | Н/Д | Н/Д |
| MOSEv2 J&F | 60.1 | 47.9 | Н/Д |
| Скорость (GPU, мс/изобр.) | 2921 | 857 | 8.4 |
| Размер модели | 3.45 GB | 162 MB (базовая) | 6.4 MB |
Скорость измерена на NVIDIA RTX PRO 6000 с torch==2.9.1 и ultralytics==8.4.19.
Основные выводы:
- SAM 3: лучше всего подходит для сегментации концепций с открытым словарём и поиска всех экземпляров концепции по текстовым подсказкам или подсказкам с примерами
- SAM 2: лучше всего подходит для интерактивной сегментации одного объекта на изображениях и видео с геометрическими подсказками
- YOLO26: лучше всего подходит для высокоскоростной сегментации в реальном времени с возможностью сквозного инференса без NMS; экспортируется во множество форматов для развёртывания на GPU, CPU и периферийных устройствах
- YOLOE: оптимальный выбор для обнаружения и сегментации в реальном времени с открытым словарём по текстовым или визуальным подсказкам
Сравнение SAM и YOLO#
Сравнение SAM 3, SAM 2, SAM, MobileSAM и FastSAM с моделями сегментации Ultralytics YOLO (YOLOv8, YOLO11, YOLO26) по размеру, количеству параметров и скорости инференса на GPU:
| Модель | Размер (МБ) | Параметры (M) | Скорость (GPU) (мс/изобр.) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s с бэкбоном YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (в 515 раз меньше) | 3.4 (в 139.1 раза меньше) | 17.4 (в 167 раз быстрее) |
| Ultralytics YOLO11n-seg | 5.9 (в 585 раз меньше) | 2.9 (в 163.1 раза меньше) | 12.6 (в 231 раз быстрее) |
| Ultralytics YOLO26n-seg | 6.4 (в 539 раз меньше) | 2.7 (в 175.2 раза меньше) | 8.4 (в 347 раз быстрее) |
Это сравнение показывает существенные различия в размере и скорости моделей вариантов SAM и моделей сегментации YOLO. Хотя SAM предоставляет уникальные возможности автоматической сегментации, модели YOLO, особенно YOLOv8n-seg, YOLO11n-seg и YOLO26n-seg, значительно компактнее, быстрее и эффективнее используют вычислительные ресурсы.
Тесты проведены на NVIDIA RTX PRO 6000 с 96 ГБ VRAM с использованием torch==2.9.1 и ultralytics==8.4.19. Чтобы повторить этот тест:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Профилирование SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Профилирование FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Профилирование моделей YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Голова YOLO26 без NMS; ничего не делает для YOLOv8/YOLO11
Метрики оценки#
В SAM 3 добавлены новые метрики для задачи PCS, дополняющие привычные показатели, такие как F1-мера, точность и полнота.
F1-мера с учетом классификации (CGF1)#
Основная метрика, объединяющая локализацию и классификацию:
CGF1 = 100 × pmF1 × IL_MCC
Где:
- pmF1 (макроусредненная F1-мера для положительных примеров): измеряет качество локализации на положительных примерах
- IL_MCC (коэффициент корреляции Мэттьюса на уровне изображения): измеряет точность бинарной классификации («присутствует ли концепт?»)
Зачем нужны эти метрики?#
Традиционные метрики AP не учитывают калибровку, поэтому модели трудно применять на практике. При оценке только предсказаний с уверенностью выше 0,5 метрики SAM 3 требуют хорошей калибровки и воспроизводят реальные сценарии использования в циклах интерактивного предсказания и отслеживания.
Ключевые абляционные исследования и выводы#
Влияние головы присутствия#
Голова присутствия отделяет распознавание от локализации, что дает существенное улучшение:
| Конфигурация | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Без учета присутствия | 57.6 | 0.77 | 74.7 |
| С учетом присутствия | 63.3 | 0.82 | 77.1 |
Голова присутствия повышает CGF1 на 5.7 (+9.9%), в первую очередь улучшая способность к распознаванию (IL_MCC +6.5%).
Влияние сложных отрицательных примеров#
| Сложных отрицательных примеров на изображение | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Сложные отрицательные примеры крайне важны для распознавания объектов с открытым словарем и повышают IL_MCC на 54.5% (0.44 → 0.68).
Масштабирование обучающих данных#
| Источники данных | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Только внешние | 30.9 | 0.46 | 66.3 |
| Внешние + синтетические | 39.7 | 0.57 | 70.6 |
| Внешние + высококачественные | 51.8 | 0.71 | 73.2 |
| Все три | 54.3 | 0.74 | 73.5 |
Высококачественная разметка, выполненная людьми, дает значительный прирост по сравнению с использованием только синтетических или внешних данных. О практиках обеспечения качества данных читай в разделе сбор и аннотация данных.
Применение#
Возможность SAM 3 сегментировать концепты открывает новые варианты применения:
- Модерация контента: поиск всех вхождений контента определенных типов в медиатеках
- Электронная коммерция: сегментация всех товаров определенного типа на изображениях каталога с поддержкой автоматической аннотации
- Медицинская визуализация: выявление всех случаев конкретных типов тканей или аномалий
- Автономные системы: отслеживание всех дорожных знаков, пешеходов или транспортных средств по категориям
- Видеоаналитика: подсчет и отслеживание всех людей в одежде определенного типа или выполняющих заданные действия
- Аннотирование датасетов: быстрая разметка всех объектов редких категорий
- Научные исследования: количественная оценка и анализ всех образцов, соответствующих заданным критериям
Агент SAM 3: расширенные языковые рассуждения#
SAM 3 можно объединить с мультимодальными большими языковыми моделями (MLLM), чтобы обрабатывать сложные запросы, требующие рассуждений, подобно системам с открытым словарем, таким как OWLv2 и T-Rex.
Результаты на задачах, требующих рассуждений#
| Бенчмарк | Показатель | Агент SAM 3 (Gemini 2.5 Pro) | Предыдущий лучший результат |
|---|---|---|---|
| ReasonSeg (валидация) | gIoU | 76.0 | 65.0 (SoTA) |
| ReasonSeg (тест) | gIoU | 73.8 | 61.3 (SoTA) |
| OmniLabel (валидация) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Примеры сложных запросов#
Агент SAM 3 может обрабатывать запросы, требующие рассуждений:
- «Люди, которые садятся, но не держат в руках подарочную коробку»
- «Собака, которая ближе всего к камере и не носит ошейник»
- «Красные объекты, размером больше руки человека»
MLLM предлагает SAM 3 простые запросы в виде именных фраз, анализирует возвращенные маски и повторяет процесс до получения нужного результата.
Ограничения#
SAM 3 имеет следующие ограничения:
- Сложность фраз: лучше всего подходит для простых именных фраз; для длинных референциальных выражений или сложных рассуждений может потребоваться интеграция с MLLM
- Работа с неоднозначностью: некоторые концепты по своей природе остаются неоднозначными (например, «маленькое окно», «уютная комната»)
- Вычислительные требования: больше и медленнее специализированных моделей обнаружения, таких как YOLO
- Охват словаря: модель ориентирована на атомарные визуальные концепты; без помощи MLLM возможности композиционных рассуждений ограничены
- Редкие концепты: качество работы может снижаться для крайне редких или детализированных концептов, которые недостаточно представлены в обучающих данных
Цитирование#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Часто задаваемые вопросы#
SAM 3 выпущена Meta 19 ноября 2025 года и полностью интегрирована в пакет
ultralytics; для предсказаний на изображениях и отслеживания в видео предусмотрены отдельные предикторы.Да. SAM 3 полностью интегрирована в пакет Ultralytics Python и поддерживает сегментацию понятий, визуальные запросы в стиле SAM 2 и отслеживание нескольких объектов в видео. SAM 3 и SAM 3.1 также лежат в основе функции умной разметки на платформе Ultralytics, где SAM 3.1 используется по умолчанию и ты можешь размечать изображения всего за несколько щелчков. На датасетах для обнаружения с 1–200 классами модели SAM 3 Text и SAM 3.1 Text также автоматически создают разметку на основе названий классов, а таблица лидеров VLM сравнивает точность этих моделей с моделями визуально-языкового анализа.
Да, для предсказания на изображениях. Загружай
sam3.1_multiplex.ptвезде, где в примерах работы с изображениями на этой странице используетсяsam3.pt:SAM("sam3.1_multiplex.pt")для промптов с точками и рамками иSAM3SemanticPredictorдля текстовых промптов и промптов с примерами. Отслеживание видео с Object Multiplex пока не поддерживается, поэтому для предсказания на видео продолжай использоватьsam3.pt. Бенчмарки Meta смотри в разделе SAM 3.1.PCS — новая задача, появившаяся в SAM 3. Она позволяет сегментировать все экземпляры визуального концепта на изображении или видео. В отличие от традиционной сегментации, нацеленной на конкретный экземпляр объекта, PCS находит все вхождения категории. Например:
- Текстовый промпт: «желтый школьный автобус» → сегментирует все желтые школьные автобусы в кадре
- Изображение-пример: обведи одну собаку → модель выделит всех собак на изображении
- Комбинация: «полосатая кошка» + рамка-пример → модель выделит всех полосатых кошек, похожих на пример
Характеристика SAM 2 SAM 3 Задача Один объект на запрос Все экземпляры понятия Типы запросов Точки, рамки, маски + Текстовые фразы, изображения-примеры Возможности детекции Требуется внешний детектор Встроенный детектор с открытым словарём Распознавание Только на основе геометрии Распознавание текста и изображений Архитектура Только трекер Детектор + трекер с головой определения присутствия Эффективность в режиме zero-shot Н/Д (требуются визуальные запросы) 47,0 AP на LVIS, в 2 раза лучше на SA-Co Интерактивное уточнение Только клики Клики + обобщение по изображению-примеру SAM 3 сохраняет обратную совместимость с визуальными запросами SAM 2 и добавляет возможности на основе понятий.
SAM 3 обучают на наборе данных Segment Anything with Concepts (SA-Co):
Данные для обучения:
- 5,2 млн изображений с 4 млн уникальных именных фраз (SA-Co/HQ) — высококачественная разметка, созданная людьми
- 52,5 тыс. видео с 24,8 тыс. уникальных именных фраз (SA-Co/VIDEO)
- 1,4 млрд синтетических масок для 38 млн именных фраз (SA-Co/SYN)
- 15 внешних наборов данных, дополненных сложными отрицательными примерами (SA-Co/EXT)
Данные для бенчмарка:
- 214 тыс. уникальных понятий на 126 тыс. изображений и видео
- В 50 раз больше понятий, чем в существующих бенчмарках (например, в LVIS около ~4 тыс. понятий)
- Тройная разметка SA-Co/Gold позволяет оценить границы производительности человека
Этот масштаб и разнообразие лежат в основе способности SAM 3 к обобщению без примеров для понятий с открытым словарём.
SAM 3 и YOLO26 предназначены для разных задач:
Преимущества SAM 3:
- Открытый словарь: сегментирует любые понятия по текстовым запросам без дополнительного обучения
- Zero-shot: сразу работает с новыми категориями
- Интерактивность: уточнение по примеру распространяется на похожие объекты
- На основе понятий: автоматически находит все экземпляры категории
- Точность: 47,0 AP в задаче zero-shot-сегментации экземпляров на LVIS
Преимущества YOLO26:
- Скорость: инференс на порядки быстрее; при необходимости можно использовать сквозную голову без NMS
- Эффективность: модели в 539 раз меньше (6,4 МБ против 3,45 ГБ)
- Работа на устройствах с ограниченными ресурсами: запускается на периферийных и мобильных устройствах
- Работа в реальном времени: оптимизирована для развертывания в production
Рекомендация:
- Используй SAM 3 для гибкой сегментации с открытым словарём, когда нужно найти все экземпляры понятий, описанных текстом или примерами
- Используй YOLO26 для высокоскоростного развертывания в production, когда категории известны заранее
- Используй SAM 2 для интерактивной сегментации одного объекта с геометрическими запросами
SAM 3 рассчитана на простые именные фразы (например, «красное яблоко», «человек в шляпе»). Для сложных запросов, требующих рассуждений, объедини SAM 3 с MLLM и используй SAM 3 Agent:
Простые запросы (встроенные возможности SAM 3):
- «жёлтый школьный автобус»
- «полосатая кошка»
- «человек в красной шляпе»
Сложные запросы (SAM 3 Agent с MLLM):
- «Люди, которые сидят, но не держат подарочную коробку»
- «Собака, которая ближе всего к камере и без ошейника»
- «Красные объекты, размером больше руки человека»
SAM 3 Agent показывает 76,0 gIoU на валидационной выборке ReasonSeg (против 65,0 у предыдущего лучшего результата; улучшение на 16,9%), объединяя сегментацию SAM 3 со способностями MLLM к рассуждению.
На бенчмарке SA-Co/Gold с тройной разметкой людьми:
- Нижняя граница человеческой производительности: 74,2 CGF1 (самый строгий разметчик)
- Результат SAM 3: 65,0 CGF1
- Достижение: 88% от оценочной нижней границы человеческой производительности
- Верхняя граница человеческой производительности: 81,4 CGF1 (самый либеральный разметчик)
SAM 3 демонстрирует высокие результаты, приближаясь к человеческой точности в сегментации понятий с открытым словарём; разрыв в основном связан с неоднозначными или субъективными понятиями (например, «маленькое окно», «уютная комната»).


Комментарии105
Задай вопрос, поделись результатами или помоги кому-нибудь.
 Glenn JocherUltralytics(изменено)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(изменено)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(изменено)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(изменено)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(изменено)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.