SKU-110K Veri Kümesi
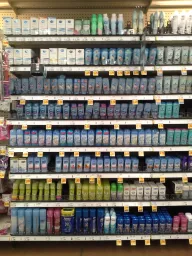
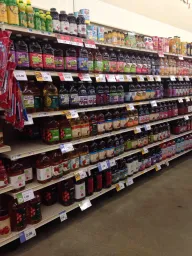
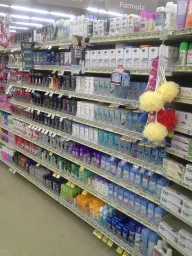
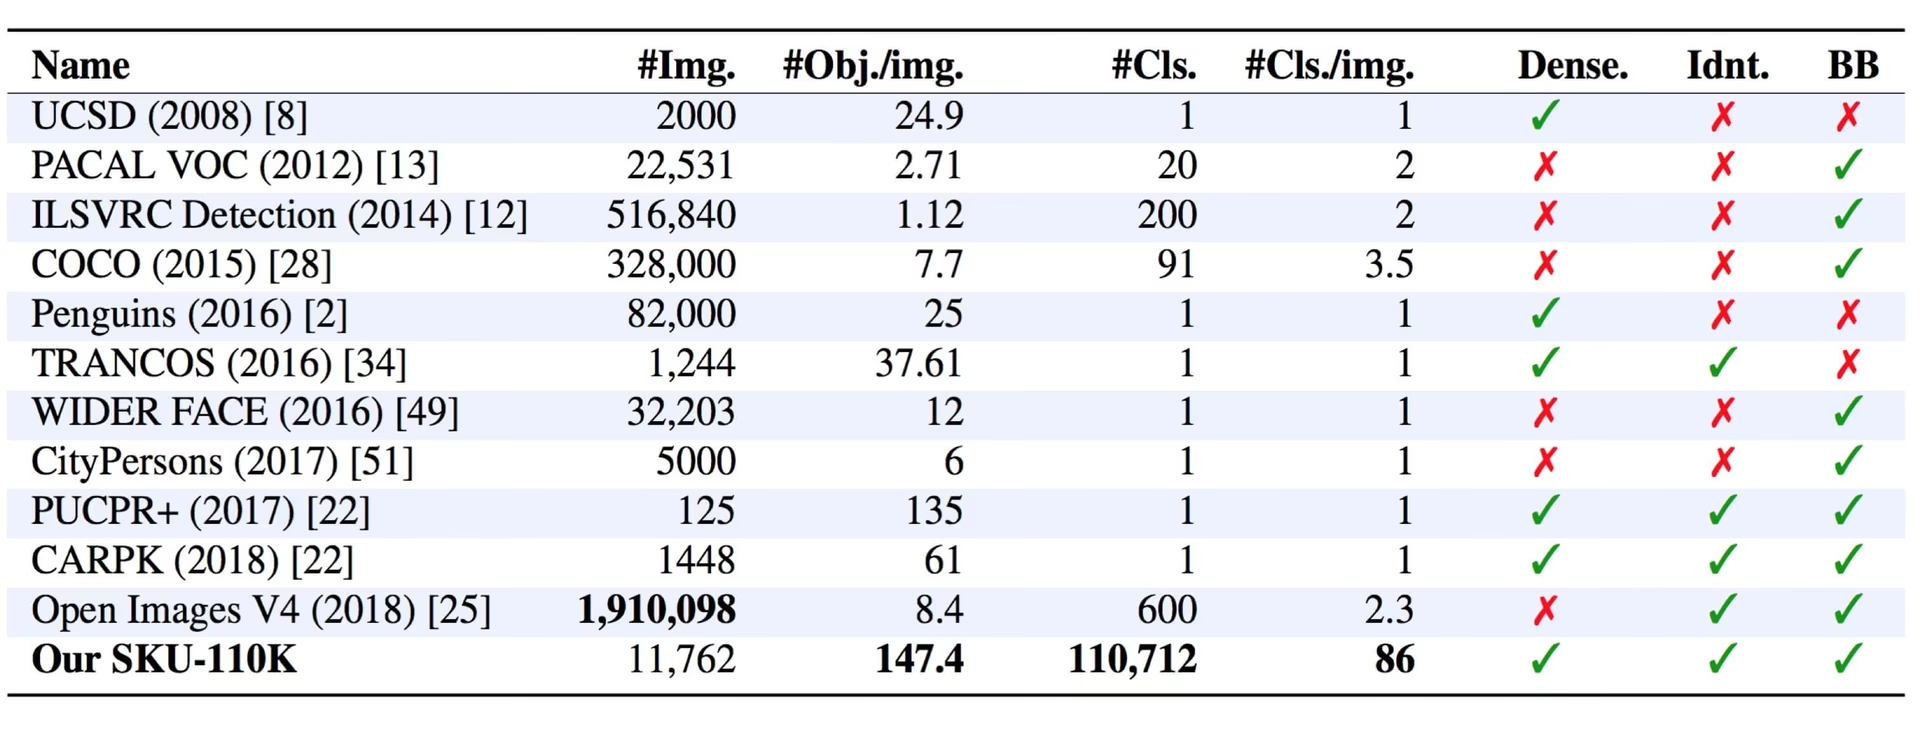
SKU-110K veri kümesi, 8.219 eğitim, 588 doğrulama ve 2.936 test görüntüsüne ayrılmış, 11.743 yoğun biçimde ürünle dolu perakende rafı görüntüsünden oluşan tek sınıflı bir nesne tespiti veri kümesidir. Her ürün, object adlı tek bir sınıf altında bir sınırlayıcı kutuyla etiketlenmiştir — isim, görüntülerdeki 110.000'den fazla benzersiz stok tutma birimini (SKU) ifade eder; 110.000 tespit sınıfını değil. Eran Goldman ve diğerleri tarafından CVPR 2019 Yoğun Biçimde Dolu Sahnelerde Hassas Tespit makalesi için oluşturulan veri kümesinde 1,7 milyondan fazla etiketlenmiş ürün bulunur — görüntü başına ortalama yaklaşık 147 ürün — ve bu da kalabalık perakende ortamlarındaki bilgisayarlı görü modelleri için zorlu bir kıyaslama ölçütü oluşturur.
İzle: Perakende Rafındaki Her Ürünü Algılamak İçin Ultralytics YOLO26 Nasıl Eğitilir | SKU-110K 🛒
Temel Özellikler#
- Tek sınıflı tespit: Her ürün,
object(names: {0: object}) adlı tek bir sınıf altında bir sınırlayıcı kutuyla etiketlenmiştir — açıklamalarda SKU başına kategori etiketleri bulunmaz. - Aşırı nesne yoğunluğu: Dünyanın dört bir yanındaki mağaza rafı görüntülerinde ortalama yaklaşık 147 ürün, birbirine çok yakın ve yoğun biçimde sıralanmıştır; bu nesneler çoğu zaman birbirine benzer, hatta tıpatıp aynıdır.
- Büyük ölçek: 11.743 görüntüdeki 110.000'den fazla benzersiz SKU ve 1,7 milyondan fazla etiketlenmiş sınırlayıcı kutu, son teknoloji nesne dedektörlerini zorlar.
Veri Kümesi Yapısı#
SKU-110K veri kümesi, tümü aynı tek object sınıfını paylaşan üç alt kümeye ayrılmıştır:
| Bölüm | Görüntüler | Açıklama |
|---|---|---|
| Eğit | 8,219 | Model eğitimi için görüntüler ve açıklamalar |
| Doğrulama | 588 | Eğitim sırasında değerlendirme için ayrılmış görüntüler |
| Test | 2,936 | Eğitilmiş modelin son değerlendirmesi için görüntüler |
Uygulamalar#
SKU-110K veri kümesi, özellikle perakende rafı sergileri gibi yoğun biçimde dolu sahnelerde, nesne tespiti görevlerindeki derin öğrenme modellerini eğitmek ve değerlendirmek için yaygın olarak kullanılır. Kullanım alanları şunlardır:
- Perakende stok yönetimi ve otomasyon
- E-ticaret platformlarında ürün tanıma
- Planogram uyumluluğu doğrulaması
- Mağazalardaki self-servis ödeme sistemleri
- Depolarda robotlarla toplama ve sıralama
Kendi raf görüntülerine açıklama eklemek, perakende tespiti veri kümelerini eğitmek ve yönetmek için tüm iş akışını tarayıcında Ultralytics Platform ile çalıştır.
Veri Kümesi YAML Dosyası#
SKU-110K.yaml dosyası, veri kümesi yollarını, sınıf adlarını ve diğer meta verileri içeren veri kümesi yapılandırmasını tanımlar. Dosya, Ultralytics deposunda https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml konumunda tutulur.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelKullanım#
SKU-110K, ilk eğitiminde otomatik olarak indirilir ve 11.743 görüntüsü için yaklaşık 13.6 GB boş disk alanı gerektirir. İndirme betiği ayrıca orijinal açıklamaları getirip YOLO biçimine dönüştürür; bu işlem birkaç dakika sürebilir.
SKU-110K veri kümesinde 640 görüntü boyutuyla 100 epoch boyunca bir YOLO26n modelini eğitmek için aşağıdaki kod parçacıklarını kullanabilirsin.
from ultralytics import YOLO

# Bir model yükle
model = YOLO("yolo26n.pt")  # Önceden eğitilmiş bir model yükle (eğitim için önerilir)

# Modeli eğit
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Örnek Veriler ve Açıklamalar#
SKU-110K görüntüleri, yan yana duran ve birbirine çok benzeyen onlarca ürünün bulunduğu gerçek mağaza raflarını gösterir. Açıklamalarıyla birlikte bir örnek görüntü şöyle:
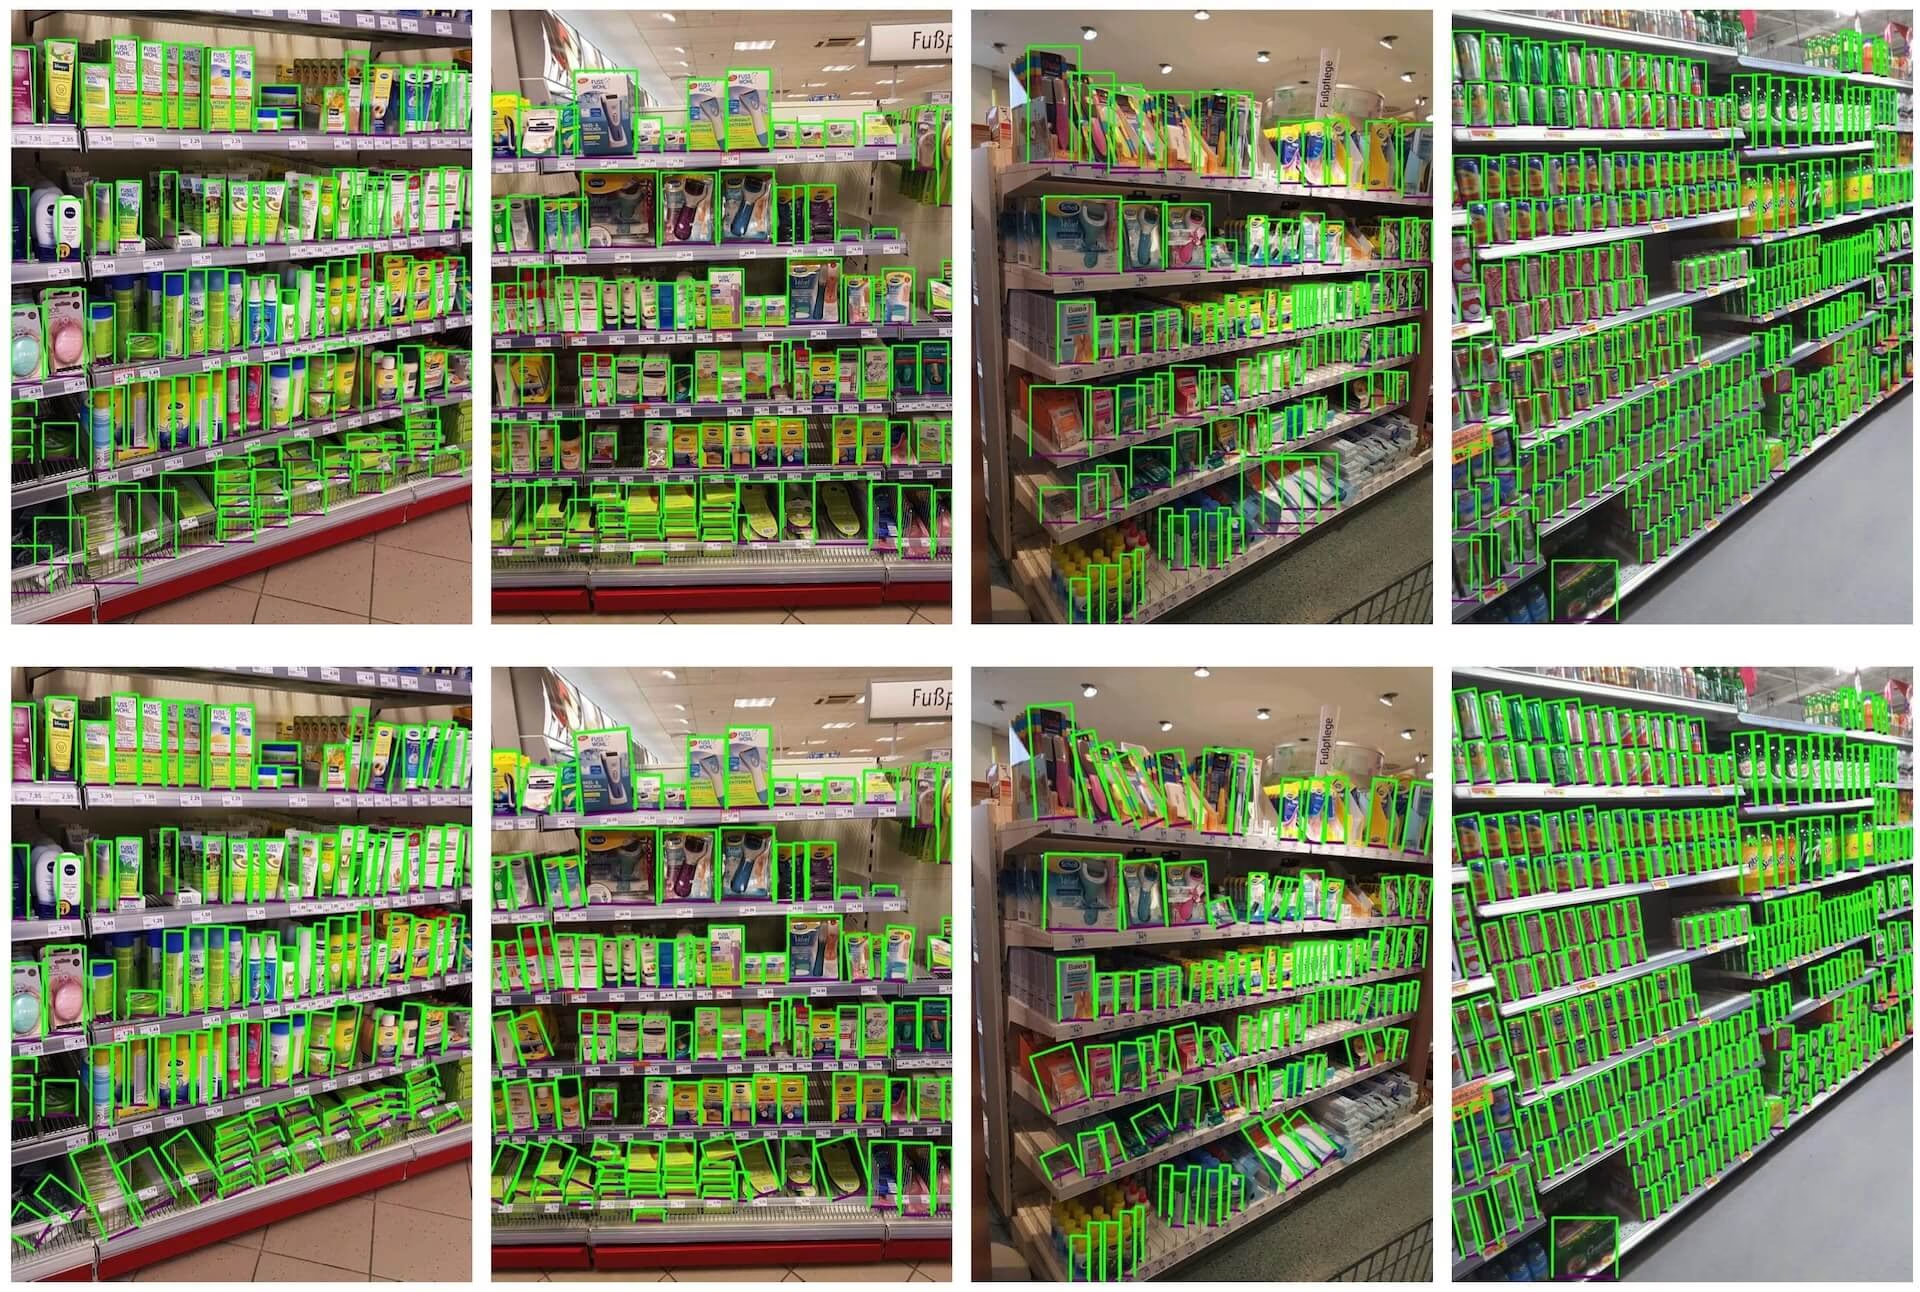
- Yoğun ürünlerle dolu perakende rafı görüntüsü: Bu görüntü, perakende rafı ortamındaki yoğun nesnelere bir örnek gösterir. Nesneler, tek
objectsınıfı altında sınırlayıcı kutularla etiketlenmiştir.
Ürünlerin yoğun biçimde dizilmesi, SKU-110K'yi sağlam perakende odaklı bilgisayarlı görü çözümleri geliştirmek için özellikle değerli kılar; görüntü başına yüksek nesne sayısı, dedektörleri tipik kıyaslama ölçütlerinin çok ötesinde zorlar.
Atıflar ve Teşekkürler#
SKU-110K veri kümesini araştırma veya geliştirme çalışmalarında kullanıyorsan lütfen aşağıdaki makaleyi kaynak göster:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Bilgisayarlı görü araştırma topluluğu için değerli bir kaynak olan SKU-110K veri kümesini oluşturup sürdürdükleri için Eran Goldman ve diğerlerine teşekkür ederiz. SKU-110K veri kümesi ve oluşturucuları hakkında daha fazla bilgi için SKU-110K veri kümesinin GitHub deposunu ziyaret et.
Sık Sorulan Sorular#
SKU-110K veri kümesi, Eran Goldman ve çalışma arkadaşlarının CVPR 2019 makalesi için oluşturduğu, yoğun biçimde istiflenmiş perakende raflarının 11.743 görüntüsünden oluşan tek sınıflı bir nesne algılama veri kümesidir. Her ürün, bir
objectsınırlayıcı kutusuyla etiketlenmiştir. Görüntüler 110.000'den fazla benzersiz stok tutma birimini (SKU) kapsar; bu da veri kümesini kalabalık sahnelerdeki nesneleri algılamak ve perakende için bilgisayarlı görü sistemleri oluşturmak açısından güçlü bir kıyaslama aracı yapar.Hayır. SKU-110K tek sınıflıdır: Her ürün,
object(names: {0: object}) sınıfı altında bir sınırlayıcı kutuyla etiketlenmiştir. İsimdeki "110K", görüntülerde yer alan benzersiz stok tutma birimlerinin (SKU) sayısını ifade eder; tespit sınıflarının sayısını değil.SKU-110K veri kümesi 11.743 görüntü içerir: 8.219 eğitim, 588 doğrulama ve 2.936 test görüntüsü; ayrıca tek bir tespit sınıfı olan
objectvardır. Ayrıntılar için Veri Kümesi Yapısı bölümüne veSKU-110K.yamlyapılandırmasına bak.SKU-110K yaklaşık 13.6 GB boyutundadır ve
data="SKU-110K.yaml"ile ilk eğitiminde otomatik olarak indirilir; elle indirmen gerekmez. Daha küçük seçeneklere göz atmak için tespit veri kümeleri genel bakışına bak.SKU-110K veri kümesinde YOLO26 modelini eğitmek oldukça kolaydır. 640 görüntü boyutuyla YOLO26n modelini 100 epoch boyunca eğitmek için bir örnek:
Eğitim Örneğifrom ultralytics import YOLO # Bir model yükle model = YOLO("yolo26n.pt") # Önceden eğitilmiş bir model yükle (eğitim için önerilir) # Modeli eğit results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Yorumlar6
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.