Bilgisayarlı Görü için Veri Toplama ve Etiketleme Stratejileri
Veri toplama ve açıklama ekleme, her bilgisayarlı görü projesinin temelindeki iki adımdır: temsil edici görüntüler veya videolar toplar, ardından modelin bunlardan öğrenebilmesi için etiketlersin. Bu verilerin kalitesi model performansını doğrudan belirler; bu nedenle eğitim başlamadan önce sınıf tanımları, tarafsız kaynak seçimi ve tutarlı açıklama ekleme önemlidir.
İzle: Bilgisayarlı Görü İçin Etkili Veri Toplama ve Etiketleme Stratejileri Nasıl Oluşturulur 🚀
Bu kılavuzda sınıfları ayarlama ve veri toplama, veri etiketlemenin ne olduğu, seçebileceğin etiket türleri ve biçimleri ile verimli etiketleme stratejileri ele alınır — her karar projenin hedefleriyle uyumludur.
Sınıfları Ayarlama ve Veri Toplama#
Bir bilgisayarlı görü projesi için görüntü ve video toplarken üç karar vermen gerekir: kaç sınıf tanımlayacağın, verileri nereden alacağın ve veri kümesini yanlılıktan nasıl uzak tutacağın.
Projen için Doğru Sınıfları Seçme#
Bir bilgisayarlı görü projesine başlarken sorulacak ilk sorulardan biri, kaç sınıfın dâhil edileceğidir. Modelinin tanımasını ve birbirinden ayırmasını istediğin farklı kategorileri veya etiketleri içeren sınıf kapsamını belirlemen gerekir. Sınıf sayısını projenin özel hedeflerine göre belirlemelisin.
Örneğin trafiği izlemek istiyorsan sınıfların "otomobil", "kamyon", "otobüs", "motosiklet" ve "bisiklet" olabilir. Öte yandan, mağazadaki ürünleri takip etmek için sınıfların "meyveler", "sebzeler", "içecekler" ve "atıştırmalıklar" olabilir. Sınıfları proje hedeflerine göre tanımlamak, veri kümeni konuyla ilgili ve odaklı tutmana yardımcı olur.
Sınıflarını tanımlarken, kaba ya da ince ayrıntılı sınıf sayısı seçmek de önemli bir ayrımdır. 'Sayı', ilgilendiğin farklı sınıfların sayısını ifade eder. Bu karar, verilerinin ayrıntı düzeyini ve modelinin karmaşıklığını etkiler. Her yaklaşımda göz önünde bulundurman gerekenler şunlardır:
- Kaba Sınıf Sayısı: "araç" ve "araç olmayan" gibi daha geniş ve kapsayıcı kategorilerdir. Etiketlemeyi basitleştirir ve daha az hesaplama kaynağı gerektirir ancak daha az ayrıntı sunar; bu da karmaşık senaryolarda modelin etkinliğini sınırlayabilir.
- İnce Ayrıntılı Sınıf Sayısı: "sedan", "SUV", "kamyonet" ve "motosiklet" gibi daha fazla ve daha ayrıntılı ayrımlara sahip kategorilerdir. Daha ayrıntılı bilgi sunarak model doğruluğunu ve performansını artırırlar. Ancak etiketlenmeleri daha fazla zaman ve emek gerektirir, ayrıca daha fazla hesaplama kaynağı kullanırlar.
Daha belirgin sınıflarla başlamak, özellikle ayrıntıların önemli olduğu karmaşık projelerde çok faydalı olabilir. Daha belirgin sınıflar, daha ayrıntılı veriler toplamanı, daha derinlemesine içgörüler edinmeni ve kategoriler arasında daha net ayrımlar oluşturmanı sağlar. Bu yaklaşım yalnızca modelin doğruluğunu artırmakla kalmaz, aynı zamanda gerektiğinde modeli daha sonra uyarlamayı kolaylaştırarak zamandan ve kaynaklardan tasarruf etmeni sağlar.
Veri Kaynakları#
Herkese açık veri kümelerini kullanabilir veya kendi özel verilerini toplayabilirsin. Kaggle ve Google Dataset Search Engine gibi kaynaklardaki herkese açık veri kümeleri, iyi etiketlenmiş ve standartlaştırılmış veriler sunarak modelleri eğitmek ve doğrulamak için harika bir başlangıç noktası sağlar.
Öte yandan özel veri toplama, veri kümeni belirli ihtiyaçlarına göre uyarlamana olanak tanır. Kameralar veya dronlarla görüntü ve videolar çekebilir, web'den görüntüler toplayabilir ya da kuruluşunun mevcut dâhilî verilerini kullanabilirsin. Özel veriler, kalite ve uygunluk üzerinde daha fazla kontrol sağlar. Herkese açık ve özel veri kaynaklarını bir arada kullanmak, çeşitli ve kapsamlı bir veri kümesi oluşturmana yardımcı olur.
Veri Toplamada Yanlılıktan Kaçınma#
Bazı gruplar veya senaryolar veri kümesinde yeterince temsil edilmediğinde ya da gereğinden fazla temsil edildiğinde yanlılık oluşur. Bu durum, bazı verilerde iyi performans gösterirken diğerlerinde kötü sonuç veren bir modele yol açar. Bilgisayarlı görü modelinin çeşitli senaryolarda iyi performans gösterebilmesi için yapay zekâdaki yanlılıktan kaçınmak çok önemlidir.
Veri toplarken yanlılıktan şu şekilde kaçınabilirsin:
- Çeşitli Kaynaklar: Farklı bakış açılarını ve senaryoları yansıtmak için verileri pek çok kaynaktan topla.
- Dengeli Temsil: İlgili tüm grupların dengeli biçimde temsil edilmesini sağla. Örneğin farklı yaşları, cinsiyetleri ve etnik kökenleri göz önünde bulundur.
- Sürekli İzleme: Ortaya çıkan yanlılıkları belirlemek ve gidermek için veri kümeni düzenli olarak gözden geçirip güncelle.
- Yanlılığı Azaltma Teknikleri: Yeterince temsil edilmeyen sınıfları aşırı örnekleme, veri artırma ve adalet odaklı algoritmalar gibi yöntemleri kullan.
Bu uygulamaları izlemek, gerçek dünya uygulamalarında iyi genelleme yapabilen, daha sağlam ve adil bir model oluşturmana yardımcı olur.
Veri Etiketleme Nedir?#
Veri etiketleme, makine öğrenimi modellerini eğitmek için kullanılabilir hâle getirmek amacıyla verilere etiket atama işlemidir. Bilgisayarlı görüde bu, modelin öğrenmesi için gereken bilgileri görüntü veya videoları etiketleyerek eklemek anlamına gelir. Düzgün etiketlenmiş veriler olmadan modeller, girdiler ve çıktılar arasındaki ilişkileri doğru biçimde öğrenemez.
Veri Etiketleme Türleri#
Bir bilgisayarlı görü görevinin özel gereksinimlerine bağlı olarak farklı veri etiketleme türleri vardır. İşte bazı örnekler:
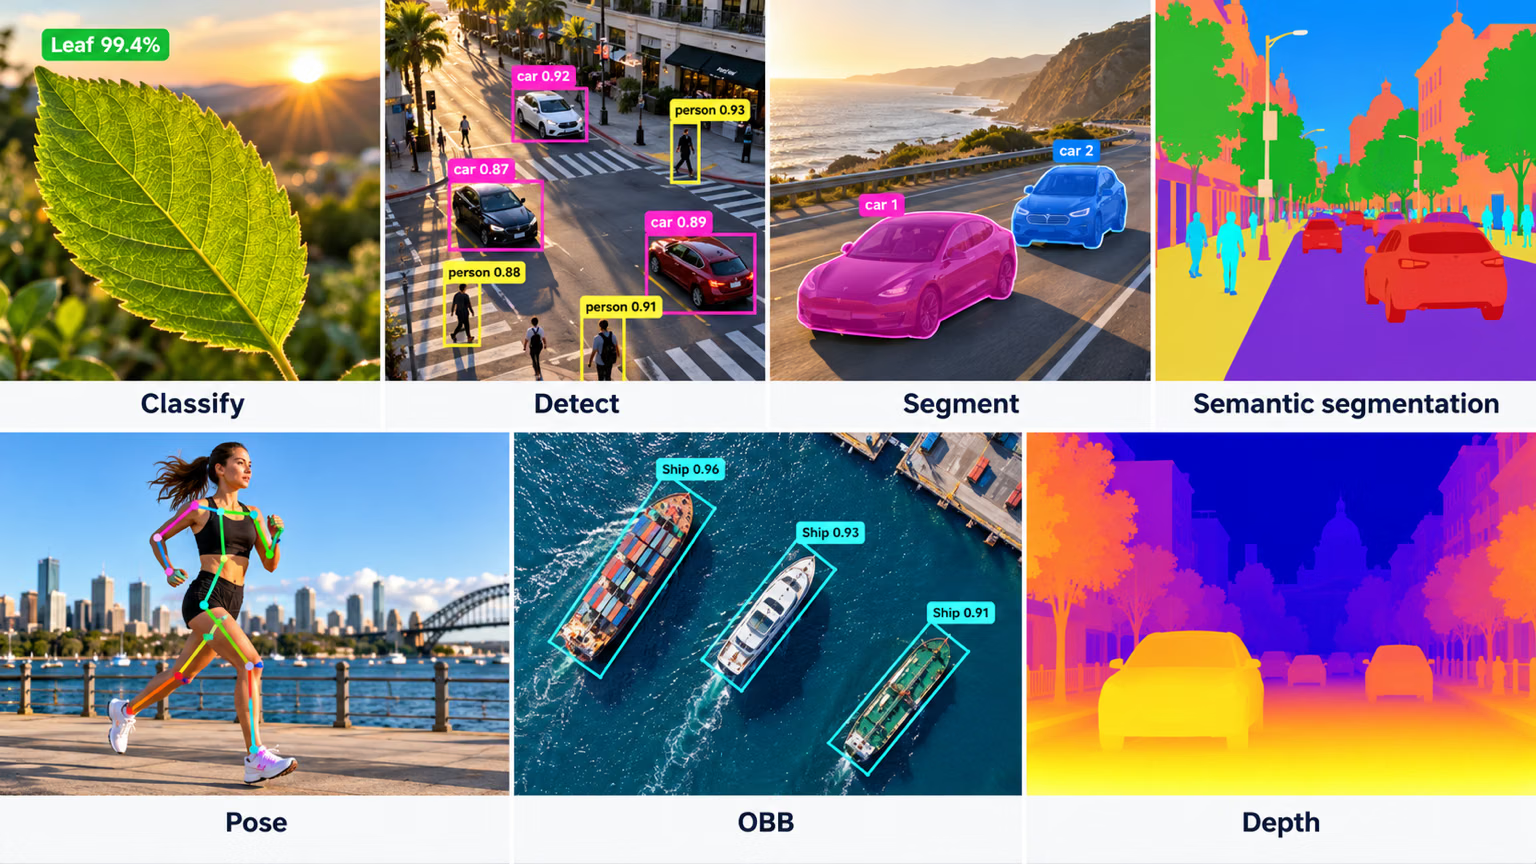
- Sınırlayıcı Kutular: Görüntüdeki nesnelerin çevresine çizilen ve öncelikle nesne algılama görevlerinde kullanılan dikdörtgen kutular. Bu kutular sol üst ve sağ alt koordinatlarla tanımlanır.
- Çokgenler: Nesneler için sınırlayıcı kutulardan daha hassas etiketlemeye olanak tanıyan ayrıntılı dış hatlar. Çokgenler, nesnenin şeklinin önemli olduğu örnek segmentasyonu gibi görevlerde kullanılır.
- Maskeler: Her pikselin bir nesnenin parçası ya da arka plan olduğu ikili maskeler. Maskeler, piksel düzeyinde ayrıntı sağlamak için semantik segmentasyon görevlerinde kullanılır.
- Anahtar Noktalar: İlgi duyulan konumları belirlemek için görüntü içinde işaretlenen belirli noktalar. Anahtar noktalar, poz tahmini ve yüz işaret noktalarını algılama gibi görevlerde kullanılır.
- Yönlendirilmiş Sınırlayıcı Kutular: Dönüş açısı içeren dikdörtgenler; hava görüntüleri gibi nesnelerin rastgele yönlerde göründüğü OBB görevlerinde kullanılır.
Yaygın Etiketleme Biçimleri#
Bir etiketleme türü seçtikten sonra etiketleri depolamak ve paylaşmak için uygun biçimi belirlemek önemlidir. En yaygın biçimler şunlardır:
| Biçim | Dosya yapısı | Yaygın kullanım alanı |
|---|---|---|
| COCO | Tek JSON dosyası | Nesne algılama, örnek segmentasyonu, anahtar nokta algılama, sınıf dışı nesne ve panoptik segmentasyon, görüntü açıklaması |
| Pascal VOC | Her görüntü için bir XML dosyası | Nesne algılama |
| YOLO | Her görüntü için bir .txt dosyası | Nesne algılama, segmentasyon, poz ve yönlendirilmiş kutular |
YOLO biçimi, sınıf dizinlerinin 0'dan başladığı, nesne başına bir satır depolar. Nesne algılama için satır, normalize edilmiş 0–1 koordinatlarına sahip class x_center y_center width height biçimindedir. Segmentasyon satırında kutunun yerini nesnenin normalize edilmiş çokgen noktaları alırken, poz satırında kutu korunur ve sonuna anahtar nokta koordinatları eklenir; veri kümesi kpt_shape: [n, 3] tanımladığında her anahtar nokta için bir görünürlük bayrağı da bulunur. OBB satırı, normalize edilmiş köşe koordinatlarını kullanarak class x1 y1 x2 y2 x3 y3 x4 y4 değerini depolar.
Etiketleme aracın COCO JSON biçiminde dışa aktarıyorsa, bunu YOLO .txt etiketlerine dönüştürebilirsin veya özel bir veri kümesi sınıfıyla doğrudan JSON üzerinde eğitim yapabilirsin.
Etiketleme İlkelerini Belirleme#
Etiket türünü ve biçimini seçtikten sonraki adım, açık ve nesnel etiketleme kuralları oluşturmaktır. Bu kurallar, etiketleme sürecinde tutarlılık ve doğruluk sağlamak için bir yol haritası işlevi görür. Bu kuralların temel unsurları şunlardır:
- Açıklık ve Ayrıntı: Talimatlarının açık olduğundan emin ol. Beklentileri göstermek için örnekler ve çizimler kullan.
- Tutarlılık: Etiketlerini standartlaştır. Farklı veri türlerini etiketlemek için standart ölçütler belirle; böylece tüm etiketler aynı kurallara uysun.
- Yanlılığı Azaltma: Tarafsız ol. Adil etiketler sağlamak için nesnel davranma becerini geliştir ve kişisel yanlılıkları en aza indir.
- Verimlilik: Tekrarlayan görevleri otomatikleştiren araçlar ve iş akışları kullanarak etiketleme sürecini daha hızlı ve verimli hâle getir.
Etiketleme kurallarını düzenli olarak gözden geçirip güncellemek, etiketlerinin doğru, tutarlı ve proje hedeflerinle uyumlu kalmasına yardımcı olur.
Etiketleme Araçları#
İyi bir etiketleme aracı, görevinin ihtiyaç duyduğu her türü etiketlemene olanak tanır, tutarlı yönergeler uygular ve etiketleri eğitime hazır bir biçimde dışa aktarır. Ultralytics Platform, algılama, örnek segmentasyonu, semantik segmentasyon, sınıflandırma, poz ve OBB'yi kapsayan yerleşik bir etiketleme düzenleyicisi sunar; ayrıca tek tıklamayla algılama, örnek segmentasyonu, semantik segmentasyon ve OBB görevleri için maske oluşturan SAM destekli akıllı etiketleme özelliği de içerir. Etiketler her görevin beklediği düzende kaydedildiği için — uzamsal görevler için YOLO .txt satırları, sınıflandırma için sınıf klasörleri — etiketlenmiş veri kümen herhangi bir dönüştürme adımı olmadan doğrudan eğitime aktarılır.
Etiket Kalitesi: Doğruluk, Kesinlik ve Aykırı Değerler#
Büyük ölçekte etiketlemeye başlamadan önce doğruluk, kesinlik, aykırı değerler ve kalite kontrolü hakkında bilgi edinmek, verilerini verimsiz bir şekilde etiketlememeni sağlar.
Doğruluk ve Kesinliği Anlama#
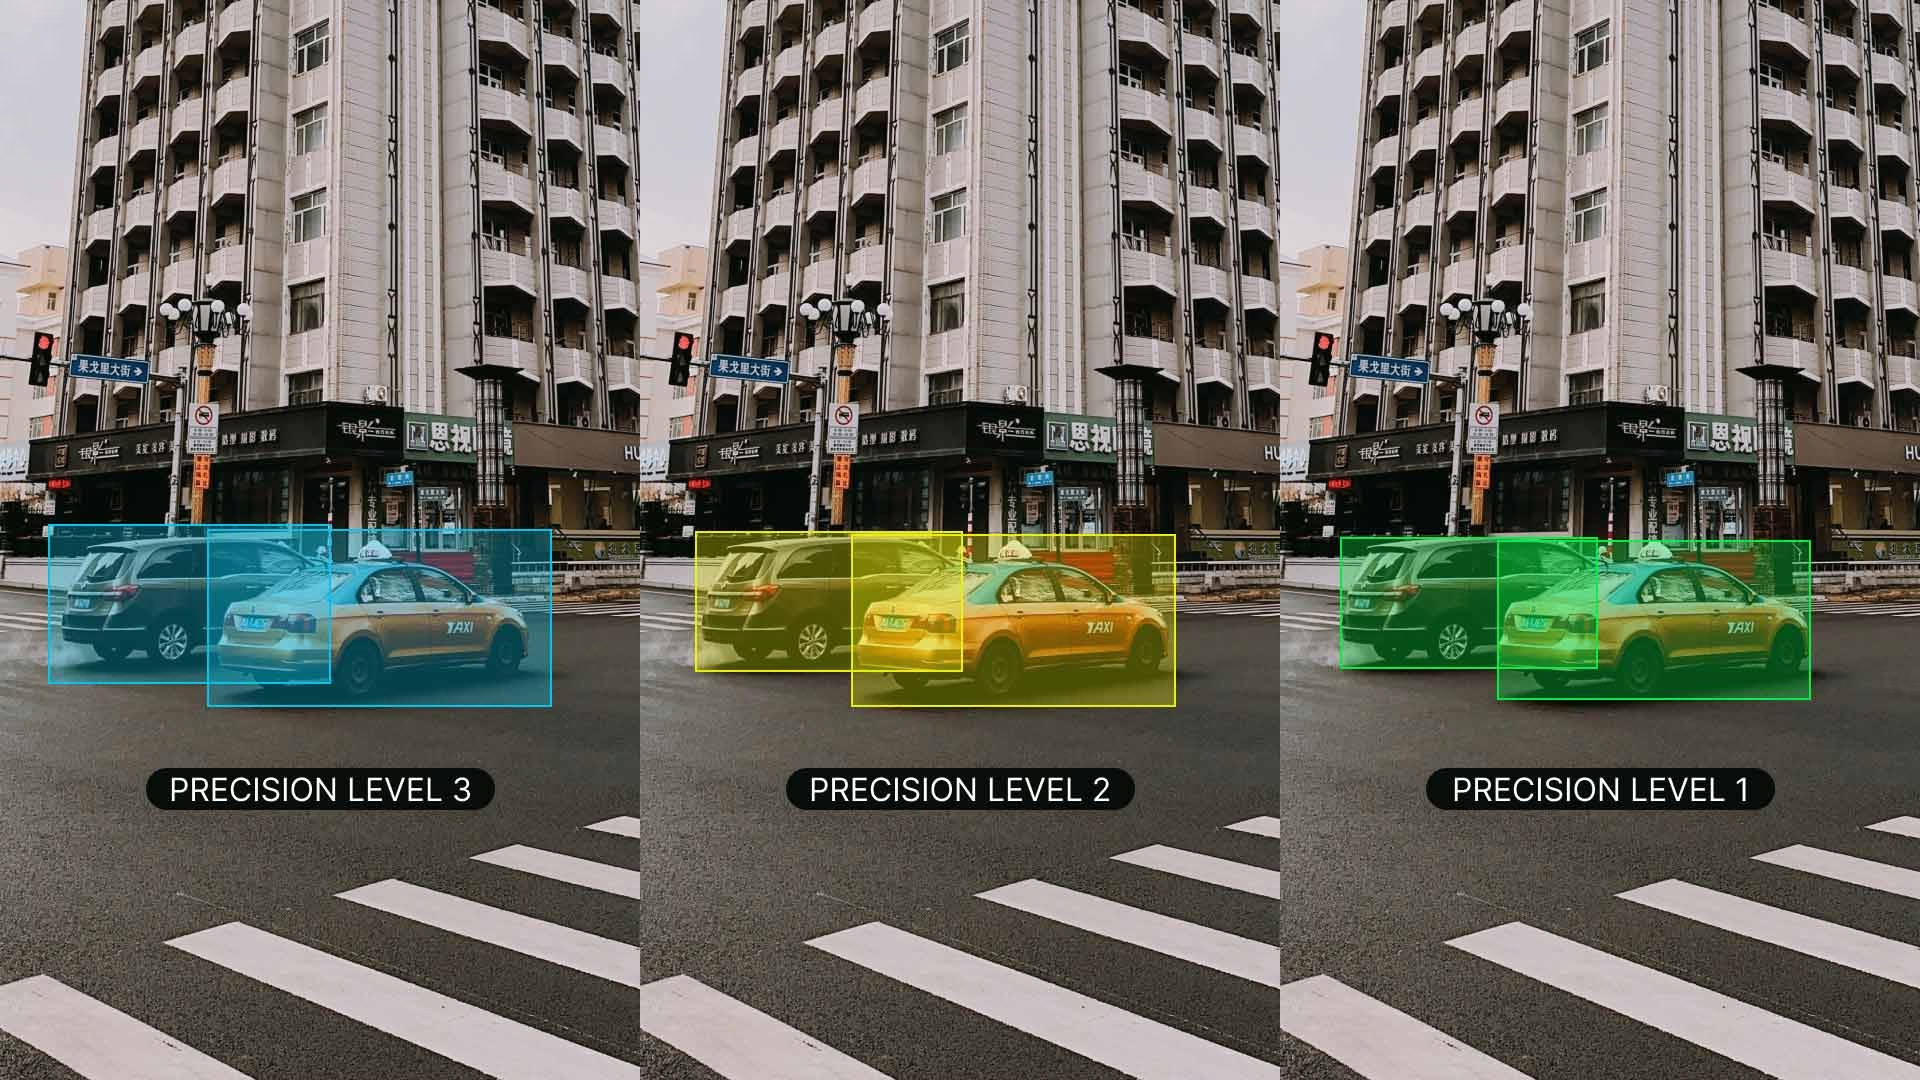
Doğruluk ile kesinlik arasındaki farkı ve bunların etiketlemeyle ilişkisini anlamak önemlidir. Doğruluk, etiketlenmiş verilerin gerçek değerlere ne kadar yakın olduğunu ifade eder. Etiketlerin gerçek dünya senaryolarını ne ölçüde yansıttığını ölçmemize yardımcı olur. Kesinlik, etiketlerin tutarlılığını gösterir. Veri kümesi boyunca aynı nesneye veya özelliğe aynı etiketi verip vermediğini kontrol eder. Yüksek doğruluk ve kesinlik, gürültüyü azaltıp modelin eğitim verilerinden genelleme yeteneğini geliştirerek daha iyi eğitilmiş modeller ortaya çıkarır.
Aykırı Değerleri Belirleme#
Aykırı değerler, veri kümesindeki diğer gözlemlerden belirgin biçimde sapan veri noktalarıdır. Etiketler söz konusu olduğunda aykırı değer, yanlış etiketlenmiş bir görüntü veya veri kümesinin geri kalanıyla uyuşmayan bir etiket olabilir. Aykırı değerler endişe vericidir; çünkü modelin öğrenme sürecini bozarak hatalı tahminlere ve zayıf genelleme performansına yol açabilirler.
Aykırı değerleri belirlemek ve düzeltmek için çeşitli yöntemler kullanabilirsin:
- İstatistiksel Teknikler: Piksel değerleri, sınırlayıcı kutu koordinatları veya nesne boyutları gibi sayısal özelliklerdeki aykırı değerleri tespit etmek için kutu grafikleri, histogramlar veya z-skorları gibi yöntemleri kullanabilirsin.
- Görsel Teknikler: Nesne sınıfları, renkler veya şekiller gibi kategorik özelliklerdeki anormallikleri belirlemek için görüntüleri, etiketleri veya ısı haritalarını çizdirme gibi görsel yöntemleri kullan.
- Algoritmik Yöntemler: Veri dağılımı örüntülerine göre aykırı değerleri belirlemek için kümeleme (ör. K-means kümeleme, DBSCAN) ve anomali tespiti algoritmaları gibi araçları kullan.
Etiketlenmiş Verilerin Kalite Kontrolü#
Diğer teknik projelerde olduğu gibi, etiketlenmiş veriler için de kalite kontrolü şarttır. Doğru ve tutarlı olduklarından emin olmak için etiketleri düzenli olarak kontrol etmek iyi bir uygulamadır. Bunu birkaç farklı şekilde yapabilirsin:
- Etiketlenmiş verilerden örnekleri gözden geçirmek
- Yaygın hataları tespit etmek için otomatik araçlar kullanmak
- Başka bir kişiden etiketleri yeniden kontrol etmesini istemek
Birden fazla kişiyle çalışıyorsan farklı etiketleyiciler arasındaki tutarlılık önemlidir. İyi bir etiketleyiciler arası uyum, yönergelerin açık olduğu ve herkesin bunları aynı şekilde uyguladığı anlamına gelir. Bu, herkesin aynı anlayışta olmasını ve etiketlerin tutarlı kalmasını sağlar.
Gözden geçirme sırasında hata bulursan bunları düzelt ve gelecekte aynı hataların yaşanmasını önlemek için yönergeleri güncelle. Hataları azaltmaya yardımcı olmak amacıyla etiketleyicilere geri bildirim ver ve düzenli eğitimler sun. Hataları ele almak için sağlam bir süreç oluşturmak, veri kümeni doğru ve güvenilir tutar.
Verimli Veri Etiketleme Stratejileri#
Veri etiketleme sürecini daha sorunsuz ve etkili hâle getirmek için şu stratejileri uygulamayı düşün:
- Açık Anotasyon Rehberleri: Tüm anotatörlerin görevleri tutarlı biçimde yorumlamasını sağlamak için örneklerle birlikte ayrıntılı talimatlar ver. Örneğin, kuşları etiketlerken kuşun tamamının mı yoksa yalnızca belirli kısımlarının mı dahil edileceğini belirt.
- Düzenli Kalite Kontrolleri: Çalışmaları gözden geçirmek için ölçütler belirle ve belirli metriklerden yararlan; sürekli geri bildirimle yüksek standartları koru.
- Ön Anotasyon Araçlarını Kullan: Pek çok modern anotasyon platformu, insanların daha sonra iyileştirebileceği ilk anotasyonları otomatik olarak oluşturarak süreci önemli ölçüde hızlandıran yapay zekâ destekli ön anotasyon özellikleri sunar.
- Aktif Öğrenme Uygula: Bu yaklaşım, önce en bilgilendirici örneklerin etiketlenmesine öncelik verir. Böylece model performansını korurken gereken toplam etiket sayısını azaltabilir.
- Toplu İşleme: Tutarlılığı korumak ve verimliliği artırmak için benzer görüntüleri anotasyon amacıyla gruplandır.
Bu stratejiler, etiketleme süreci için gereken zaman ve kaynakları azaltırken anotasyonların yüksek kalitede kalmasına yardımcı olabilir.
Sonuç#
Çeşitli ve tarafsız veriler toplamak ve doğru araçlarla tutarlı biçimde anotasyon yapmak, güvenilir bir bilgisayarlı görü modelinin temelini oluşturur. Veri kümeni toplayıp etiketledikten sonra, eğitim ve değerlendirme aşamalarına geçmek için bilgisayarlı görü projesinin adımları kılavuzunu incele. Bu süreçte soruların olursa topluluğa Ultralytics GitHub deposunda veya Ultralytics Discord sunucusunda danış.
Sık Sorulan Sorular#
Yanlılığı en aza indirmek için çeşitli kaynaklardan veri topla, ilgili tüm grupların (örneğin farklı yaş, cinsiyet ve etnik kökenlerin) dengeli biçimde temsil edilmesini sağla, ortaya çıkan yanlılıkları yakalamak için veri kümeni düzenli olarak gözden geçirip güncelle ve az temsil edilen sınıfları aşırı örnekleme, veri artırma ve adalet odaklı algoritmalar gibi azaltma tekniklerini uygula. Bu şekilde yanlılıktan kaçınmak, bilgisayarlı görü modelinin çeşitli gerçek dünya senaryolarında iyi performans göstermesini sağlar ve genelleme yeteneğini geliştirir.
Ayrıntılı talimatlar, örnekler ve görseller içeren açık, nesnel etiketleme yönergeleri oluştur; ardından her anotasyonun aynı kurallara uyması için bu yönergeleri tüm veri türlerinde tutarlı biçimde uygula. Kişisel yanlılığı azaltmak için anotatörleri tarafsız kalacak şekilde eğit, yönergeleri düzenli olarak gözden geçirip güncelle ve doğruluğu yüksek tutup proje hedeflerinle uyumlu kılmak için otomatik tutarlılık kontrollerinden ve anotatörler arası geri bildirimden yararlan.
Transfer öğrenimi ile denemelere başlamak için sınıf başına anotasyonlu birkaç yüz nesne yeterlidir; ancak gerçek dünyada güvenilir performans için Ultralytics, sınıf başına en az 1.500 görüntü ve 10.000 etiketli örnek önerir. Yeterince büyük bir veri kümesini makul bir eğitim programıyla eşleştir — yaklaşık 300 epoch yaygın bir başlangıç noktasıdır; model erken aşamada aşırı öğrenirse bu sayıyı azalt — ve anotasyonlarının titiz, projenin özel hedefleriyle uyumlu olmasını sağla. Ayrıntılı eğitim stratejileri için YOLO26 eğitim kılavuzunu incele.
Evet. Ultralytics Platform, sınırlayıcı kutuları, çokgenleri, kilit noktaları, yönlendirilmiş kutuları ve sınıflandırma etiketlerini tek bir çalışma alanında destekleyen yerleşik bir anotasyon düzenleyicisi içerir. SAM destekli akıllı anotasyon, tek tıklamayla maskeler oluşturarak nesne algılama, örnek segmentasyonu, anlamsal segmentasyon ve OBB görevlerinde etiketlemeyi hızlandırır; poz veri kümelerinde akıllı anotasyon için YOLO poz modelleri kullanılabilir, sınıflandırma ise elle anotasyonlanır. Anotasyonlar her görevin beklediği düzende saklanır: uzamsal görevler için YOLO
.txtsatırları, sınıflandırma için sınıf klasörleri — eğitime hazır.Anotasyon türünü eğitmeyi amaçladığın göreve göre belirle. Sınırlayıcı kutuları çizmek en hızlı yöntemdir ve nesne algılama için yeterlidir. Çokgenler ve maskeler nesne başına belirgin biçimde daha fazla zaman gerektirir; ancak nesnenin tam şeklinin önemli olduğu örnek segmentasyonu için gereklidir. Kilit noktalar poz kestirimi ve işaret noktası algılama için, yönlendirilmiş kutular ise eksenlere hizalı bir dikdörtgenin çok fazla arka planı kapsayacağı hava görüntüleri gibi OBB görevleri için uygundur. Gerçekten ihtiyaç duyduğun en ayrıntılı görev için anotasyon yapmak, etiketleme çabasını elde edeceğin sonuçla orantılı tutar.


Yorumlar16
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
 Letícia Rama
Hello,
Has anyone worked with oriented object detection using a multisource dataset that combines satellite and UAV imagery?
I am currently developing a scientific project focused on oriented detection of fishing vessels. As part of this work, I conducted two systematic reviews: one covering existing oriented detection models and another covering publicly available datasets. So far, I have identified multisource datasets that combine imagery from multiple satellite platforms; however, I have not found datasets that explicitly integrate both satellite and UAV images.
I understand the importance of source diversity to mitigate dataset bias and improve model generalization. That said, I would appreciate insights from the community on whether combining UAV and satellite imagery might introduce excessive domain variability (e.g., differences in spatial resolution, viewing angles, and sensor characteristics), potentially hindering model training and convergence.
Any experiences, references, or best practices related to this type of multisource setup would be highly appreciated.
 Glenn JocherUltralytics
Great question—mixing UAV + satellite can increase domain shift (GSD/resolution, look-angle, sensor PSF), but it’s usually manageable if you control the dataset and evaluation: keep one unified, very explicit labeling policy (same object extent/rotation rules) and balanced sampling as described in our Data Collection and Annotation guide, then train with per-source “slice” validation (sat-only/UAV-only) and consider staged training (pretrain on the larger domain, then fine-tune on the smaller) rather than a single fully-mixed run; if you’re using Ultralytics YOLO for oriented detection, the OBB task docs cover the expected label format and training flow—feel free to share your planned split strategy and a couple example tiles (UAV + satellite) here and the team/community can sanity-check the setup.
1- Letícia Rama
Hi Glenn,
To be more specific,
I am using a pretrained yolo26 m obb to perform detection of a single class: ships of a particular type (fishing boats).
I have a dataset with satellite optical images collected from google earth pro counting 331 pairs of images/labels. The total number of instances is 5974. Images size are fixed at 4823 height x 8192 width. The bounding boxes have 0.075 height x 0.04 width (according to yolo train results). Resolution varies from very-low to very-high. The images were captured with an altitude between 200-400 meters.
I also have 21 very-high resolution images collected from UAV. Images size are fixed at 3072 height x 4096 width. The images were captured with an altitude of 120 meters.
I would like to test if incorporating UAV images in training data would improved the models hability to detect the objects.
From what you proposed, please confirm if I understood correctly:
- Should the train set be mixed (sat+UAV) and the validation set be separate (sat-only/UAV-only)?
- If so, is this separation configured the staged training you are refering? That is, pretrain with sat+UAV as the train set and sat-only as validation subset, and further fine-tune with the same train subset (sat+UAV) but now using the uav-only as the validation set?
Thanks
- Letícia Rama
OBS.: sorry, sometimes I wrote 'train subset', and 'validation subset' but all of them was supposed to be written as 'train set', and 'validation set'.
- Glenn JocherUltralytics
Your first interpretation is correct: compare a satellite-only baseline against mixed satellite+UAV training while keeping fixed, disjoint satellite-only and UAV-only evaluation sets. This is not staged training—changing only the validation set does not fine-tune the model. Staged training would first train on satellite data, then continue from that checkpoint using only the UAV training split with a lower learning rate, evaluating both domains afterward. With only 21 UAV images, split by original scene before tiling to prevent leakage, and consider grouped k-fold validation because a single UAV split will be unstable.
1 - Letícia Rama
Understood, thanks.
Sudharsanam-1
hello ! For detecting 31 Chinese symbols (16 true and 15 fake), how many classes should be used in the model? Is it more efficient to detect the true symbols using only true class , or should we also include the fake symbols as separate classes?
Team-Q-Botix
I’m working on Robocon 2026 (Kung Fu Quest) and using YOLO-seg for detecting KFS symbols — ancient Chinese oracle bone characters. There are 15 true symbols, 15 fake ones (random patterns mimicking the real ones), plus 1 “other” class → total 31 classes.
Do you think instance segmentation (YOLOv8-seg / YOLOv11-seg) is the right approach for these detailed 2D symbols, or would box detection + contour refinement be better? Also, any advice on which model to start with and how large a dataset (per class) you’d recommend for good mask performance on Jetson Orin?
robert-hardman
Hello In object recognition with YOLO11 If we label images by drawing polygons: When training, does YOLO11 convert polygon coordinates to boxes? How does Inference handle polygon coordinates?
- Glenn JocherUltralytics
@robert-hardman yOLO11 does not inherently convert polygon annotations to bounding boxes during training. Polygons are used directly for tasks like instance segmentation, while bounding boxes are utilized for object detection. During inference, polygon annotations are retained for segmentation tasks, ensuring accurate object shape representation. For more on annotation types, refer to Data Annotation Guide.
1
ghost
Hello, thanks for the info ! I would like to know how to perform active learning, specifically what are the metrics to choose the most informative images when the task is multi-instance multi-class object detection ?
 Paula DerrengerUltralytics(düzenlendi)
@cawilchesp hello! Great question on active learning for multi-instance multi-class object detection. Active learning can significantly enhance your model by iteratively selecting the most informative samples for annotation. Here are some key metrics and strategies to consider:
Metrics for Selecting Informative Images:
-
Uncertainty Sampling: Choose images where the model is least confident. This can be measured using:
- Entropy: High entropy indicates uncertainty in predictions.
- Margin Sampling: Select samples where the difference between the top two class probabilities is smallest.
- Least Confidence: Select samples with the lowest maximum class probability.
-
Diversity Sampling: Ensure a diverse set of samples to avoid redundancy.
- Core-Set Selection: Use clustering techniques to select a diverse subset of data points.
- Representative Sampling: Choose samples that represent the overall data distribution.
-
Error-Based Sampling: Focus on samples where the model previously made errors.
- Misclassified Samples: Select images where the model's predictions were incorrect.
- High Loss Samples: Choose samples with high loss values during training.
Implementing Active Learning:
Here's a basic example using least-confidence uncertainty sampling for detection, based on each image's mean box confidence (
result.probsis only available for classification models):import numpy as np from ultralytics import YOLO # Load your model model = YOLO('yolo26n.pt') # Predict on a batch of images results = model(['image1.jpg', 'image2.jpg', 'image3.jpg']) # Mean box confidence per image (0 if nothing was detected) scores = [r.boxes.conf.mean().item() if len(r.boxes) else 0.0 for r in results] # Select the image with the lowest confidence most_informative_image = results[int(np.argmin(scores))]Additional Resources:
For more detailed strategies and examples, you can refer to our Data Collection and Annotation Strategies.
Feel free to experiment with these methods and see which works best for your specific use case. If you have any further questions or need more examples, don't hesitate to ask! 😊
-
MoAbbasid
Hello, Im looking for an open source annotation tool similar to labelme that exports directly to YOLOv8 format, something other than labelme?
- Glenn JocherUltralytics
@MoAbbasid hello! For an open-source annotation tool that exports directly to YOLOv8 format, you might want to try CVAT. It's quite versatile and supports exporting annotations directly into YOLO format among others. Another good option could be Label Studio, which offers flexibility in configuring export formats, including YOLO. Both tools provide robust features for efficient data labeling and are well-suited for various annotation tasks. Happy annotating! 😊
1 @glenn-jocher do they offer polygon annotations for instance segmentation?
- Glenn JocherUltralytics(düzenlendi)
Hello @MoAbbasid,
Yes, Ultralytics YOLO does support polygon annotations for instance segmentation. This allows for more precise labeling of objects compared to traditional bounding boxes, which can be particularly useful for complex shapes and detailed segmentation tasks.
To create polygon annotations, you can use tools like Roboflow Annotate or CVAT. Both of these tools support polygon annotations and can export the data in a format compatible with Ultralytics YOLO.
Here's a brief overview of how you can use Roboflow for this purpose:
- Create a Project: Start by creating a new project in Roboflow.
- Upload Images: Upload your images to the project.
- Annotate Images: Use the polygon tool to draw detailed outlines around objects. Roboflow also offers a SAM-based label assistant to speed up the annotation process.
- Export Annotations: Once your annotations are complete, you can export the dataset in YOLO format.
For more detailed steps on using Roboflow for data annotation and management, you can refer to the Roboflow documentation.
Here's a quick example of how to load and use a dataset with polygon annotations:
from ultralytics import YOLO

# Load a YOLO26 segmentation model
model = YOLO('yolo26n-seg.pt')

# Train the model on your custom dataset
model.train(data='path/to/your/dataset.yaml', epochs=100, imgsz=640)

# Validate the model
metrics = model.val()

# Make predictions
results = model.predict(source='path/to/your/images')

# Visualize results
results[0].show()
Feel free to reach out if you have any more questions or need further assistance. Happy annotating! 😊
1