Ultralytics ile K-Katlı Çapraz Doğrulama
Giriş#
Bu kılavuz, Ultralytics ekosistemindeki nesne algılama veri kümeleri için K-Katlı Çapraz Doğrulamayı nasıl uygulayacağını gösterir. YOLO algılama biçimini ve scikit-learn, pandas ve PyYAML gibi Python kütüphanelerini kullanarak kurulum, özellik vektörleri oluşturma ve veri kümesini K katına bölme adımlarını açıklar.
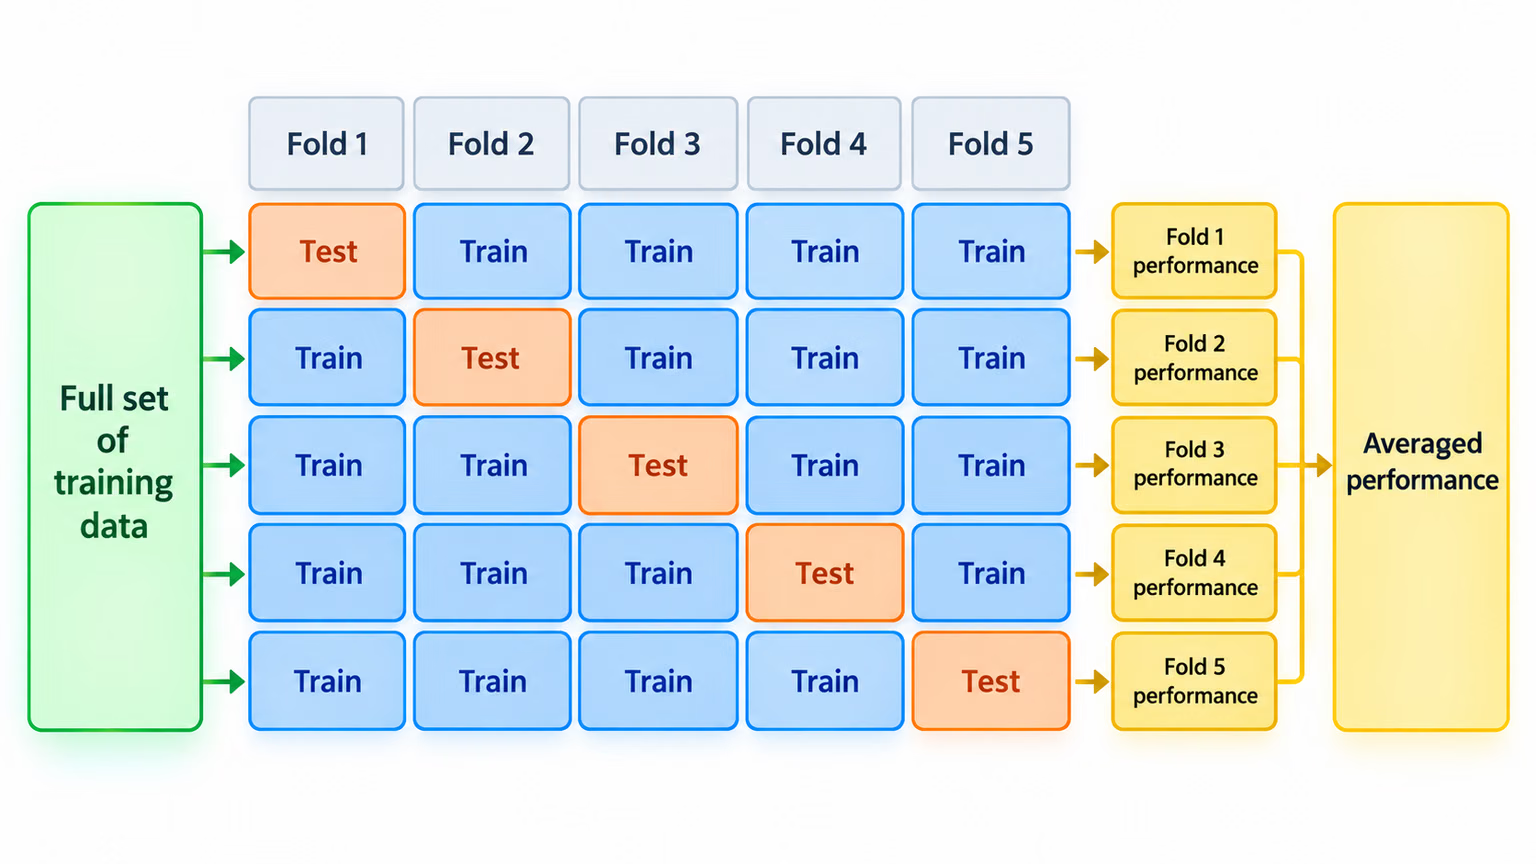
Projen ister Meyve Algılama veri kümesini ister özel bir veri kaynağını kullansın, bu eğitim makine öğrenmesi modellerinin güvenilirliğini ve dayanıklılığını artırmak için K-Katlı Çapraz Doğrulamayı anlamana ve uygulamana yardımcı olur. Bu eğitimde k=5 kat kullansak da en uygun kat sayısının veri kümesine ve projenin özelliklerine göre değişebileceğini unutma. K-Katlı Çapraz Doğrulama; küçük, gürültülü veya değişkenliği yüksek veri kümelerinde en fazla faydayı sağlar. Büyük ve çeşitli veri kümeleri için iyi oluşturulmuş bir eğitim/doğrulama/test bölmesi genellikle yeterlidir.
Kurulum#
-
Ek açıklamaların YOLO algılama biçiminde olmalıdır.
-
Bu kılavuzda ek açıklama dosyalarının yerel olarak erişilebilir olduğu varsayılır.
-
Örneğimizde Fruit Detection veri kümesini kullanıyoruz.
- Bu veri kümesinde toplam 8479 görüntü bulunur.
- Veri kümesi 6 sınıf etiketi içerir ve her sınıfın toplam örnek sayısı aşağıda listelenmiştir.
| Sınıf Etiketi | Örnek Sayısı |
|---|---|
| Elma | 7049 |
| Üzüm | 7202 |
| Ananas | 1613 |
| Portakal | 15549 |
| Muz | 3536 |
| Karpuz | 1976 |
-
Gerekli Python paketleri:
ultralyticssklearnpandaspyyaml
-
Bu eğitimde
k=5kat kullanılır. Ancak kendi veri kümen için en uygun kat sayısını belirlemelisin.
-
Projen için yeni bir Python sanal ortamı (
venv) oluşturup etkinleştir. Kurulum yapmak içinpip(veya tercih ettiğin paket yöneticisi) aracını kullan:- Ultralytics kütüphanesi:
pip install -U ultralytics. Alternatif olarak resmî depoyu klonlayabilirsin. - Scikit-learn, pandas ve PyYAML:
pip install -U scikit-learn pandas pyyaml.
- Ultralytics kütüphanesi:
-
Ek açıklamalarının YOLO algılama biçiminde olduğunu doğrula.
- Bu eğitimde tüm ek açıklama dosyaları
Fruit-Detection/labelsdizininde bulunur.
- Bu eğitimde tüm ek açıklama dosyaları
Nesne Algılama Veri Kümesi için Özellik Vektörleri Oluşturma#
-
Aşağıdaki adımlar için yeni bir
example.pyPython dosyası oluşturarak başla. -
Test bölmesini değiştirmeden bırakıp, veri kümesi YAML dosyanda listelenen eğitim ve doğrulama görüntülerini Ultralytics
YOLODatasetsınıfıyla yükle.from pathlib import Path from ultralytics.data.dataset import YOLODataset from ultralytics.data.utils import check_det_dataset yaml_file = "path/to/data.yaml" data = check_det_dataset(yaml_file) dataset_path = Path(data["path"]) sources = [] for split in ("train", "val"): source = data.get(split) if source: sources.extend(source if isinstance(source, list) else [source]) dataset = YOLODataset(sources, data=data, augment=False) images = [Path(p) for p in dataset.im_files] -
Şimdi veri kümesinin YAML dosyasını oku ve sınıf etiketlerinin indekslerini çıkar.
classes = data["names"] cls_idx = sorted(classes.keys()) -
Boş bir
pandasDataFrame'i başlat.import pandas as pd labels_df = pd.DataFrame(0.0, columns=cls_idx, index=images) -
Etiket dosyalarında bulunan her sınıf etiketinin örnek sayısını hesapla.
from collections import Counter for image, label in zip(images, dataset.labels): lbl_counter = Counter(label["cls"].flatten().astype(int)) labels_df.loc[image, list(lbl_counter)] = list(lbl_counter.values()) -
Doldurulmuş DataFrame'in örnek görünümü aşağıdadır:
                                                       0    1    2    3    4    5
'0000a16e4b057580_jpg.rf.00ab48988370f64f5ca8ea4...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.7e6dce029fb67f01eb19aa7...'  0.0  0.0  0.0  0.0  0.0  7.0
'0000a16e4b057580_jpg.rf.bc4d31cdcbe229dd022957a...'  0.0  0.0  0.0  0.0  0.0  7.0
'00020ebf74c4881c_jpg.rf.508192a0a97aa6c4a3b6882...'  0.0  0.0  0.0  1.0  0.0  0.0
'00020ebf74c4881c_jpg.rf.5af192a2254c8ecc4188a25...'  0.0  0.0  0.0  1.0  0.0  0.0
 ...                                                  ...  ...  ...  ...  ...  ...
'ff4cd45896de38be_jpg.rf.c4b5e967ca10c7ced3b9e97...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff4cd45896de38be_jpg.rf.ea4c1d37d2884b3e3cbce08...'  0.0  0.0  0.0  0.0  0.0  2.0
'ff5fd9c3c624b7dc_jpg.rf.bb519feaa36fc4bf630a033...'  1.0  0.0  0.0  0.0  0.0  0.0
'ff5fd9c3c624b7dc_jpg.rf.f0751c9c3aa4519ea3c9d6a...'  1.0  0.0  0.0  0.0  0.0  0.0
'fffe28b31f2a70d4_jpg.rf.7ea16bd637ba0711c53b540...'  0.0  6.0  0.0  0.0  0.0  0.0
Satırlarda mutlak görüntü yolları, sütunlarda ise sınıf etiketi indeksleri yer alır. Eksik etiketler, tüm değerleri sıfır olan arka plan satırları olarak kalır. Bu veri yapısı, nesne algılama veri kümesine K-Katlı Çapraz Doğrulama uygulamayı sağlar.
K-Katlı Veri Kümesi Bölmesi#
-
Şimdi veri kümesini
kbölüme ayırmak içinsklearn.model_selectioniçindekiKFoldsınıfını kullanacağız.- Önemli:
shuffle=Trueayarı, bölümlerde sınıfların rastgele dağıtılmasını sağlar.Mseçilen bir tam sayı olduğundarandom_state=Mayarını yaparak tekrarlanabilir sonuçlar elde edebilirsin.
from sklearn.model_selection import KFold ksplit = 5 kf = KFold(n_splits=ksplit, shuffle=True, random_state=20) # tekrarlanabilir sonuçlar için random_state ayarlanıyor kfolds = list(kf.split(labels_df)) - Önemli:
-
Veri kümesi artık
kkata bölündü; her kattatrainvevalindekslerinden oluşan bir liste bulunuyor. Sonuçları daha net görüntülemek için bir DataFrame oluşturacağız.folds = [f"split_{n}" for n in range(1, ksplit + 1)] folds_df = pd.DataFrame(index=labels_df.index, columns=folds) for i, (train, val) in enumerate(kfolds, start=1): folds_df.loc[labels_df.index[train], f"split_{i}"] = "train" folds_df.loc[labels_df.index[val], f"split_{i}"] = "val" -
Şimdi her kat için sınıf etiketlerinin dağılımını,
valiçindeki sınıflarıntrainiçindeki sınıflara oranı olarak hesaplayacağız.fold_lbl_distrb = pd.DataFrame(index=folds, columns=cls_idx) for n, (train_indices, val_indices) in enumerate(kfolds, start=1): train_totals = labels_df.iloc[train_indices].sum() val_totals = labels_df.iloc[val_indices].sum() # To avoid division by zero, we add a small value (1E-7) to the denominator ratio = val_totals / (train_totals + 1e-7) fold_lbl_distrb.loc[f"split_{n}"] = ratioİdeal durumda tüm sınıf oranları her bölmede ve sınıflar arasında makul ölçüde benzer olmalıdır. Ancak bu, veri kümenin özelliklerine bağlıdır.
-
Her bölme için görüntü listelerini ve bir veri kümesi YAML dosyası yaz. Metin listeleri, veri kümesini
kkez kopyalama ihtiyacını ortadan kaldırır.import yaml save_path = dataset_path.parent / f"{ksplit}-Fold_Cross-val" save_path.mkdir(parents=True, exist_ok=True) ds_yamls = [] for split in folds_df.columns: for partition in ("train", "val"): split_images = folds_df.index[folds_df[split] == partition] paths = "\n".join(map(str, split_images)) (save_path / f"{split}_{partition}.txt").write_text(f"{paths}\n") dataset_yaml = save_path / f"{split}.yaml" ds_yamls.append(dataset_yaml) with open(dataset_yaml, "w") as ds_y: yaml.safe_dump( { "path": save_path.as_posix(), "train": f"{split}_train.txt", "val": f"{split}_val.txt", "names": classes, }, ds_y, )
Kayıtları Kaydetme (İsteğe Bağlı)#
İstersen K-Katlı bölme ve etiket dağılımı DataFrame'lerinin kayıtlarını ileride başvurmak üzere CSV dosyaları olarak kaydedebilirsin.
folds_df.to_csv(save_path / "kfold_datasplit.csv")
fold_lbl_distrb.to_csv(save_path / "kfold_label_distribution.csv")
K-Katlı Veri Bölmeleriyle YOLO Eğitme#
-
Önce YOLO modelini yükle.
from ultralytics import YOLO weights_path = "path/to/weights.pt" # küçük bir model için yolo26n.pt kullan model = YOLO(weights_path, task="detect") -
Ardından eğitim çalıştırmak için veri kümesi YAML dosyaları arasında döngü kur. Sonuçlar,
projectvenamebağımsız değişkenleriyle belirtilen dizine kaydedilir. Varsayılan olarak bu dizinruns/detect/train#olur;#ise bir tamsayı indeksidir.results = {} # Define your additional arguments here batch = 16 project = "kfold_demo" epochs = 100 for k, dataset_yaml in enumerate(ds_yamls): model = YOLO(weights_path, task="detect") results[k] = model.train( data=dataset_yaml, epochs=epochs, batch=batch, project=project, name=f"fold_{k + 1}" ) # include any additional train arguments -
Veri kümesini otomatik olarak bölmek için Ultralytics autosplit işlevini de kullanabilirsin:
from ultralytics.data.split import autosplit

# Veri kümesini otomatik olarak train/val/test bölümlerine ayır
autosplit(path="path/to/images", weights=(0.8, 0.2, 0.0), annotated_only=True)
Sonuç#
Bu kılavuzda, YOLO nesne algılama modelini eğitmek için K-Katlı çapraz doğrulama kullanımını inceledik. Eğitim ve doğrulama havuzunu K bölüme ayırmayı ve rastgele bölme sonrasında sınıf dengesini incelemek için oluşturulan oran tablosunu kullanmayı öğrendik.
Ayrıca veri bölmelerini ve bu bölmelerdeki etiket dağılımlarını görselleştiren rapor DataFrame'leri oluşturma yöntemini de inceledik. Böylece eğitim ve doğrulama kümelerimizin yapısını net biçimde görebildik.
Kayıtlarımızı isteğe bağlı olarak ileride başvurmak üzere kaydettik. Bu, büyük ölçekli projelerde veya model performansıyla ilgili sorunları giderirken özellikle yararlı olabilir.
Son olarak, her bölmeyi bir döngüde kullanarak model eğitimini uyguladık ve eğitim sonuçlarımızı daha sonra analiz ve karşılaştırma yapmak üzere kaydettik.
Bu K-Katlı çapraz doğrulama tekniği, elindeki verilerden en iyi şekilde yararlanmanın sağlam bir yoludur ve farklı veri alt kümelerinde model performansının güvenilir ve tutarlı olmasını sağlamaya yardımcı olur. Böylece belirli veri örüntülerine aşırı uyum gösterme olasılığı daha düşük, genelleme kabiliyeti ve güvenilirliği daha yüksek bir model elde edilir.
Bu kılavuzda YOLO kullanmış olsak da bu adımların çoğunun diğer makine öğrenimi modellerine de uygulanabileceğini unutma. Bu adımları anlamak, kendi makine öğrenimi projelerinde çapraz doğrulamayı etkili biçimde uygulamanı sağlar.
Sık Sorulan Sorular#
K-Katlı Çapraz Doğrulama, model performansını daha güvenilir biçimde değerlendirmek için veri kümesinin 'k' alt kümeye (kata) bölündüğü bir tekniktir. Her kat hem eğitim hem de doğrulama verisi olarak kullanılır. Nesne algılama bağlamında K-Katlı Çapraz Doğrulama, Ultralytics YOLO modelinin farklı veri bölmelerindeki performansının sağlam ve genellenebilir olmasını sağlayarak güvenilirliğini artırmaya yardımcı olur. Ultralytics YOLO ile K-Katlı Çapraz Doğrulamayı ayarlama konusunda ayrıntılı talimatlar için Ultralytics ile K-Katlı Çapraz Doğrulama başlıklı kaynağa bak.
Ultralytics YOLO ile K-Katlı Çapraz Doğrulamayı uygulamak için şu adımları izle:
- Ek açıklamaların YOLO algılama biçiminde olduğunu doğrula.
sklearn,pandasvepyyamlgibi Python kütüphanelerini kullan.- Veri kümen üzerinden özellik vektörleri oluştur.
- Veri kümeni
sklearn.model_selectioniçindekiKFoldöğesini kullanarak böl. - YOLO modelini her bölmede eğit.
Kapsamlı bir kılavuz için belgelerimizdeki K-Katlı Veri Kümesi Bölmesi bölümüne bak.
Bu kılavuzdaki iş akışı YOLO algılama biçimini hedefler, ancak aynı yaklaşım tüm YOLO görevlerine uyarlanabilir: görev, çapraz doğrulamanın faydalı olup olmadığını değil, katları nasıl oluşturacağını değiştirir:
Görev Kat tasarımı detectNesne ve sınıf dağılımlarını katlar arasında dengeleyerek görüntü düzeyinde böl. İlişkili görüntüleri (aynı hasta, video dizisi, kamera veya konum) tek bir katta tut. segmentAlgılamayla aynı görüntü düzeyindeki stratejiyi kullan ve buna ek olarak her kattaki maske ve sınıf kapsamını koru. classifySınıf sıklıklarının eğitim ve doğrulama arasında dengeli kalması için katmanlı katları tercih et. poseAynı kişi veya hayvanın bir katın iki tarafında da yer almaması için denek ya da dizi bazında böl. obbGörüntü düzeyinde bölme yap ve aynı sahneden gelen döşemeleri veya kırpmaları bir arada tut; bu, özellikle hava görüntüleri için önemlidir. Görev ne olursa olsun, birbirine çok benzeyen örnekleri ve ilişkili örnekleri karşıt katlara koyma. Bu tür bir sızıntı, doğrulama metriklerini modelin üretimde elde edeceği düzeyin çok üzerine çıkarır.
Ultralytics YOLO, yüksek doğruluk ve verimlilikle son teknoloji ürünü, gerçek zamanlı nesne tespiti sunar. Tespit, örnek segmentasyonu, anlamsal segmentasyon ve sınıflandırma gibi çeşitli bilgisayarlı görü görevlerini destekleyen çok yönlü bir çözümdür. Ayrıca kod yazmadan model eğitimi ve dağıtımı için Ultralytics Platform gibi araçlarla entegre olur.
Ek açıklamaların YOLO algılama biçimine uygun olmalıdır. Her ek açıklama dosyası, nesne sınıfını ve görüntüdeki sınırlayıcı kutu koordinatlarını listelemelidir. YOLO biçimi, nesne algılama modellerini eğitmek için veri işlemenin verimli ve standartlaştırılmış olmasını sağlar. Ek açıklamaları doğru biçimlendirme hakkında daha fazla bilgi için YOLO algılama biçimi kılavuzunu ziyaret et.
Evet, ek açıklamalar YOLO algılama biçimindeyse herhangi bir özel veri kümesiyle K-Katlı Çapraz Doğrulama kullanabilirsin. Veri kümesi yollarını ve sınıf etiketlerini kendi veri kümene özgü olanlarla değiştir. Bu esneklik, her nesne algılama projesinin K-Katlı Çapraz Doğrulama ile sağlam model değerlendirmesinden yararlanmasını sağlar. Uygulamalı bir örnek için Özellik Vektörleri Oluşturma bölümümüzü incele.


Yorumlar21
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.
jingieboy
does this work with yolov8-cls? if so how would the folder structure look like? how are the data splits
 Glenn JocherUltralytics(düzenlendi)
Yes—K‑Fold works the same for classification; use the standard ImageNet-style layout per fold, and train each fold separately (YOLO infers classes from folder names). For YOLO26 (recommended) you can do:
dataset/
  split_1/
    train/
      class_a/ ...
      class_b/ ...
    val/
      class_a/ ...
      class_b/ ...
  split_2/
    train/...
    val/...
  ...
from ultralytics import YOLO weights = "yolo26n-cls.pt" # swap to 'yolov8n-cls.pt' if you prefer YOLOv8 splits = ["dataset/split_1", "dataset/split_2", "dataset/split_3"] for d in splits: model = YOLO(weights) model.train(data=d, epochs=20, batch=16) # d must contain 'train/' and 'val/' subfoldersFor building folds, use
StratifiedKFoldon image-level labels derived from parent folder names to keep class balance, or use the random splitter shown in the autosplit reference if stratification isn’t required. Classification usage details are in the classification task docs.thank you for this! I have also notice that everytime I run model.val(), the accuracies and confusion matrix values are slightly different this time. Is this normal or during evaluation, there is a small randomness when calling the function.
- Glenn JocherUltralytics
@jingieboy minor variations can occur from non-deterministic CUDA ops or multi-threading; validation itself doesn’t add randomness by default—set seeds and force deterministic ops to lock results:
import random, numpy as np, torch

seed = 0
random.seed(seed); np.random.seed(seed); torch.manual_seed(seed)
torch.backends.cudnn.deterministic = True
torch.backends.cudnn.benchmark = False

model.val()  # run evaluation
If differences are still large, double-check your eval args in the validation mode docs.
Nehasq
Hi, I am applying K-fold validation using the leave-one-out technique. My dataset consists of a single class and includes 21 images in total. For each split, I use 20 images for training and 1 image for testing. I am implementing the leave-one-out technique with the code above, setting ksplit=21.
I am not using a separate validation dataset, only training and testing data. Here is the code I am using:
results = {}
Define additional arguments here
batch = 16 project = "kfold_demo" epochs = 100
for k in range(ksplit): dataset_yaml = ds_yamls[k] model = YOLO(weights_path, task="detect") model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project) # Include any train arguments results[k] = model.metrics # Save output metrics for further analysis
In my data.yaml file, I have provided the validation path as the test set. When it trains and validates on the "1 test data," does this mean the model is being tested on data it has never seen during training? This is my first point of confusion.
my data.yaml file for each split looks like this: names:
- pothole path: ../ 2024-12-10_21-Fold_Cross-val/split_1 train: train val: test
My second question is about calculating the final performance. When I ran the above code, it calculated scores for each individual split. Do I need to calculate the final performance metrics manually, or is there any functionality in YOLOv8 to compute the aggregated performance automatically?
- Glenn JocherUltralytics
@Nehasq to address your first question, yes, the model is being tested on unseen data during each split, as the test set (1 image) is excluded from training and only used for validation. Regarding your second question, YOLO does not automatically aggregate metrics across splits. You need to compute the final performance metrics manually by averaging the results from all splits. For reference, you can review the K-Fold Cross Validation guide.
Thanks for your reply. I understand your point. So, are you saying that, for example, in my case, where I have 21 scores (precision, recall, etc.), I should simply add all the precision values together and divide the sum by 21 to get the final precision of the model? Is that correct?
Also, in y case of 20 images( training) and 1 images for test, what batch size would you suggest?
- Glenn JocherUltralytics
Yes, to calculate the final precision (or any metric), you average the values across all splits, i.e., sum all precision scores and divide by the number of splits (21 in your case). As for the batch size, given your small dataset, you could keep it low (e.g., 1 or 2) to ensure efficient utilization of the data while avoiding overfitting.
Thanks, that really helps! With a batch size of 1, I am keeping the epochs at 10. Should it be fewer? Also, to check for overfitting, I need to review the result graphs for each split. However, I can't definitively determine if it is overfitting since each split is separate, right?
- Glenn JocherUltralytics
Keeping epochs at 10 with a batch size of 1 is reasonable given your small dataset size. To check for overfitting, reviewing result graphs from each split can help, but overfitting may be harder to detect since each split involves different training and test data. Consider comparing trends across splits for consistent insights. For further details, you can reference the K-Fold Cross Validation guide.
semyon-v-dot
After the loop:
for ext in supported_extensions:
    images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))
Should be this line of code:
images = sorted(images)For
imagesmatching withlabelslist:labels = sorted(dataset_path.rglob("*labels/*.txt"))Otherwise the script creates background images because some images missing their labels.
- Glenn JocherUltralytics
@semyon-v-dot thank you for your suggestion. Sorting the
imageslist after extending it with supported extensions is a good practice to ensure alignment with thelabelslist. This helps prevent issues with missing labels.1
 sangeun jo
K-폴드 데이터 세트 분할 4번에서
images.extend(sorted((dataset_path / "images").rglob(f"*{ext}")))이 코드를images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))로 변환해야 작동했습니다.- Glenn JocherUltralytics
@sangeun-jo thank you for pointing that out. Your modification to
images.extend(sorted(dataset_path.rglob(f"*images/*{ext}")))is indeed correct and ensures the code works as intended. If you have any further questions or need additional assistance, feel free to ask!
kh-diab
is it usefult to use this k fold approach when I just have one class only but my issue is the class is detected as background or vice versa as per the attached Confusion matrix
- Glenn JocherUltralytics
@kh-diab using K-Fold Cross Validation can still be beneficial even with a single class. It helps ensure that your model's performance is robust and not overly dependent on a particular subset of the data. This can be particularly useful if you're experiencing issues with class detection accuracy, as it allows you to validate the model's performance across multiple splits and identify any inconsistencies. If your class is being detected as background or vice versa, K-Fold Cross Validation can help diagnose whether this issue is consistent across different data splits or specific to certain subsets. For more details, you can refer to our guide on K-Fold Cross Validation: https://docs.ultralytics.com/guides/kfold-cross-validation/.
alexander-sony
Good guide, consider adding it in a colab notebook.
In section "Train YOLO using K-Fold Data Splits", model should be re-initialized foe every k, i.e. it should be inside the for-loop: for k in range(ksplit).
- Glenn JocherUltralytics
@alexander-sony thank you for your feedback and suggestion! 😊
You're absolutely right about re-initializing the model within the loop for each fold to ensure a fresh start for every training iteration. This can help avoid any potential carryover effects from previous folds. Here's the corrected code snippet for the training section:
from ultralytics import YOLO

weights_path = "path/to/weights.pt"
results = {}

# Define your additional arguments here
batch = 16
project = "kfold_demo"
epochs = 100

for k in range(ksplit):
    model = YOLO(weights_path, task="detect")  # Re-initialize the model inside the loop
    dataset_yaml = ds_yamls[k]
    model.train(data=dataset_yaml, epochs=epochs, batch=batch, project=project)  # include any train arguments
    results[k] = model.metrics  # save output metrics for further analysis
Regarding your suggestion to add this guide to a Colab notebook, that's a fantastic idea! It would make the process more interactive and accessible for users. We'll consider creating a Colab version of this guide in the future.
For more details on K-Fold Cross Validation, you can refer to our comprehensive guide.
Thanks again for your valuable input! If you have any more suggestions or questions, feel free to share. Happy coding! 🚀
Likhith-Sugganahalli
@alexander-sony
woudnt that be a new model trained on each split, giving us n different models trained on 1/nth of the dataset?
 Fazri Gading
Is there any way to implement Stratified K-Fold Cross Validation with YOLOv8?
 Paula DerrengerUltralytics
Yes, you can implement Stratified K-Fold Cross Validation with YOLOv8! Stratified K-Fold ensures that each fold has a similar distribution of class labels, which can be particularly useful for imbalanced datasets.
To achieve this, you can use
StratifiedKFoldfromsklearn.model_selectioninstead ofKFold. Here's a brief example of how to modify the K-Fold implementation:from sklearn.model_selection import StratifiedKFold # Assuming labels_df is your DataFrame with class counts ksplit = 5 skf = StratifiedKFold(n_splits=ksplit, shuffle=True, random_state=20) # Generate stratified splits kfolds = list(skf.split(labels_df, labels_df.idxmax(axis=1))) # The rest of the process remains the sameFor a detailed guide on K-Fold Cross Validation, please refer to the Ultralytics documentation. If you have any more questions, feel free to ask! 😊
1