Dataset Viên thuốc y tế#
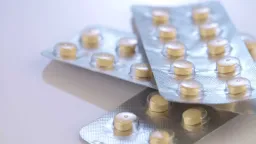
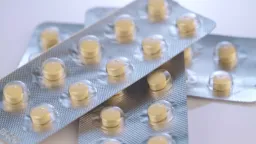
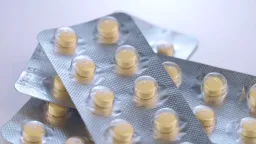
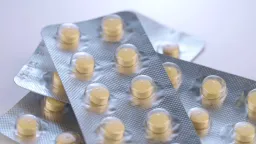

Dataset Viên thuốc y tế của Ultralytics là dataset phát hiện đối tượng mang tính thử nghiệm chứng minh khả thi (POC), gồm 115 ảnh được gán nhãn thuộc một lớp duy nhất, pill — 92 ảnh huấn luyện và 23 ảnh validation. Dataset được xây dựng để minh họa các model thị giác máy tính cho các ứng dụng dược phẩm như kiểm soát chất lượng, tự động hóa đóng gói và phân loại.
Xem: Cách huấn luyện model Ultralytics YOLO trên dataset phát hiện thuốc viên y tế trong Google Colab
Cấu trúc dataset#
Dataset Viên thuốc y tế gồm 115 ảnh được gán nhãn thuộc một lớp duy nhất, pill, được chia thành hai tập con xác định trong cấu hình medical-pills.yaml:
| Tập dữ liệu | Hình ảnh | Mô tả |
|---|---|---|
| Huấn luyện | 92 | Ảnh được gán nhãn để training model |
| Validation | 23 | Ảnh tách biệt để đánh giá và benchmark |
Khám phá Viên thuốc y tế trên Ultralytics Platform để xem ảnh cùng lớp phủ chú thích, xem phân phối lớp và heatmap hộp giới hạn trong tab Biểu đồ, đồng thời sao chép dataset để huấn luyện model của riêng bạn trên cloud.
Ứng dụng#
Ứng dụng thị giác máy tính để phát hiện viên thuốc y tế giúp tự động hóa trong ngành dược phẩm, hỗ trợ các tác vụ như:
- Phân loại dược phẩm: Tự động phân loại viên thuốc dựa trên kích thước, hình dạng hoặc màu sắc để nâng cao hiệu suất sản xuất.
- Nghiên cứu và phát triển AI: Làm benchmark để phát triển và kiểm thử thuật toán thị giác máy tính trong các trường hợp sử dụng thuộc lĩnh vực dược phẩm.
- Hệ thống quản lý kho kỹ thuật số: Hỗ trợ các giải pháp quản lý kho thông minh bằng cách tích hợp khả năng nhận diện viên thuốc tự động để theo dõi tồn kho theo thời gian thực và lập kế hoạch bổ sung hàng.
- Kiểm soát chất lượng: Đảm bảo tính đồng nhất trong quá trình sản xuất viên thuốc bằng cách nhận diện lỗi, bất thường hoặc nhiễm bẩn.
- Phát hiện thuốc giả: Hỗ trợ xác định các loại thuốc có khả năng bị làm giả bằng cách phân tích đặc điểm hình ảnh so với các tiêu chuẩn đã biết.
YAML của dataset#
Tệp medical-pills.yaml định nghĩa cấu hình dataset — các đường dẫn dataset, tên lớp và metadata khác. Tệp được duy trì trong kho lưu trữ Ultralytics tại https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/medical-pills.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Medical-pills dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/medical-pills
# Example usage: yolo train data=medical-pills.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── medical-pills ← downloads here (8.19 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: medical-pills # dataset root dir
train: images/train # train images (relative to 'path') 92 images
val: images/val # val images (relative to 'path') 23 images

# Classes
names:
  0: pill

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
Cách sử dụng#
Để huấn luyện model YOLO26n trên dataset Viên thuốc y tế trong 100 epoch với kích thước ảnh 640, hãy sử dụng các ví dụ sau. Để biết chi tiết về các đối số, hãy tham khảo trang Huấn luyện của model.
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")  # tải model đã huấn luyện trước (được khuyến nghị khi huấn luyện)

# Huấn luyện model
results = model.train(data="medical-pills.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Tải model
model = YOLO("path/to/best.pt") # Tải model đã tinh chỉnh
# Suy luận bằng model
results = model.predict("https://ultralytics.com/assets/medical-pills-sample.jpg")Hình ảnh mẫu và annotation#
Dataset Viên thuốc y tế có các ảnh được gán nhãn, thể hiện sự đa dạng của viên thuốc. Dưới đây là ví dụ về một batch huấn luyện ghép mosaic từ dataset:
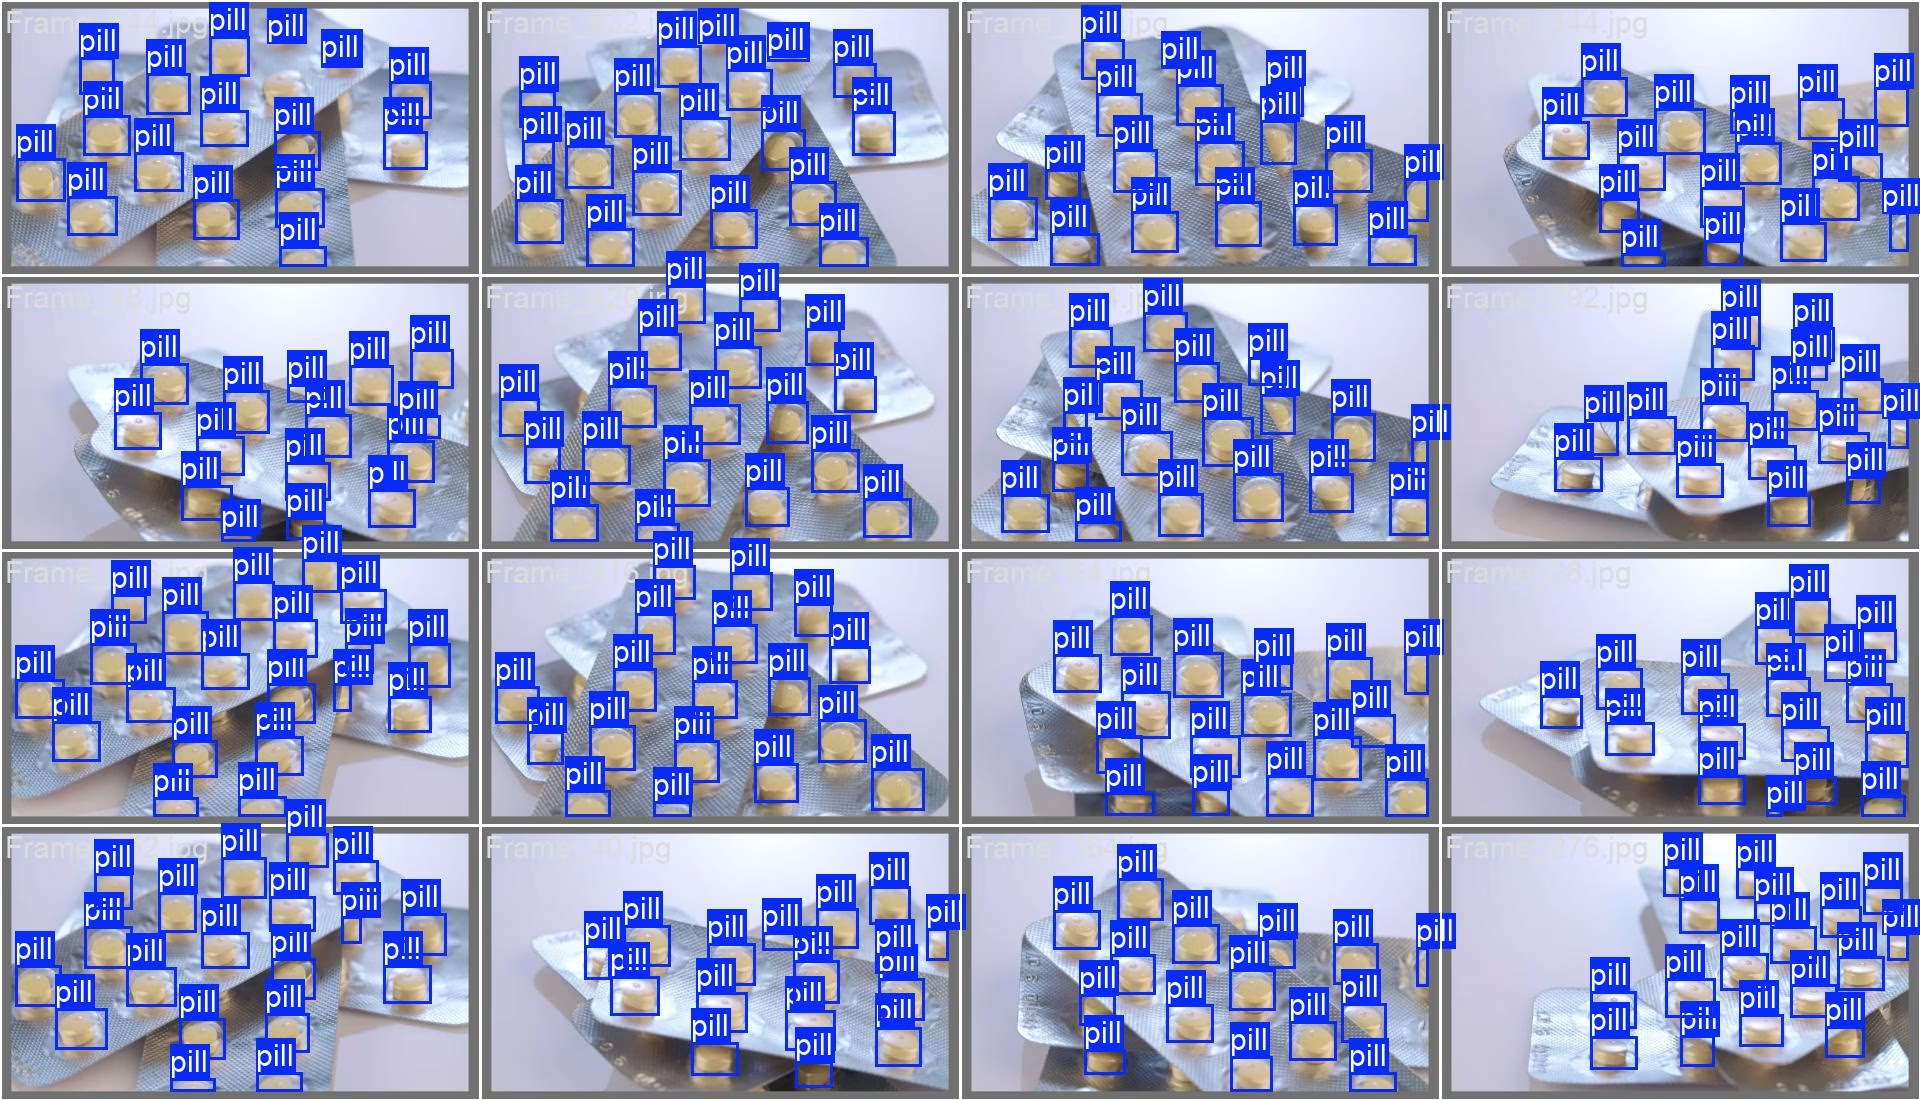
- Ảnh ghép dạng mosaic: Hình minh họa là một batch huấn luyện gồm các ảnh dataset được ghép dạng mosaic. Kỹ thuật mosaic tăng tính đa dạng trong huấn luyện bằng cách kết hợp nhiều ảnh thành một, giúp model tổng quát hóa tốt hơn.
Tích hợp với các dataset khác#
Để phân tích dược phẩm toàn diện hơn, hãy cân nhắc kết hợp dataset Medical Pills với các dataset liên quan khác như package-seg để nhận diện bao bì hoặc các dataset chẩn đoán hình ảnh y tế như brain-tumor nhằm phát triển các giải pháp AI y tế đầu cuối.
Trích dẫn và lời cảm ơn#
Dataset được cung cấp theo Giấy phép AGPL-3.0.
Nếu sử dụng dataset Medical Pills trong nghiên cứu hoặc phát triển, vui lòng trích dẫn theo thông tin được nêu:
@dataset{Jocher_Ultralytics_Datasets_2024,
    author = {Jocher, Glenn and Rizwan, Muhammad},
    license = {AGPL-3.0},
    month = {Dec},
    title = {Ultralytics Datasets: Medical-pills Detection Dataset},
    url = {https://docs.ultralytics.com/datasets/detect/medical-pills},
    version = {1.0.0},
    year = {2024}
}
Câu hỏi thường gặp#
Dataset Medical Pills có tổng cộng 115 ảnh — 92 ảnh dùng để huấn luyện và 23 ảnh dùng để validation — không có tập test riêng. Mỗi ảnh được gán nhãn cho một class duy nhất,
pill. Dataset được cung cấp dưới dạng gói tải xuống tự động 8.19 MB, được khai báo trong cấu hìnhmedical-pills.yaml.Bạn có thể huấn luyện model YOLO26 trong 100 epoch với kích thước ảnh 640px bằng các phương thức Python hoặc CLI được cung cấp. Tham khảo mục Ví dụ huấn luyện để xem hướng dẫn chi tiết và xem tài liệu YOLO26 để biết thêm về các khả năng của model.
Dataset hỗ trợ tự động hóa việc phát hiện viên thuốc, góp phần ngăn chặn hàng giả, đảm bảo chất lượng và tối ưu hóa quy trình dược phẩm. Dataset cũng là tài nguyên hữu ích để phát triển các giải pháp AI có thể cải thiện độ an toàn của thuốc và hiệu quả chuỗi cung ứng.
Có thể chạy inference bằng Python hoặc CLI với model YOLO26 đã fine-tune. Tham khảo mục Ví dụ inference để xem các đoạn mã và tài liệu chế độ Predict để biết thêm tùy chọn.
File YAML có tại medical-pills.yaml, chứa các đường dẫn dataset, class và thông tin cấu hình bổ sung cần thiết để huấn luyện model trên dataset này.