Hướng dẫn bắt đầu nhanh: NVIDIA DGX Spark với Ultralytics YOLO26
Hướng dẫn này trình bày cách triển khai Ultralytics YOLO26 trên NVIDIA DGX Spark, siêu máy tính AI để bàn nhỏ gọn của NVIDIA, đồng thời bao gồm benchmark YOLO11 trên hệ thống này với nhiều định dạng export.
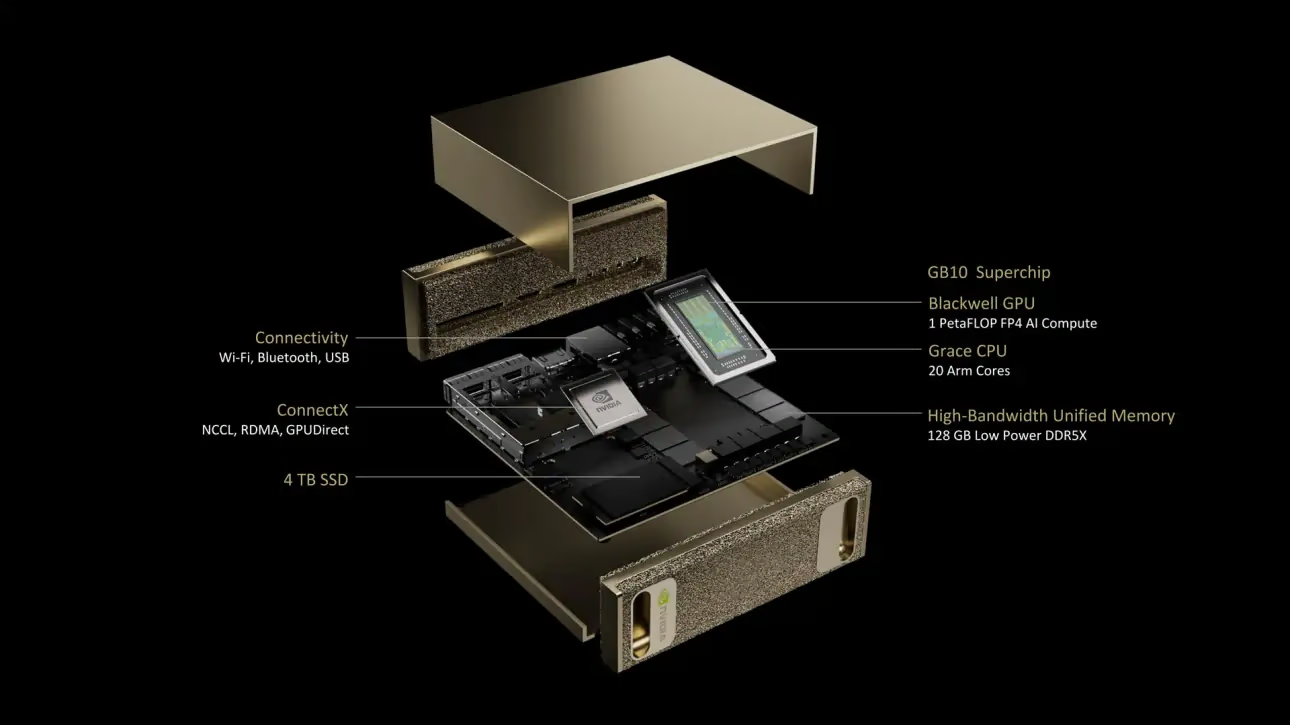
Hướng dẫn này đã được kiểm thử trên NVIDIA DGX Spark Founders Edition chạy DGX OS dựa trên Ubuntu. Hướng dẫn dự kiến cũng hoạt động với các bản phát hành DGX OS mới nhất.
NVIDIA DGX Spark là gì?#
NVIDIA DGX Spark là siêu máy tính AI để bàn nhỏ gọn, sử dụng NVIDIA GB10 Grace Blackwell Superchip. Thiết bị cung cấp hiệu năng tính toán AI lên đến 1 petaFLOP với độ chính xác FP4, được thiết kế cho các nhà phát triển, nhà nghiên cứu và nhà khoa học dữ liệu cần năng lực AI mạnh mẽ trong một thiết bị để bàn.
Xem: Cách đạt tới 1000 FPS với Ultralytics YOLO26 trên NVIDIA DGX Spark | TensorRT và suy luận theo batch
Thông số kỹ thuật chính#
| Thông số kỹ thuật | Chi tiết |
|---|---|
| Hiệu năng AI | Lên đến 1 PFLOP (FP4) |
| GPU | Kiến trúc NVIDIA Blackwell với Tensor Core thế hệ thứ 5 và RT Core thế hệ thứ 4 |
| CPU | Bộ xử lý Arm 20 lõi (10 Cortex-X925 + 10 Cortex-A725) |
| Bộ nhớ | Bộ nhớ hệ thống hợp nhất LPDDR5x 128 GB, giao tiếp 256-bit, 4266 MHz, băng thông 273 GB/s |
| Lưu trữ | NVMe M.2 1 TB hoặc 4 TB có tính năng tự mã hóa |
| Mạng | 1x RJ-45 (10 GbE), Smart NIC ConnectX-7, Wi-Fi 7, Bluetooth 5.4 |
| Kết nối | 4x USB Type-C, 1x HDMI 2.1a, âm thanh đa kênh HDMI |
| Xử lý video | 1x NVENC, 1x NVDEC |
DGX OS#
NVIDIA DGX OS là bản phân phối Linux tùy chỉnh, cung cấp nền tảng hệ điều hành ổn định, đã được kiểm thử và hỗ trợ để chạy các ứng dụng AI, machine learning và phân tích trên hệ thống DGX. Bản phân phối này bao gồm:
- Nền tảng Linux mạnh mẽ được tối ưu hóa cho workload AI
- Driver và cài đặt hệ thống được cấu hình sẵn cho phần cứng NVIDIA
- Các bản cập nhật bảo mật và khả năng bảo trì hệ thống
- Khả năng tương thích với hệ sinh thái phần mềm NVIDIA rộng lớn hơn
DGX OS tuân theo lịch phát hành định kỳ, thường cung cấp bản cập nhật hai lần mỗi năm (khoảng tháng 2 và tháng 8), cùng các bản vá bảo mật bổ sung giữa những lần phát hành chính.
DGX Dashboard#
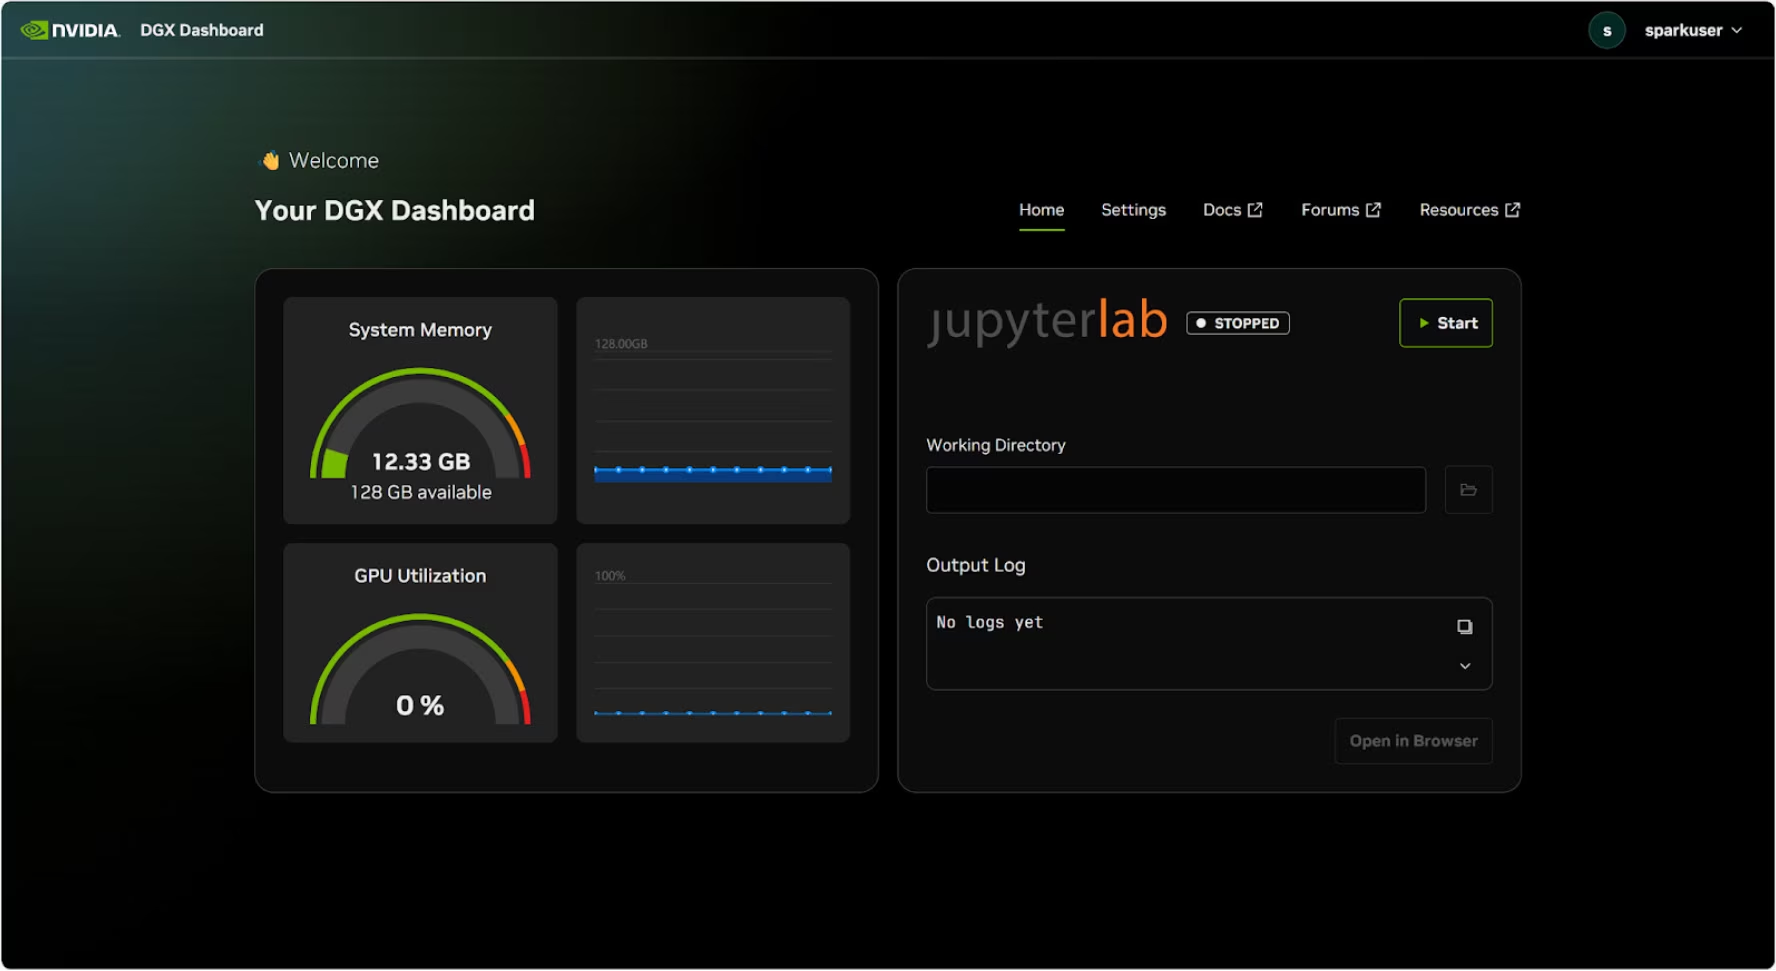
DGX Spark tích hợp sẵn DGX Dashboard, cung cấp:
- Giám sát hệ thống theo thời gian thực: Tổng quan về các chỉ số vận hành hiện tại của hệ thống
- Cập nhật hệ thống: Khả năng áp dụng bản cập nhật trực tiếp từ dashboard
- Cài đặt hệ thống: Thay đổi tên thiết bị và các cấu hình khác
- JupyterLab tích hợp: Truy cập Jupyter Notebook cục bộ để phát triển
Truy cập Dashboard#
Nhấp vào nút "Show Apps" ở góc dưới bên trái màn hình Ubuntu, sau đó chọn "DGX Dashboard" để mở dashboard trong trình duyệt.
Dashboard bao gồm một phiên bản JupyterLab tích hợp, tự động tạo môi trường ảo và cài đặt các package được đề xuất khi khởi chạy. Mỗi tài khoản người dùng được cấp một cổng riêng để truy cập JupyterLab.
Bắt đầu nhanh với Docker#
Cách nhanh nhất để bắt đầu sử dụng Ultralytics YOLO26 trên NVIDIA DGX Spark là chạy các image Docker dựng sẵn. Image NVIDIA ARM64 hỗ trợ DGX Spark chạy DGX OS.
t=ultralytics/ultralytics:latest-nvidia-arm64
sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all $t
Yêu cầu thiết bị CDI ở trên áp dụng cho DGX Spark chạy DGX OS. Đối với workload PyTorch trên Jetson AGX Thor, hãy xem các yêu cầu riêng của host và giới hạn TensorRT trong hướng dẫn NVIDIA Jetson.
Image này sử dụng NVIDIA PyTorch 26.10, CUDA 13.4 và TensorRT 11.4. Cập nhật driver trên host DGX OS lên phiên bản được NVIDIA PyTorch 26.10 hỗ trợ, và build lại engine TensorRT sau khi thay đổi image hoặc GPU mục tiêu.
Sau khi hoàn tất, chuyển đến phần Sử dụng TensorRT trên NVIDIA DGX Spark.
Bắt đầu với cài đặt gốc#
Để cài đặt native không dùng Docker, hãy làm theo các bước sau.
Cài đặt package Ultralytics#
Ở đây, chúng ta sẽ cài đặt package Ultralytics trên DGX Spark. Các dependency phục vụ export sẽ được tự động cài đặt trong lần đầu export model, vì vậy ở đây chỉ cần package cơ bản. Hướng dẫn này tập trung vào export NVIDIA TensorRT vì TensorRT mang lại hiệu năng cao nhất trên DGX Spark.
-
Cập nhật danh sách package, cài đặt pip và nâng cấp lên phiên bản mới nhất
sudo apt update sudo apt install python3-pip -y pip install -U pip -
Cài đặt package pip
ultralyticspip install ultralytics -
Khởi động lại thiết bị
sudo reboot
Cài đặt PyTorch và Torchvision#
Lệnh cài đặt ultralytics ở trên sẽ cài PyTorch và Torchvision. Tuy nhiên, các package cài qua pip này có thể chưa được tối ưu hoàn toàn cho kiến trúc ARM64 với CUDA 13 của DGX Spark. Vì vậy, chúng tôi khuyến nghị cài các phiên bản tương thích với CUDA 13:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130Khi chạy PyTorch 2.9.1 trên NVIDIA DGX Spark, bạn có thể gặp UserWarning sau đây khi khởi tạo CUDA (ví dụ: chạy yolo checks, yolo predict, v.v.):
UserWarning: Found GPU0 NVIDIA GB10 which is of cuda capability 12.1.
Minimum and Maximum cuda capability supported by this version of PyTorch is (8.0) - (12.0)
Có thể bỏ qua cảnh báo này một cách an toàn.
Cài đặt onnxruntime-gpu#
Các bản phát hành ONNX Runtime GPU hiện tại cung cấp wheel Linux ARM64, bao gồm cả Python 3.12. Image NVIDIA ARM64 Docker cài đặt package chính thức; đối với cài đặt native CUDA 13, hãy dùng:
pip install onnxruntime-gpuSử dụng TensorRT trên NVIDIA DGX Spark#
Trong tất cả định dạng export model được Ultralytics hỗ trợ, TensorRT mang lại hiệu năng suy luận cao nhất trên NVIDIA DGX Spark, nên là lựa chọn hàng đầu của chúng tôi khi triển khai.
Chuyển đổi model sang TensorRT và chạy inference#
Model PyTorch YOLO26n được chuyển đổi sang TensorRT, sau đó model đã export được dùng để suy luận.
from ultralytics import YOLO

# Tải model YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Xuất model sang TensorRT FP16
model.export(format="engine", quantize=16)  # # tạo 'yolo26n.engine'

# Tải model TensorRT đã export
trt_model = YOLO("yolo26n.engine")

# Chạy suy luận
results = trt_model("https://ultralytics.com/images/bus.jpg")
Benchmark YOLO11 trên NVIDIA DGX Spark#
Nhóm Ultralytics đã benchmark YOLO11 trên nhiều định dạng model, đo tốc độ và độ chính xác: PyTorch, TorchScript, ONNX, OpenVINO, TensorRT, TF SavedModel, TF GraphDef, TF Lite, MNN, NCNN, ExecuTorch. Các benchmark được chạy trên NVIDIA DGX Spark với độ chính xác FP32 và kích thước ảnh đầu vào mặc định là 640.
Bảng so sánh chi tiết#
Bảng dưới đây trình bày kết quả benchmark của năm model khác nhau (YOLO11n, YOLO11s, YOLO11m, YOLO11l, YOLO11x) trên nhiều định dạng, bao gồm trạng thái, kích thước, metric mAP50-95(B) và thời gian suy luận cho từng tổ hợp.
| Định dạng | Trạng thái | Dung lượng trên ổ đĩa (MB) | mAP50-95(B) | Thời gian suy luận (ms/ảnh) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.4 | 0.5071 | 2.67 |
| TorchScript | ✅ | 10.5 | 0.5083 | 2.62 |
| ONNX | ✅ | 10.2 | 0.5074 | 5.92 |
| OpenVINO | ✅ | 10.4 | 0.5058 | 14.95 |
| TensorRT (FP32) | ✅ | 12.8 | 0.5085 | 1.95 |
| TensorRT (FP16) | ✅ | 7.0 | 0.5068 | 1.01 |
| TensorRT (INT8) | ✅ | 18.6 | 0.4880 | 1.62 |
| TF SavedModel | ✅ | 25.7 | 0.5076 | 36.39 |
| TF GraphDef | ✅ | 10.3 | 0.5076 | 41.06 |
| TF Lite | ✅ | 10.3 | 0.5075 | 64.36 |
| MNN | ✅ | 10.1 | 0.5075 | 12.14 |
| NCNN | ✅ | 10.2 | 0.5041 | 12.31 |
| ExecuTorch | ✅ | 10.2 | 0.5075 | 27.61 |
Được benchmark bằng Ultralytics 8.3.249
Tái tạo kết quả của chúng tôi#
Để tái tạo các benchmark Ultralytics ở trên trên tất cả định dạng export, hãy chạy đoạn mã sau:
from ultralytics import YOLO

# Tải model YOLO26n PyTorch
model = YOLO("yolo26n.pt")

# Benchmark tốc độ và độ chính xác của YOLO26n trên tập dữ liệu COCO128 cho tất cả định dạng xuất
results = model.benchmark(data="coco128.yaml", imgsz=640)
Lưu ý rằng kết quả benchmark có thể thay đổi tùy theo cấu hình phần cứng và phần mềm cụ thể của hệ thống, cũng như khối lượng công việc hiện tại của hệ thống tại thời điểm chạy benchmark. Để có kết quả đáng tin cậy nhất, hãy sử dụng tập dữ liệu có nhiều ảnh, ví dụ: data='coco.yaml' (5000 ảnh val).
Độ chính xác TensorRT của YOLO26 trên DGX Spark#
Ở batch size 1 trên DGX Spark, TensorRT INT8 chậm hơn FP16 đối với YOLO26n và YOLO26s, và có tốc độ gần như tương đương đối với YOLO26m (chênh lệch trong phạm vi 2% ở cả thời gian xác thực lẫn thời gian tính toán GPU trong trtexec). INT8 cũng làm giảm 1,1 đến 1,8 mAP, vì vậy FP16 là lựa chọn tốt hơn cho các model này. Bảng YOLO11 ở trên cho thấy cùng xu hướng: TensorRT (INT8) chậm hơn TensorRT (FP16) ở cả năm model.
| Model | Định dạng | Dung lượng trên ổ đĩa (MB) | mAP50-95(B) | Thời gian suy luận (ms/ảnh) |
|---|---|---|---|---|
| YOLO26n | TensorRT (FP16) | 6.7 | 0.4032 | 0.79 |
| YOLO26n | TensorRT (INT8) | 28.4 | 0.3849 | 1.43 |
| YOLO26s | TensorRT (FP16) | 20.3 | 0.4793 | 1.49 |
| YOLO26s | TensorRT (INT8) | 34.4 | 0.4644 | 1.73 |
| YOLO26m | TensorRT (FP16) | 41.1 | 0.5266 | 2.70 |
| YOLO26m | TensorRT (INT8) | 45.0 | 0.5156 | 2.74 |
Độ chính xác và tốc độ được đo qua quá trình xác thực trên COCO val2017 (5000 ảnh), với kích thước ảnh 640 và batch size 1. Các engine INT8 được hiệu chuẩn trên COCO128. Đánh giá hiệu năng được thực hiện bằng Ultralytics 8.4.192 trong ultralytics/ultralytics:latest-nvidia-arm64 (NVIDIA PyTorch 26.08, TensorRT 11.2.1.2, ModelOpt 0.45.0).
Các phương pháp hay nhất cho NVIDIA DGX Spark#
Khi sử dụng NVIDIA DGX Spark, hãy áp dụng các phương pháp tối ưu sau để đạt hiệu năng tốt nhất khi chạy YOLO26.
-
Giám sát hiệu năng hệ thống
Sử dụng các công cụ giám sát của NVIDIA để theo dõi mức sử dụng GPU và CPU:
nvidia-smi -
Tối ưu hóa mức sử dụng bộ nhớ
Với bộ nhớ hợp nhất 128 GB, DGX Spark có thể xử lý batch size và model lớn. Hãy cân nhắc tăng batch size để cải thiện thông lượng:
from ultralytics import YOLO model = YOLO("yolo26n.engine") results = model.predict(source="path/to/images", batch=16) -
Sử dụng TensorRT FP16
Ở batch size 1 trên DGX Spark, INT8 chậm hơn FP16 đối với YOLO26n và YOLO26s, không nhanh hơn đối với YOLO26m và có độ chính xác thấp hơn (xem Độ chính xác TensorRT của YOLO26 trên DGX Spark):
yolo export model=yolo26n.pt format=engine quantize=16 # FP16
Cập nhật hệ thống (Founders Edition)#
Việc cập nhật DGX Spark Founders Edition là điều thiết yếu để đảm bảo hiệu năng và bảo mật. NVIDIA cung cấp hai phương thức chính để cập nhật hệ điều hành, driver và firmware của hệ thống.
Sử dụng DGX Dashboard (Khuyến nghị)#
DGX Dashboard là phương thức được khuyến nghị để cập nhật hệ thống, đảm bảo khả năng tương thích. Công cụ này cho phép bạn:
- Xem các bản cập nhật hệ thống hiện có
- Cài đặt bản vá bảo mật và bản cập nhật hệ thống
- Quản lý các bản cập nhật driver và firmware NVIDIA
Cập nhật hệ thống thủ công#
Người dùng nâng cao có thể cập nhật thủ công qua terminal:
sudo apt update
sudo apt dist-upgrade
sudo fwupdmgr refresh
sudo fwupdmgr upgrade
sudo rebootTrước khi cập nhật, hãy đảm bảo hệ thống được kết nối với nguồn điện ổn định và bạn đã sao lưu dữ liệu quan trọng.
Các bước tiếp theo#
Để tìm hiểu thêm và nhận hỗ trợ, hãy xem Tài liệu Ultralytics YOLO26.
Câu hỏi thường gặp#
Việc triển khai Ultralytics YOLO26 trên NVIDIA DGX Spark rất đơn giản. Bạn có thể dùng Docker image dựng sẵn để thiết lập nhanh hoặc tự cài đặt các package cần thiết. Hướng dẫn chi tiết cho từng phương thức có trong các phần Bắt đầu nhanh với Docker và Bắt đầu với cài đặt native.
Các model YOLO chạy nhanh trên DGX Spark nhờ GB10 Grace Blackwell Superchip. Định dạng TensorRT mang lại hiệu năng suy luận tốt nhất. Xem mục Bảng so sánh chi tiết để biết kết quả benchmark YOLO11 trên DGX Spark với nhiều kích thước và định dạng model khác nhau, và mục Độ chính xác TensorRT của YOLO26 trên DGX Spark để xem kết quả YOLO26 FP16 và INT8.
TensorRT được khuyến nghị để triển khai model YOLO26 trên DGX Spark vì cung cấp tốc độ suy luận nhanh nhất trong các định dạng xuất được hỗ trợ, sử dụng Tensor Core của GPU Blackwell với độ chính xác FP16 hoặc INT8.
DGX Spark cung cấp hiệu năng AI lên đến 1 PFLOP và bộ nhớ hợp nhất 128 GB, trong khi Jetson AGX Thor có hiệu năng 2070 TFLOPS và bộ nhớ 128 GB. DGX Spark được thiết kế như một siêu máy tính AI để bàn, còn thiết bị Jetson là các hệ thống nhúng được tối ưu cho triển khai ở biên.
Đối với workload PyTorch,
ultralytics/ultralytics:latest-nvidia-arm64hỗ trợ DGX Spark với DGX OS và Thor với JetPack 7.1. TensorRT 11.4 đi kèm không hỗ trợ JetPack, vì vậy các workflow TensorRT trên Jetson phải sử dụng runtime TensorRT 10.x được hỗ trợ trong bản JetPack tương ứng. Xem yêu cầu Docker cho Jetson.


Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.