Tối ưu inference OpenVINO cho YOLO#
Giới thiệu#
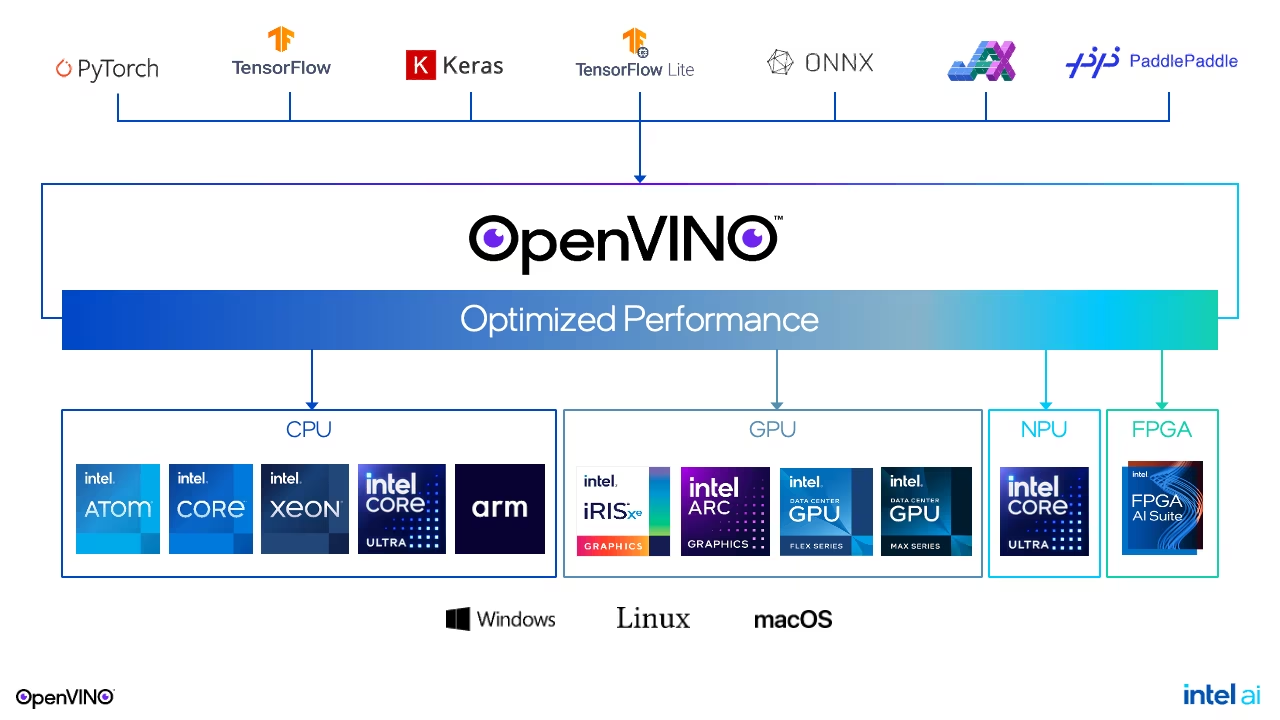
Khi triển khai các model deep learning, đặc biệt là những model dùng cho phát hiện đối tượng như các model Ultralytics YOLO, việc đạt được hiệu suất tối ưu là rất quan trọng. Hướng dẫn này đi sâu vào việc khai thác bộ công cụ OpenVINO của Intel để tối ưu inference, tập trung vào độ trễ và thông lượng. Dù bạn đang phát triển ứng dụng cấp người tiêu dùng hay triển khai trên quy mô lớn, việc hiểu và áp dụng các chiến lược tối ưu này sẽ giúp model chạy hiệu quả trên nhiều thiết bị khác nhau.
Tối ưu độ trễ#
Tối ưu độ trễ là yếu tố thiết yếu đối với các ứng dụng cần phản hồi tức thì từ một model duy nhất với một đầu vào, thường gặp trong các tình huống hướng đến người tiêu dùng. Mục tiêu là giảm thiểu thời gian từ lúc nhận đầu vào đến khi có kết quả inference. Tuy nhiên, để đạt độ trễ thấp cần cân nhắc kỹ lưỡng, nhất là khi chạy inference đồng thời hoặc quản lý nhiều model.
Các chiến lược chính để tối ưu độ trễ#
- Một inference trên mỗi thiết bị: Cách đơn giản nhất để đạt độ trễ thấp là giới hạn mỗi thiết bị chỉ chạy một inference tại một thời điểm. Việc tăng mức độ đồng thời thường làm độ trễ tăng lên.
- Khai thác các thiết bị con: Các thiết bị như CPU đa socket hoặc GPU đa tile có thể xử lý nhiều yêu cầu với mức tăng độ trễ tối thiểu bằng cách tận dụng các thiết bị con bên trong.
- Gợi ý hiệu suất OpenVINO: Sử dụng
ov::LATENCYcủa OpenVINO cho thuộc tínhov::performance_modetrong quá trình biên dịch model giúp đơn giản hóa việc tinh chỉnh hiệu suất, đồng thời mang đến phương pháp không phụ thuộc thiết bị và phù hợp cho tương lai.
Quản lý độ trễ của lần inference đầu tiên#
- Caching model: Để giảm ảnh hưởng của thời gian tải và biên dịch model đến độ trễ, hãy sử dụng caching model khi có thể. Trong những tình huống không thể caching, CPU thường cho thời gian tải model nhanh nhất.
- Ánh xạ model và đọc model: Để rút ngắn thời gian tải, OpenVINO đã thay thế việc đọc model bằng ánh xạ model. Tuy nhiên, nếu model nằm trên ổ đĩa di động hoặc ổ đĩa mạng, hãy cân nhắc dùng
ov::enable_mmap(false)để chuyển lại sang chế độ đọc. - Tự động chọn thiết bị: Chế độ này bắt đầu inference trên CPU rồi chuyển sang accelerator khi sẵn sàng, giúp giảm độ trễ của lần inference đầu tiên một cách liền mạch.
Tối ưu thông lượng#
Tối ưu thông lượng là yếu tố quan trọng trong các tình huống xử lý đồng thời nhiều yêu cầu inference, nhằm tối đa hóa mức sử dụng tài nguyên mà không làm giảm đáng kể hiệu suất của từng yêu cầu.
Các phương pháp tối ưu thông lượng#
-
Gợi ý hiệu suất OpenVINO: Phương pháp cấp cao, phù hợp cho tương lai để cải thiện thông lượng trên nhiều thiết bị bằng cách sử dụng các gợi ý hiệu suất.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Batching tường minh và luồng: Phương pháp chi tiết hơn, bao gồm batching tường minh và sử dụng các luồng để tinh chỉnh hiệu suất nâng cao.
Thiết kế ứng dụng hướng đến thông lượng#
Để tối đa hóa thông lượng, ứng dụng nên:
- Xử lý đầu vào song song, tận dụng tối đa khả năng của thiết bị.
- Phân rã luồng dữ liệu thành các yêu cầu inference đồng thời, được lập lịch để thực thi song song.
- Sử dụng Async API cùng callback để duy trì hiệu suất và tránh tình trạng thiết bị không được khai thác.
Thực thi trên nhiều thiết bị#
Chế độ đa thiết bị của OpenVINO giúp đơn giản hóa việc mở rộng thông lượng bằng cách tự động cân bằng các yêu cầu inference trên nhiều thiết bị mà không cần quản lý thiết bị ở cấp ứng dụng.
Cải thiện hiệu suất trong thực tế#
Triển khai các tối ưu hóa OpenVINO với model Ultralytics YOLO có thể mang lại cải thiện hiệu suất đáng kể. Như được minh họa trong các benchmark, người dùng có thể đạt tốc độ inference nhanh hơn tới 3 lần trên CPU Intel, và mức tăng tốc còn lớn hơn trên toàn bộ dải phần cứng Intel, bao gồm GPU tích hợp, GPU rời và NPU.
Ví dụ, khi chạy model YOLO26 trên CPU Intel Xeon, các phiên bản được tối ưu bằng OpenVINO luôn có thời gian inference trên mỗi ảnh nhanh hơn các phiên bản PyTorch tương ứng mà không ảnh hưởng đến độ chính xác.
Triển khai thực tế#
Để export và tối ưu model Ultralytics YOLO cho OpenVINO, bạn có thể dùng chức năng export:
from ultralytics import YOLO

# Tải model
model = YOLO("yolo26n.pt")

# Export model sang định dạng OpenVINO
model.export(format="openvino", quantize=16)  # Export với độ chính xác FP16
Sau khi export, bạn có thể chạy inference bằng model đã tối ưu:
# Tải model OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Chạy inference (Ultralytics biên dịch model OpenVINO với gợi ý hiệu suất LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)
Kết luận#
Tối ưu model Ultralytics YOLO cho độ trễ và thông lượng bằng OpenVINO có thể cải thiện đáng kể hiệu suất ứng dụng của bạn. Bằng cách áp dụng cẩn thận các chiến lược được nêu trong hướng dẫn này, nhà phát triển có thể đảm bảo model chạy hiệu quả và đáp ứng yêu cầu của nhiều tình huống triển khai. Hãy nhớ rằng lựa chọn tối ưu độ trễ hay thông lượng phụ thuộc vào nhu cầu cụ thể của ứng dụng và đặc điểm của môi trường triển khai.
Để biết thêm thông tin kỹ thuật chi tiết và các cập nhật mới nhất, hãy tham khảo tài liệu OpenVINO và repository Ultralytics YOLO. Các tài nguyên này cung cấp hướng dẫn chuyên sâu, bài hướng dẫn và hỗ trợ cộng đồng để giúp bạn khai thác tối đa các model deep learning.
Đảm bảo model đạt hiệu suất tối ưu không chỉ là điều chỉnh cấu hình; điều quan trọng là hiểu nhu cầu của ứng dụng và đưa ra quyết định dựa trên thông tin đầy đủ. Dù bạn đang tối ưu cho phản hồi thời gian thực hay tối đa hóa thông lượng cho xử lý quy mô lớn, sự kết hợp giữa model Ultralytics YOLO và OpenVINO mang đến bộ công cụ mạnh mẽ để nhà phát triển triển khai các giải pháp AI hiệu suất cao.
Câu hỏi thường gặp#
Tối ưu model Ultralytics YOLO để đạt độ trễ thấp đòi hỏi một số chiến lược chính:
- Một inference trên mỗi thiết bị: Giới hạn mỗi thiết bị chỉ chạy một inference tại một thời điểm để giảm thiểu độ trễ.
- Khai thác các thiết bị con: Tận dụng các thiết bị như CPU đa socket hoặc GPU đa tile, vốn có thể xử lý nhiều yêu cầu với mức tăng độ trễ tối thiểu.
- Gợi ý hiệu suất OpenVINO: Sử dụng
ov::LATENCYcủa OpenVINO trong quá trình biên dịch model để tinh chỉnh đơn giản, không phụ thuộc thiết bị.
Để biết thêm mẹo thực tiễn về tối ưu độ trễ, hãy xem mục Tối ưu độ trễ trong hướng dẫn của chúng tôi.
OpenVINO cải thiện thông lượng của model Ultralytics YOLO bằng cách tối đa hóa mức sử dụng tài nguyên thiết bị mà không làm giảm hiệu suất. Các lợi ích chính gồm:
- Gợi ý hiệu suất: Tinh chỉnh hiệu suất đơn giản, cấp cao trên nhiều thiết bị.
- Batching tường minh và luồng: Tinh chỉnh để đạt hiệu suất nâng cao.
- Thực thi trên nhiều thiết bị: Tự động cân bằng tải inference, giảm gánh nặng quản lý ở cấp ứng dụng.
Cấu hình mẫu:
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Tìm hiểu thêm về tối ưu thông lượng trong mục Tối ưu thông lượng của hướng dẫn chi tiết.
Để giảm độ trễ của lần inference đầu tiên, hãy cân nhắc các phương pháp sau:
- Caching model: Sử dụng caching model để rút ngắn thời gian tải và biên dịch.
- Ánh xạ model và đọc model: Mặc định, hãy dùng phương thức ánh xạ (
ov::enable_mmap(true)), nhưng chuyển sang phương thức đọc (ov::enable_mmap(false)) nếu model nằm trên ổ đĩa di động hoặc ổ đĩa mạng. - Tự động chọn thiết bị: Sử dụng chế độ AUTO để bắt đầu inference trên CPU rồi chuyển liền mạch sang accelerator.
Để xem các chiến lược chi tiết nhằm quản lý độ trễ của lần inference đầu tiên, hãy tham khảo mục Quản lý độ trễ của lần inference đầu tiên.
Để cân bằng việc tối ưu độ trễ và thông lượng, cần hiểu rõ nhu cầu của ứng dụng:
- Tối ưu độ trễ: Phù hợp nhất với các ứng dụng thời gian thực cần phản hồi tức thì (ví dụ: ứng dụng dành cho người tiêu dùng).
- Tối ưu thông lượng: Phù hợp nhất với các tình huống có nhiều inference đồng thời, nhằm tối đa hóa mức sử dụng tài nguyên (ví dụ: triển khai quy mô lớn).
Sử dụng các gợi ý hiệu suất cấp cao và chế độ đa thiết bị của OpenVINO có thể giúp đạt được sự cân bằng phù hợp. Hãy chọn gợi ý hiệu suất OpenVINO thích hợp dựa trên các yêu cầu cụ thể của bạn.
Có, model Ultralytics YOLO rất linh hoạt và có thể tích hợp với nhiều framework AI. Các lựa chọn gồm:
- TensorRT: Để tối ưu cho GPU NVIDIA, hãy làm theo hướng dẫn tích hợp TensorRT.
- CoreML: Đối với thiết bị Apple, hãy tham khảo hướng dẫn export CoreML của chúng tôi.
- LiteRT.js: Đối với ứng dụng web và Node.js, hãy xem hướng dẫn tích hợp LiteRT và runtime web LiteRT.js.
Khám phá thêm các tích hợp trên trang Tích hợp Ultralytics.