Hướng dẫn từng bước huấn luyện model YOLO26 với IBM Watsonx
Giải pháp thị giác máy tính có khả năng mở rộng cần cơ sở hạ tầng cho dữ liệu, huấn luyện và triển khai. IBM Watsonx là nền tảng AI và dữ liệu hỗ trợ phát triển, triển khai và quản lý model AI. Nền tảng này bao quát toàn bộ vòng đời AI và tích hợp với các dịch vụ IBM Cloud.
Bạn có thể huấn luyện model Ultralytics YOLO26 bằng IBM Watsonx. Đây là lựa chọn phù hợp cho doanh nghiệp quan tâm đến huấn luyện model hiệu quả, tinh chỉnh cho các tác vụ cụ thể và cải thiện hiệu suất model bằng các công cụ mạnh mẽ cùng thiết lập thân thiện với người dùng. Hướng dẫn này trình bày cách huấn luyện YOLO26 bằng IBM Watsonx, từ thiết lập môi trường đến đánh giá model đã huấn luyện.
IBM Watsonx là gì?#
Watsonx là nền tảng đám mây của IBM được thiết kế cho generative AI thương mại và dữ liệu khoa học. Ba thành phần của IBM Watsonx — watsonx.ai, watsonx.data và watsonx.governance — kết hợp tạo thành một nền tảng AI đầu-cuối đáng tin cậy, có thể thúc đẩy các dự án AI nhằm giải quyết vấn đề kinh doanh. Nền tảng này cung cấp công cụ xây dựng, huấn luyện và triển khai model machine learning, đồng thời giúp dễ dàng kết nối với nhiều nguồn dữ liệu.
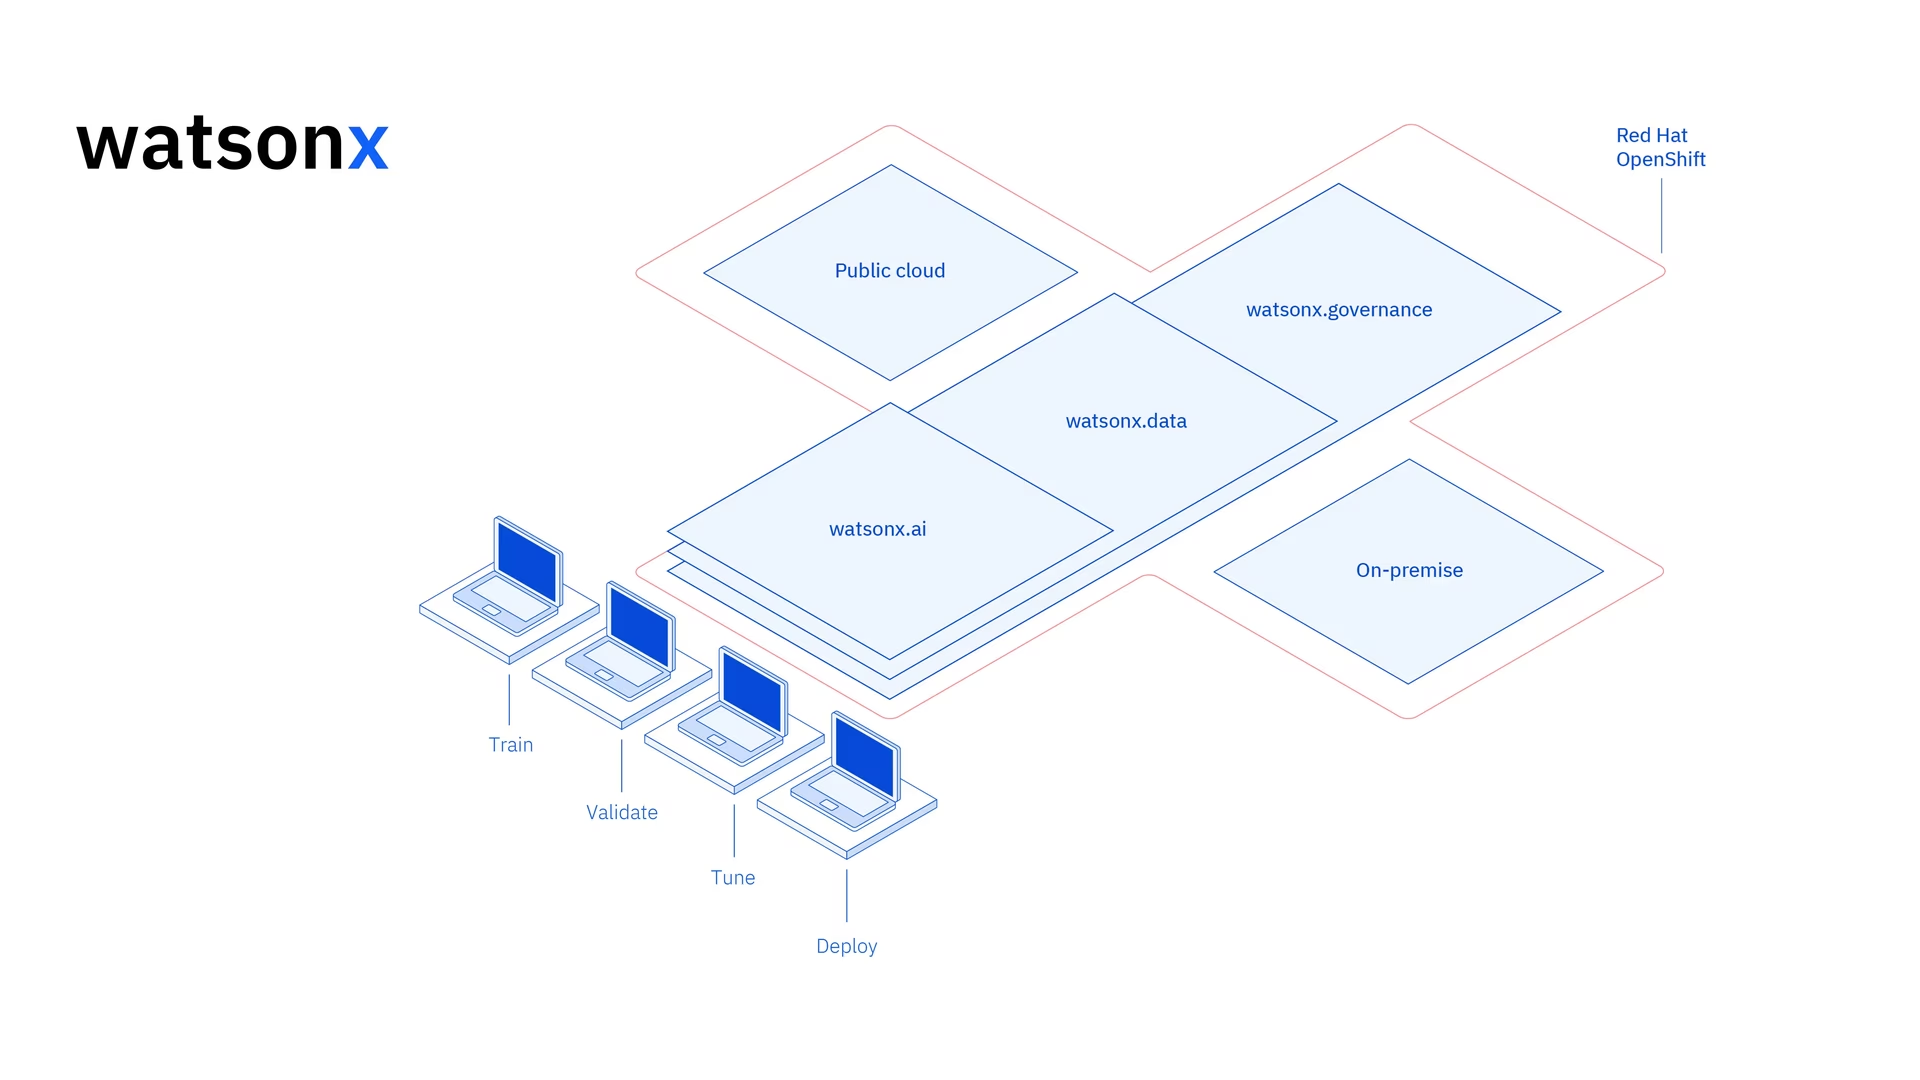
Giao diện và các tính năng cộng tác của nền tảng hỗ trợ phát triển, quản lý và triển khai model. IBM Watsonx phục vụ các ứng dụng thị giác máy tính, phân tích dự đoán, xử lý ngôn ngữ tự nhiên và các ứng dụng AI khác.
Các tính năng chính của IBM Watsonx#
IBM Watsonx gồm ba thành phần chính: watsonx.ai, watsonx.data và watsonx.governance. Mỗi thành phần phụ trách một khía cạnh khác nhau của AI và quản lý dữ liệu.
Watsonx.ai#
Watsonx.ai cung cấp các công cụ phát triển AI và quyền truy cập vào model tùy chỉnh do IBM hỗ trợ, model bên thứ ba như Llama 3 và các model Granite của IBM. Nền tảng này bao gồm Prompt Lab để thử nghiệm prompt AI và Tuning Studio để cải thiện hiệu suất model bằng dữ liệu đã gán nhãn. Ngoài ra, nền tảng còn cung cấp các công cụ toàn diện để tự động hóa vòng đời model AI và kết nối với nhiều API, thư viện.
Watsonx.data#
Watsonx.data hỗ trợ triển khai trên cloud và tại chỗ. Console thân thiện với người dùng cung cấp quyền truy cập tập trung vào dữ liệu giữa các môi trường và giúp khám phá dữ liệu dễ dàng bằng SQL phổ biến. Nền tảng tối ưu workload bằng các query engine hiệu quả như Presto và Spark, tăng tốc khả năng khai thác thông tin dữ liệu bằng lớp ngữ nghĩa ứng dụng AI, tích hợp vector database để tăng mức độ liên quan cho AI và hỗ trợ các định dạng dữ liệu mở nhằm dễ dàng chia sẻ dữ liệu phân tích và AI.
Watsonx.governance#
Watsonx.governance giúp việc tuân thủ trở nên dễ dàng hơn bằng cách tự động xác định các thay đổi về quy định và thực thi chính sách. Nền tảng này liên kết các yêu cầu với dữ liệu rủi ro nội bộ và cung cấp các bảng thông tin AI cập nhật. Nền tảng giúp quản lý rủi ro bằng cảnh báo và công cụ phát hiện các vấn đề như thiên lệch và độ trôi. Nền tảng cũng tự động hóa việc giám sát và lập tài liệu về vòng đời AI, tổ chức hoạt động phát triển AI bằng danh mục model, đồng thời tăng cường cộng tác với bảng điều khiển và công cụ báo cáo thân thiện với người dùng.
Cách huấn luyện YOLO26 bằng IBM Watsonx#
Bạn có thể dùng IBM Watsonx để đẩy nhanh quy trình huấn luyện model YOLO26.
Điều kiện tiên quyết#
Bạn cần có tài khoản IBM Cloud để tạo dự án watsonx.ai và cũng cần có tài khoản Kaggle để tải tập dữ liệu.
Bước 1: Thiết lập môi trường#
Trước tiên, bạn cần thiết lập tài khoản IBM để sử dụng Jupyter Notebook. Đăng nhập vào watsonx.ai bằng tài khoản IBM Cloud của bạn.
Sau đó, tạo một dự án watsonx.ai và một Jupyter Notebook.
Sau khi thực hiện bước này, môi trường notebook sẽ mở ra để bạn tải tập dữ liệu. Bạn có thể sử dụng mã trong hướng dẫn này để huấn luyện một model phát hiện đối tượng đơn giản.
Bước 2: Cài đặt và import các thư viện liên quan#
Tiếp theo, bạn có thể cài đặt và import các thư viện Python cần thiết.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Để biết hướng dẫn chi tiết và các phương pháp tốt nhất về quy trình cài đặt, hãy xem hướng dẫn cài đặt Ultralytics. Nếu gặp khó khăn khi cài đặt các package cần thiết cho YOLO26, hãy tham khảo hướng dẫn khắc phục sự cố thường gặp để tìm giải pháp và mẹo hữu ích.
Sau đó, bạn có thể import các package cần dùng.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Bước 3: Tải dữ liệu#
Trong hướng dẫn này, chúng ta sẽ sử dụng tập dữ liệu rác thải biển có trên Kaggle (cũng có trên Trash-ICRA19 của Ultralytics Platform). Với tập dữ liệu này, chúng ta sẽ huấn luyện tùy chỉnh model YOLO26 để phát hiện và phân loại rác thải cũng như các đối tượng sinh học trong ảnh dưới nước.
Chúng ta có thể tải dataset trực tiếp vào notebook bằng Kaggle API. Trước tiên, hãy tạo tài khoản Kaggle miễn phí. Sau khi tạo tài khoản, bạn cần tạo API key. Hướng dẫn tạo key có trong tài liệu Kaggle API, tại mục "Thông tin xác thực API".
Sao chép và dán tên người dùng Kaggle cùng API key vào đoạn code sau. Sau đó chạy code để cài đặt API và tải dataset vào Watsonx.
# Install kaggle
pip install kaggle
Sau khi cài đặt Kaggle, chúng ta có thể tải dataset vào Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Sau khi tải tập dữ liệu, chúng ta đã in và lưu thư mục làm việc. Chúng ta cũng đã in nội dung thư mục làm việc để xác nhận tập dữ liệu "trash_ICRA19" được tải đúng cách.
Nếu thấy "trash_ICRA19" trong nội dung thư mục, nghĩa là dataset đã được tải thành công. Bạn sẽ thấy ba tệp/thư mục: một tệp config.yaml, một thư mục videos_for_testing và một thư mục dataset. Chúng ta sẽ bỏ qua thư mục videos_for_testing, vì vậy bạn có thể xóa thư mục đó.
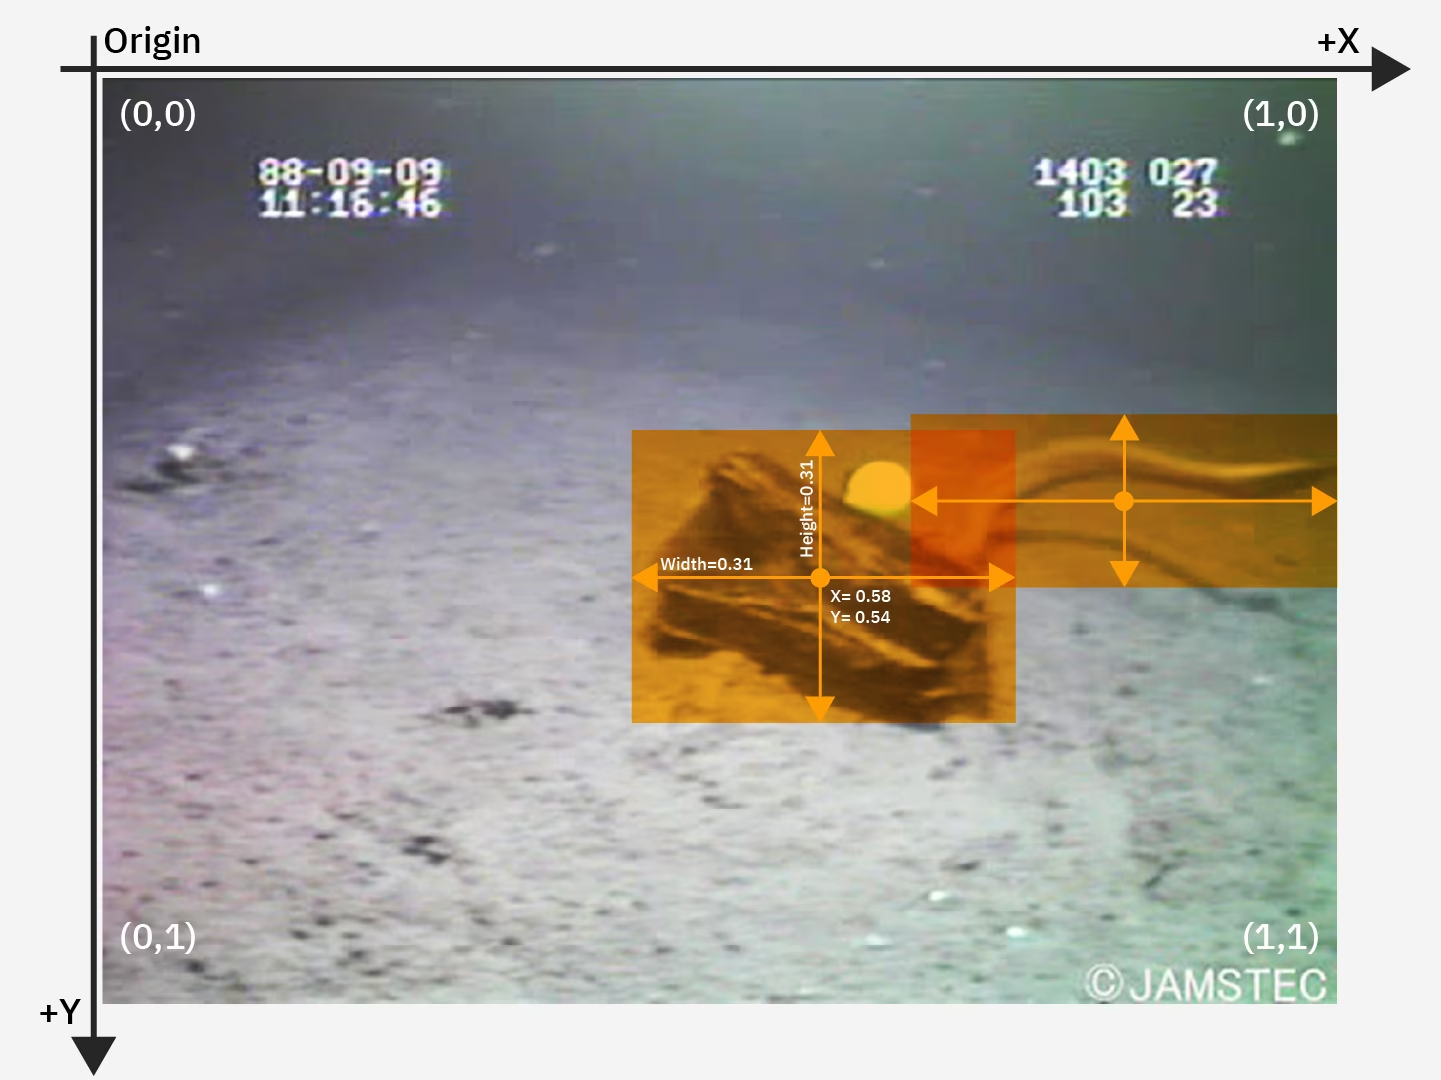
Chúng ta sẽ sử dụng tệp config.yaml và nội dung của thư mục tập dữ liệu để huấn luyện model phát hiện đối tượng. Sau đây là ảnh mẫu từ tập dữ liệu rác thải biển.
Bước 4: Tiền xử lý dữ liệu#
Tất cả nhãn trong tập dữ liệu rác thải biển đã được định dạng thành các tệp YOLO .txt. Tuy nhiên, chúng ta cần sắp xếp lại các thư mục ảnh và nhãn để model có thể tìm thấy chúng. Hiện tại, thư mục tập dữ liệu đã tải có cấu trúc như sau:
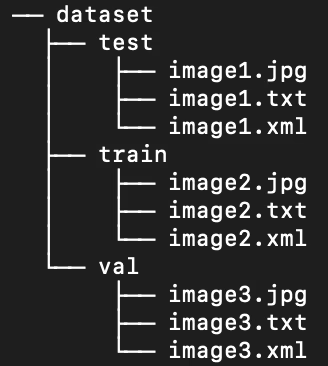
Theo mặc định, các model YOLO cần có các thư mục con images và labels riêng biệt trong mỗi phần train/val/test. Chúng ta cần sắp xếp lại thư mục theo cấu trúc sau:
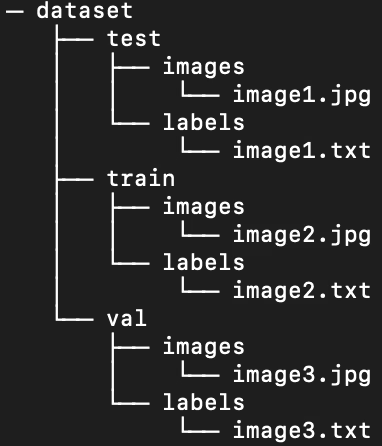
Để sắp xếp lại thư mục tập dữ liệu, chúng ta có thể chạy script sau:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Tiếp theo, chúng ta cần chỉnh sửa tệp YAML của tập dữ liệu. Đây là cấu hình sẽ dùng trong tệp .yaml. ID lớp bắt đầu từ 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Chạy script sau để xóa nội dung hiện tại của config.yaml và thay thế bằng cấu hình phản ánh cấu trúc thư mục tập dữ liệu mới. Script tự động sử dụng biến work_dir mà chúng ta đã định nghĩa trước đó, vì vậy hãy đảm bảo biến này trỏ đến tập dữ liệu của bạn trước khi chạy và giữ nguyên các định nghĩa thư mục con train, val và test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Bước 5: Huấn luyện model YOLO26#
Chạy lệnh sau để tinh chỉnh model YOLO26n đã huấn luyện trước.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueSau đây là phần giải thích chi tiết hơn về các tham số trong lệnh huấn luyện model:
- detect: Tác vụ thị giác máy tính mà bạn sử dụng model YOLO và tập dữ liệu đã chỉ định.
- train: Chế độ, cho biết mục đích tải model và dữ liệu đã chỉ định. Sau này, khi kiểm tra hiệu suất model, chúng ta sẽ dùng
predict. - epochs: Số lần YOLO26 duyệt qua toàn bộ tập dữ liệu.
- batch: Kích thước batch khi huấn luyện, tức số lượng ảnh model xử lý trước khi cập nhật tham số.
- plots: Yêu cầu YOLO tạo và lưu biểu đồ về các metric huấn luyện và đánh giá của model.
Để hiểu chi tiết quy trình huấn luyện model và các phương pháp tốt nhất, hãy tham khảo hướng dẫn Huấn luyện Model YOLO26. Hướng dẫn này sẽ giúp bạn khai thác tối đa các thử nghiệm và đảm bảo bạn sử dụng YOLO26 hiệu quả.
Bước 6: Kiểm tra Model#
Giờ đây, chúng ta có thể chạy inference để kiểm tra hiệu suất của model đã fine-tune:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueLệnh này tạo nhãn dự đoán cho từng ảnh trong tập kiểm thử, đồng thời tạo các tệp ảnh đầu ra mới có bounding box dự đoán phủ lên ảnh gốc.
Nhãn .txt dự đoán cho từng ảnh được lưu bằng đối số save_txt=True, còn ảnh đầu ra có bounding box phủ lên được tạo thông qua đối số save=True. Tham số conf=0.5 yêu cầu model bỏ qua mọi dự đoán có độ tin cậy dưới 50%.
Cuối cùng, iou=.5 đặt ngưỡng loại bỏ tối đa không (NMS): các hộp cùng lớp chồng lấp lên một hộp có điểm số cao hơn trên 50% sẽ bị loại bỏ. Điều này giúp giảm các hộp trùng lặp được tạo cho cùng một đối tượng. Chúng ta có thể tải ảnh có bounding box dự đoán phủ lên để xem hiệu suất model trên một số ảnh.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Đoạn code trên hiển thị mười ảnh từ tập kiểm tra cùng với bounding box dự đoán, nhãn tên lớp và độ tin cậy tương ứng.
Bước 7: Đánh giá Model#
Chúng ta có thể tạo hình ảnh trực quan hóa precision và recall của model cho từng lớp. Các hình ảnh trực quan hóa này được lưu trong thư mục của lượt huấn luyện ({work_dir}/runs/detect/train/). Điểm precision được hiển thị trong BoxP_curve.png:
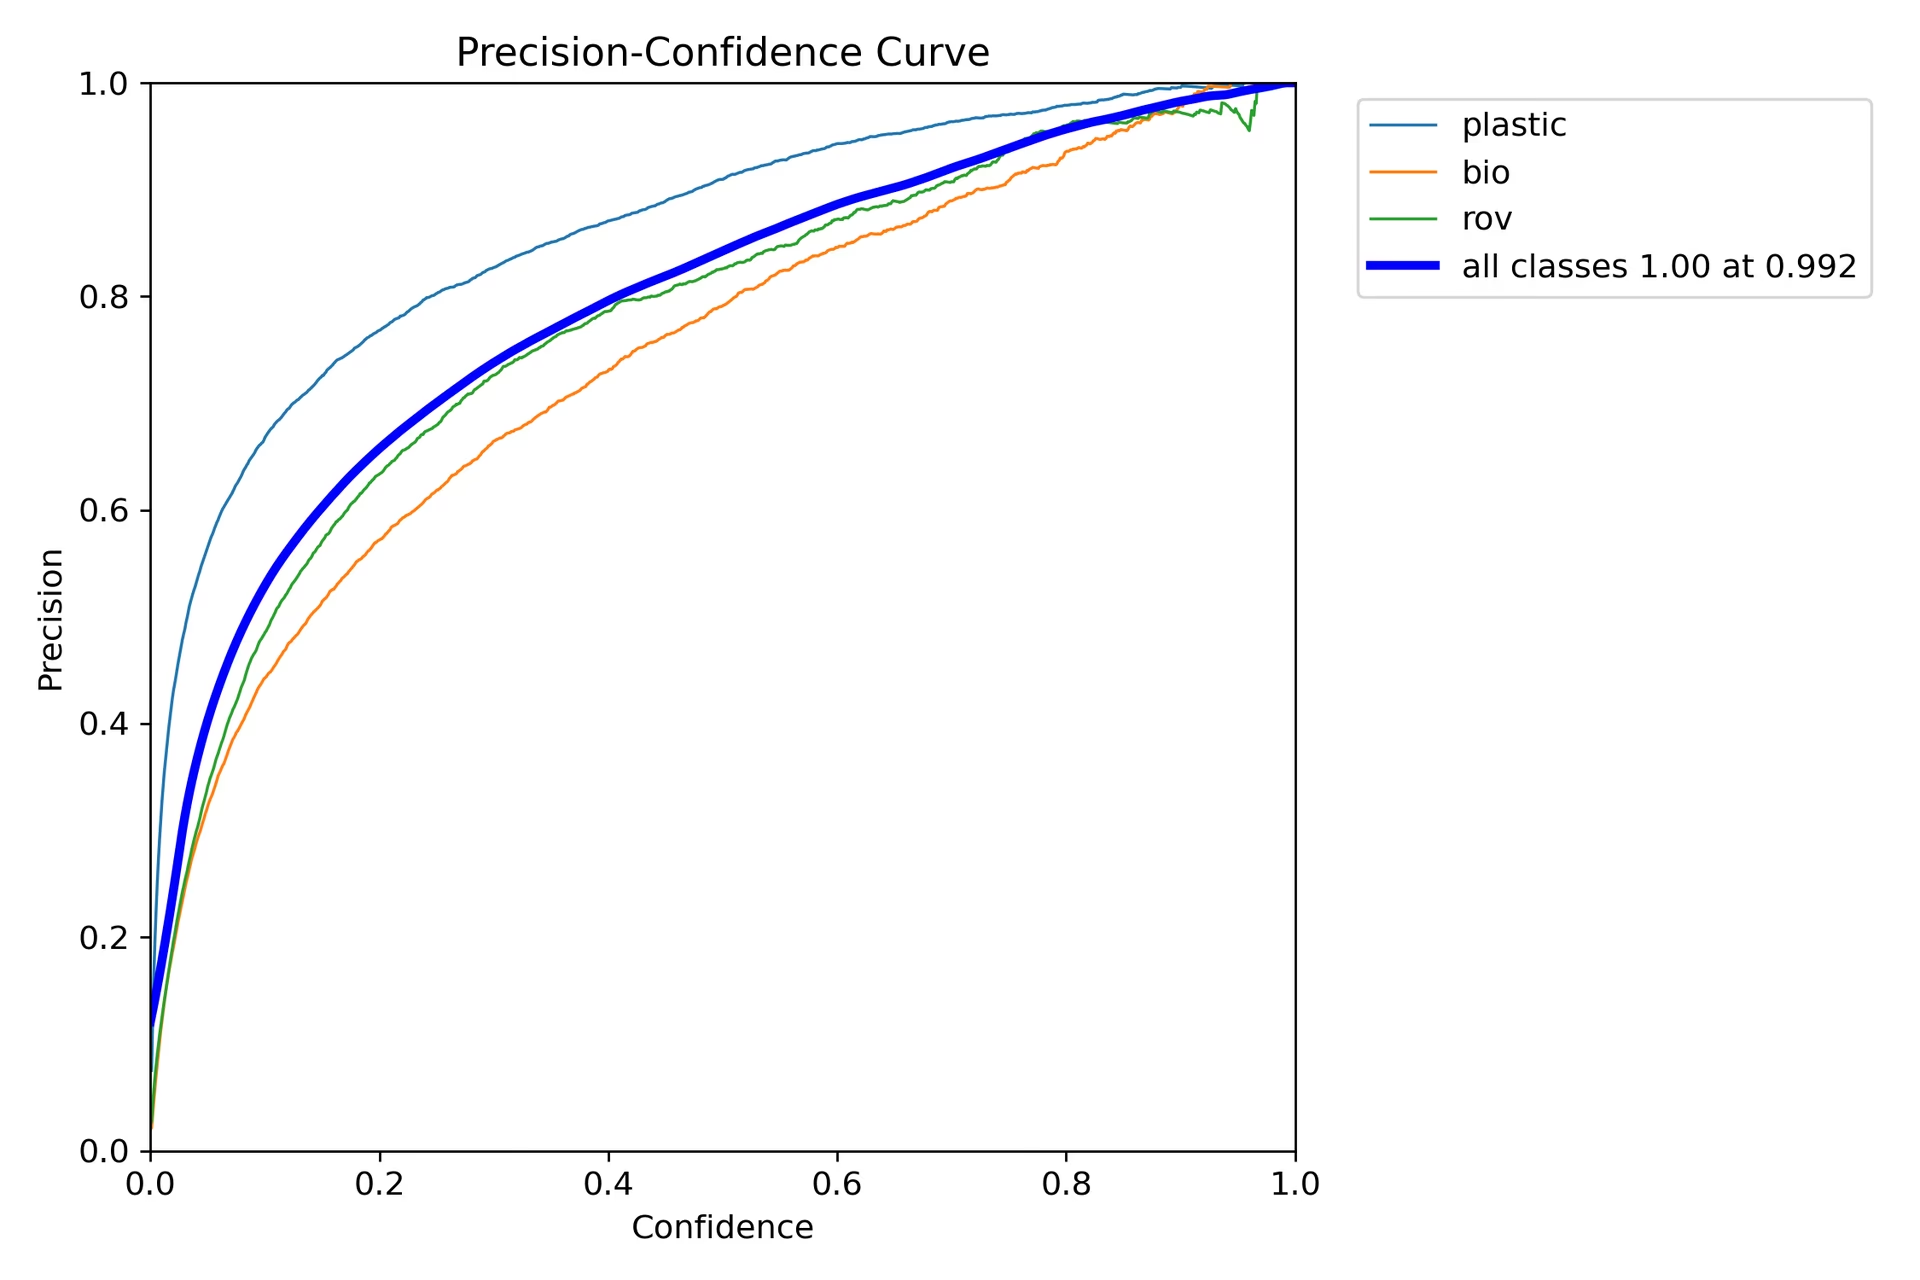
Biểu đồ cho thấy precision tăng khi ngưỡng confidence của dự đoán tăng. Tuy nhiên, sau hai epoch, precision của model vẫn chưa ổn định ở một mức confidence nhất định.
Biểu đồ recall (BoxR_curve.png) thể hiện xu hướng ngược lại:
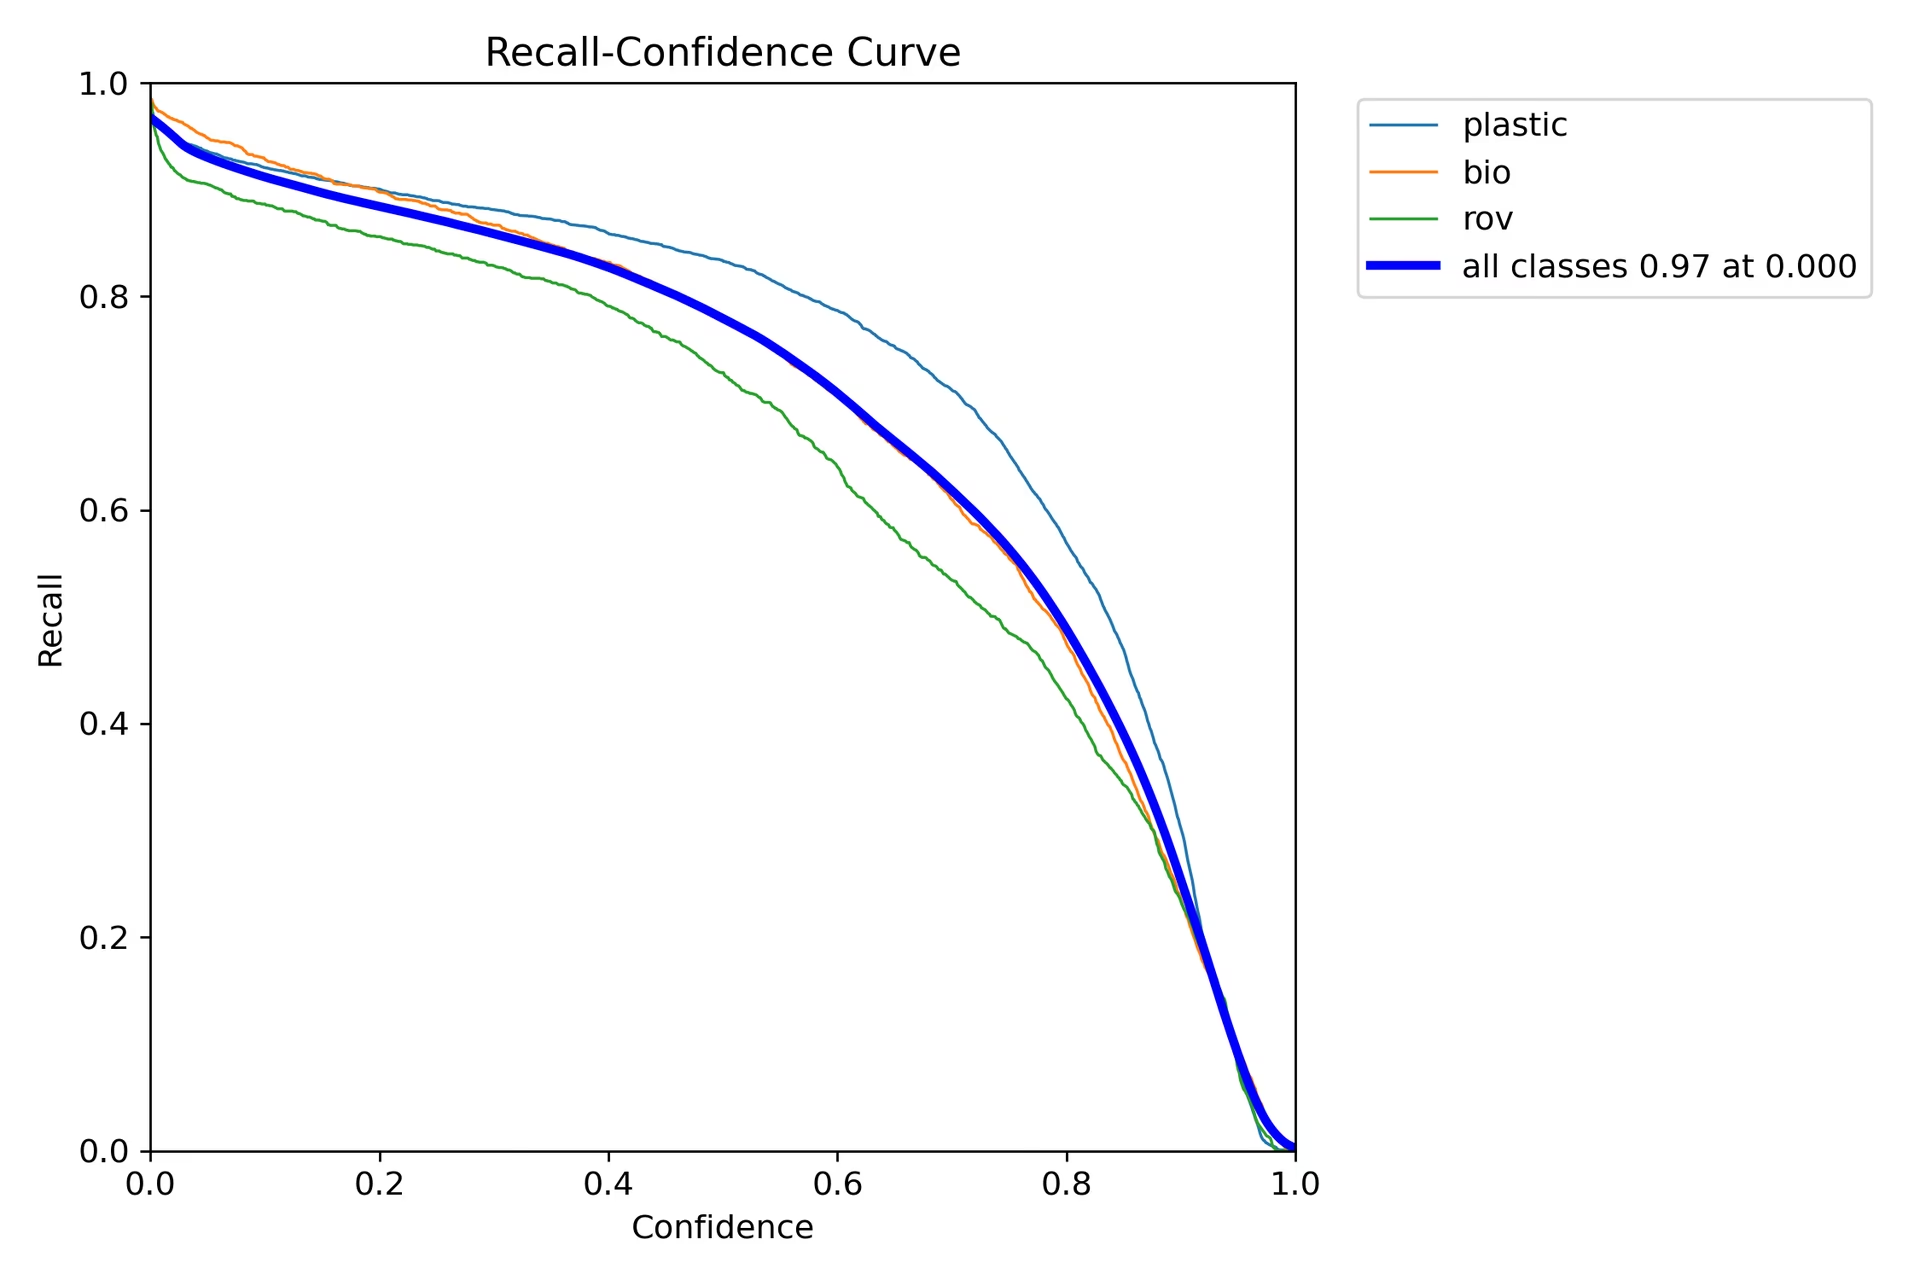
Khác với precision, recall cao nhất ở các ngưỡng confidence thấp và giảm khi ngưỡng tăng. Điều này minh họa sự đánh đổi giữa precision và recall.
Bước 8: Tính Intersection over Union#
Bạn có thể đo độ chính xác định vị bằng cách tính độ giao trên hợp (IoU) giữa bounding box dự đoán và bounding box ground truth của cùng một đối tượng.
Tóm tắt#
Chúng tôi đã tìm hiểu các tính năng chính của IBM Watsonx và cách huấn luyện model YOLO26 bằng nền tảng này. IBM Watsonx cũng cung cấp các công cụ xây dựng model, quản lý dữ liệu và tuân thủ.
Để biết thêm chi tiết về cách sử dụng, hãy truy cập tài liệu chính thức của IBM Watsonx.
Câu hỏi thường gặp#
Để huấn luyện model YOLO26 bằng IBM Watsonx, hãy làm theo các bước sau:
- Thiết lập môi trường: Tạo tài khoản IBM Cloud và thiết lập dự án Watsonx.ai. Sử dụng Jupyter Notebook làm môi trường viết code.
- Cài đặt thư viện: Cài đặt các thư viện cần thiết như
torch,opencvvàultralytics. - Tải dữ liệu: Sử dụng Kaggle API để tải dataset lên Watsonx.
- Tiền xử lý dữ liệu: Sắp xếp dataset theo cấu trúc thư mục bắt buộc và cập nhật file cấu hình
.yaml. - Huấn luyện model: Sử dụng giao diện dòng lệnh YOLO để huấn luyện model với các tham số như
epochsvàbatch. - Kiểm tra và đánh giá: Chạy inference để kiểm tra model và đánh giá hiệu suất bằng các metric như precision và recall.
Để xem hướng dẫn chi tiết, hãy tham khảo hướng dẫn Huấn luyện Model YOLO26.
IBM Watsonx cung cấp một số tính năng chính phục vụ việc huấn luyện model AI:
- Watsonx.ai: Cung cấp các công cụ phát triển AI, bao gồm quyền truy cập vào model tùy chỉnh do IBM hỗ trợ và model bên thứ ba như Llama 3. Nền tảng bao gồm Prompt Lab và Tuning Studio để quản lý toàn diện vòng đời AI.
- Watsonx.data: Hỗ trợ triển khai trên cloud và tại chỗ, cung cấp quyền truy cập dữ liệu tập trung, các query engine hiệu quả như Presto và Spark, cùng lớp ngữ nghĩa có hỗ trợ AI.
- Watsonx.governance: Tự động hóa việc tuân thủ, quản lý rủi ro bằng cảnh báo và cung cấp công cụ phát hiện các vấn đề như sai lệch và drift. Nền tảng này cũng có dashboard và công cụ báo cáo hỗ trợ cộng tác.
Để biết thêm thông tin, hãy truy cập tài liệu chính thức của IBM Watsonx.
IBM Watsonx phù hợp để huấn luyện Ultralytics YOLO26 vì các công cụ của nền tảng bao quát toàn bộ vòng đời AI. Các lợi ích chính gồm:
- Khả năng mở rộng: Dễ dàng mở rộng quy mô huấn luyện model bằng các dịch vụ IBM Cloud.
- Tích hợp: Kết nối với nhiều nguồn dữ liệu và API.
- Giao diện thân thiện với người dùng: Đơn giản hóa quy trình phát triển với giao diện trực quan, hỗ trợ cộng tác.
- Công cụ nâng cao: Truy cập các công cụ như Prompt Lab và Tuning Studio để cải thiện hiệu suất model.
Để tiền xử lý dataset cho quá trình huấn luyện YOLO26 trên IBM Watsonx:
- Sắp xếp thư mục: Đảm bảo dataset tuân theo cấu trúc thư mục YOLO, với các thư mục con riêng cho ảnh và nhãn trong từng phân vùng train/val/test.
- Cập nhật file .yaml: Chỉnh sửa file cấu hình
.yamlđể phản ánh cấu trúc thư mục mới và tên các lớp. - Chạy script tiền xử lý: Dùng script Python để sắp xếp lại dataset và cập nhật file
.yamltương ứng.
Dưới đây là script mẫu để sắp xếp dataset:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Để biết thêm chi tiết, hãy tham khảo hướng dẫn tiền xử lý dữ liệu của chúng tôi.
Trước khi bắt đầu huấn luyện model YOLO26 trên IBM Watsonx, hãy đảm bảo bạn đã chuẩn bị các điều kiện tiên quyết sau:
- Tài khoản IBM Cloud: Tạo tài khoản IBM Cloud để truy cập Watsonx.ai.
- Tài khoản Kaggle: Để tải dataset, bạn cần có tài khoản Kaggle và API key.
- Jupyter Notebook: Thiết lập môi trường Jupyter Notebook trong Watsonx.ai để viết code và huấn luyện model.
Để biết thêm thông tin về cách thiết lập môi trường, hãy truy cập hướng dẫn cài đặt Ultralytics của chúng tôi.


Bình luận
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.