RT-DETR của Baidu: Model phát hiện đối tượng thời gian thực dựa trên Vision Transformer
Tổng quan#
Real-Time Detection Transformer (RT-DETR), do Baidu phát triển, là model phát hiện đối tượng end-to-end, đạt hiệu năng thời gian thực trong khi duy trì độ chính xác cao. Model kế thừa DETR, một framework phát hiện Transformer không cần NMS, đồng thời bổ sung backbone tích chập và hybrid encoder hiệu quả để đạt tốc độ thời gian thực. RT-DETR xử lý hiệu quả các đặc trưng đa tỷ lệ bằng cách tách biệt tương tác trong cùng tỷ lệ và hợp nhất giữa các tỷ lệ. Model có khả năng thích ứng cao, cho phép điều chỉnh linh hoạt tốc độ suy luận bằng cách sử dụng các lớp decoder khác nhau mà không cần huấn luyện lại. RT-DETR hoạt động tốt nhất trên các backend tăng tốc như CUDA với TensorRT.
Xem: Cách sử dụng RT-DETR của Baidu để phát hiện đối tượng | Suy luận và benchmark với Ultralytics
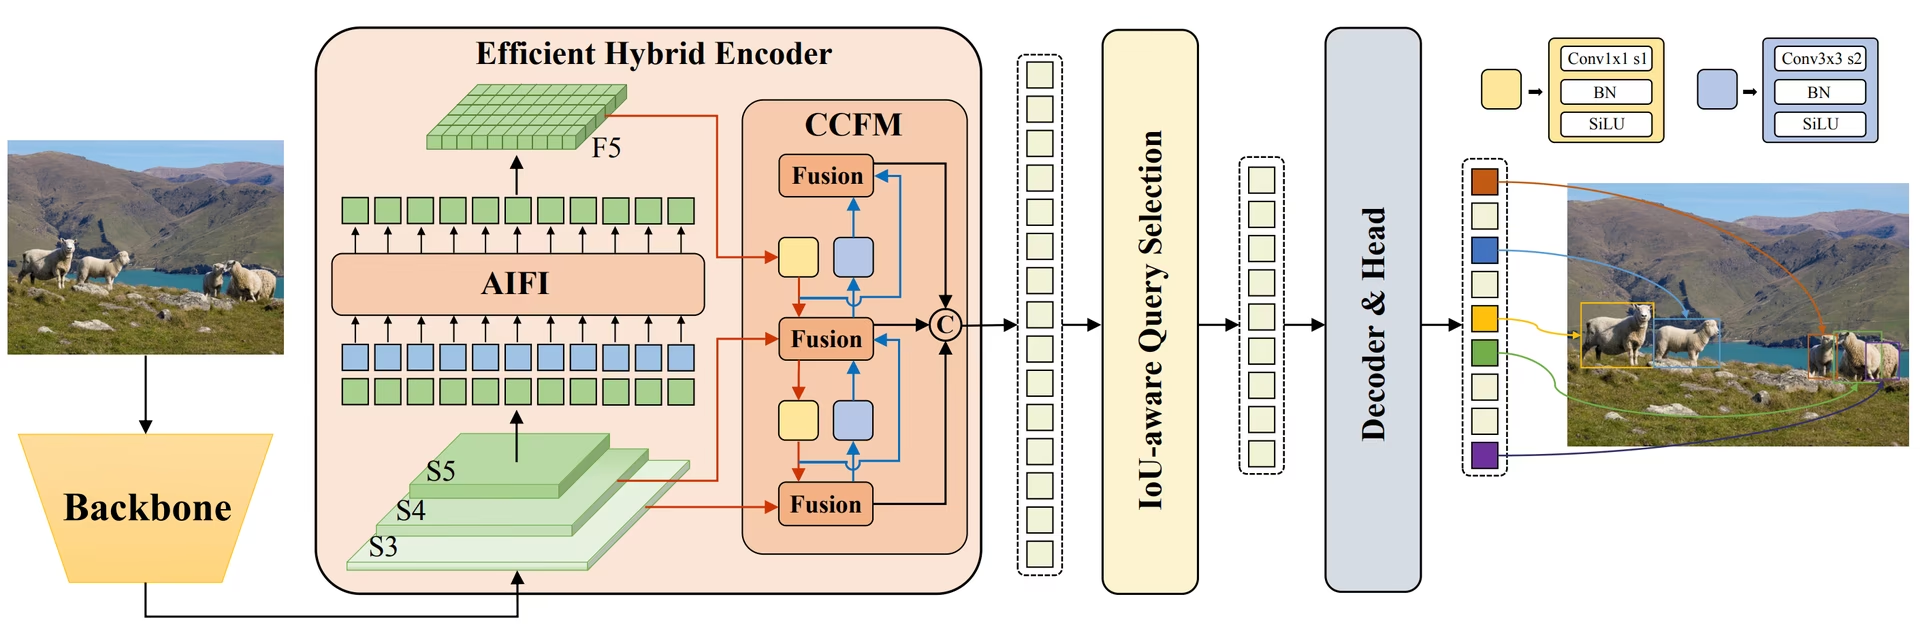 Tổng quan về RT-DETR của Baidu. Sơ đồ kiến trúc model RT-DETR cho thấy ba giai đoạn cuối của backbone {S3, S4, S5} là đầu vào của encoder. Bộ mã hóa lai hiệu quả chuyển đổi các đặc trưng đa tỷ lệ thành chuỗi đặc trưng ảnh thông qua tương tác đặc trưng trong cùng tỷ lệ (AIFI) và module hợp nhất đặc trưng xuyên tỷ lệ (CCFM). Cơ chế chọn query nhận biết IoU được dùng để chọn một số lượng cố định đặc trưng ảnh làm query đối tượng ban đầu cho decoder. Cuối cùng, decoder cùng các đầu dự đoán phụ tối ưu lặp lại query đối tượng để tạo ra các box và điểm tin cậy (nguồn).
Tính năng chính#
- Hybrid Encoder hiệu quả: RT-DETR của Baidu sử dụng hybrid encoder hiệu quả, xử lý các đặc trưng đa tỷ lệ bằng cách tách biệt tương tác trong cùng tỷ lệ và hợp nhất giữa các tỷ lệ. Thiết kế dựa trên Transformer này giảm chi phí tính toán và cho phép phát hiện đối tượng theo thời gian thực.
- Lựa chọn truy vấn nhận biết IoU: RT-DETR của Baidu cải thiện khởi tạo truy vấn đối tượng bằng cách lựa chọn truy vấn nhận biết IoU. Điều này giúp model tập trung vào những đối tượng phù hợp nhất trong khung cảnh, cải thiện độ chính xác phát hiện.
- Tốc độ suy luận có thể điều chỉnh: RT-DETR của Baidu hỗ trợ điều chỉnh linh hoạt tốc độ suy luận bằng cách sử dụng các lớp decoder khác nhau mà không cần huấn luyện lại. Khả năng thích ứng này hỗ trợ triển khai thực tế trong nhiều tình huống phát hiện đối tượng thời gian thực.
- Framework không cần NMS: Dựa trên DETR, RT-DETR loại bỏ nhu cầu hậu xử lý ức chế phi cực đại, giúp đơn giản hóa pipeline phát hiện và có khả năng cải thiện hiệu quả.
- Phát hiện không cần anchor: Là một bộ phát hiện không cần anchor, RT-DETR đơn giản hóa quy trình phát hiện và có thể cải thiện khả năng tổng quát hóa trên các bộ dữ liệu khác nhau.
Model được tiền huấn luyện#
Ultralytics Python API cung cấp các model RT-DETR PaddlePaddle được huấn luyện trước với nhiều kích thước khác nhau:
- RT-DETR-L: 53.0% AP trên tập val2017 của COCO, 114 FPS trên GPU T4
- RT-DETR-X: 54.8% AP trên COCO val2017, 74 FPS trên GPU T4
Baidu phát hành RTDETRv2 vào tháng 7 năm 2024, với kiến trúc được cải tiến hơn nữa so với phiên bản gốc.
Ví dụ sử dụng#
Các ví dụ dưới đây minh họa cách huấn luyện và suy luận RT-DETR đơn giản. Bạn cũng có thể huấn luyện model trên GPU đám mây thông qua Ultralytics Platform.
from ultralytics import RTDETR

# Tải model RT-DETR-l được huấn luyện trước trên COCO
model = RTDETR("rtdetr-l.pt")

# Hiển thị thông tin model (không bắt buộc)
model.info()

# Huấn luyện model trên dataset mẫu COCO8 trong 100 epoch
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Chạy suy luận bằng model RT-DETR-l trên ảnh 'bus.jpg'
results = model("path/to/bus.jpg")Đặt deterministic=False khi huấn luyện RT-DETR trên CUDA với PyTorch 2.0 trở lên. Cơ chế attention biến dạng của model sử dụng F.grid_sample, vốn không có backward CUDA mang tính xác định, do đó deterministic=True không thể giúp quá trình chạy tái lập được và có thể làm giảm thông lượng huấn luyện. seed vẫn kiểm soát việc khởi tạo trọng số, thứ tự dữ liệu và lấy mẫu tăng cường dữ liệu.
Trọng số RT-DETR được huấn luyện trước hỗ trợ hai thiết lập tại thời điểm suy luận để giảm độ trễ mà không cần huấn luyện lại:
eval_idx: Dừng giải mã sớm. Với decoder 6 lớp mặc định, hãy dùng chỉ số bắt đầu từ 0 (0–5).eval_idx=5sử dụng tất cả các lớp;eval_idx=3sử dụng 4 lớp. Trên GPU T4 với TensorRT v10.11, RT-DETR-L cải thiện từ 8.0 ms / 52.7 mAP lên 7.4 ms / 52.5 mAP khi dùng 4 lớp.num_queries: Giảm số lượng query đối tượng (mặc định: 300). Giảm xuống 100 có thể đạt 7.4 ms / 51.7 mAP trên COCO trong cùng cấu hình. Với các bộ dữ liệu có ít đối tượng hơn trong mỗi ảnh, mức giảm mAP thường nhỏ hơn, nhưng hãy giữ giá trị này cao hơn số lượng đối tượng tối đa dự kiến trong mỗi ảnh.
Cả hai thiết lập đều có thể làm giảm mAP — hãy đánh giá sự đánh đổi trên bộ dữ liệu của bạn trước khi triển khai.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Chọn một hoặc cả hai thiết lập sau khi đánh giá sự đánh đổi giữa tốc độ và độ chính xác.
head.decoder.eval_idx = 3  # Sử dụng 4 trong 6 lớp decoder.
head.num_queries = 100  # Sử dụng ít query đối tượng hơn.

results = rtdetr("path/to/image.jpg")

# Quá trình export sử dụng cùng thiết lập decoder và query, bao gồm cả khi export sang TensorRT.
rtdetr.export(format="engine", device=0, quantize=16)
Các tác vụ và chế độ được hỗ trợ#
Bảng này trình bày các loại model, trọng số pretrained cụ thể, các tác vụ được từng model hỗ trợ và những chế độ được hỗ trợ (Train, Val, Predict, Export), được đánh dấu bằng emoji ✅.
| Loại model | Weights pretrained | Các tác vụ được hỗ trợ | Huấn luyện | Validation | Suy luận | Export |
|---|---|---|---|---|---|---|
| RT-DETR cỡ lớn | rtdetr-l.pt | Phát hiện đối tượng | ✅ | ✅ | ✅ | ✅ |
| RT-DETR cỡ cực lớn | rtdetr-x.pt | Phát hiện đối tượng | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml và rtdetr-resnet101.yaml chỉ được cung cấp dưới dạng kiến trúc YAML. Ultralytics chỉ phát hành trọng số được huấn luyện trước cho rtdetr-l và rtdetr-x. Khởi tạo các biến thể ResNet từ YAML (ví dụ: RTDETR("rtdetr-resnet50.yaml")) rồi huấn luyện hoặc fine-tune khi cần.
Các trường hợp sử dụng phù hợp nhất#
RT-DETR đặc biệt phù hợp với các ứng dụng đòi hỏi cả độ chính xác cao và hiệu năng thời gian thực:
- Lái xe tự hành: Hỗ trợ nhận thức môi trường đáng tin cậy trong hệ thống tự lái, nơi cả tốc độ và độ chính xác đều rất quan trọng.
- Robot tiên tiến: Giúp robot thực hiện các tác vụ phức tạp đòi hỏi nhận dạng và tương tác chính xác với đối tượng trong môi trường biến động.
- Chẩn đoán hình ảnh y tế: Dùng trong các ứng dụng chăm sóc sức khỏe, nơi độ chính xác của phát hiện đối tượng có thể đóng vai trò then chốt trong chẩn đoán.
- Hệ thống giám sát: Dùng cho các ứng dụng an ninh cần giám sát thời gian thực với độ chính xác phát hiện cao. Tìm hiểu về hệ thống báo động an ninh.
- Phân tích ảnh vệ tinh: Dùng để phân tích chi tiết ảnh độ phân giải cao, nơi khả năng hiểu ngữ cảnh toàn cục rất quan trọng. Đọc về thị giác máy tính trong ảnh vệ tinh.
Trích dẫn và lời cảm ơn#
Nếu sử dụng RT-DETR của Baidu trong nghiên cứu hoặc phát triển, vui lòng trích dẫn bài báo gốc:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Đối với RTDETRv2, bạn có thể trích dẫn bài báo năm 2024:
@misc{lv2024rtdetrv2,
      title={RT-DETRv2: Improved Baseline with Bag-of-Freebies for Real-Time Detection Transformer},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Chúng tôi xin ghi nhận đóng góp của Baidu và đội ngũ PaddlePaddle trong việc tạo ra và duy trì tài nguyên quý giá này cho cộng đồng thị giác máy tính. Chúng tôi đánh giá cao việc họ phát triển model phát hiện đối tượng thời gian thực dựa trên Transformer RT-DETR.
Câu hỏi thường gặp#
RT-DETR (Transformer phát hiện thời gian thực) của Baidu là bộ phát hiện đối tượng thời gian thực dựa trên Transformer. Model xử lý hiệu quả các đặc trưng đa tỷ lệ bằng cách tách biệt tương tác trong cùng tỷ lệ và hợp nhất chéo tỷ lệ thông qua encoder lai hiệu quả. Bằng cách sử dụng lựa chọn truy vấn nhận biết IoU, model tập trung vào các đối tượng phù hợp nhất, từ đó cải thiện độ chính xác phát hiện. Tốc độ suy luận linh hoạt, đạt được bằng cách điều chỉnh các lớp decoder mà không cần huấn luyện lại, giúp RT-DETR phù hợp với nhiều tình huống phát hiện đối tượng thời gian thực.
Sử dụng API Python của Ultralytics để tải các model RT-DETR PaddlePaddle pretrained. Ví dụ, để tải model RT-DETR-l pretrained trên COCO, tinh chỉnh model và chạy suy luận:
Ví dụfrom ultralytics import RTDETR # Tải model RT-DETR-l được huấn luyện trước trên COCO model = RTDETR("rtdetr-l.pt") # Hiển thị thông tin model (không bắt buộc) model.info() # Huấn luyện model trên dataset mẫu COCO8 trong 100 epoch results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Chạy suy luận bằng model RT-DETR-l trên ảnh 'bus.jpg' results = model("path/to/bus.jpg")RT-DETR của Baidu kết hợp hybrid encoder hiệu quả với lựa chọn truy vấn nhận biết IoU, giúp giảm chi phí tính toán mà vẫn duy trì độ chính xác cao. Khả năng điều chỉnh tốc độ suy luận bằng cách sử dụng các lớp decoder khác nhau mà không cần huấn luyện lại tăng tính linh hoạt, hữu ích cho ứng dụng thời gian thực trên các backend tăng tốc như CUDA với TensorRT. Kiến trúc Transformer cũng nắm bắt ngữ cảnh toàn cục tốt hơn các model phát hiện truyền thống dựa trên CNN.
RT-DETR của Baidu cho phép điều chỉnh linh hoạt tốc độ suy luận bằng cách sử dụng các lớp decoder khác nhau mà không cần huấn luyện lại. Nhờ đó, bạn có thể cân bằng tốc độ và độ chính xác trong các tác vụ phát hiện đối tượng thời gian thực: dùng ít lớp decoder hơn để xử lý nhanh hơn với độ chính xác thấp hơn đôi chút, hoặc dùng tất cả các lớp để có kết quả phát hiện chính xác nhất. Tính năng này đặc biệt hữu ích khi triển khai model trên các thiết bị có năng lực tính toán khác nhau.
Không. Với RT-DETR,
max_detgiới hạn số lượng dự đoán được trả về sau suy luận, nhưng không làm tăng số query đối tượng do decoder tạo ra. Các checkpoint RT-DETR được huấn luyện trước của Ultralytics sử dụng 300 query đối tượng, vì vậy chúng không thể trả về hơn 300 kết quả phát hiện cho mỗi ảnh, ngay cả khi bạn đặtmax_detthành giá trị lớn hơn.Dùng
max_detđể giảm số kết quả phát hiện được trả về, chẳng hạnmax_det=100, khi bạn chỉ cần ít dự đoán có độ tin cậy cao hơn. Nếu bộ dữ liệu của bạn có thể chứa hơn 300 đối tượng trong mỗi ảnh, hãy huấn luyện model RT-DETR tùy chỉnh với số lượng query decoder cao hơn (nq) trong YAML của model; thay đổi giá trị này trên checkpoint đã huấn luyện trước không tương đương và cần huấn luyện lại để model học các query bổ sung.Có, model RT-DETR hỗ trợ các chế độ huấn luyện, đánh giá, dự đoán và xuất của Ultralytics. Framework Ultralytics cung cấp API nhất quán trên các kiến trúc model, vì vậy RT-DETR sử dụng quy trình làm việc giống các model YOLO.


Bình luận148
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
PhucPhamSy
Hi all, Could you please let me know how to use all parameters in the appendix of the original paper, "https://arxiv.org/pdf/2304.08069"? Thanks!
1 Glenn JocherUltralytics
Hey there! 👋
We're really glad you're interested in diving deep into the parameters detailed in the original paper. Specifically, for utilizing parameters as mentioned in the RT-DETR paper ("DETRs Beat YOLOs on Real-time Object Detection"), I recommend focusing on the key components such as the Efficient Hybrid Encoder, IoU-aware Query Selection, and adaptability in Inference Speed adjustments that make RT-DETR efficient.
Details on these components can be extrapolated to parameter usage within your model through our Python API. For instance, when initializing the RT-DETR model or adjusting inference speed, you would consider the different scales of pre-trained models available:
from ultralytics import RTDETR

# For a larger model with potentially higher accuracy but lower FPS (Frames Per Second)
model = RTDETR('rtdetr-l.pt')

# For an extra-large model prioritizing accuracy over speed
model_x = RTDETR('rtdetr-x.pt')
Adjustments for inference speed and applying IoU-aware query selection can directly correlate with your focus during the
.train()or.predict()processes, especially understanding what goes behind each configuration setting in these functions.Unfortunately, we don't provide a direct mapping for every parameter mentioned in the appendix to code-level argument settings as the implementation abstracts many complexities for user convenience and to maintain the API's simplicity. However, understanding the RT-DETR's key features and translating that understanding into practical API usage is a great way to leverage the power of RT-DETR. 😊
For more tailored guidance, always feel free to ask or refer to our official documentation for specific examples and deeper insights.
Happy coding! 🚀
 Murat Raimbekov
hey @wba-zzu, thanks for raising this.
quick rundown of where things stand:
resnet50 / resnet101 - the architectures are already shipped as yaml configs:
you can build and train them straight from yaml:
from ultralytics import RTDETR

model = RTDETR("rtdetr-resnet50.yaml")
model.train(data="coco.yaml", epochs=100, imgsz=640)
however, ultralytics does not publish pretrained weights for these. the only official rt-detr checkpoints in the ultralytics/assets releases are
rtdetr-l.ptandrtdetr-x.pt, both of which use the hgnetv2 backbone (not resnet). this is also flagged in the model docs under "architecture-only variants".resnet18 - not shipped. there is no
rtdetr-resnet18.yamlin the repo, so a resnet18 variant would need its own yaml and corresponding modules added.loading external pretrained weights: ultralytics builds the model from yaml, so the state_dict keys follow a pattern like
model.<index>.layer.<...>.conv.weight. weights from another implementation will not load directly - they would need a key-mapping / conversion step to match this layout.hope this helps!
 Boao Wang
想要将原版RT-DETR中的ResNet50和ResNet18以及ResNet101完全移植到Ultralytics,并且获得其预训练模型
995742853
您好,我想请问一下,在哪里有基于rtdetr-resnet50的预训练pt权重,我知道看到rtdetr-l以及x的预训练权重
- Glenn JocherUltralytics
目前 RT-DETR 文档 里公开提供的 Ultralytics 预训练权重只有
rtdetr-l.pt和rtdetr-x.pt;如果你找的是 ResNet50 版本,建议查看 Baidu 官方的 RT-DETR PyTorch 权重列表,其中提供的是rtdetr_r50vd_*.pth,不是 Ultralytics 直接发布的rtdetr-resnet50.pt,也欢迎直接在这里继续提问,方便 Ultralytics 团队跟进。 (docs.ultralytics.com) 谢谢您的回复
maitianstudio-arch
How to use RT-DETRv2?
- Glenn JocherUltralytics
Ultralytics currently exposes the original RT-DETR pretrained weights (
rtdetr-l.pt,rtdetr-x.pt) via theRTDETRAPI; RT-DETRv2 pretrained weights/configs aren’t packaged inultralyticsyet, so if you share what RT-DETRv2 checkpoint you have (Paddle vs PyTorch) and how you’re trying to run it, we can point you to the right conversion/workflow—meanwhile you can use RT-DETR as shown in the RT-DETR docs.from ultralytics import RTDETR model = RTDETR("rtdetr-l.pt") results = model("path/to/image.jpg")
fxc0627
你好,请问RE-DETR模型适用于小目标工业缺陷检测吗?对于小目标检测有什么天然的优势?
wang18382140151-hub
你好,最近deim,dfine等对于rtdetr有了很好的改进,尤其是deim能很好的加速训练的速度,能将其整合进rtdetr中吗?
yuwencool
您好RT-DETR模型的推理支持model.track模式吗?
liyansong123456
RT-DETRv3 has been released. Does Ultralytics have plans to integrate it?
AK993
你好,rt-detr支持在转为rknn格式,并在rk3588上部署吗