SAM 3: Phân đoạn mọi thứ bằng khái niệm
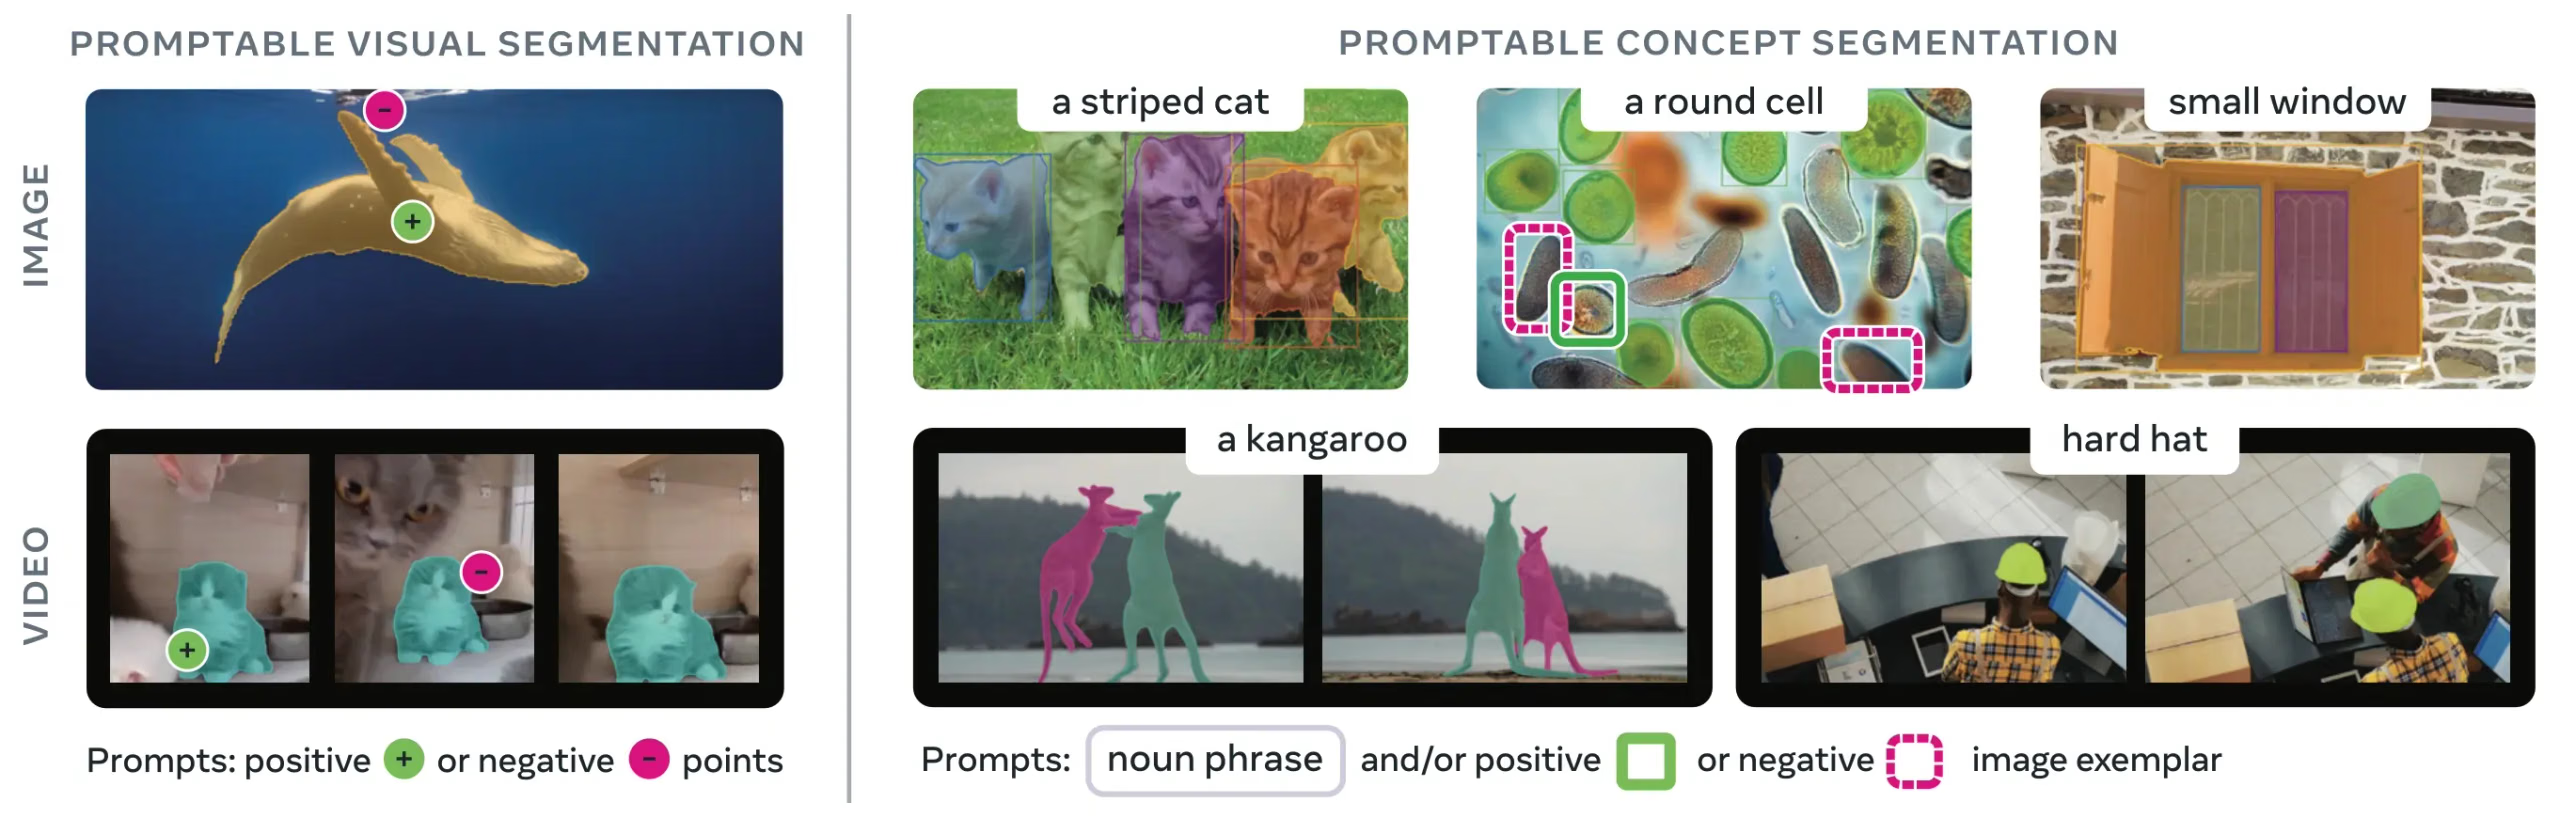
SAM 3 (Model Segment Anything 3) là model nền tảng của Meta dành cho Phân đoạn khái niệm có thể nhắc lệnh (PCS). Dựa trên SAM 2, SAM 3 giới thiệu một khả năng mới: phát hiện, phân đoạn và theo dõi mọi instance của một khái niệm thị giác được chỉ định bằng prompt văn bản, ảnh mẫu hoặc cả hai. Khác với các phiên bản SAM trước chỉ phân đoạn một đối tượng cho mỗi prompt, SAM 3 có thể tìm và phân đoạn mọi vị trí xuất hiện của một khái niệm trong ảnh hoặc video, phù hợp với mục tiêu từ vựng mở trong phân đoạn instance hiện đại.
Xem: Cách sử dụng Meta Segment Anything 3 với Ultralytics | Phân đoạn ảnh và video bằng prompt văn bản
SAM 3 được tích hợp hoàn toàn vào package ultralytics, cung cấp hỗ trợ gốc cho phân đoạn khái niệm bằng prompt văn bản, prompt ảnh mẫu và theo dõi video. Checkpoint SAM 3.1 mới hơn được hỗ trợ cho dự đoán trên ảnh.
Tổng quan#
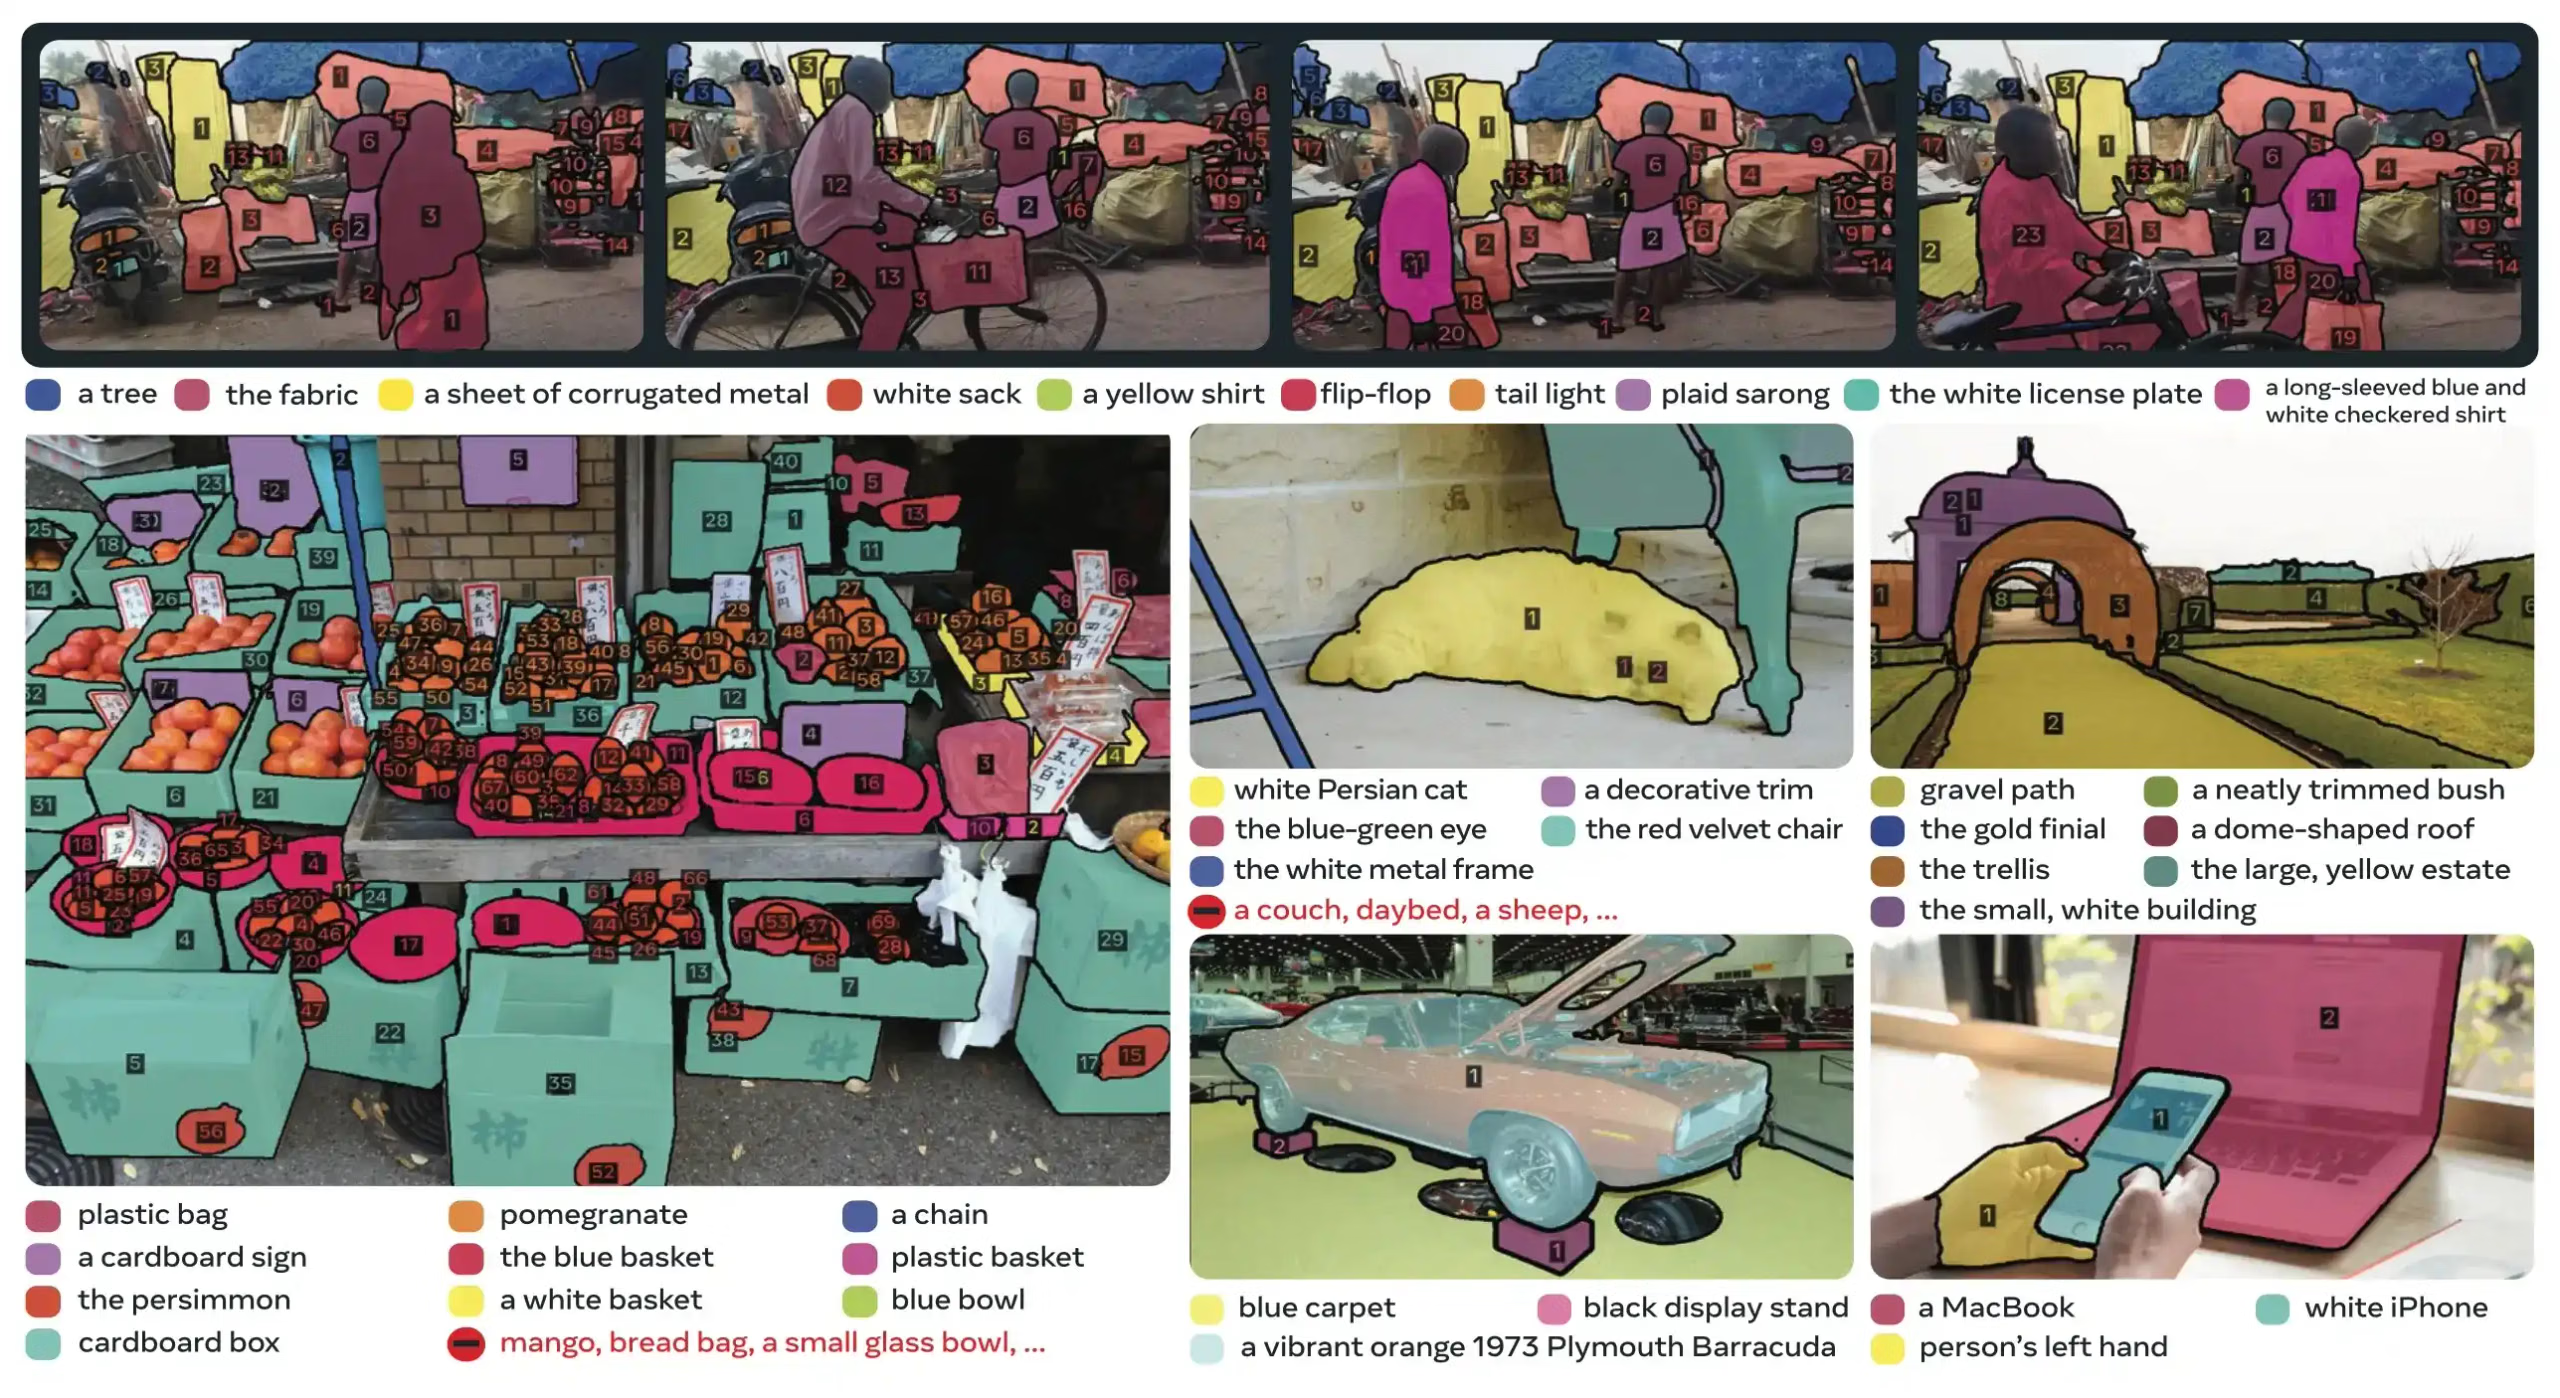
SAM 3 đạt hiệu năng cao gấp 2 lần các hệ thống hiện có trong tác vụ Phân đoạn khái niệm có thể nhắc lệnh, đồng thời duy trì và cải thiện các khả năng của SAM 2 cho phân đoạn thị giác tương tác. Model vượt trội trong phân đoạn từ vựng mở, cho phép người dùng chỉ định khái niệm bằng cụm danh từ đơn giản (ví dụ: “xe buýt trường học màu vàng”, “mèo vằn”) hoặc cung cấp ảnh mẫu của đối tượng mục tiêu. Trong Ultralytics, SAM 3 chạy ở chế độ predict, với các predictor video chuyên dụng để theo dõi.
Phân đoạn khái niệm bằng prompt (PCS) là gì?#
Tác vụ PCS nhận prompt khái niệm làm đầu vào và trả về các mask phân đoạn có định danh riêng cho tất cả instance đối tượng khớp. Prompt khái niệm có thể là:
- Văn bản: Các cụm danh từ đơn giản như "quả táo đỏ" hoặc "người đội mũ", tương tự như học zero-shot
- Ảnh mẫu: Các bounding box bao quanh đối tượng mẫu (dương tính hoặc âm tính) để khái quát hóa nhanh
- Kết hợp: Văn bản và ảnh mẫu cùng lúc để kiểm soát chính xác
Cách này khác với các prompt thị giác truyền thống (điểm, box, mask), vốn chỉ phân đoạn một thể hiện đối tượng cụ thể duy nhất, như được phổ biến bởi họ SAM gốc.
Các chỉ số hiệu năng chính#
| Chỉ số | Kết quả của SAM 3 |
|---|---|
| LVIS Zero-Shot Mask AP | 47.0 (so với mức cao nhất trước đó là 38.5, cải thiện +22%) |
| Benchmark SA-Co | Tốt hơn 2× so với các hệ thống hiện có |
| Tốc độ suy luận (GPU H200) | 30 ms cho mỗi ảnh với hơn 100 đối tượng được phát hiện |
| Hiệu năng video | Gần thời gian thực với ~5 đối tượng đồng thời |
| Benchmark MOSEv2 VOS | 60.1 J&F (cao hơn SAM 2.1 25.5%, cao hơn SOTA trước đó 17%) |
| Tinh chỉnh tương tác | Cải thiện +18.6 CGF1 sau 3 prompt ảnh mẫu |
| Khoảng cách so với hiệu năng con người | Đạt 88% mức cận dưới ước tính trên SA-Co/Gold |
Để hiểu thêm về các chỉ số và đánh đổi của model trong môi trường production, hãy xem phân tích đánh giá model và chỉ số hiệu năng YOLO.
SAM 3.1#
SAM 3.1, được Meta phát hành ngày 27 tháng 3 năm 2026, là checkpoint SAM 3 mới bổ sung Object Multiplex, một phương pháp dùng bộ nhớ chia sẻ để theo dõi nhiều đối tượng trong video. Thay vì xử lý riêng từng đối tượng được theo dõi, SAM 3.1 nhóm các đối tượng vào các bucket có dung lượng cố định và xử lý chúng cùng nhau; Meta cho biết cách này tăng tốc ~7× khi xử lý 128 đối tượng trên một GPU H100. Detector ảnh và head tương tác dùng prompt điểm vẫn giữ nguyên kiến trúc SAM 3.
| Benchmark | Chỉ số | SAM 3 | SAM 3.1 |
|---|---|---|---|
| SA-Co/VEval SA-V (test) | cgF1 | 30.3 | 30.5 |
| SA-Co/VEval YT-Temporal-1B (test) | cgF1 | 50.8 | 52.9 |
| SA-Co/VEval SmartGlasses (test) | cgF1 | 36.4 | 36.3 |
| MOSEv1 (val) | J&F | 78.4 | 79.6 |
| DAVIS17 (val) | J&F | 92.2 | 92.7 |
| SA-V (test) | J&F | 84.4 | 85.1 |
| YTVOS19 (val) | G | 89.7 | 89.3 |
| MOSEv2 (val) | J&Ḟ | 60.3 | 62.3 |
Ultralytics tải checkpoint SAM 3.1 (sam3.1_multiplex.pt) vào các bộ dự đoán ảnh SAM 3: SAM("sam3.1_multiplex.pt") cho prompt điểm và box, và SAM3SemanticPredictor cho prompt văn bản và ảnh mẫu. Hiện chưa hỗ trợ theo dõi video Object Multiplex, vì vậy hãy tiếp tục sử dụng sam3.pt cùng với SAM3VideoPredictor và SAM3VideoSemanticPredictor.
Kiến trúc#
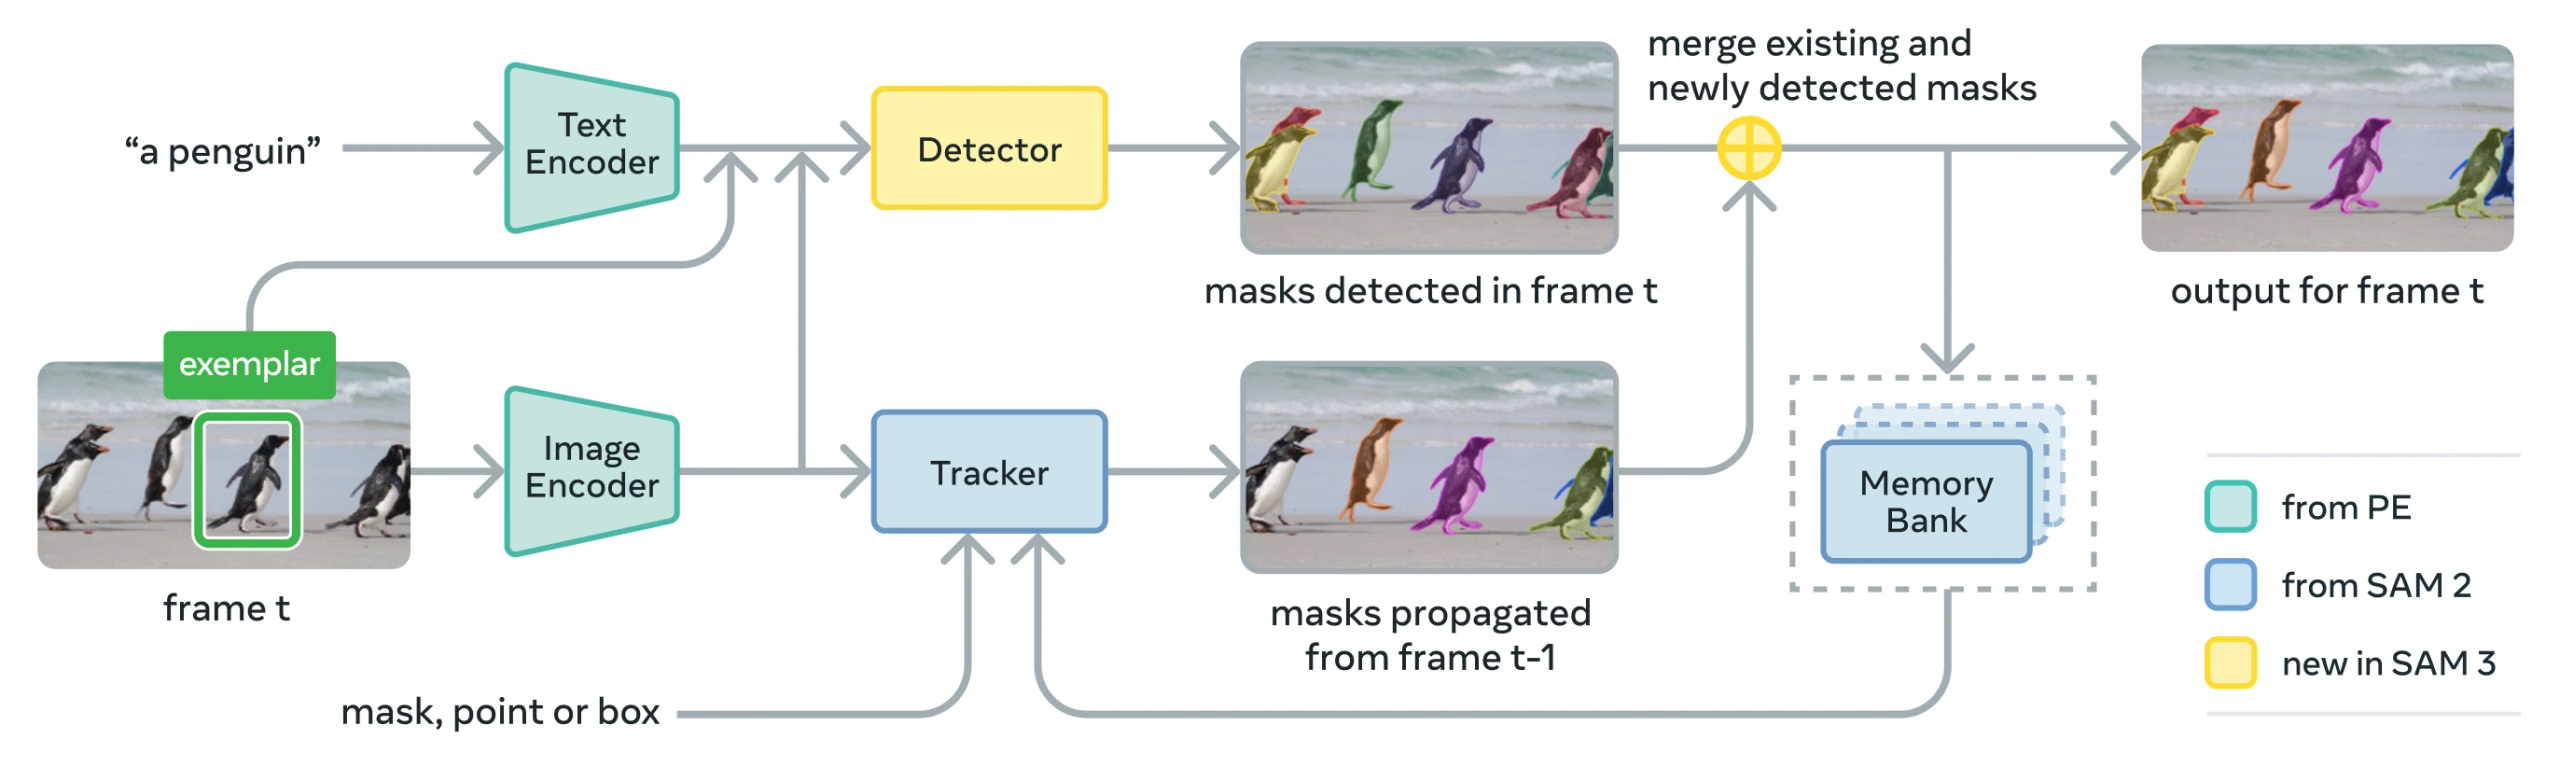
SAM 3 gồm một detector và một tracker dùng chung backbone thị giác Perception Encoder (PE). Thiết kế tách rời này tránh xung đột giữa các tác vụ, đồng thời hỗ trợ cả phát hiện ở cấp ảnh và theo dõi ở cấp video, với giao diện tương thích với cách sử dụng Python và CLI của Ultralytics.
Các thành phần cốt lõi#
-
Detector: Kiến trúc dựa trên DETR để phát hiện khái niệm ở cấp ảnh
- Text encoder cho prompt cụm danh từ
- Exemplar encoder cho prompt dựa trên ảnh
- Fusion encoder để điều kiện hóa đặc trưng ảnh theo prompt
- Presence head mới giúp tách biệt nhận diện ("là gì") khỏi định vị ("ở đâu")
- Mask head để tạo mask phân đoạn thể hiện
-
Tracker: Phân đoạn video dựa trên bộ nhớ, kế thừa từ SAM 2
- Prompt encoder, mask decoder, memory encoder
- Memory bank để lưu trữ diện mạo đối tượng qua các frame
-
Presence Token: Một token toàn cục được học để dự đoán liệu khái niệm mục tiêu có xuất hiện trong ảnh/frame hay không, qua đó cải thiện khả năng phát hiện bằng cách tách biệt nhận diện khỏi định vị.
Đổi mới then chốt#
- Tách biệt nhận diện và định vị: Head dự đoán sự hiện diện của concept trên toàn cục, trong khi các truy vấn đề xuất chỉ tập trung vào định vị, tránh các mục tiêu xung đột.
- Thống nhất concept và prompt trực quan: Hỗ trợ cả PCS (prompt concept) và PVS (prompt trực quan như thao tác nhấp/khung của SAM 2) trong cùng một model.
- Tinh chỉnh exemplar tương tác: Người dùng có thể thêm exemplar ảnh dương tính hoặc âm tính để tinh chỉnh kết quả theo cách lặp lại; model khái quát hóa sang các đối tượng tương tự thay vì chỉ sửa từng instance riêng lẻ.
- Phân giải mơ hồ theo thời gian: Sử dụng điểm phát hiện masklet và việc đặt lại prompt định kỳ để xử lý hiện tượng che khuất, cảnh đông đúc và lỗi theo dõi trong video, phù hợp với các phương pháp thực hành tốt nhất về phân đoạn instance và theo dõi.
Dataset SA-Co#
SAM 3 được huấn luyện trên Segment Anything with Concepts (SA-Co), dataset phân đoạn lớn nhất và đa dạng nhất từ trước đến nay của Meta, mở rộng vượt ra ngoài các benchmark phổ biến như COCO và LVIS.
Dữ liệu huấn luyện#
| Thành phần dataset | Mô tả | Quy mô |
|---|---|---|
| SA-Co/HQ | Dữ liệu ảnh chất lượng cao do con người gán nhãn từ data engine 4 giai đoạn | 5.2M ảnh, 4M cụm danh từ duy nhất |
| SA-Co/SYN | Dataset tổng hợp được AI gán nhãn mà không có sự tham gia của con người | 38M cụm danh từ, 1.4B mask |
| SA-Co/EXT | 15 dataset bên ngoài được bổ sung các hard negative | Thay đổi tùy theo nguồn |
| SA-Co/VIDEO | Chú giải video có theo dõi theo thời gian | 52.5K video, 24.8K cụm danh từ duy nhất |
Dữ liệu benchmark#
Benchmark đánh giá SA-Co bao gồm 214K cụm từ duy nhất trên 126K ảnh và video, cung cấp số lượng concept nhiều hơn 50× so với các benchmark hiện có. Benchmark này bao gồm:
- SA-Co/Gold: 7 lĩnh vực, được chú giải ba lần để đo lường giới hạn hiệu suất của con người
- SA-Co/Silver: 10 lĩnh vực, được con người chú giải một lần
- SA-Co/Bronze và SA-Co/Bio: 9 dataset hiện có được điều chỉnh cho phân đoạn concept
- SA-Co/VEval: Benchmark video gồm 3 lĩnh vực (SA-V, YT-Temporal-1B, SmartGlasses)
Đổi mới trong data engine#
Data engine có khả năng mở rộng, kết hợp con người và model trong vòng lặp của SAM 3 đạt thông lượng chú giải cao gấp 2× thông qua:
- Công cụ gán nhãn AI: Các model dựa trên Llama đề xuất nhiều cụm danh từ đa dạng, bao gồm cả mẫu âm khó
- Bộ xác minh AI: LLM đa phương thức được fine-tune xác minh chất lượng mask và tính toàn diện ở mức hiệu suất gần bằng con người
- Khai thác chủ động: Tập trung nỗ lực của con người vào các trường hợp lỗi khó mà AI gặp khó khăn
- Dựa trên ontology: Sử dụng ontology quy mô lớn, được xây dựng dựa trên Wikidata, để bao phủ các khái niệm
Cài đặt#
Cài đặt hoặc nâng cấp package ultralytics:
pip install -U ultralyticsKhông giống các model Ultralytics khác, trọng số SAM 3 (sam3.pt) không được tự động tải xuống. Trước tiên, bạn phải yêu cầu quyền truy cập trọng số model trên trang model SAM 3 trên Hugging Face, sau đó tải sam3.pt từ trang này khi được phê duyệt. Đặt file sam3.pt đã tải xuống trong thư mục làm việc hoặc chỉ định đường dẫn đầy đủ khi tải model.
Trọng số SAM 3.1 (sam3.1_multiplex.pt) cũng bị giới hạn quyền truy cập theo cách tương tự trên trang model SAM 3.1. Truyền sam3.1_multiplex.pt ở mọi nơi mà các ví dụ hình ảnh bên dưới sử dụng sam3.pt.
Nếu gặp lỗi trên khi dự đoán, điều đó có nghĩa là bạn đã cài đặt sai package clip. Cài đặt package clip chính xác bằng cách chạy lệnh sau:
pip uninstall clip -y
pip install git+https://github.com/ultralytics/CLIP.git
Cách sử dụng SAM 3: Tính linh hoạt trong phân đoạn concept#
SAM 3 hỗ trợ cả tác vụ phân đoạn concept có thể prompt (PCS) và phân đoạn trực quan có thể prompt (PVS) thông qua các interface predictor khác nhau:
Các tác vụ và model được hỗ trợ#
| Loại tác vụ | Loại prompt | Đầu ra |
|---|---|---|
| Phân đoạn concept (PCS) | Văn bản (cụm danh từ), exemplar ảnh | Tất cả instance khớp với concept |
| Phân đoạn trực quan (PVS) | Điểm, khung, mask | Một instance đối tượng đơn lẻ (kiểu SAM 2) |
| Tinh chỉnh tương tác | Thêm/xóa exemplar hoặc thao tác nhấp theo cách lặp lại | Phân đoạn được tinh chỉnh với độ chính xác cao hơn |
Ví dụ phân đoạn concept#
Phân đoạn bằng prompt văn bản#
Tìm và phân đoạn tất cả instance của một concept bằng mô tả văn bản. Prompt văn bản yêu cầu interface SAM3SemanticPredictor.
from ultralytics.models.sam import SAM3SemanticPredictor

# Khởi tạo predictor bằng cấu hình
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "model": "sam3.pt",
    "quantize": 16,  # Dùng FP16 để suy luận nhanh hơn
    "save": True,
}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Thiết lập ảnh một lần cho nhiều truy vấn
predictor.set_image("path/to/image.jpg")

# Truy vấn bằng nhiều prompt văn bản
results = predictor(text=["person", "bus", "glasses"])

# Hoạt động với các cụm từ mô tả
results = predictor(text=["person with red cloth", "person with blue cloth"])

# Truy vấn bằng một concept
results = predictor(text=["a person"])
Phân đoạn bằng exemplar ảnh#
Dùng bounding box làm prompt trực quan để tìm tất cả instance tương tự. Cách này cũng yêu cầu SAM3SemanticPredictor để đối sánh dựa trên concept.
from ultralytics.models.sam import SAM3SemanticPredictor

# Khởi tạo predictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16, "save": True}
predictor = SAM3SemanticPredictor(overrides=overrides)

# Thiết lập ảnh
predictor.set_image("path/to/image.jpg")

# Cung cấp các ví dụ bounding box để phân đoạn những đối tượng tương tự
results = predictor(bboxes=[[480.0, 290.0, 590.0, 650.0]])

# Nhiều bounding box làm exemplar cho cùng một concept trực quan
results = predictor(bboxes=[[539, 599, 589, 639], [343, 267, 499, 662]])
Suy luận dựa trên feature để tăng hiệu quả#
Trích xuất feature ảnh một lần và tái sử dụng cho nhiều truy vấn phân đoạn để cải thiện hiệu quả.
import cv2

from ultralytics.models.sam import SAM3SemanticPredictor
from ultralytics.utils.plotting import Annotator, colors

# Khởi tạo các predictor
overrides = {"conf": 0.50, "task": "segment", "mode": "predict", "model": "sam3.pt", "verbose": False}
predictor = SAM3SemanticPredictor(overrides=overrides)
predictor2 = SAM3SemanticPredictor(overrides=overrides)

# Trích xuất feature từ predictor thứ nhất
source = "path/to/image.jpg"
predictor.set_image(source)
src_shape = cv2.imread(source).shape[:2]

# Thiết lập predictor thứ hai và tái sử dụng feature
predictor2.setup_model()

# Thực hiện suy luận bằng feature dùng chung với prompt văn bản
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, text=["person"])

# Thực hiện suy luận bằng feature dùng chung với prompt bounding box
masks, boxes = predictor2.inference_features(predictor.features, src_shape=src_shape, bboxes=[[439, 437, 524, 709]])

# Trực quan hóa kết quả
if masks is not None:
    masks, boxes = masks.cpu().numpy(), boxes.cpu().numpy()
    im = cv2.imread(source)
    annotator = Annotator(im, pil=False)
    annotator.masks(masks, [colors(x, True) for x in range(len(masks))])

    cv2.imshow("result", annotator.result())
    cv2.waitKey(0)
Phân đoạn concept trong video#
Theo dõi concept xuyên suốt video bằng bounding box#
Phát hiện và theo dõi các instance đối tượng qua các frame video bằng prompt bounding box.
from ultralytics.models.sam import SAM3VideoPredictor

# Tạo predictor video
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "model": "sam3.pt", "quantize": 16}
predictor = SAM3VideoPredictor(overrides=overrides)

# Theo dõi đối tượng bằng prompt bounding box
results = predictor(source="path/to/video.mp4", bboxes=[[706.5, 442.5, 905.25, 555], [598, 635, 725, 750]], stream=True)

# Xử lý và hiển thị kết quả
for r in results:
    r.show()  # Hiển thị frame với các mask phân đoạn
Theo dõi concept bằng prompt văn bản#
Theo dõi tất cả instance của các concept được chỉ định bằng văn bản qua các frame video.
from ultralytics.models.sam import SAM3VideoSemanticPredictor

# Khởi tạo predictor video ngữ nghĩa
overrides = {
    "conf": 0.25,
    "task": "segment",
    "mode": "predict",
    "imgsz": 640,
    "model": "sam3.pt",
    "quantize": 16,
    "save": True,
}
predictor = SAM3VideoSemanticPredictor(overrides=overrides)

# Theo dõi concept bằng prompt văn bản
results = predictor(source="path/to/video.mp4", text=["person", "bicycle"], stream=True)

# # Xử lý kết quả
for r in results:
    r.show()  # Hiển thị frame với các đối tượng được theo dõi

# Cách khác: Theo dõi bằng prompt bounding box
results = predictor(
    source="path/to/video.mp4",
    bboxes=[[864, 383, 975, 620], [705, 229, 782, 402]],
    labels=[1, 1],  # Nhãn dương tính
    stream=True,
)
Prompt trực quan (tương thích với SAM 2)#
SAM 3 duy trì khả năng tương thích ngược hoàn toàn với tính năng prompt trực quan của SAM 2 để phân đoạn một đối tượng đơn lẻ:
Interface cơ bản SAM hoạt động chính xác như SAM 2, chỉ phân đoạn vùng cụ thể được chỉ ra bằng prompt trực quan (điểm, khung hoặc mask).
from ultralytics import SAM

model = SAM("sam3.pt")

# Prompt một điểm - phân đoạn đối tượng tại vị trí cụ thể
results = model.predict(source="path/to/image.jpg", points=[900, 370], labels=[1])
results[0].show()

# Nhiều điểm - phân đoạn một đối tượng bằng nhiều gợi ý điểm
results = model.predict(source="path/to/image.jpg", points=[[400, 370], [900, 370]], labels=[1, 1])

# Prompt hộp - phân đoạn đối tượng bên trong hộp giới hạn
results = model.predict(source="path/to/image.jpg", bboxes=[100, 150, 300, 400])
results[0].show()Dùng SAM("sam3.pt") với prompt trực quan (điểm/hộp/mask) sẽ chỉ phân đoạn đối tượng cụ thể tại vị trí đó, tương tự SAM 2. Để phân đoạn tất cả các instance của một khái niệm, hãy dùng SAM3SemanticPredictor với prompt văn bản hoặc prompt mẫu như minh họa ở trên.
Đánh giá hiệu năng#
Phân đoạn ảnh#
SAM 3 đạt kết quả tiên tiến trên nhiều benchmark, bao gồm các dataset thực tế như LVIS và COCO cho phân đoạn:
| Benchmark | Chỉ số | SAM 3 | Kết quả tốt nhất trước đây | Mức cải thiện |
|---|---|---|---|---|
| LVIS (zero-shot) | Mask AP | 47.0 | 38.5 | +22.1% |
| SA-Co/Gold | CGF1 | 65.0 | 34.3 (OWLv2) | +89.5% |
| COCO (zero-shot) | Box AP | 53.5 | 52.2 (T-Rex2) | +2.5% |
| ADE-847 (phân đoạn ngữ nghĩa) | mIoU | 14.7 | 9.2 (APE-D) | +59.8% |
| PascalConcept-59 | mIoU | 59.4 | 58.5 (APE-D) | +1.5% |
| Cityscapes (phân đoạn ngữ nghĩa) | mIoU | 65.1 | 44.2 (APE-D) | +47.3% |
Khám phá các tùy chọn dataset để thử nghiệm nhanh trong dataset của Ultralytics.
Hiệu năng phân đoạn video#
SAM 3 cho thấy mức cải thiện đáng kể so với SAM 2 và các phương pháp tiên tiến nhất trước đây trên những benchmark video như DAVIS 2017 và YouTube-VOS:
| Benchmark | Chỉ số | SAM 3 | SAM 2.1 L | Mức cải thiện |
|---|---|---|---|---|
| MOSEv2 | J&F | 60.1 | 47.9 | +25.5% |
| DAVIS 2017 | J&F | 92.0 | 90.7 | +1.4% |
| LVOSv2 | J&F | 88.2 | 79.6 | +10.8% |
| SA-V | J&F | 84.6 | 78.4 | +7.9% |
| YTVOS19 | J&F | 89.6 | 89.3 | +0.3% |
Thích ứng few-shot#
SAM 3 thích ứng với miền mới chỉ bằng một vài ví dụ, phù hợp với quy trình AI lấy dữ liệu làm trọng tâm:
| Benchmark | AP 0-shot | AP 10-shot | Kết quả tốt nhất trước đây (10-shot) |
|---|---|---|---|
| ODinW13 | 59.9 | 71.6 | 67.9 (gDino1.5-Pro) |
| RF100-VL | 14.3 | 35.7 | 33.7 (gDino-T) |
Hiệu quả tinh chỉnh tương tác#
Prompt dựa trên khái niệm với các ví dụ mẫu của SAM 3 hội tụ nhanh hơn nhiều so với prompt trực quan:
| Số prompt được thêm | Điểm CGF1 | Mức tăng so với chỉ dùng văn bản | Mức tăng so với baseline PVS |
|---|---|---|---|
| Chỉ văn bản | 46.4 | baseline | baseline |
| +1 ví dụ mẫu | 57.6 | +11.2 | +6.7 |
| +2 ví dụ mẫu | 62.2 | +15.8 | +9.7 |
| +3 ví dụ mẫu | 65.0 | +18.6 | +11.2 |
| +4 ví dụ mẫu | 65.7 | +19.3 | +11.5 (chững lại) |
Độ chính xác đếm đối tượng#
SAM 3 đếm chính xác bằng cách phân đoạn tất cả các instance, một yêu cầu phổ biến trong bài toán đếm đối tượng:
| Benchmark | Độ chính xác | MAE | so với MLLM tốt nhất |
|---|---|---|---|
| CountBench | 95.6% | 0.11 | 92.4% (Gemini 2.5) |
| PixMo-Count | 87.3% | 0.22 | 88.8% (Molmo-72B) |
So sánh SAM 3, SAM 2 và YOLO#
Sau đây là so sánh khả năng của SAM 3 với SAM 2 và các model YOLO26:
| Khả năng | SAM 3 | SAM 2 | YOLO26n-seg |
|---|---|---|---|
| Phân đoạn theo khái niệm | ✅ Tất cả instance từ văn bản/ví dụ mẫu | ❌ Không hỗ trợ | ❌ Không hỗ trợ |
| Phân đoạn trực quan | ✅ Một instance (tương thích với SAM 2) | ✅ Một instance | ✅ Tất cả instance |
| Khả năng zero-shot | ✅ Từ vựng mở | ✅ Prompt hình học | ❌ Tập nhãn đóng |
| Tinh chỉnh tương tác | ✅ Ví dụ mẫu + click | ✅ Chỉ click | ❌ Không hỗ trợ |
| Theo dõi video | ✅ Nhiều đối tượng, có định danh | ✅ Nhiều đối tượng | ✅ Nhiều đối tượng |
| LVIS Mask AP (zero-shot) | 47.0 | Không áp dụng | Không áp dụng |
| MOSEv2 J&F | 60.1 | 47.9 | Không áp dụng |
| Tốc độ (GPU, ms/ảnh) | 2921 | 857 | 8.4 |
| Kích thước model | 3.45 GB | 162 MB (bản base) | 6.4 MB |
Tốc độ được benchmark trên NVIDIA RTX PRO 6000 với torch==2.9.1 và ultralytics==8.4.19.
Điểm chính:
- SAM 3: Phù hợp nhất cho phân đoạn khái niệm với từ vựng mở, tìm tất cả instance của một khái niệm bằng prompt văn bản hoặc ví dụ mẫu
- SAM 2: Phù hợp nhất cho phân đoạn tương tác một đối tượng trong ảnh và video bằng prompt hình học
- YOLO26: Phù hợp nhất cho phân đoạn tốc độ cao theo thời gian thực, có tùy chọn suy luận end-to-end không cần NMS, có thể export sang nhiều định dạng để triển khai trên GPU, CPU và thiết bị biên
- YOLOE: Phù hợp nhất cho phát hiện và phân đoạn từ vựng mở theo thời gian thực bằng prompt văn bản hoặc hình ảnh
So sánh SAM với YOLO#
So sánh SAM 3, SAM 2, SAM, MobileSAM và FastSAM với các model phân đoạn Ultralytics YOLO (YOLOv8, YOLO11, YOLO26) về kích thước, số lượng tham số và tốc độ suy luận trên GPU:
| Model | Kích thước (MB) | Tham số (M) | Tốc độ (GPU) (ms/ảnh) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 1306 |
| Meta SAM2-b | 162 | 80.8 | 857 |
| Meta SAM2-t | 78.1 | 38.9 | 668 |
| Meta SAM3 | 3450 | 473.6 | 2921 |
| MobileSAM | 40.7 | 10.1 | 605 |
| FastSAM-s với backbone YOLOv8 | 23.7 | 11.8 | 55.9 |
| Ultralytics YOLOv8n-seg | 6.7 (nhỏ hơn 515 lần) | 3.4 (ít hơn 139.1 lần) | 17.4 (nhanh hơn 167 lần) |
| Ultralytics YOLO11n-seg | 5.9 (nhỏ hơn 585 lần) | 2.9 (ít hơn 163.1 lần) | 12.6 (nhanh hơn 231 lần) |
| Ultralytics YOLO26n-seg | 6.4 (nhỏ hơn 539 lần) | 2.7 (ít hơn 175.2 lần) | 8.4 (nhanh hơn 347 lần) |
So sánh này cho thấy sự khác biệt đáng kể về kích thước và tốc độ giữa các biến thể SAM và model phân đoạn YOLO. SAM có khả năng phân đoạn tự động độc đáo, nhưng các model YOLO, đặc biệt là YOLOv8n-seg, YOLO11n-seg và YOLO26n-seg, nhỏ hơn, nhanh hơn và hiệu quả tính toán hơn đáng kể.
Các bài kiểm tra chạy trên NVIDIA RTX PRO 6000 với VRAM 96GB, sử dụng torch==2.9.1 và ultralytics==8.4.19. Để tái tạo bài kiểm tra này:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# Lập hồ sơ SAM3, SAM2-t, SAM2-b, SAM-b, MobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt", "sam3.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# Lập hồ sơ FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# Lập hồ sơ các model YOLO
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    model(ASSETS, nms=False)  # Đầu NMS-free của YOLO26; không có tác dụng với YOLOv8/YOLO11
Các chỉ số đánh giá#
SAM 3 giới thiệu các chỉ số mới dành cho tác vụ PCS, bổ sung cho những thước đo quen thuộc như điểm F1, độ chính xác và độ bao phủ.
F1 có xét đến phân loại (CGF1)#
Chỉ số chính kết hợp khả năng định vị và phân loại:
CGF1 = 100 × pmF1 × IL_MCC
Trong đó:
- pmF1 (F1 macro dương): Đo chất lượng định vị trên các mẫu dương tính
- IL_MCC (Hệ số tương quan Matthews cấp ảnh): Đo độ chính xác phân loại nhị phân ("có khái niệm này không?")
Vì sao dùng các chỉ số này?#
Các chỉ số AP truyền thống không tính đến khả năng hiệu chuẩn, khiến model khó áp dụng trong thực tế. Bằng cách chỉ đánh giá các dự đoán có độ tin cậy trên 0.5, các chỉ số của SAM 3 buộc model phải được hiệu chuẩn tốt và mô phỏng cách sử dụng thực tế trong các vòng lặp dự đoán tương tác và theo dõi.
Các thí nghiệm loại bỏ thành phần và thông tin chuyên sâu chính#
Tác động của nhánh nhận diện sự hiện diện#
Nhánh nhận diện sự hiện diện tách biệt khả năng nhận dạng khỏi định vị, mang lại cải thiện đáng kể:
| Cấu hình | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Không có nhánh nhận diện sự hiện diện | 57.6 | 0.77 | 74.7 |
| Có nhánh nhận diện sự hiện diện | 63.3 | 0.82 | 77.1 |
Nhánh nhận diện sự hiện diện giúp CGF1 tăng 5.7 điểm (+9.9%), chủ yếu nhờ cải thiện khả năng nhận dạng (IL_MCC tăng 6.5%).
Tác động của mẫu âm khó#
| Mẫu âm khó/Ảnh | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| 0 | 31.8 | 0.44 | 70.2 |
| 5 | 44.8 | 0.62 | 71.9 |
| 30 | 49.2 | 0.68 | 72.3 |
Mẫu âm khó đóng vai trò thiết yếu trong nhận dạng từ vựng mở, giúp IL_MCC tăng 54.5% (0.44 → 0.68).
Mở rộng quy mô dữ liệu huấn luyện#
| Nguồn dữ liệu | CGF1 | IL_MCC | pmF1 |
|---|---|---|---|
| Chỉ dữ liệu bên ngoài | 30.9 | 0.46 | 66.3 |
| Dữ liệu bên ngoài + dữ liệu tổng hợp | 39.7 | 0.57 | 70.6 |
| Dữ liệu bên ngoài + dữ liệu chất lượng cao | 51.8 | 0.71 | 73.2 |
| Cả ba | 54.3 | 0.74 | 73.5 |
Chú thích do con người tạo có chất lượng cao mang lại mức cải thiện lớn so với chỉ sử dụng dữ liệu tổng hợp hoặc dữ liệu bên ngoài. Để tìm hiểu về các phương pháp đảm bảo chất lượng dữ liệu, xem thu thập và chú thích dữ liệu.
Ứng dụng#
Khả năng phân đoạn khái niệm của SAM 3 mở ra các trường hợp sử dụng mới:
- Kiểm duyệt nội dung: Tìm tất cả các trường hợp thuộc loại nội dung cụ thể trong thư viện media
- Thương mại điện tử: Phân đoạn tất cả sản phẩm thuộc một loại nhất định trong ảnh danh mục, hỗ trợ tự động chú thích
- Chẩn đoán hình ảnh y khoa: Xác định mọi vị trí xuất hiện của các loại mô hoặc bất thường cụ thể
- Hệ thống tự hành: Theo dõi mọi biển báo giao thông, người đi bộ hoặc phương tiện theo danh mục
- Phân tích video: Đếm và theo dõi tất cả người mặc trang phục cụ thể hoặc thực hiện hành động nhất định
- Chú thích bộ dữ liệu: Nhanh chóng chú thích mọi trường hợp thuộc các danh mục đối tượng hiếm
- Nghiên cứu khoa học: Định lượng và phân tích tất cả mẫu vật đáp ứng các tiêu chí cụ thể
SAM 3 Agent: Suy luận ngôn ngữ mở rộng#
Có thể kết hợp SAM 3 với các mô hình ngôn ngữ lớn đa phương thức (MLLMs) để xử lý các truy vấn phức tạp đòi hỏi suy luận, tương tự như các hệ thống từ vựng mở như OWLv2 và T-Rex.
Hiệu năng trên các tác vụ suy luận#
| Benchmark | Chỉ số | SAM 3 Agent (Gemini 2.5 Pro) | Kết quả tốt nhất trước đây |
|---|---|---|---|
| ReasonSeg (tập validation) | gIoU | 76.0 | 65.0 (SoTA) |
| ReasonSeg (tập test) | gIoU | 73.8 | 61.3 (SoTA) |
| OmniLabel (tập validation) | AP | 46.7 | 36.5 (REAL) |
| RefCOCO+ | Acc | 91.2 | 89.3 (LISA) |
Ví dụ về truy vấn phức tạp#
SAM 3 Agent có thể xử lý các truy vấn đòi hỏi suy luận:
- "Những người đang ngồi nhưng không cầm hộp quà trên tay"
- "Con chó gần máy ảnh nhất và không đeo vòng cổ"
- "Các vật thể màu đỏ lớn hơn bàn tay của người đó"
MLLM đề xuất các truy vấn cụm danh từ đơn giản cho SAM 3, phân tích các mask được trả về và lặp lại cho đến khi đạt yêu cầu.
Hạn chế#
SAM 3 có những hạn chế sau:
- Độ phức tạp của cụm từ: Phù hợp nhất với các cụm danh từ đơn giản; biểu thức quy chiếu dài hoặc suy luận phức tạp có thể cần tích hợp MLLM
- Xử lý sự mơ hồ: Một số khái niệm vốn dĩ vẫn mơ hồ (ví dụ: "cửa sổ nhỏ", "căn phòng ấm cúng")
- Yêu cầu tính toán: Lớn hơn và chậm hơn các model phát hiện chuyên biệt như YOLO
- Phạm vi từ vựng: Tập trung vào các khái niệm thị giác đơn lẻ; khả năng suy luận tổ hợp bị hạn chế nếu không có MLLM hỗ trợ
- Khái niệm hiếm: Hiệu năng có thể suy giảm với các khái niệm cực hiếm hoặc chi tiết mà dữ liệu huấn luyện không đại diện đầy đủ
Trích dẫn#
@misc{carion2025sam3,
  title         = {SAM 3: Segment Anything with Concepts},
  author        = {Nicolas Carion and Laura Gustafson and Yuan-Ting Hu and Shoubhik Debnath and Ronghang Hu and Didac Suris and Chaitanya Ryali and Kalyan Vasudev Alwala and Haitham Khedr and Andrew Huang and Jie Lei and Tengyu Ma and Baishan Guo and Arpit Kalla and Markus Marks and Joseph Greer and Meng Wang and Peize Sun and Roman R{\"a}dle and Triantafyllos Afouras and Effrosyni Mavroudi and Katherine Xu and Tsung-Han Wu and Yu Zhou and Liliane Momeni and Rishi Hazra and Shuangrui Ding and Sagar Vaze and Francois Porcher and Feng Li and Siyuan Li and Aishwarya Kamath and Ho Kei Cheng and Piotr Doll{\'a}r and Nikhila Ravi and Kate Saenko and Pengchuan Zhang and Christoph Feichtenhofer},
  year          = {2025},
  eprint        = {2511.16719},
  archivePrefix = {arXiv},
  primaryClass  = {cs.CV},
  url           = {https://arxiv.org/abs/2511.16719}
}
Câu hỏi thường gặp#
SAM 3 được Meta phát hành vào ngày 19 tháng 11 năm 2025 và được tích hợp hoàn toàn vào package
ultralytics, hỗ trợ dự đoán ảnh và theo dõi video thông qua các predictor chuyên dụng.Có. SAM 3 được tích hợp hoàn toàn vào package Python Ultralytics, bao gồm phân đoạn khái niệm, prompt thị giác kiểu SAM 2 và theo dõi nhiều đối tượng trong video. SAM 3 và SAM 3.1 cũng hỗ trợ tính năng gán nhãn thông minh trên Ultralytics Platform, trong đó SAM 3.1 là model mặc định và bạn có thể gán nhãn ảnh chỉ với vài cú nhấp. Trên các dataset phát hiện có 1–200 lớp, SAM 3 Text và SAM 3.1 Text cũng tự động gán nhãn dựa trên tên lớp, còn Bảng xếp hạng VLM so sánh độ chính xác của chúng với các model ngôn ngữ-thị giác.
Có, dùng để dự đoán trên ảnh. Tải
sam3.1_multiplex.ptở mọi nơi mà các ví dụ ảnh trên trang này dùngsam3.pt:SAM("sam3.1_multiplex.pt")cho prompt điểm và hộp, cònSAM3SemanticPredictorcho prompt văn bản và exemplar. Tính năng theo dõi video Object Multiplex hiện chưa được hỗ trợ, vì vậy hãy tiếp tục dùngsam3.ptvới các predictor video. Xem SAM 3.1 để biết benchmark của Meta.PCS là tác vụ mới được giới thiệu trong SAM 3, dùng để phân đoạn tất cả các trường hợp của một khái niệm thị giác trong ảnh hoặc video. Khác với phân đoạn truyền thống nhắm đến một đối tượng cụ thể, PCS tìm mọi lần xuất hiện của một danh mục. Ví dụ:
- Prompt văn bản: "xe buýt trường học màu vàng" → phân đoạn tất cả xe buýt trường học màu vàng trong cảnh
- Ảnh mẫu: Khoanh vùng một con chó → phân đoạn tất cả chó trong ảnh
- Kết hợp: "mèo vằn" + hộp ảnh mẫu → phân đoạn tất cả mèo vằn khớp với ví dụ
Tính năng SAM 2 SAM 3 Tác vụ Một đối tượng cho mỗi prompt Tất cả thực thể của một khái niệm Loại prompt Điểm, khung, mask + Cụm từ văn bản, ảnh mẫu Khả năng phát hiện Cần detector bên ngoài Detector open-vocabulary tích hợp sẵn Nhận dạng Chỉ dựa trên hình học Nhận dạng văn bản và hình ảnh Kiến trúc Chỉ tracker Detector + tracker cùng head xác định sự hiện diện Hiệu suất zero-shot N/A (cần prompt hình ảnh) 47.0 AP trên LVIS, tốt hơn 2× trên SA-Co Tinh chỉnh tương tác Chỉ thao tác nhấp Thao tác nhấp + khả năng khái quát hóa từ ảnh mẫu SAM 3 duy trì khả năng tương thích ngược với prompt hình ảnh của SAM 2, đồng thời bổ sung các khả năng dựa trên khái niệm.
SAM 3 được huấn luyện trên bộ dữ liệu Segment Anything with Concepts (SA-Co):
Dữ liệu huấn luyện:
- 5.2M ảnh với 4M cụm danh từ duy nhất (SA-Co/HQ) - chú giải chất lượng cao do con người thực hiện
- 52.5K video với 24.8K cụm danh từ duy nhất (SA-Co/VIDEO)
- 1.4B mask tổng hợp trên 38M cụm danh từ (SA-Co/SYN)
- 15 bộ dữ liệu bên ngoài được bổ sung các mẫu âm khó (SA-Co/EXT)
Dữ liệu benchmark:
- 214K khái niệm duy nhất trên 126K ảnh/video
- Nhiều hơn 50× khái niệm so với các benchmark hiện có (ví dụ: LVIS có ~4K khái niệm)
- Chú giải ba lần trên SA-Co/Gold để đo giới hạn hiệu suất của con người
Quy mô và tính đa dạng này là nền tảng cho khả năng khái quát hóa zero-shot của SAM 3 trên các khái niệm từ vựng mở.
SAM 3 và YOLO26 phục vụ các trường hợp sử dụng khác nhau:
Ưu điểm của SAM 3:
- Open-vocabulary: Phân đoạn mọi khái niệm thông qua prompt văn bản mà không cần huấn luyện
- Zero-shot: Có thể xử lý ngay các danh mục mới
- Tương tác: Tinh chỉnh dựa trên ảnh mẫu sẽ khái quát hóa cho các đối tượng tương tự
- Dựa trên khái niệm: Tự động tìm tất cả thực thể thuộc một danh mục
- Độ chính xác: 47.0 AP cho phân đoạn thực thể zero-shot trên LVIS
Ưu điểm của YOLO26:
- Tốc độ: Tốc độ suy luận nhanh hơn nhiều bậc độ lớn, với head end-to-end không cần NMS tùy chọn
- Hiệu quả: Model nhỏ hơn 539× (6.4MB so với 3.45GB)
- Thân thiện với tài nguyên: Chạy được trên thiết bị edge và thiết bị di động
- Thời gian thực: Được tối ưu hóa cho triển khai trong môi trường production
Khuyến nghị:
- Dùng SAM 3 để phân đoạn linh hoạt theo open-vocabulary khi cần tìm tất cả thực thể thuộc các khái niệm được mô tả bằng văn bản hoặc ví dụ
- Dùng YOLO26 để triển khai tốc độ cao trong môi trường production khi các danh mục đã được xác định trước
- Dùng SAM 2 để phân đoạn tương tác một đối tượng với prompt hình học
SAM 3 được thiết kế cho các cụm danh từ đơn giản (ví dụ: "táo đỏ", "người đội mũ"). Với các truy vấn phức tạp cần suy luận, hãy kết hợp SAM 3 với MLLM thành SAM 3 Agent:
Truy vấn đơn giản (SAM 3 nguyên bản):
- "xe buýt trường học màu vàng"
- "mèo vằn"
- "người đội mũ đỏ"
Truy vấn phức tạp (SAM 3 Agent với MLLM):
- "Những người đang ngồi nhưng không cầm hộp quà"
- "Con chó gần máy ảnh nhất nhưng không đeo vòng cổ"
- "Các vật thể màu đỏ lớn hơn bàn tay của người đó"
SAM 3 Agent đạt 76.0 gIoU trên tập validation của ReasonSeg (so với mức tốt nhất trước đó là 65.0, cải thiện +16.9%) nhờ kết hợp khả năng phân đoạn của SAM 3 với năng lực suy luận của MLLM.
Trên benchmark SA-Co/Gold với chú giải ba lần do con người thực hiện:
- Cận dưới của con người: 74.2 CGF1 (người chú giải thận trọng nhất)
- Hiệu suất của SAM 3: 65.0 CGF1
- Kết quả đạt được: 88% cận dưới ước tính của con người
- Cận trên của con người: 81.4 CGF1 (người chú giải rộng lượng nhất)
SAM 3 đạt hiệu suất cao, tiệm cận độ chính xác cấp độ con người trong phân đoạn khái niệm open-vocabulary; khoảng cách chủ yếu nằm ở các khái niệm mơ hồ hoặc mang tính chủ quan (ví dụ: "cửa sổ nhỏ", "căn phòng ấm cúng").


Bình luận105
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 Glenn JocherUltralytics(đã chỉnh sửa)
SAM 3 looks like a big step forward for open-vocabulary segmentation, and it is now supported natively in
ultralytics. This page covers text, exemplar and video prompts; thesam3.ptweights are gated and must be requested from Meta on Hugging Face first.Feel free to drop questions or comments for the team below!
7koolfox
Incredible, when you think it’s available for use?
2- Glenn JocherUltralytics(đã chỉnh sửa)
SAM 3 is available now in
ultralytics: runpip install -U ultralyticsand see this page for usage. Thesam3.ptweights must be requested from Meta first. Abdulhady-WITCo
Appreciate the effort, and can't wait for your implementation. It's resource heavy already but I'm sure your optimisation will make a difference. Best of luck.
- Glenn JocherUltralytics(đã chỉnh sửa)
Thanks for the kind words—most of the credit goes to the Meta SAM team and the Ultralytics community. SAM 3 is now available in
ultralytics, and this page covers exactly those trade-offs, so you can balance its open-vocabulary power against lighter options like YOLO26 or SAM 2 on your hardware.
mishaogui
sam3如何把預訓練模型導出onnx進行推理,目前官方好像還不支持導出,求導出和推理。
1- Glenn JocherUltralytics(đã chỉnh sửa)
目前
ultralytics里 SAM 3 只支持predict/track推理,还没有提供把sam3.pt导出 ONNX 的官方流程(yolo export主要面向 YOLO 等可部署导出管线的模型);建议先按 SAM 3 使用文档 用 PyTorch 方式部署推理。如果你的目标是 ONNX 部署分割(固定类别/已知类别),更推荐直接用可导出的 YOLO26 分割 并参考 Export 模式;若你这边是“必须 SAM3→ONNX”的需求,麻烦在 Ultralytics 新建 Issue 说明场景并附上
yolo checks和最小复现脚本,方便我们评估支持路径。
tomer196
Hi, thanks for the great work. I am trying to use sam3.1. Is it supported? I tried using sam3.1 weights, and it seems to work, but each frame the objects get new IDs. Am I doing something wrong? Thanks
- Glenn JocherUltralytics(đã chỉnh sửa)
SAM 3.1 is supported for image prediction: load
sam3.1_multiplex.ptwherever the image examples usesam3.pt(SAM("sam3.1_multiplex.pt")for point and box prompts,SAM3SemanticPredictorfor text and exemplar prompts). Object Multiplex video tracking is not supported yet, so usesam3.ptwithSAM3VideoPredictororSAM3VideoSemanticPredictor. For stable identities across frames, run a video predictor on the full video rather than image inference frame-by-frame, since per-frame inference assigns fresh IDs each time. See the SAM 3 docs and the SAM predictor reference, and if you’re already doing that please drop a minimal repro plusyolo checksoutput here so the team can take a closer look.
yccckid
你好,我测试下来输入的常见的类别的提示词(包括一些限定词)都是可以分割的。不过提示词输入得越多确实MLLM时间会更长,sam分割倒是挺快的。你说的这个“ 只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象 ”是在分割什么物体?物体的表面纹理是不是比较sparsely textured?怎么解决的?谢谢
On Thu, 23 Apr 2026 at 09:11, Yiwang2333 @.***> wrote:
我之前使用MLLM与SAM3结合起来成为SAM 3 Agent进行测试并没有发现分割的掩码出现空洞问题,他们都是完整的,只不过会出现分割不了提示词中的内容,而且耗时这方面会增加,这也正常。只有在单点(正负样本)和掩码提示(精细化粗糙掩码)是会出现分割源码出现零碎和空洞现象
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/22441?email_source=notifications&email_token=APKLLPPMDYK4F36HG6B3BOL4XFUUJA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRWG43TCMBVUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16677105, or unsubscribe https://github.com/notifications/unsubscribe-auth/APKLLPKUZ2OAWS3Y672TETD4XFUUJAVCNFSM6AAAAACJTVH7HGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMNRXG4YTANI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
这种情况更像是
SAM("sam3.pt")的视觉提示分割问题而不是概念分割本身:单点或粗掩码在细长边界、低对比度或稀疏纹理目标上更容易出现碎片和空洞,通常可通过增加正负点、改用更紧的框提示,或直接用SAM3SemanticPredictor做文本/示例提示来改善,相关用法见 SAM 3 文档;如果你愿意,也欢迎把一张示例图和最小复现代码直接发在这个讨论里,我们可以按你的具体 case 看看。 Yiwang2333
其实我也想把示例和代码文件展示出来,但是可能我太蠢了不知道怎么发在这个讨论中,我已急哭😭
- Glenn JocherUltralytics
没关系,直接发在这里就可以:图片可直接拖到评论框上传,代码按 GitHub Markdown 写法 用代码块贴出;如果文件太大,就先发一个最小复现示例,只保留
model初始化、输入图像、提示词和实际输出即可,例如:from ultralytics import SAM model = SAM("sam3.pt") results = model.predict("test.jpg", points=[900, 370], labels=[1]) print(results[0].masks.data.shape if results[0].masks is not None else None)如果暂时不方便传图,也可以先把异常现象和文字版输出贴出来,我们继续帮你看。
一、单点分割 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
正样本(1) + 负样本(0),点数与标签一一对应
point_coords = np.array([ [900.0, 370.0], # 前景点:点在目标上 [800.0, 400.0], # 背景点:点在要排除的区域 ]) point_labels = np.array([1, 0])
masks, scores, logits = model.predict_inst( inference_state, point_coords=point_coords, point_labels=point_labels, multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
二、交互式细化 import numpy as np import torch from PIL import Image from sam3.model_builder import build_sam3_image_model from sam3.model.sam3_image_processor import Sam3Processor
device = "cuda" if torch.cuda.is_available() else "cpu" sam3_pt_path = "sam3_model/sam3.pt"
model = build_sam3_image_model( bpe_path=None, checkpoint_path=sam3_pt_path, device=device, enable_inst_interactivity=True, load_from_HF=False, ) processor = Sam3Processor(model) model.eval()
pil_image = Image.open("test.jpg").convert("RGB") inference_state = processor.set_image(pil_image)
若需要文本提示(与 demo 一致):
inference_state = processor.set_text_prompt(state=inference_state, prompt="your english prompt")
init_x = 900.0 init_y = 370.0 refinement_points = [[910.0, 380.0], [920.0, 360.0]] refinement_labels = [1, 0]
all_points = [[init_x, init_y]] + refinement_points all_labels = [1] + refinement_labels
masks, scores, logits = model.predict_inst( inference_state, point_coords=np.array(all_points), point_labels=np.array(all_labels), multimask_output=True, ) best = masks[int(np.argmax(scores))] mask_np = best.cpu().numpy() if isinstance(best, torch.Tensor) else np.asarray(best) print(mask_np.shape)
测试使用的是同一张图片,分割的内容是图中汽车,在单点分割和交互式细化中正负样本点结合使用会出现分割车辆边缘出现参差不齐零碎现象
- Glenn JocherUltralytics
感谢把代码贴出来,这更像是交互式点提示的行为而不是“汽车”这个类别本身:车窗反光、轮胎空隙和细长边界会让负点一旦靠近车身就容易把掩码边缘切碎或挖空,而且
multimask_output=True返回的最高分候选也不一定是最平滑的那个;建议先把负点移到目标外更远的位置、在断裂边缘补几个正点,或直接改用框/示例提示,如果你的目标是稳定分割整辆车,SAM3SemanticPredictor的文本/示例提示通常比稀疏点提示更稳,相关接口可参考 SAM 3 文档里的视觉提示与概念分割说明。 感谢您的回答,我还有一个问题,就是文本提示分割时,文本提示词可以对多张图片起作用,能做输入一个文本可以对所有图片进行分割,这一个功能已经实现。 但是有一个我实在是难以实现,就是比如有多张图片A、B、C、D...,在纯框选示例提示分割下,能不能做到只在A图上进行框选,然后进行纯框选示例提示分割时可以对A、B、C、D...多张图片进行分割呢。也就是实现一批图片中,只在一张图片上进行框选就能进行所有图片的分割,类似于图片搜索一样,在一批图片中随机挑一张图片,在这张挑选的图片中框选出汽车然后所有图片中的汽车都能被分割出来(类似在一批图片中框选后搜索出有汽车的图片进行分割)。我不知道这个功能是否能做到。 目前我使用的方法是在框选时将框选的目标进行切块,然后拼接在每一张待搜索图片上,最后根据拼接图片中的小目标切块进行示例提示分割,来实现一张图中框选能对所有图片进行分割,不过这种方法的效果有些一般,有时候分割不到东西或者是遗漏一些需要分割的目标。 还有一种方法是评论区向我提供的思路,将几何特征缓存下来,然后再另一张图片上应用这个几何特征,参考https://github.com/leon0514/trt-sam3,但是这位先生也提到了效果不好,目前我也正在尝试实现这种方法。 或者是理解在单图时框选示例提示分割到底在做什么,然后将这个行为重复作用于其他图片,这样是否也能实现呢?
- Glenn JocherUltralytics
目前原生
SAM3SemanticPredictor还不支持“在 A 图框一次,然后直接对 B/C/D 这类独立图片做纯示例检索+分割”;bboxes示例提示是作用在当前set_image()的那张图上,而文档里的inference_features()也是复用同一张图的特征、不是跨图迁移,所以更可靠的做法还是先用文本提示或检索/检测筛出候选图,再逐张做 SAM 3 分割,接口细节可参考 SAM3SemanticPredictor 参考。 好的,谢谢您的回复
shspc
ultralytics支持从其他图像中抽取特征作为视觉提示吗
在SAM3中
- Glenn JocherUltralytics
目前公开接口里,SAM 3 支持用
SAM3SemanticPredictor的bboxes做 exemplar 式视觉提示,也支持用inference_features()复用已提取特征,但文档里的用法主要是对当前图像做特征复用,不是直接把“另一张图像”的特征当作 prompt 传入;你可以先参考 SAM 3 文档 和 predictor API,如果你的目标是跨图像 exemplar prompting,欢迎把最小复现流程贴在这里,团队会继续看。 aoaoy288-oss
想知道,sam3是否能导成ONNX等格式
ZePequeno25
gostei bastante da para integrar diferentes modelos
SWTZJD
想请问SAM3最低支持的python版本和pytorch版本
- Glenn JocherUltralytics
欢迎直接把环境信息贴在这里,团队会看到;按目前公开信息,
SAM 3自ultralytics>=8.3.237起已集成,而ultralytics的基础要求是 Python>=3.8、PyTorch>=1.8,所以SAM 3目前至少按这组版本起步,参考 SAM 3 文档 和 Ultralytics PyPI 安装说明。 (docs.ultralytics.com)
cyt1990cyt1990-dev
运行环境为:Ultralytics 8.4.21 Python-3.11.8 torch-2.5.1+cu121 CUDA:0 (NVIDIA GeForce RTX 4070, 12282MiB) 运行使用掩码提示的概念分割的示例程序报错如下:WARNING imgsz=[640] must be multiple of max stride 14, updating to [644] Traceback (most recent call last): File "C:\Users\admin\PycharmProjects\PythonProject\testMasks.py", line 12, in results = predictor(source=img_path, masks=[rough]) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 225, in call return list(self.stream_inference(source, model, *args, **kwargs)) # merge list of Results into one ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\utils_contextlib.py", line 36, in generator_context response = gen.send(None) ^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\engine\predictor.py", line 330, in stream_inference preds = self.inference(im, *args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 205, in inference return self.prompt_inference(im, bboxes, points, labels, masks, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 236, in prompt_inference return self._inference_features(features, *prompts, multimask_output) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\predict.py", line 814, in _inference_features pred_masks, pred_scores, _, _ = self.model.sam_mask_decoder( ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1736, in _wrapped_call_impl return self._call_impl(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\torch\nn\modules\module.py", line 1747, in _call_impl return forward_call(*args, **kwargs) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 334, in forward masks, iou_pred, mask_tokens_out, object_score_logits = self.predict_masks( ^^^^^^^^^^^^^^^^^^^ File "C:\Users\admin\PycharmProjects\PythonProject.venv\Lib\site-packages\ultralytics\models\sam\modules\decoders.py", line 398, in predict_masks src = src + dense_prompt_embeddings ~~~~^~~~~~~~~~~~~~~~~~~~~~~~~ RuntimeError: The size of tensor a (46) must match the size of tensor b (161) at non-singleton dimension 3
运行代码如下所示: import cv2 import numpy as np from ultralytics.models.sam import SAM3Predictor
predictor = SAM3Predictor(overrides=dict(task="segment", mode="predict", model="sam/sam3.pt")) img_path = "测试图片/测试图片1/Out.jpg" rough = cv2.imread("测试图片/测试图片1/rough.jpg", cv2.IMREAD_GRAYSCALE) rough = (rough > 0).astype(np.uint8)
results = predictor(source=img_path, masks=[rough]) for result in results: annotated_img = result.plot() cv2.imshow("SAM with Mask Prompt", annotated_img) cv2.waitKey(0) cv2.destroyAllWindows()
图片Out.jpg,rough.jpg是大小为4024*3036,位深度为8的灰度图片
- Glenn JocherUltralytics
感谢补充代码,这个报错看起来不是图片分辨率本身的问题,而是
SAM3Predictor走masks=提示时出现了特征尺寸不匹配;按 SAM 3 文档 当前概念分割应使用SAM3SemanticPredictor配合text或示例bboxes,而SAM("sam3.pt")/SAM3Predictor主要是单对象视觉提示流程。若你在最新版本下仍需要masks提示,请新开一个 issue 并附上yolo checks输出、完整文本回溯和最小可复现脚本,方便我们确认这是否是 SAM 3 的一个 bug。
max-dev-14
I'd compared facebook/sam3 and ultralytics/sam3. I set up both the models for inference as follow: imgsz=1008, half=True, conf=0.5 and prompts = [ "person", "car", "truck", "tractor", "building", "combine harvester", "power lines", "clear sky", "trees", "crop field", "harvested field", "grassy field", "dark frame edges", "farm lane", "windrow" ] I'd attached scripts I used for inference: ul-sam3.py - ultralytics/sam3 inference. fb-sam3.py - facebook/sam3 inference.
I expected that there would be the same results of inference on the same videos and paramteres above. But I'd got different segments, as it can be seen on the screens below (there are original frame to the left, facebook/sam3 segmentation on the middle and ultralytics/sam3 segmentation to the right).
Can someone explain me why it's happened like this?
- Glenn JocherUltralytics
Thanks for raising it here — exact parity with
facebookresearch/sam3isn’t expected, because the Ultralytics integration uses its own SAM 3 predictor path for resizing/preprocessing and postprocessing, so matchingimgsz,half,conf, and prompts alone won’t guarantee identical masks; see the SAM 3 docs and the predictor reference. If you’d like us to check whether this is a bug rather than an implementation difference, please open a new issue with a minimal reproducible example, confirm both runs use the samesam3.pt, and includeyolo checksplus the full text outputs from both scripts.