YOLOv10: Phát hiện đối tượng end-to-end theo thời gian thực
YOLOv10, ra mắt vào tháng 5 năm 2024 và được xây dựng trên package Python Ultralytics bởi các nhà nghiên cứu tại Đại học Thanh Hoa, giới thiệu một phương pháp mới cho phát hiện đối tượng thời gian thực, giải quyết các hạn chế trong hậu xử lý và kiến trúc model ở các phiên bản YOLO trước. Bằng cách loại bỏ non-maximum suppression (NMS) và tối ưu nhiều thành phần của model, YOLOv10 đạt hiệu năng mạnh mẽ với overhead tính toán giảm đáng kể tại thời điểm ra mắt. Thiết kế đầu cuối không cần NMS tiên phong cho phương pháp đã được phát triển thêm trong YOLO26.
Xem: Cách huấn luyện YOLOv10 trên dataset SKU-110k bằng Ultralytics | Dataset bán lẻ
Tổng quan#
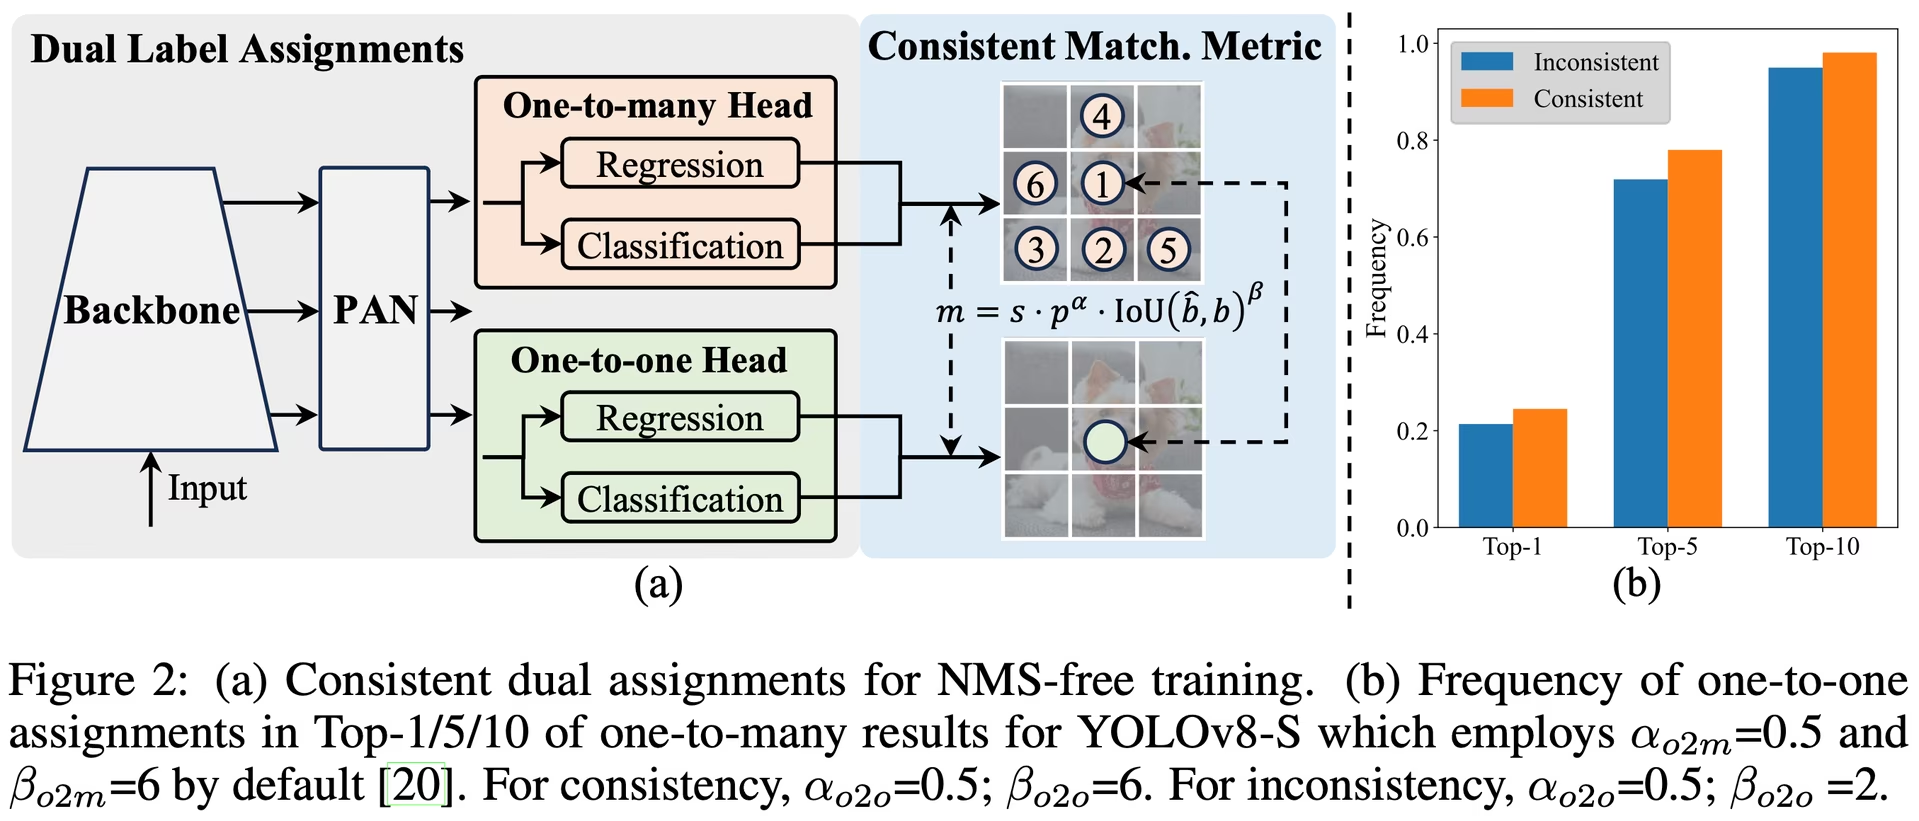
Phát hiện đối tượng thời gian thực hướng đến việc dự đoán chính xác lớp và vị trí của đối tượng trong ảnh với độ trễ thấp. Dòng YOLO luôn dẫn đầu trong lĩnh vực nghiên cứu này nhờ cân bằng giữa hiệu năng và hiệu quả. Tuy nhiên, việc phụ thuộc vào NMS và những điểm kém hiệu quả trong kiến trúc đã cản trở hiệu năng tối ưu. YOLOv10 giải quyết các vấn đề này bằng cách giới thiệu cơ chế gán kép nhất quán để huấn luyện không cần NMS, cùng chiến lược thiết kế model toàn diện dựa trên hiệu quả và độ chính xác.
Kiến trúc#
Kiến trúc YOLOv10 kế thừa thế mạnh của các model YOLO trước đó, đồng thời giới thiệu một số cải tiến then chốt. Kiến trúc model bao gồm các thành phần sau:
- Backbone: Đảm nhiệm trích xuất đặc trưng, backbone trong YOLOv10 sử dụng phiên bản cải tiến của CSPNet (Mạng phân đoạn một phần qua các giai đoạn) để cải thiện luồng gradient và giảm dư thừa tính toán.
- Neck: Neck được thiết kế để tổng hợp đặc trưng từ nhiều tỷ lệ khác nhau rồi truyền chúng đến head. Thành phần này bao gồm các lớp PAN (Mạng tổng hợp đường dẫn) để hợp nhất đặc trưng đa tỷ lệ hiệu quả.
- Head một-nhiều: Tạo nhiều dự đoán cho mỗi đối tượng trong quá trình huấn luyện nhằm cung cấp tín hiệu giám sát phong phú và cải thiện độ chính xác học tập.
- Đầu ra One-to-One: Tạo một dự đoán tốt nhất duy nhất cho mỗi đối tượng trong quá trình suy luận, loại bỏ nhu cầu sử dụng NMS, nhờ đó giảm độ trễ và cải thiện hiệu quả.
Tính năng chính#
- Huấn luyện không cần NMS: Sử dụng các phép gán kép nhất quán để loại bỏ nhu cầu sử dụng NMS, giảm độ trễ suy luận.
- Thiết kế model toàn diện: Tối ưu hóa toàn diện nhiều thành phần xét trên cả khía cạnh hiệu quả và độ chính xác, bao gồm các đầu phân loại nhẹ, giảm kích thước tách biệt không gian-kênh và thiết kế khối được định hướng bằng thứ hạng.
- Nâng cao năng lực model: Tích hợp các phép tích chập kernel lớn và các module self-attention một phần để cải thiện hiệu năng mà không làm tăng đáng kể chi phí tính toán.
Các biến thể model#
YOLOv10 có nhiều kích cỡ model để đáp ứng các nhu cầu ứng dụng khác nhau:
- YOLOv10n: Phiên bản Nano dành cho môi trường có tài nguyên cực kỳ hạn chế.
- YOLOv10s: Phiên bản Small cân bằng giữa tốc độ và độ chính xác.
- YOLOv10m: Phiên bản Medium dành cho mục đích sử dụng tổng quát.
- YOLOv10b: Phiên bản cân bằng, có chiều rộng tăng lên để đạt độ chính xác cao hơn.
- YOLOv10l: Phiên bản Large cho độ chính xác cao hơn, đổi lại cần nhiều tài nguyên tính toán hơn.
- YOLOv10x: Phiên bản Extra-large cho độ chính xác và hiệu năng tối đa.
Hiệu năng#
Tại thời điểm ra mắt, YOLOv10 vượt trội hơn các phiên bản YOLO trước và các model hiện đại khác về độ chính xác lẫn hiệu quả. Ví dụ, YOLOv10s nhanh hơn 1,8 lần so với RT-DETR-R18 với AP tương đương trên dataset COCO, còn YOLOv10b có độ trễ thấp hơn 46% và ít hơn 25% số tham số so với YOLOv9-C trong khi đạt hiệu năng tương đương.
Độ trễ được đo bằng TensorRT FP16 trên GPU T4.
| Model | Kích thước đầu vào | APval50-95 | FLOPs (G) | Độ trễ (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Phương pháp#
Gán kép nhất quán để huấn luyện không cần NMS#
YOLOv10 sử dụng cơ chế gán nhãn kép, kết hợp chiến lược one-to-many và one-to-one trong quá trình huấn luyện để đảm bảo giám sát phong phú và triển khai đầu cuối hiệu quả. Theo mặc định, các tác vụ dự đoán và đánh giá của Ultralytics sử dụng head one-to-many có NMS; đặt nms=False để chọn head không cần NMS. Chỉ số khớp nhất quán giúp đồng bộ hóa việc giám sát giữa hai chiến lược, nâng cao chất lượng dự đoán trong quá trình suy luận.
Thiết kế model toàn diện hướng đến hiệu quả và độ chính xác#
Cải thiện hiệu quả#
- Đầu phân loại nhẹ: Giảm chi phí tính toán của đầu phân loại bằng cách sử dụng các phép tích chập phân tách theo chiều sâu.
- Giảm kích thước tách biệt không gian-kênh: Tách biệt việc giảm kích thước không gian và điều biến kênh để giảm thiểu mất mát thông tin và chi phí tính toán.
- Thiết kế khối được định hướng bằng thứ hạng: Điều chỉnh thiết kế khối dựa trên mức độ dư thừa nội tại của từng stage, đảm bảo sử dụng tham số tối ưu.
Cải thiện độ chính xác#
- Tích chập kernel lớn: Mở rộng trường tiếp nhận để tăng cường khả năng trích xuất đặc trưng.
- Self-Attention một phần (PSA): Tích hợp các module self-attention để cải thiện khả năng học biểu diễn toàn cục với chi phí tối thiểu.
Thử nghiệm và kết quả#
YOLOv10 được đánh giá trên các benchmark tiêu chuẩn như COCO. Tại thời điểm ra mắt, mọi biến thể đều cải thiện sự cân bằng giữa độ trễ và độ chính xác so với các phiên bản YOLO trước cũng như các detector đương thời khác.
So sánh#
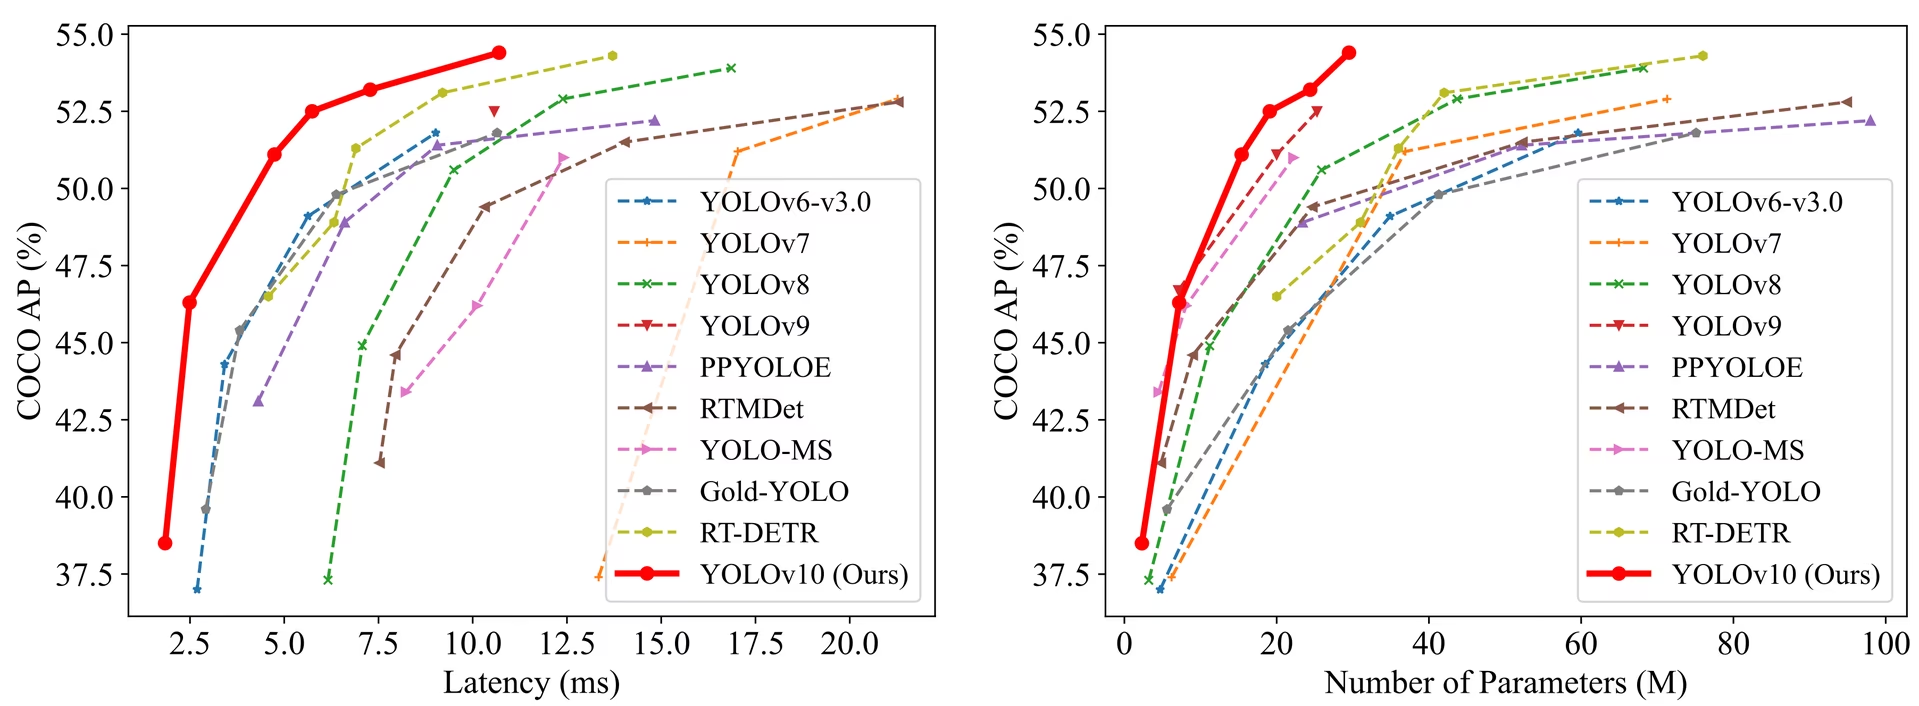
So với các bộ phát hiện tiên tiến nhất khác:
- YOLOv10s / x nhanh hơn RT-DETR-R18 / R101 lần lượt 1.8× / 1.3× với độ chính xác tương đương
- YOLOv10b có ít hơn 25% tham số và độ trễ thấp hơn 46% so với YOLOv9-C ở cùng độ chính xác
- YOLOv10l / x vượt trội hơn YOLOv8l / x lần lượt 0.3 AP / 0.5 AP, đồng thời có ít hơn 1.8× / 2.3× tham số
Các số liệu dưới đây được báo cáo trong bài báo YOLOv10, đo theo giao thức riêng của bài báo, do đó không thể so sánh trực tiếp với các giá trị trên trang model Ultralytics:
| Model | Params (M) | FLOPs (G) | mAPval50-95 | Độ trễ (ms) | Độ trễ-forward (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Các giá trị Params và FLOPs áp dụng cho model đã hợp nhất sau model.fuse(), thao tác này gộp các lớp Conv và BatchNorm, đồng thời loại bỏ đầu phát hiện one-to-many phụ trợ. Các checkpoint pretrained giữ nguyên kiến trúc huấn luyện đầy đủ và có thể hiển thị số liệu cao hơn.
Ví dụ sử dụng#
Model cũng có thể được huấn luyện trên GPU đám mây thông qua Ultralytics Platform. Để dự đoán trên hình ảnh mới bằng YOLOv10:
from ultralytics import YOLO

# Tải model YOLOv10n pretrained
model = YOLO("yolov10n.pt")

# Thực hiện phát hiện đối tượng trên hình ảnh
results = model("image.jpg")

# Hiển thị kết quả
results[0].show()
Để huấn luyện YOLOv10 trên tập dữ liệu tùy chỉnh:
from ultralytics import YOLO

# Tải model YOLOv10n từ đầu
model = YOLO("yolov10n.yaml")

# Huấn luyện model
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Các tác vụ và chế độ được hỗ trợ#
Dòng model YOLOv10 cung cấp nhiều model được tối ưu cho phát hiện đối tượng. Các biến thể đáp ứng nhiều mức ngân sách tính toán và yêu cầu độ chính xác khác nhau.
| Model | Tên tệp | Tác vụ | Huấn luyện | Validation | Suy luận | Export |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Phát hiện đối tượng | ✅ | ✅ | ✅ | ✅ |
Xuất YOLOv10#
Do YOLOv10 giới thiệu các phép toán mới, hiện chưa hỗ trợ tất cả định dạng xuất do Ultralytics cung cấp. Bảng sau liệt kê các định dạng mà Ultralytics đã chuyển đổi thành công cho YOLOv10. Chúng tôi hoan nghênh các pull request bổ sung hỗ trợ xuất sang các định dạng khác.
| Định dạng xuất | Hỗ trợ xuất | Suy luận với model đã xuất | Ghi chú |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Định dạng model PyTorch tiêu chuẩn. |
| ONNX | ✅ | ✅ | Được hỗ trợ rộng rãi để triển khai. |
| OpenVINO | ✅ | ✅ | Được tối ưu hóa cho phần cứng Intel. |
| TensorRT | ✅ | ✅ | Được tối ưu hóa cho GPU NVIDIA. |
| CoreML | ✅ | ✅ | Chỉ dành cho thiết bị Apple. |
| TF SavedModel | ✅ | ✅ | Định dạng model tiêu chuẩn của TensorFlow. |
| TF GraphDef | ✅ | ✅ | Định dạng TensorFlow cũ. |
| TF Edge TPU | ✅ | ✅ | Dành riêng cho các thiết bị Edge TPU của Google. |
| LiteRT | ✅ | ✅ | Được tối ưu hóa cho thiết bị di động, hệ thống nhúng và trình duyệt (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Phổ biến tại Trung Quốc; mức độ hỗ trợ toàn cầu thấp hơn. |
| NCNN | ✅ | ✅ | Được tối ưu hóa cho thiết bị di động và thiết bị nhúng. |
Kết luận#
Khi ra mắt, YOLOv10 thúc đẩy phát hiện đối tượng thời gian thực bằng cách loại bỏ bước hậu xử lý NMS và thiết kế lại các thành phần model nhằm cải thiện cả hiệu quả lẫn độ chính xác. Phương pháp không cần NMS mở đường cho phát hiện đối tượng đầu cuối trong dòng YOLO. YOLO26, model Ultralytics mới nhất, phát triển dựa trên phương pháp này với hiệu năng cải thiện và suy luận không cần NMS.
Trích dẫn và lời cảm ơn#
Chúng tôi xin ghi nhận các tác giả YOLOv10 tại Đại học Thanh Hoa vì những nghiên cứu chuyên sâu và đóng góp đáng kể cho framework Ultralytics:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Để biết chi tiết về triển khai, các đổi mới trong kiến trúc và kết quả thực nghiệm, vui lòng tham khảo bài báo nghiên cứu YOLOv10 và kho GitHub của nhóm Đại học Thanh Hoa.
Câu hỏi thường gặp#
YOLOv10, do các nhà nghiên cứu tại Đại học Thanh Hoa phát triển, đưa ra một số đổi mới then chốt cho việc phát hiện đối tượng thời gian thực. Model loại bỏ nhu cầu dùng ức chế phi cực đại (NMS) bằng cách sử dụng cơ chế gán kép nhất quán trong quá trình huấn luyện, đồng thời tối ưu hóa các thành phần model để giảm chi phí tính toán.
Chạy suy luận bằng Python API của Ultralytics hoặc giao diện dòng lệnh (CLI). Dưới đây là các ví dụ dự đoán trên ảnh mới bằng YOLOv10:
Ví dụfrom ultralytics import YOLO # Tải model YOLOv10n đã được huấn luyện trước model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Để xem thêm ví dụ sử dụng, hãy truy cập mục Ví dụ sử dụng của chúng tôi.
YOLOv10 cung cấp một số biến thể model để đáp ứng các trường hợp sử dụng khác nhau:
- YOLOv10n: Phù hợp với môi trường có tài nguyên cực kỳ hạn chế
- YOLOv10s: Cân bằng giữa tốc độ và độ chính xác
- YOLOv10m: Dành cho mục đích sử dụng chung
- YOLOv10b: Độ chính xác cao hơn nhờ tăng chiều rộng
- YOLOv10l: Độ chính xác cao, đổi lại cần nhiều tài nguyên tính toán hơn
- YOLOv10x: Độ chính xác và hiệu năng tối đa
Mỗi biến thể được thiết kế cho các nhu cầu tính toán và yêu cầu độ chính xác khác nhau, nhờ đó phù hợp với nhiều ứng dụng. Xem mục Các biến thể model để biết thêm thông tin.
YOLOv10 được huấn luyện bằng phương pháp gán kép nhất quán để head một-một tạo ra một dự đoán tốt nhất duy nhất cho mỗi đối tượng, nhờ đó loại bỏ nhu cầu thực hiện loại bỏ cực đại không cục bộ (NMS) trong quá trình suy luận. Theo mặc định, Ultralytics dùng head một-nhiều với NMS cho dự đoán và xác thực; đặt
nms=Falseđể chọn head không dùng NMS và bỏ qua lượt xử lý NMS. Để xem giải thích chi tiết, hãy tham khảo mục Gán kép nhất quán cho quá trình huấn luyện không dùng NMS.YOLOv10 hỗ trợ một số định dạng xuất, bao gồm TorchScript, ONNX, OpenVINO và TensorRT. Tuy nhiên, hiện tại YOLOv10 chưa hỗ trợ tất cả định dạng xuất do Ultralytics cung cấp vì các phép toán mới của model. Để biết chi tiết về những định dạng được hỗ trợ và hướng dẫn xuất model, hãy truy cập mục Xuất YOLOv10.
Tại thời điểm ra mắt, YOLOv10 vượt trội hơn các phiên bản YOLO trước và các model hiện đại khác về cả độ chính xác lẫn hiệu quả. Ví dụ, YOLOv10s nhanh hơn 1,8 lần so với RT-DETR-R18 và có AP tương đương trên dataset COCO. YOLOv10b có độ trễ thấp hơn 46% và ít hơn 25% số tham số so với YOLOv9-C trong khi đạt hiệu năng tương đương. Có thể xem benchmark chi tiết trong phần So sánh.


Bình luận188
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
 Glenn JocherUltralytics(đã chỉnh sửa)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(đã chỉnh sửa)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(đã chỉnh sửa)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(đã chỉnh sửa)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(đã chỉnh sửa)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1