Deployment#
Ultralytics Platform cung cấp các tùy chọn triển khai model toàn diện để đưa các model YOLO của bạn vào môi trường production. Kiểm thử model bằng inference trên trình duyệt, triển khai lên các endpoint chuyên dụng tại 42 khu vực trên toàn cầu và theo dõi hiệu suất theo thời gian thực.
Watch: Get Started with Ultralytics Platform - Deploy
Tổng quan#
Phần Triển khai giúp bạn:
- Kiểm thử model trực tiếp trên trình duyệt bằng tab
Predict - Triển khai lên các endpoint chuyên dụng tại 42 khu vực trên toàn cầu
- Giám sát các chỉ số yêu cầu, nhật ký, kiểm tra tình trạng hoạt động và dự đoán tạm thời trên các endpoint có trả phí
- Chọn tài nguyên: các endpoint mặc định tự động scale về 0; các kích thước tùy chỉnh giữ một instance luôn ấm với chi phí tính theo thời gian hoạt động
Tùy chọn triển khai#
Ultralytics Platform cung cấp nhiều phương thức triển khai:
| Tùy chọn | Mô tả | Phù hợp nhất cho |
|---|---|---|
| Tab Predict | Inference trên trình duyệt với image, webcam và các ví dụ | Phát triển, validation |
| Shared Inference | Service multi-tenant trên 3 khu vực dữ liệu | Sử dụng nhẹ, kiểm thử |
| Dedicated Endpoints | Các service single-tenant trên 42 khu vực | Production, độ trễ thấp |
| Export | Tải weights ở 20 định dạng để chạy trên runtime local hoặc edge | Offline, trên thiết bị |
Workflow#
graph LR
    A[✅ Test]:::start --> B[⚙️ Configure]:::proc
    B --> C[🌐 Deploy]:::proc
    C --> D[📊 Monitor]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
classDef out fill:#9C27B0,color:#fff| Giai đoạn | Mô tả |
|---|---|
| Test | Validation model bằng tab Predict |
| Cấu hình | Chọn một model, khu vực, CPU và bộ nhớ; xem lại bảng giá và tên deployment |
| Deploy | Tạo một endpoint chuyên dụng từ tab Deploy |
| Theo dõi | Kiểm tra các chỉ số của endpoint và dự đoán tạm thời trong phần Monitoring |
Kiến trúc#
Shared Inference#
Service shared inference chạy tại 3 khu vực chính. Request đến một model được định tuyến đến service tại khu vực dữ liệu của model đó, vì vậy kết quả vẫn nằm trong khu vực lưu trữ model:
graph TB
    User[User Request]:::start --> API[Platform API]:::proc
    API --> Router{Model Data Region}:::decide
    Router -->|US models| US["US Predict Service<br/>Iowa"]:::out
    Router -->|EU models| EU["EU Predict Service<br/>Belgium"]:::out
    Router -->|AP models| AP["AP Predict Service<br/>Taiwan"]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
classDef out fill:#9C27B0,color:#fff| Region | Nhãn | Vị trí | Phù hợp nhất cho |
|---|---|---|---|
| US | Châu Mỹ | Iowa, Hoa Kỳ | Người dùng tại châu Mỹ, nhanh nhất cho châu Mỹ |
| EU | Châu Âu, Trung Đông & châu Phi | Bỉ, châu Âu | Người dùng tại châu Âu, tuân thủ GDPR |
| AP | Châu Á - Thái Bình Dương | Đài Loan, châu Á - Thái Bình Dương | Người dùng tại châu Á - Thái Bình Dương, độ trễ thấp nhất tại APAC |
Dedicated Endpoints#
Triển khai lên 42 khu vực trên toàn thế giới trên Ultralytics Cloud:
- Châu Mỹ: 14 khu vực
- Châu Âu: 13 khu vực
- Châu Á - Thái Bình Dương: 12 khu vực
- Trung Đông & Châu Phi: 3 khu vực
Mỗi endpoint là một service single-tenant với:
- CPU và bộ nhớ có thể cấu hình với mức giá hiển thị trước khi deployment
- Scale về 0 đối với tài nguyên mặc định; một instance ấm, tính phí theo thời gian hoạt động đối với tài nguyên tùy chỉnh
- URL endpoint riêng cùng tài liệu tham chiếu API tương tác riêng tại
/docs - Liên kết API key riêng, để chỉ key đó có thể gọi endpoint
- Monitoring, log và kiểm tra tình trạng hoạt động độc lập
Trang Deployments#
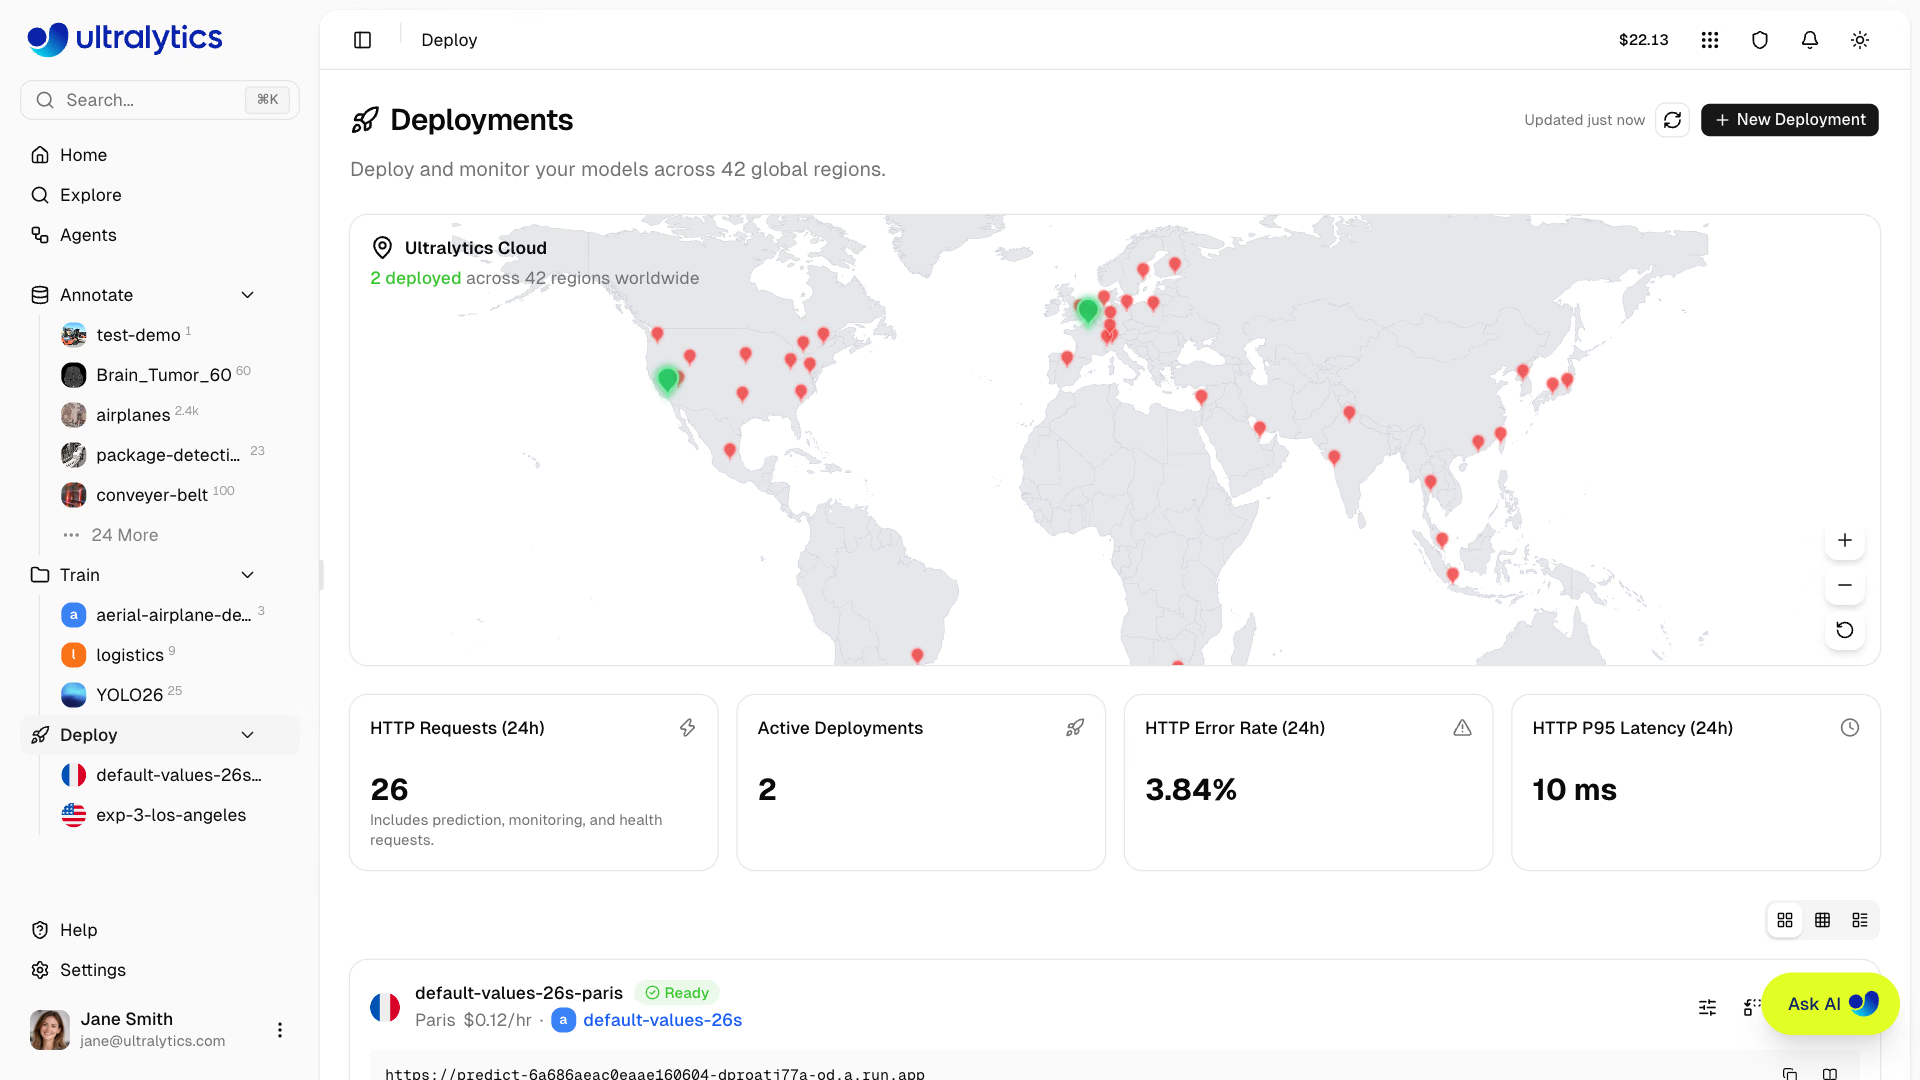
Truy cập trang deployments toàn cầu từ thanh bên trong Deploy. Trang này hiển thị:
- Bản đồ thế giới với các ghim khu vực đã triển khai; nhấp vào một khu vực để mở hộp thoại
New Deployment - Thẻ tổng quan: HTTP Requests (24h), Active Deployments, HTTP Error Rate (24h), HTTP P95 Latency (24h)
- Danh sách deployments với ba chế độ xem: thẻ, thu gọn và bảng
- Nút New Deployment để tạo endpoint từ bất kỳ model nào đã hoàn tất
- Nút Refresh và timestamp
Updatedtrong header của trang
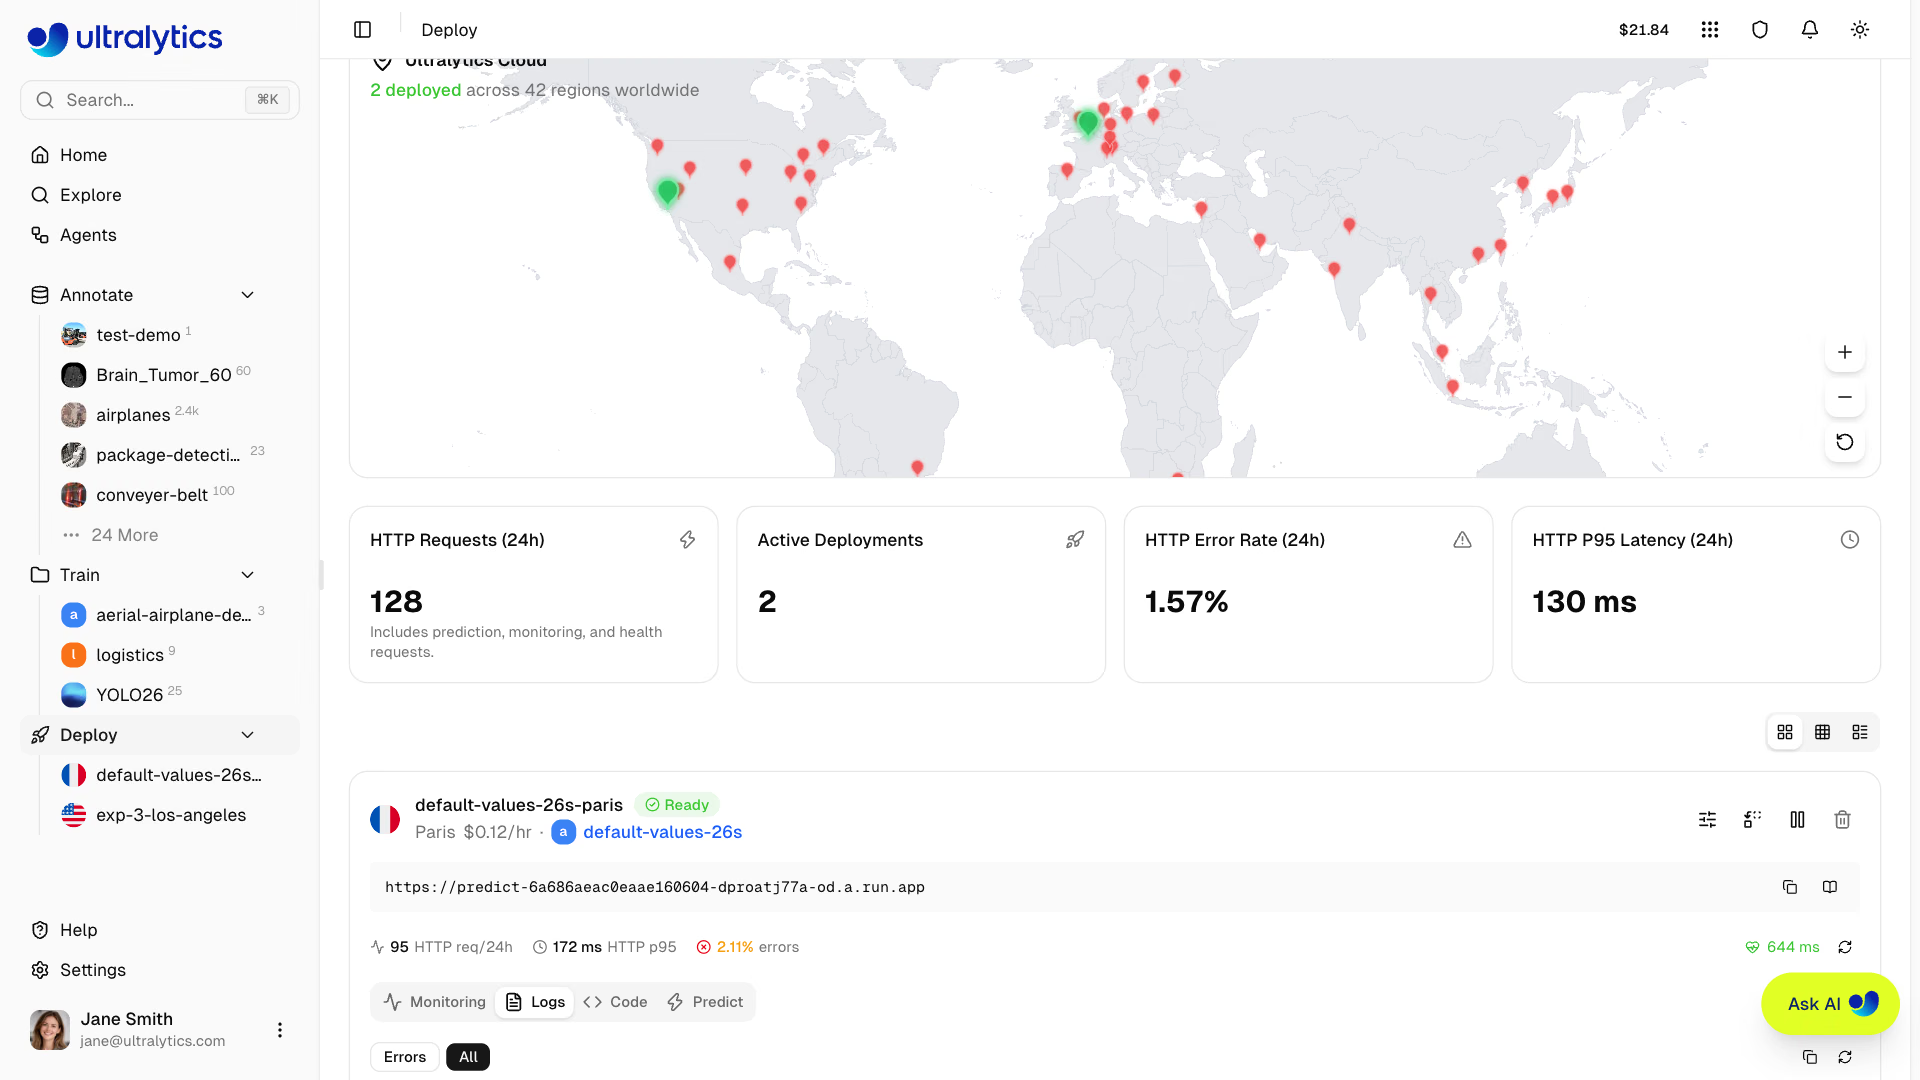
Trang tự động refresh, polling nhanh hơn khi deployment đang ở trạng thái chuyển tiếp (creating, deploying hoặc stopping). Xem Monitoring để biết thêm chi tiết.
Các endpoint trả phí cung cấp biểu đồ và hình ảnh ví dụ chỉ được lưu trong bộ nhớ của instance phục vụ. Việc dừng, khởi động lại, redeploy, thay đổi kích thước hoặc thay thế model có thể làm sạch dữ liệu này. Lưu các ví dụ vào một dataset và chờ quá trình nhập hoàn tất để giữ lại chúng. Xem thêm tại Monitoring.
Tính năng chính#
Phạm vi toàn cầu#
Triển khai gần người dùng của bạn tại 42 khu vực bao phủ:
- Bắc Mỹ, Nam Mỹ
- Châu Âu, Trung Đông, Châu Phi
- Châu Á - Thái Bình Dương, Châu Đại Dương
Cơ chế scaling#
Các endpoint hiện hoạt động như sau:
- Tài nguyên mặc định: các endpoint không hoạt động sẽ scale xuống 0 và khởi động lạnh ở yêu cầu tiếp theo
- Tài nguyên tùy chỉnh: một instance duy trì trạng thái ấm và tính phí thời gian hoạt động cho đến khi bị dừng
- Một instance đang hoạt động: mỗi endpoint hiện phục vụ từ một instance trên tất cả các plan
- Load shedding: các request nhận phản hồi
429khi endpoint tạm thời đạt giới hạn capacity — xem Direct Endpoint Requests - Thời gian chờ yêu cầu: các yêu cầu endpoint trực tiếp có thời lượng tối đa là 1 giờ; xem phần Inference để biết các đầu vào được hỗ trợ
Triển khai theo khu vực#
Sử dụng độ trễ theo khu vực đã đo để đặt endpoint gần các client gọi đến. Độ trễ inference thực tế phụ thuộc vào model, kích thước input, trạng thái endpoint và đường truyền mạng.
Kiểm tra tình trạng hoạt động#
Mỗi deployment đang chạy đều có kiểm tra tình trạng hoạt động tự động với:
- Chỉ báo trạng thái trực tiếp (healthy/unhealthy)
- Hiển thị độ trễ phản hồi
- Tự động retry khi unhealthy và dừng khi đã healthy
- Nút refresh thủ công
Bắt đầu nhanh#
Tạo một deployment:
- Train hoặc upload một model vào project
- Đi đến tab Deploy của model
- Nhấp vào Deploy cho một khu vực trong bảng độ trễ
- Xem lại CPU, bộ nhớ, bảng giá và tên trong hộp thoại deployment
- Nhấp vào Create Deployment và đợi trạng thái deployment chuyển thành Ready
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentTên deployment được tạo từ tên model và thành phố khu vực, có thể được chỉnh sửa trước khi deployment. Sau khi deploy, hãy sử dụng URL của endpoint với khóa API của bạn để gửi yêu cầu suy luận từ bất kỳ ứng dụng nào.
Liên kết nhanh#
- Inference: Kiểm thử model trên trình duyệt
- Endpoints: Triển khai các endpoint chuyên dụng
- Monitoring: Theo dõi hiệu năng deployment
FAQ#
Quá trình triển khai vẫn ở trạng thái đang tạo hoặc đang triển khai trong khi service khởi động. Service có thể sử dụng được khi trạng thái chuyển sang Ready; thời gian thay đổi tùy theo model và khu vực, thường mất vài phút.
Có, mỗi model có thể có nhiều endpoint ở các khu vực khác nhau. Số lượng deployment bị giới hạn theo gói: Miễn phí
3, Pro10, Enterpriseunlimited. Hạn mức được tính cho workspace sở hữu model, và mỗi endpoint chỉ phục vụ chính xác một model tại một thời điểm — sử dụng thay thế model để thay đổi model mà không cần thay đổi URL.Các endpoint sử dụng tài nguyên mặc định sẽ scale về 0 khi không hoạt động:
- Endpoint giảm quy mô sau một khoảng thời gian không hoạt động
- Request đầu tiên kích hoạt cold start
- Các request tiếp theo có tốc độ nhanh
Các request đầu tiên sau một khoảng thời gian không hoạt động sẽ kích hoạt cold start. Việc mở deployment card sẽ chạy kiểm tra tình trạng, giúp làm nóng endpoint, vì vậy một lần dự đoán thử ngay sau đó sẽ phản hồi nhanh.
Các endpoint sử dụng tài nguyên tùy chỉnh duy trì trạng thái ấm và bị tính phí theo thời gian hoạt động, bao gồm cả thời gian nhàn rỗi. Hãy dừng một endpoint để ngừng tính phí thời gian hoạt động.