快速入门指南:使用 NVIDIA DGX Spark 运行 Ultralytics YOLO26#
本指南将介绍如何在 NVIDIA DGX Spark(NVIDIA 推出的紧凑型桌面 AI 超级计算机)上部署 Ultralytics YOLO26,并提供该系统在多种导出格式下的 YOLO11 基准测试结果。
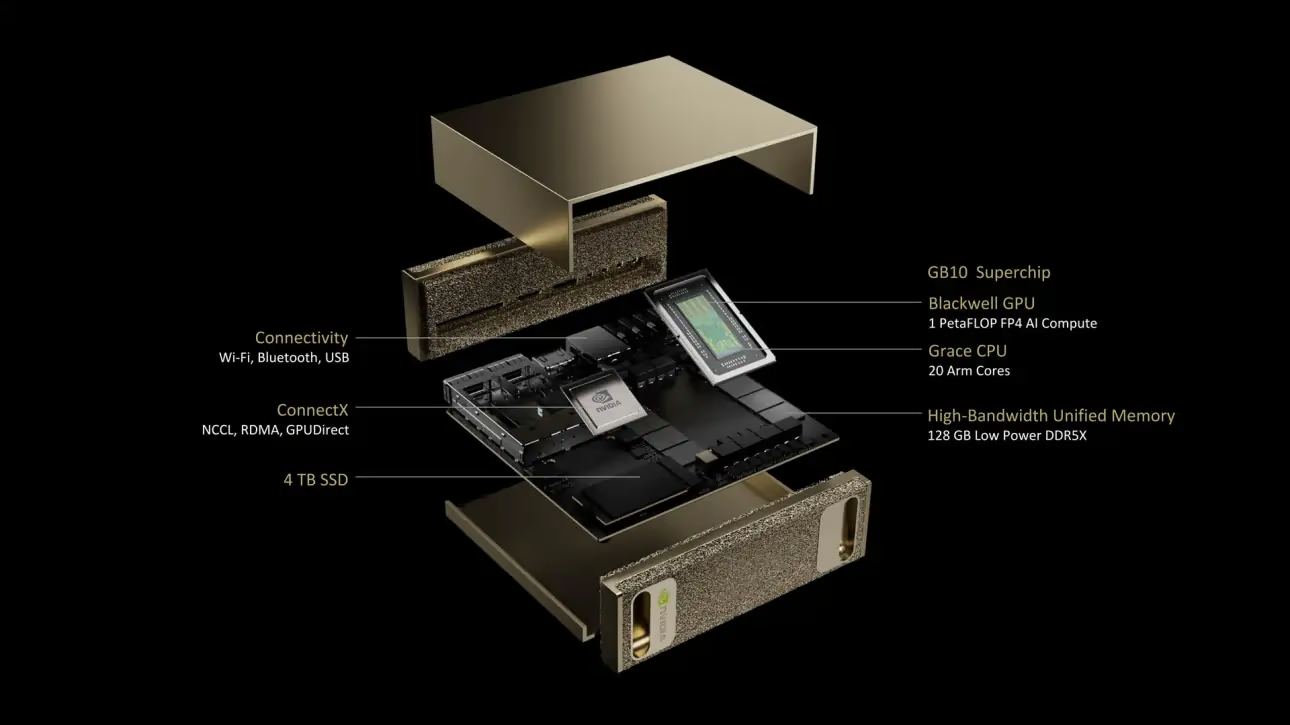
本指南已在搭载基于 Ubuntu 的 DGX OS 的 NVIDIA DGX Spark Founders Edition 上进行测试。预计本指南也适用于最新版本的 DGX OS。
什么是 NVIDIA DGX Spark?#
NVIDIA DGX Spark 是一款紧凑型桌面 AI 超级计算机,搭载 NVIDIA GB10 Grace Blackwell Superchip。它以 FP4 精度可提供高达 1 petaFLOP 的 AI 计算性能,专为需要强大 AI 能力的开发者、研究人员和数据科学家设计,同时保持桌面设备的形态。
观看:如何在 NVIDIA DGX Spark 上使用 Ultralytics YOLO26 实现高达 1000 FPS | TensorRT 与批量推理
主要规格#
| 规格 | 详情 |
|---|---|
| AI 性能 | 最高 1 PFLOP(FP4) |
| GPU | NVIDIA Blackwell 架构,配备第 5 代 Tensor Core 和第 4 代 RT Core |
| CPU | 20 核 Arm 处理器(10 个 Cortex-X925 + 10 个 Cortex-A725) |
| 内存 | 128 GB LPDDR5x 统一系统内存,256 位接口,4266 MHz,带宽 273 GB/s |
| 存储 | 1 TB 或 4 TB NVMe M.2 自加密存储 |
| 网络 | 1 个 RJ-45(10 GbE)、ConnectX-7 Smart NIC、Wi-Fi 7、Bluetooth 5.4 |
| 连接 | 4 个 USB Type-C、1 个 HDMI 2.1a、HDMI 多声道音频 |
| 视频处理 | 1 个 NVENC、1 个 NVDEC |
DGX OS#
NVIDIA DGX OS 是一个定制的 Linux 发行版,为在 DGX 系统上运行 AI、机器学习和分析应用提供稳定、经过测试且受支持的操作系统基础。它包括:
- 针对 AI 工作负载优化的可靠 Linux 基础
- 为 NVIDIA 硬件预配置的驱动程序和系统设置
- 安全更新和系统维护功能
- 与更广泛的 NVIDIA 软件生态系统兼容
DGX OS 按照固定的发布计划进行更新,通常每年发布两次(约在 2 月和 8 月),并在主要版本之间提供额外的安全补丁。
DGX Dashboard#
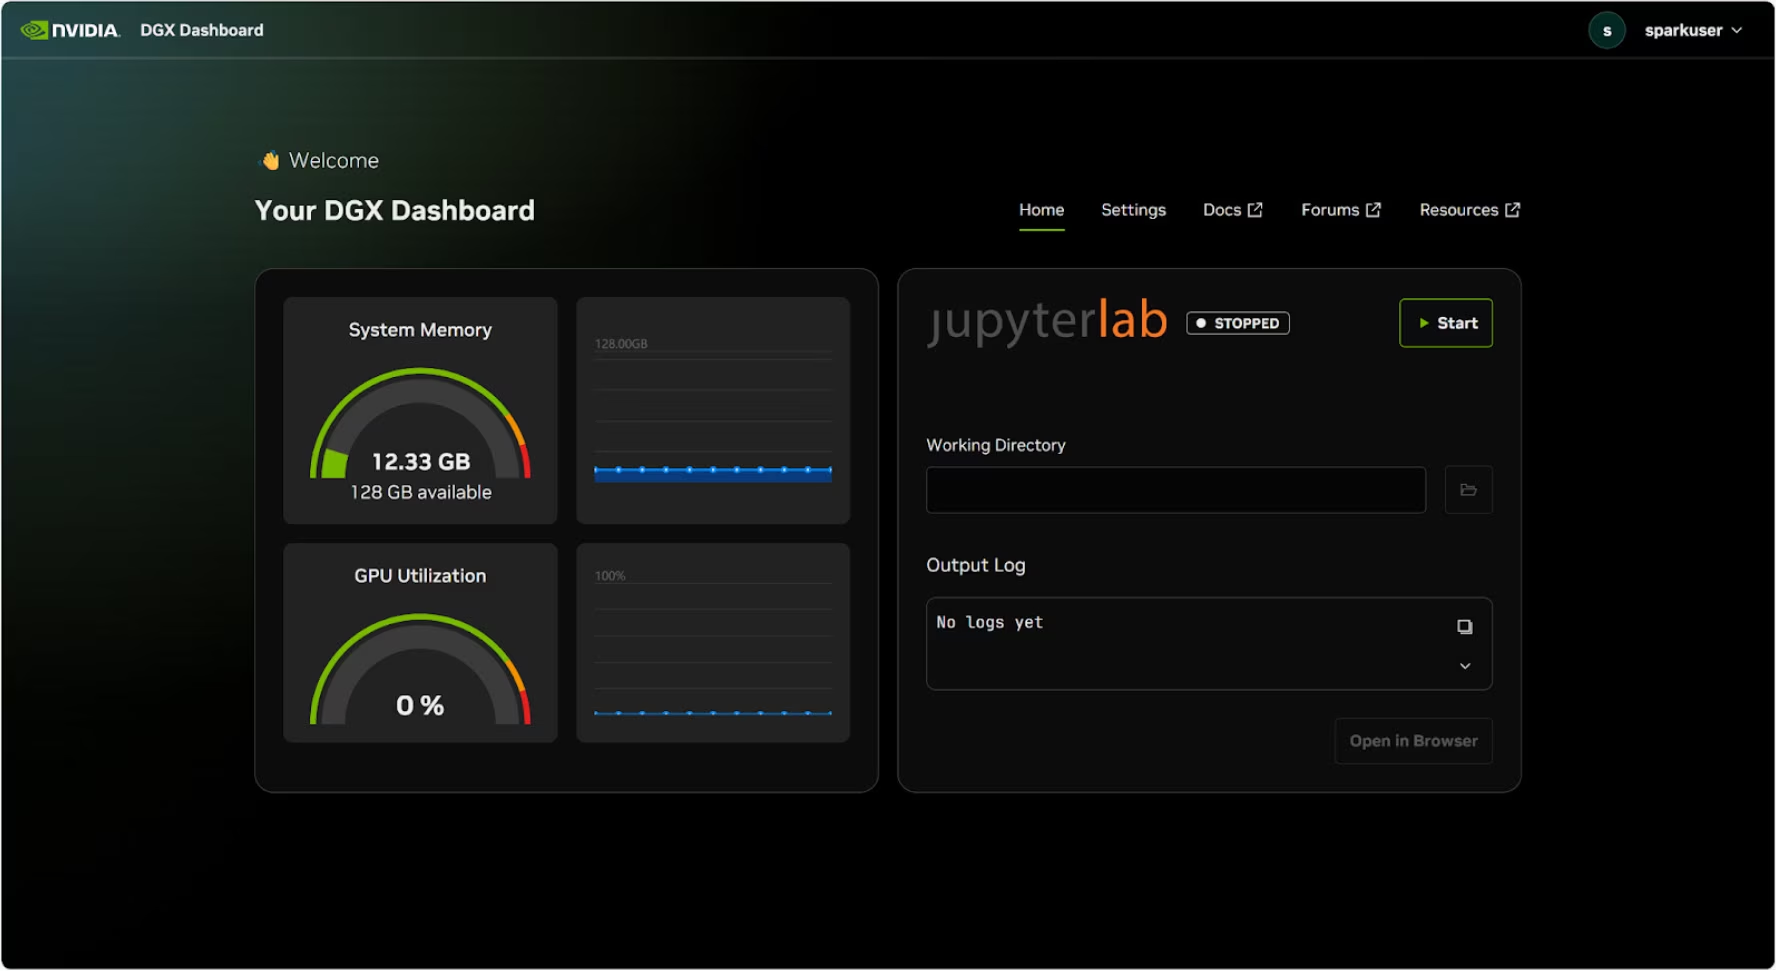
DGX Spark 内置了 DGX Dashboard,其中提供:
- 实时系统监控:概览系统当前的运行指标
- 系统更新:可直接通过仪表板应用更新
- 系统设置:更改设备名称及其他配置
- 集成式 JupyterLab:访问本地 Jupyter Notebooks 进行开发
访问仪表板#
点击 Ubuntu 桌面左下角的“显示应用”按钮,然后选择“DGX Dashboard”,即可在浏览器中打开。
仪表板集成了 JupyterLab 实例,启动时会自动创建虚拟环境并安装推荐的软件包。每个用户帐户都会分配一个专用端口来访问 JupyterLab。
Docker 快速入门#
在 NVIDIA DGX Spark 上开始使用 Ultralytics YOLO26,最快的方法是运行预构建的 Docker 镜像。NVIDIA ARM64 镜像支持搭载 DGX OS 的 DGX Spark。
t=ultralytics/ultralytics:latest-nvidia-arm64
sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all $t
上面的 CDI 设备请求适用于运行 DGX OS 的 DGX Spark。若要在 Jetson AGX Thor 上运行 PyTorch 工作负载,请参阅 NVIDIA Jetson 指南中的主机要求和 TensorRT 限制。
此镜像使用 NVIDIA PyTorch 26.08、CUDA 13.4 和 TensorRT 11.2。请将 DGX OS 主机驱动程序更新到 NVIDIA PyTorch 26.08支持的版本,并在更改镜像或目标 GPU 后重新构建 TensorRT 引擎。
完成此操作后,跳转至在 NVIDIA DGX Spark 上使用 TensorRT。
从原生安装开始#
如需不使用 Docker 进行原生安装,请按照以下步骤操作。
安装 Ultralytics 包#
这里将在 DGX Spark 上安装 Ultralytics 软件包。首次导出模型时会自动安装导出所需的依赖,因此这里只需安装基础软件包。本指南重点介绍 NVIDIA TensorRT 导出,因为 TensorRT 在 DGX Spark 上性能最高。
-
更新软件包列表、安装 pip,并将其升级到最新版本
sudo apt update sudo apt install python3-pip -y pip install -U pip -
安装
ultralyticspip 包pip install ultralytics -
重启设备
sudo reboot
安装 PyTorch 和 Torchvision#
上述 ultralytics 安装会安装 PyTorch 和 Torchvision。但通过 pip 安装的这些软件包可能未针对 DGX Spark 的 ARM64 架构和 CUDA 13 进行充分优化。因此,我们建议安装兼容 CUDA 13 的版本:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130在 NVIDIA DGX Spark 上运行 PyTorch 2.9.1 时,初始化 CUDA 可能会遇到以下 UserWarning(例如运行 yolo checks、yolo predict 等时):
UserWarning: Found GPU0 NVIDIA GB10 which is of cuda capability 12.1.
Minimum and Maximum cuda capability supported by this version of PyTorch is (8.0) - (12.0)
可以放心忽略此警告。
安装 onnxruntime-gpu#
当前的 ONNX Runtime GPU 版本提供 Linux ARM64 wheel,包括 Python 3.12。NVIDIA ARM64 Docker 镜像会安装官方软件包;对于原生 CUDA 13 安装,请使用:
pip install onnxruntime-gpu在 NVIDIA DGX Spark 上使用 TensorRT#
在 Ultralytics 支持的所有模型导出格式中,TensorRT 在 NVIDIA DGX Spark 上的推理性能最高,因此我们最推荐在部署时使用它。
将模型转换为 TensorRT 并运行推理#
将 YOLO26n PyTorch 模型转换为 TensorRT,然后使用导出的模型进行推理。
from ultralytics import YOLO

# 加载 YOLO26n PyTorch 模型
model = YOLO("yolo26n.pt")

# 将模型导出为 TensorRT FP16
model.export(format="engine", quantize=16)  # 创建 'yolo26n.engine'

# 加载导出的 TensorRT 模型
trt_model = YOLO("yolo26n.engine")

# 运行推理
results = trt_model("https://ultralytics.com/images/bus.jpg")
NVIDIA DGX Spark 上的 YOLO11 基准测试#
Ultralytics 团队针对多种模型格式进行了 YOLO11 基准测试,测量速度和精度:PyTorch、TorchScript、ONNX、OpenVINO、TensorRT、TF SavedModel、TF GraphDef、TF Lite、MNN、NCNN、ExecuTorch。测试在 NVIDIA DGX Spark 上以 FP32 精度进行,默认输入图像尺寸为 640。
详细对比表#
下表展示了五种不同模型(YOLO11n、YOLO11s、YOLO11m、YOLO11l、YOLO11x)在多种格式下的基准测试结果,包括每种组合的状态、大小、mAP50-95(B) 指标和推理时间。
| 格式 | 状态 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.4 | 0.5071 | 2.67 |
| TorchScript | ✅ | 10.5 | 0.5083 | 2.62 |
| ONNX | ✅ | 10.2 | 0.5074 | 5.92 |
| OpenVINO | ✅ | 10.4 | 0.5058 | 14.95 |
| TensorRT (FP32) | ✅ | 12.8 | 0.5085 | 1.95 |
| TensorRT (FP16) | ✅ | 7.0 | 0.5068 | 1.01 |
| TensorRT (INT8) | ✅ | 18.6 | 0.4880 | 1.62 |
| TF SavedModel | ✅ | 25.7 | 0.5076 | 36.39 |
| TF GraphDef | ✅ | 10.3 | 0.5076 | 41.06 |
| TF Lite | ✅ | 10.3 | 0.5075 | 64.36 |
| MNN | ✅ | 10.1 | 0.5075 | 12.14 |
| NCNN | ✅ | 10.2 | 0.5041 | 12.31 |
| ExecuTorch | ✅ | 10.2 | 0.5075 | 27.61 |
使用 Ultralytics 8.3.249 进行基准测试
复现我们的结果#
要在所有导出格式上复现上述 Ultralytics 基准测试,请运行以下代码:
from ultralytics import YOLO

# 加载 YOLO26n PyTorch 模型
model = YOLO("yolo26n.pt")

# 在 COCO128 数据集上对 YOLO26n 的所有导出格式进行速度和精度基准测试
results = model.benchmark(data="coco128.yaml", imgsz=640)
请注意,基准测试结果可能因系统的具体硬件和软件配置,以及运行基准测试时系统的当前负载而有所不同。为获得最可靠的结果,请使用包含大量图像的数据集,例如 data='coco.yaml'(5000 张验证图像)。
DGX Spark 上 YOLO26 的 TensorRT 精度#
在 DGX Spark 上,批次大小为 1 时,YOLO26n 和 YOLO26s 使用 TensorRT INT8 的速度比 FP16 慢,而 YOLO26m 的速度基本相同(验证和 trtexec GPU 计算时间的差异均在 2% 以内)。INT8 的 mAP 还会降低 1.1 到 1.8,因此对于这些模型,FP16 是更好的选择。上方的 YOLO11 表格显示了相同的趋势:对于全部五种模型,TensorRT (INT8) 都比 TensorRT (FP16) 慢。
| 模型 | 格式 | 磁盘占用大小 (MB) | mAP50-95(B) | 推理时间 (ms/im) |
|---|---|---|---|---|
| YOLO26n | TensorRT (FP16) | 6.7 | 0.4032 | 0.79 |
| YOLO26n | TensorRT (INT8) | 28.4 | 0.3849 | 1.43 |
| YOLO26s | TensorRT (FP16) | 20.3 | 0.4793 | 1.49 |
| YOLO26s | TensorRT (INT8) | 34.4 | 0.4644 | 1.73 |
| YOLO26m | TensorRT (FP16) | 41.1 | 0.5266 | 2.70 |
| YOLO26m | TensorRT (INT8) | 45.0 | 0.5156 | 2.74 |
准确率和速度数据来自 COCO val2017(5000 张图像)上的验证,图像尺寸为 640,批次大小为 1。INT8 引擎使用 COCO128 进行校准。基准测试使用 Ultralytics 8.4.192,在 ultralytics/ultralytics:latest-nvidia-arm64 中运行(NVIDIA PyTorch 26.08、TensorRT 11.2.1.2、ModelOpt 0.45.0)。
NVIDIA DGX Spark 最佳实践#
在 NVIDIA DGX Spark 上运行 YOLO26 时,请遵循以下最佳实践以获得最佳性能。
-
监控系统性能
使用 NVIDIA 的监控工具跟踪 GPU 和 CPU 利用率:
nvidia-smi -
优化内存使用
DGX Spark 配备 128 GB 统一内存,能够运行较大的批次大小和模型。你可以考虑增大批次大小以提升吞吐量:
from ultralytics import YOLO model = YOLO("yolo26n.engine") results = model.predict(source="path/to/images", batch=16) -
使用 TensorRT FP16
在 DGX Spark 上,批次大小为 1 时,YOLO26n 和 YOLO26s 使用 INT8 的速度比 FP16 慢,YOLO26m 使用 INT8 并不会更快,而且准确率更低(参见 DGX Spark 上 YOLO26 的 TensorRT 精度:
yolo export model=yolo26n.pt format=engine quantize=16 # FP16
系统更新(Founders Edition)#
及时更新 DGX Spark Founders Edition 对性能和安全至关重要。NVIDIA 提供两种主要方法来更新系统 OS、驱动程序和固件。
使用 DGX Dashboard(推荐)#
建议使用 DGX Dashboard 执行系统更新,以确保兼容性。你可以通过它:
- 查看可用的系统更新
- 安装安全补丁和系统更新
- 管理 NVIDIA 驱动程序和固件更新
手动更新系统#
高级用户可以通过终端手动执行更新:
sudo apt update
sudo apt dist-upgrade
sudo fwupdmgr refresh
sudo fwupdmgr upgrade
sudo reboot执行更新前,请确保系统已连接到稳定的电源,并已备份重要数据。
后续步骤#
如需进一步学习和获取支持,请参阅 Ultralytics YOLO26 文档。
常见问题#
在 NVIDIA DGX Spark 上部署 Ultralytics YOLO26 非常简单。你可以使用预构建的 Docker 镜像快速设置,也可以手动安装所需软件包。两种方法的详细步骤分别见使用 Docker 快速入门和从原生安装开始部分。
得益于 GB10 Grace Blackwell Superchip,YOLO 模型在 DGX Spark 上运行迅速。TensorRT 格式可提供最佳推理性能。请查看 详细对比表 部分,了解 YOLO11 在 DGX Spark 上不同模型尺寸和格式的基准测试结果;并查看 DGX Spark 上 YOLO26 的 TensorRT 精度 部分,了解 YOLO26 FP16 和 INT8 的结果。
在 DGX Spark 上部署 YOLO26 模型时,建议使用 TensorRT,因为在支持的导出格式中,它能提供最快的推理速度,并可利用 Blackwell GPU 的 Tensor Core,以 FP16 或 INT8 精度运行。
DGX Spark 可提供高达 1 PFLOP 的 AI 性能和 128 GB 统一内存;相比之下,Jetson AGX Thor 提供 2070 TFLOPS 和 128 GB 内存。DGX Spark 专为桌面 AI 超级计算机设计,而 Jetson 设备是针对边缘部署优化的嵌入式系统。
对于 PyTorch 工作负载,
ultralytics/ultralytics:latest-nvidia-arm64支持搭载 DGX OS 的 DGX Spark,以及搭载 JetPack 7.1 的 Thor。捆绑的 TensorRT 11.2 不支持 JetPack,因此 Jetson TensorRT 工作流必须使用对应 JetPack 版本支持的 TensorRT 10.x 运行时。请参阅 Jetson Docker 要求。