مجموعة بيانات SKU-110K
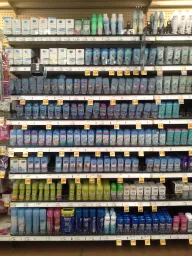
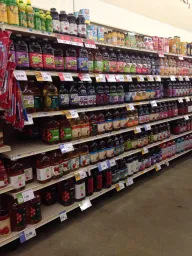
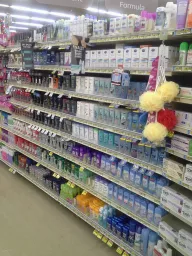
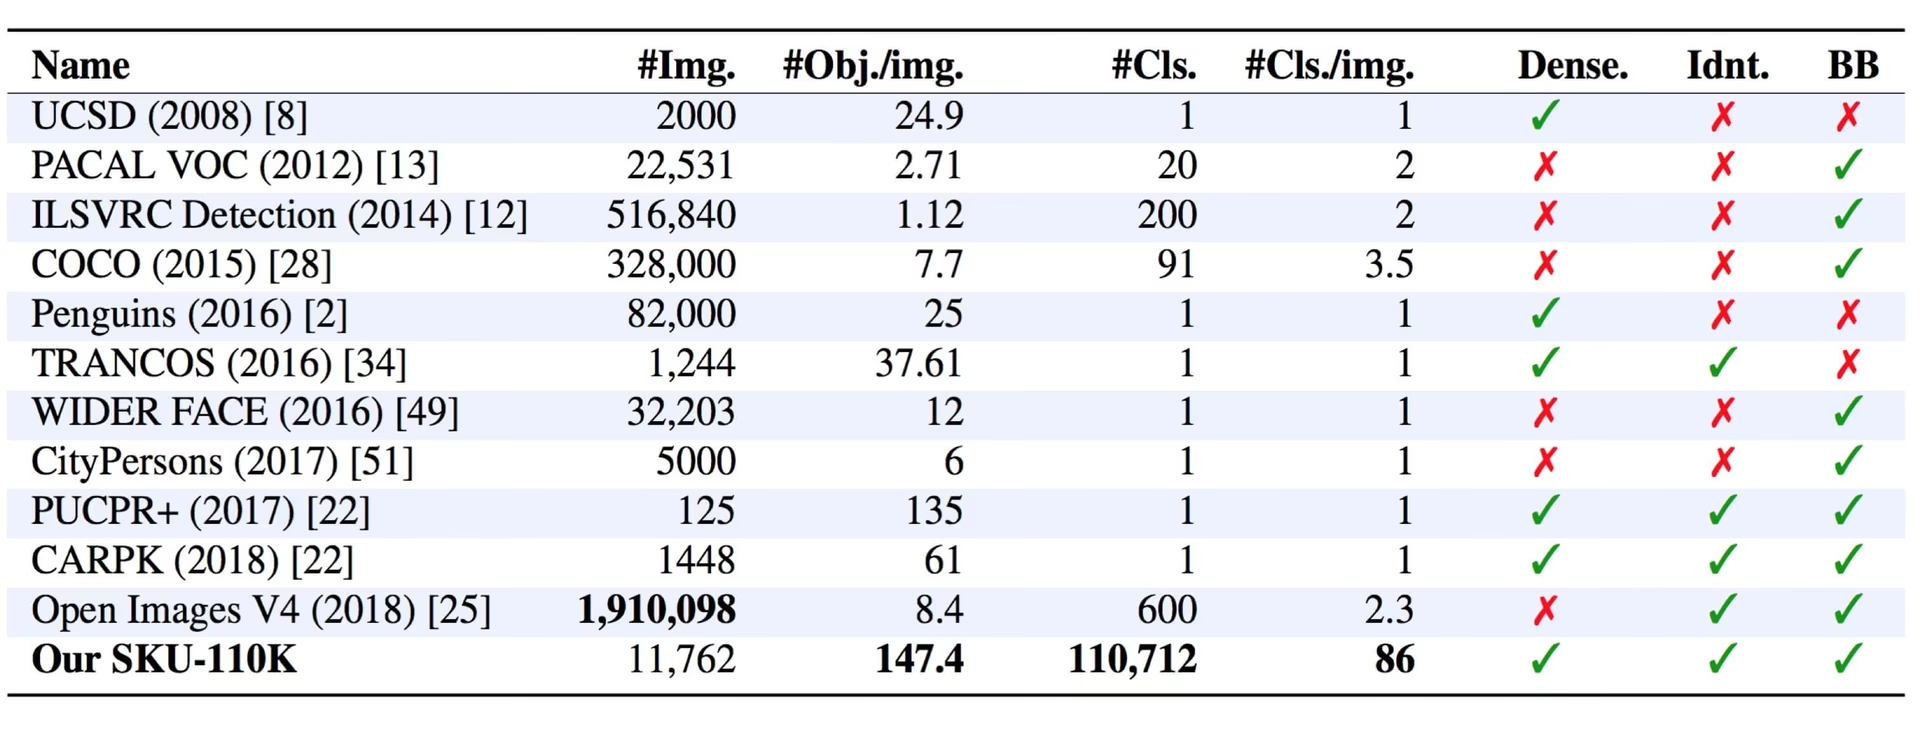
مجموعة بيانات SKU-110K هي مجموعة أحادية الفئة لـاكتشاف الأجسام، وتتألف من 11,743 صورة لرفوف متاجر مكتظة بالمنتجات، مقسمة إلى 8,219 صورة للتدريب و588 للتحقق و2,936 للاختبار. يُشرح كل منتج بمربع إحاطة واحد ضمن فئة واحدة هي object — ويشير الاسم إلى أكثر من 110,000 وحدة حفظ مخزون فريدة (SKUs) ظاهرة في المشاهد، لا إلى 110,000 فئة للكشف. أنشأها Eran Goldman وآخرون لورقة CVPR لعام 2019 الكشف الدقيق في المشاهد المكتظة، وهي تضم أكثر من 1.7 مليون منتج مشروح — بمتوسط يقارب 147 منتجًا في الصورة — ما يجعلها معيارًا مرجعيًا صعبًا لنماذج الرؤية الحاسوبية في بيئات البيع بالتجزئة المزدحمة.
شاهد: كيفية تدريب Ultralytics YOLO26 لاكتشاف كل منتج على رف متجر | SKU-110K 🛒
الميزات الرئيسية#
- الكشف أحادي الفئة: يُوسم كل منتج بمربع إحاطة واحد ضمن فئة واحدة هي
object(names: {0: object}) — ولا تتضمن الشروح تسميات فئات خاصة بكل SKU. - كثافة الأجسام القصوى: يبلغ متوسط صور رفوف المتاجر من أنحاء العالم نحو 147 منتجًا متراصًا في كل صورة، وغالبًا ما تبدو الأجسام متشابهة أو متطابقة تقريبًا، وتوجد متقاربة.
- نطاق واسع: يتحدى أكثر من 110,000 SKU فريد وما يزيد على 1.7 مليون مربع إحاطة مشروح موزعة على 11,743 صورة أحدث كواشف الأجسام.
بنية مجموعة البيانات#
تنقسم مجموعة بيانات SKU-110K إلى ثلاث مجموعات فرعية، وتشترك جميعها في الفئة الوحيدة object:
| المجموعة الفرعية | الصور | الوصف |
|---|---|---|
| التدريب | 8,219 | صور وشروح لتدريب النموذج |
| التحقق | 588 | صور محجوبة من التدريب لإجراء التقييم أثناء التدريب |
| الاختبار | 2,936 | صور للتقييم النهائي للنموذج المدرّب |
التطبيقات#
تُستخدم مجموعة بيانات SKU-110K على نطاق واسع لتدريب نماذج التعلّم العميق وتقييمها في مهام اكتشاف الأجسام، ولا سيما في المشاهد المكتظة مثل عروض رفوف المتاجر. وتشمل تطبيقاتها:
- إدارة مخزون التجزئة وأتمتته
- التعرّف على المنتجات في منصات التجارة الإلكترونية
- التحقق من الامتثال لمخطط ترتيب المنتجات
- أنظمة الدفع الذاتي في المتاجر
- الانتقاء والفرز الآليان في المستودعات
لشرح صور رفوفك وتدريب مجموعات بيانات الكشف عن المنتجات بالتجزئة وإدارتها في المتصفح، نفّذ سير العمل كاملًا باستخدام منصة Ultralytics.
ملف YAML لمجموعة البيانات#
يحدّد الملف SKU-110K.yaml تهيئة مجموعة البيانات — مسارات مجموعة البيانات وأسماء الفئات والبيانات الوصفية الأخرى. ويُصان في مستودع Ultralytics على https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelالاستخدام#
تُنزّل مجموعة بيانات SKU-110K تلقائيًا عند التدريب لأول مرة، وتحتاج إلى نحو 13.6 GB من المساحة الحرة على القرص لصورها البالغ عددها 11,743. كما يجلب برنامج التنزيل الشروح الأصلية ويحوّلها إلى تنسيق YOLO، وقد تستغرق العملية بضع دقائق.
لتدريب نموذج YOLO26n على مجموعة بيانات SKU-110K لمدة 100 حقبة وبحجم صورة 640، يمكنك استخدام مقتطفات الشيفرة التالية.
from ultralytics import YOLO
# تحميل نموذج
model = YOLO("yolo26n.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب)
# تدريب النموذج
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)البيانات النموذجية والتعليقات التوضيحية#
تلتقط صور SKU-110K منتجات متراصة على رفوف متاجر حقيقية، حيث تتجاور عشرات المنتجات المتشابهة تقريبًا. إليك صورة نموذجية مع شروحها:
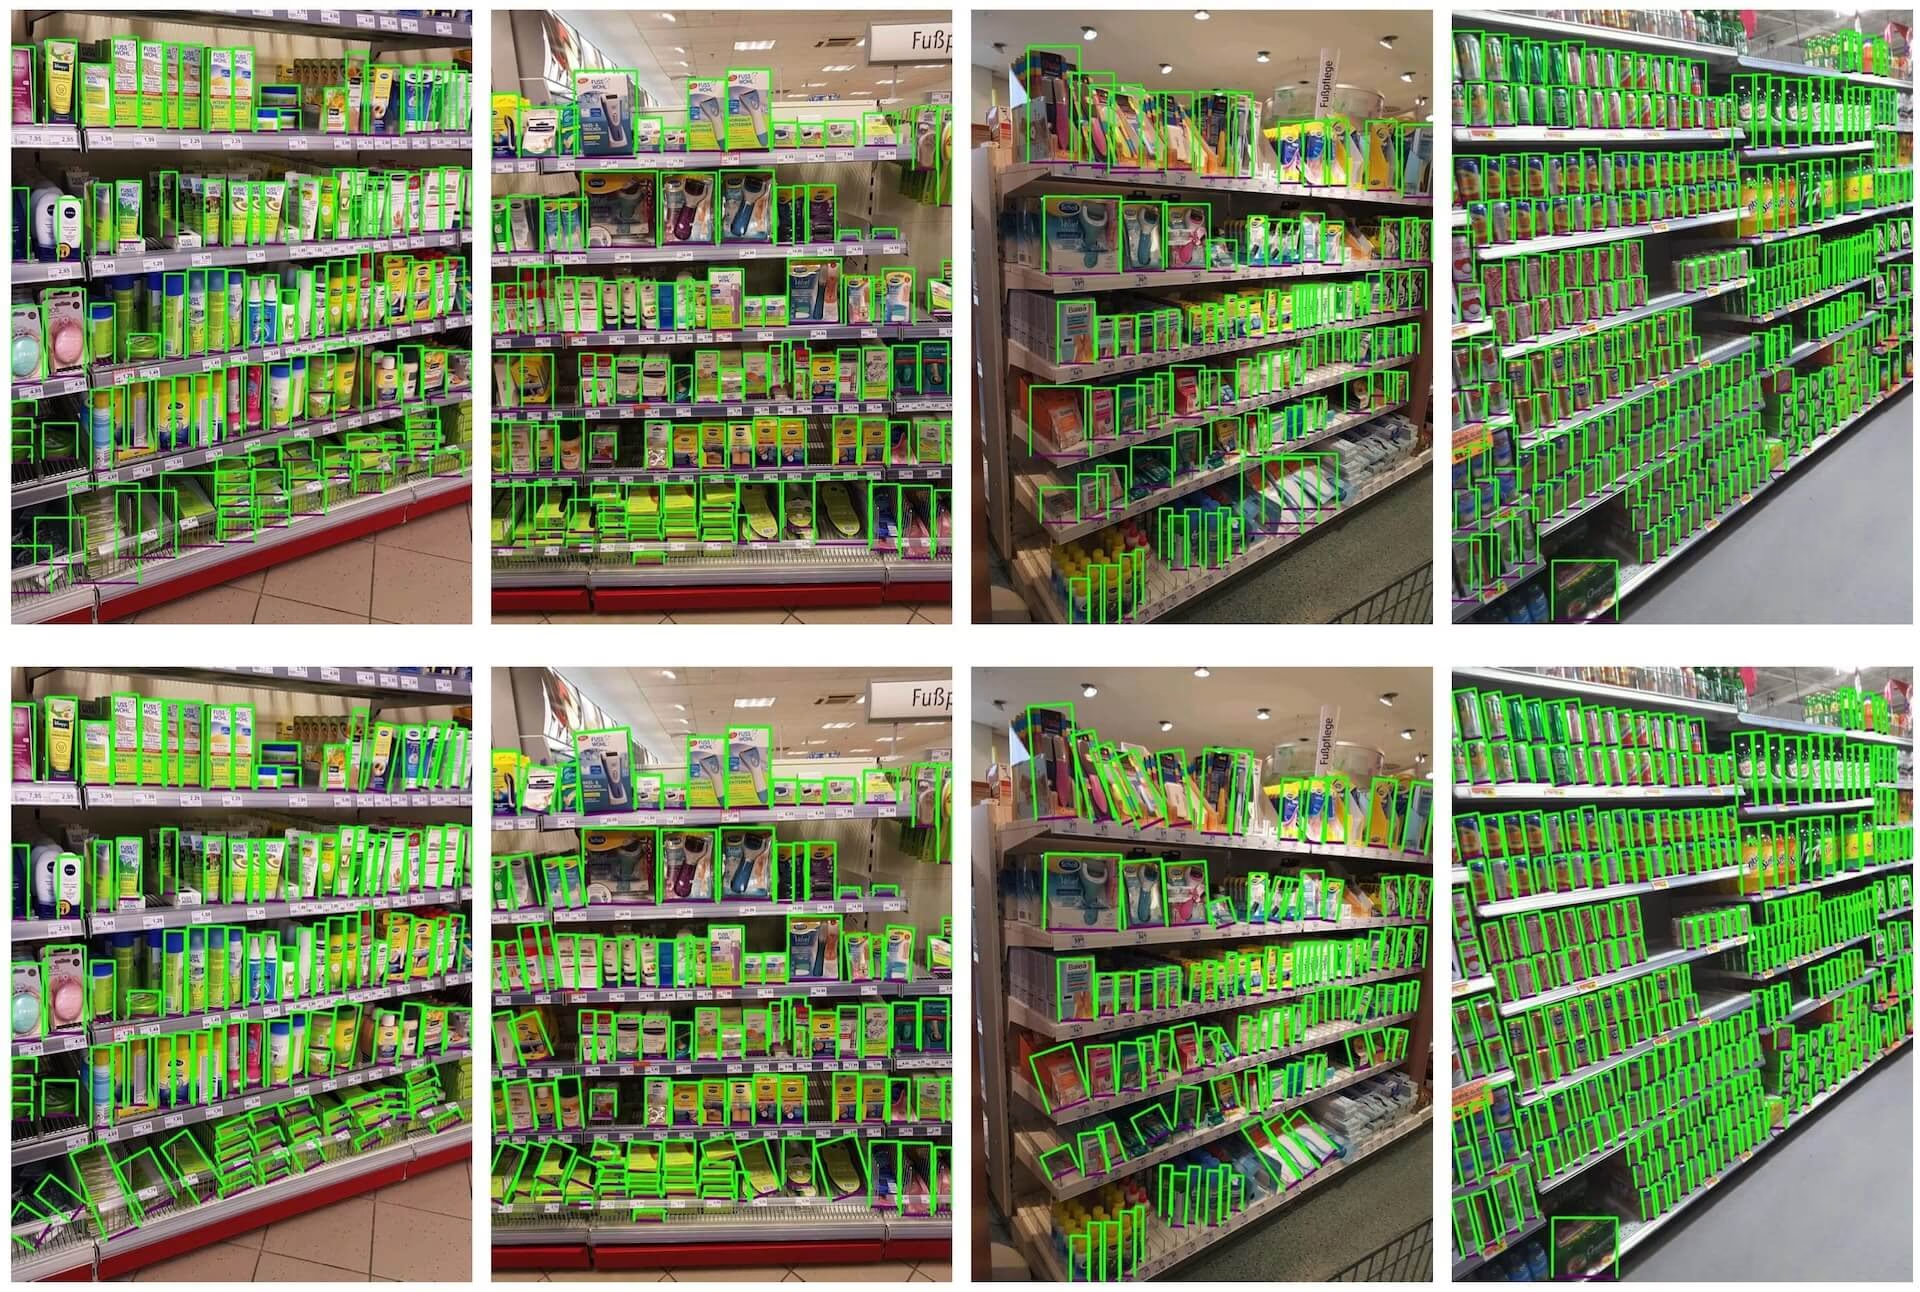
- صورة رف متجر مكتظ بالمنتجات: توضح هذه الصورة مثالًا على الأجسام المكتظة في بيئة رفوف متاجر البيع بالتجزئة. تُشرح الأجسام بمربعات إحاطة ضمن الفئة الوحيدة
object.
يجعل الترتيب الكثيف للمنتجات مجموعة بيانات SKU-110K ذات قيمة خاصة لتطوير حلول رؤية حاسوبية متينة تركز على البيع بالتجزئة، إذ يدفع العدد الكبير للأجسام في الصورة الواحدة الكواشف إلى ما يتجاوز المعايير المرجعية المعتادة.
الاستشهادات والشكر والتقدير#
إذا استخدمت مجموعة بيانات SKU-110K في أبحاثك أو أعمال التطوير، فيُرجى الاستشهاد بالورقة التالية:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
نود أن نعرب عن تقديرنا لـ Eran Goldman وآخرين لإنشاء مجموعة بيانات SKU-110K وصيانتها بوصفها موردًا قيّمًا لمجتمع أبحاث الرؤية الحاسوبية. لمزيد من المعلومات عن مجموعة بيانات SKU-110K ومنشئيها، تفضّل بزيارة مستودع SKU-110K على GitHub.
الأسئلة الشائعة#
مجموعة بيانات SKU-110K لاكتشاف الكائنات ضمن فئة واحدة، وتضم 11,743 صورة لرفوف متاجر مكتظة، أنشأها Eran Goldman وآخرون لبحثهم المنشور في CVPR 2019. ويُوسم كل منتج بصندوق إحاطة واحد من
object، كما تشمل الصور أكثر من 110,000 وحدة مخزون فريدة (SKUs)، ما يجعلها معيارًا قويًا لاكتشاف الكائنات في المشاهد المزدحمة وبناء أنظمة الرؤية الحاسوبية للتجزئة.لا. مجموعة SKU-110K أحادية الفئة: يُشرح كل منتج بمربع إحاطة واحد ضمن الفئة
object(names: {0: object}). يشير «110K» في الاسم إلى عدد وحدات حفظ المخزون الفريدة (SKUs) الظاهرة في الصور، وليس إلى عدد فئات الكشف.تضم مجموعة بيانات SKU-110K عدد 11,743 صورة — 8,219 للتدريب و588 للتحقق و2,936 للاختبار — وفئة كشف واحدة هي
object. راجع قسم بنية مجموعة البيانات وتهيئةSKU-110K.yamlللاطلاع على التفاصيل.يبلغ حجم SKU-110K نحو 13.6 GB، وتُنزّل تلقائيًا عند التدريب لأول مرة باستخدام
data="SKU-110K.yaml"، ولا يلزم تنزيلها يدويًا. لاستعراض خيارات أصغر، راجع نظرة عامة على مجموعات بيانات الكشف.تدريب نموذج YOLO26 على مجموعة بيانات SKU-110K عملية مباشرة. إليك مثالًا لتدريب نموذج YOLO26n لمدة 100 حقبة وبحجم صورة 640:
مثال على التدريبfrom ultralytics import YOLO # تحميل نموذج model = YOLO("yolo26n.pt") # تحميل نموذج مدرّب مسبقًا (موصى به للتدريب) # تدريب النموذج results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


التعليقات6
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.