تقطير المعرفة#
البدء السريع#
درّب نموذجًا طالبًا أصغر حجمًا بتوجيه من نموذج معلّم أكبر، وذلك بإضافة الوسيطة distill_model:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt")
ما تقطير المعرفة؟#
ينقل تقطير المعرفة المعرفة من نموذج معلّم كبير ودقيق إلى نموذج طالب أصغر. ويتعلم الطالب محاكاة تمثيلات السمات الداخلية للمعلّم، وغالبًا ما يحقق دقة أفضل من التدريب من البداية.
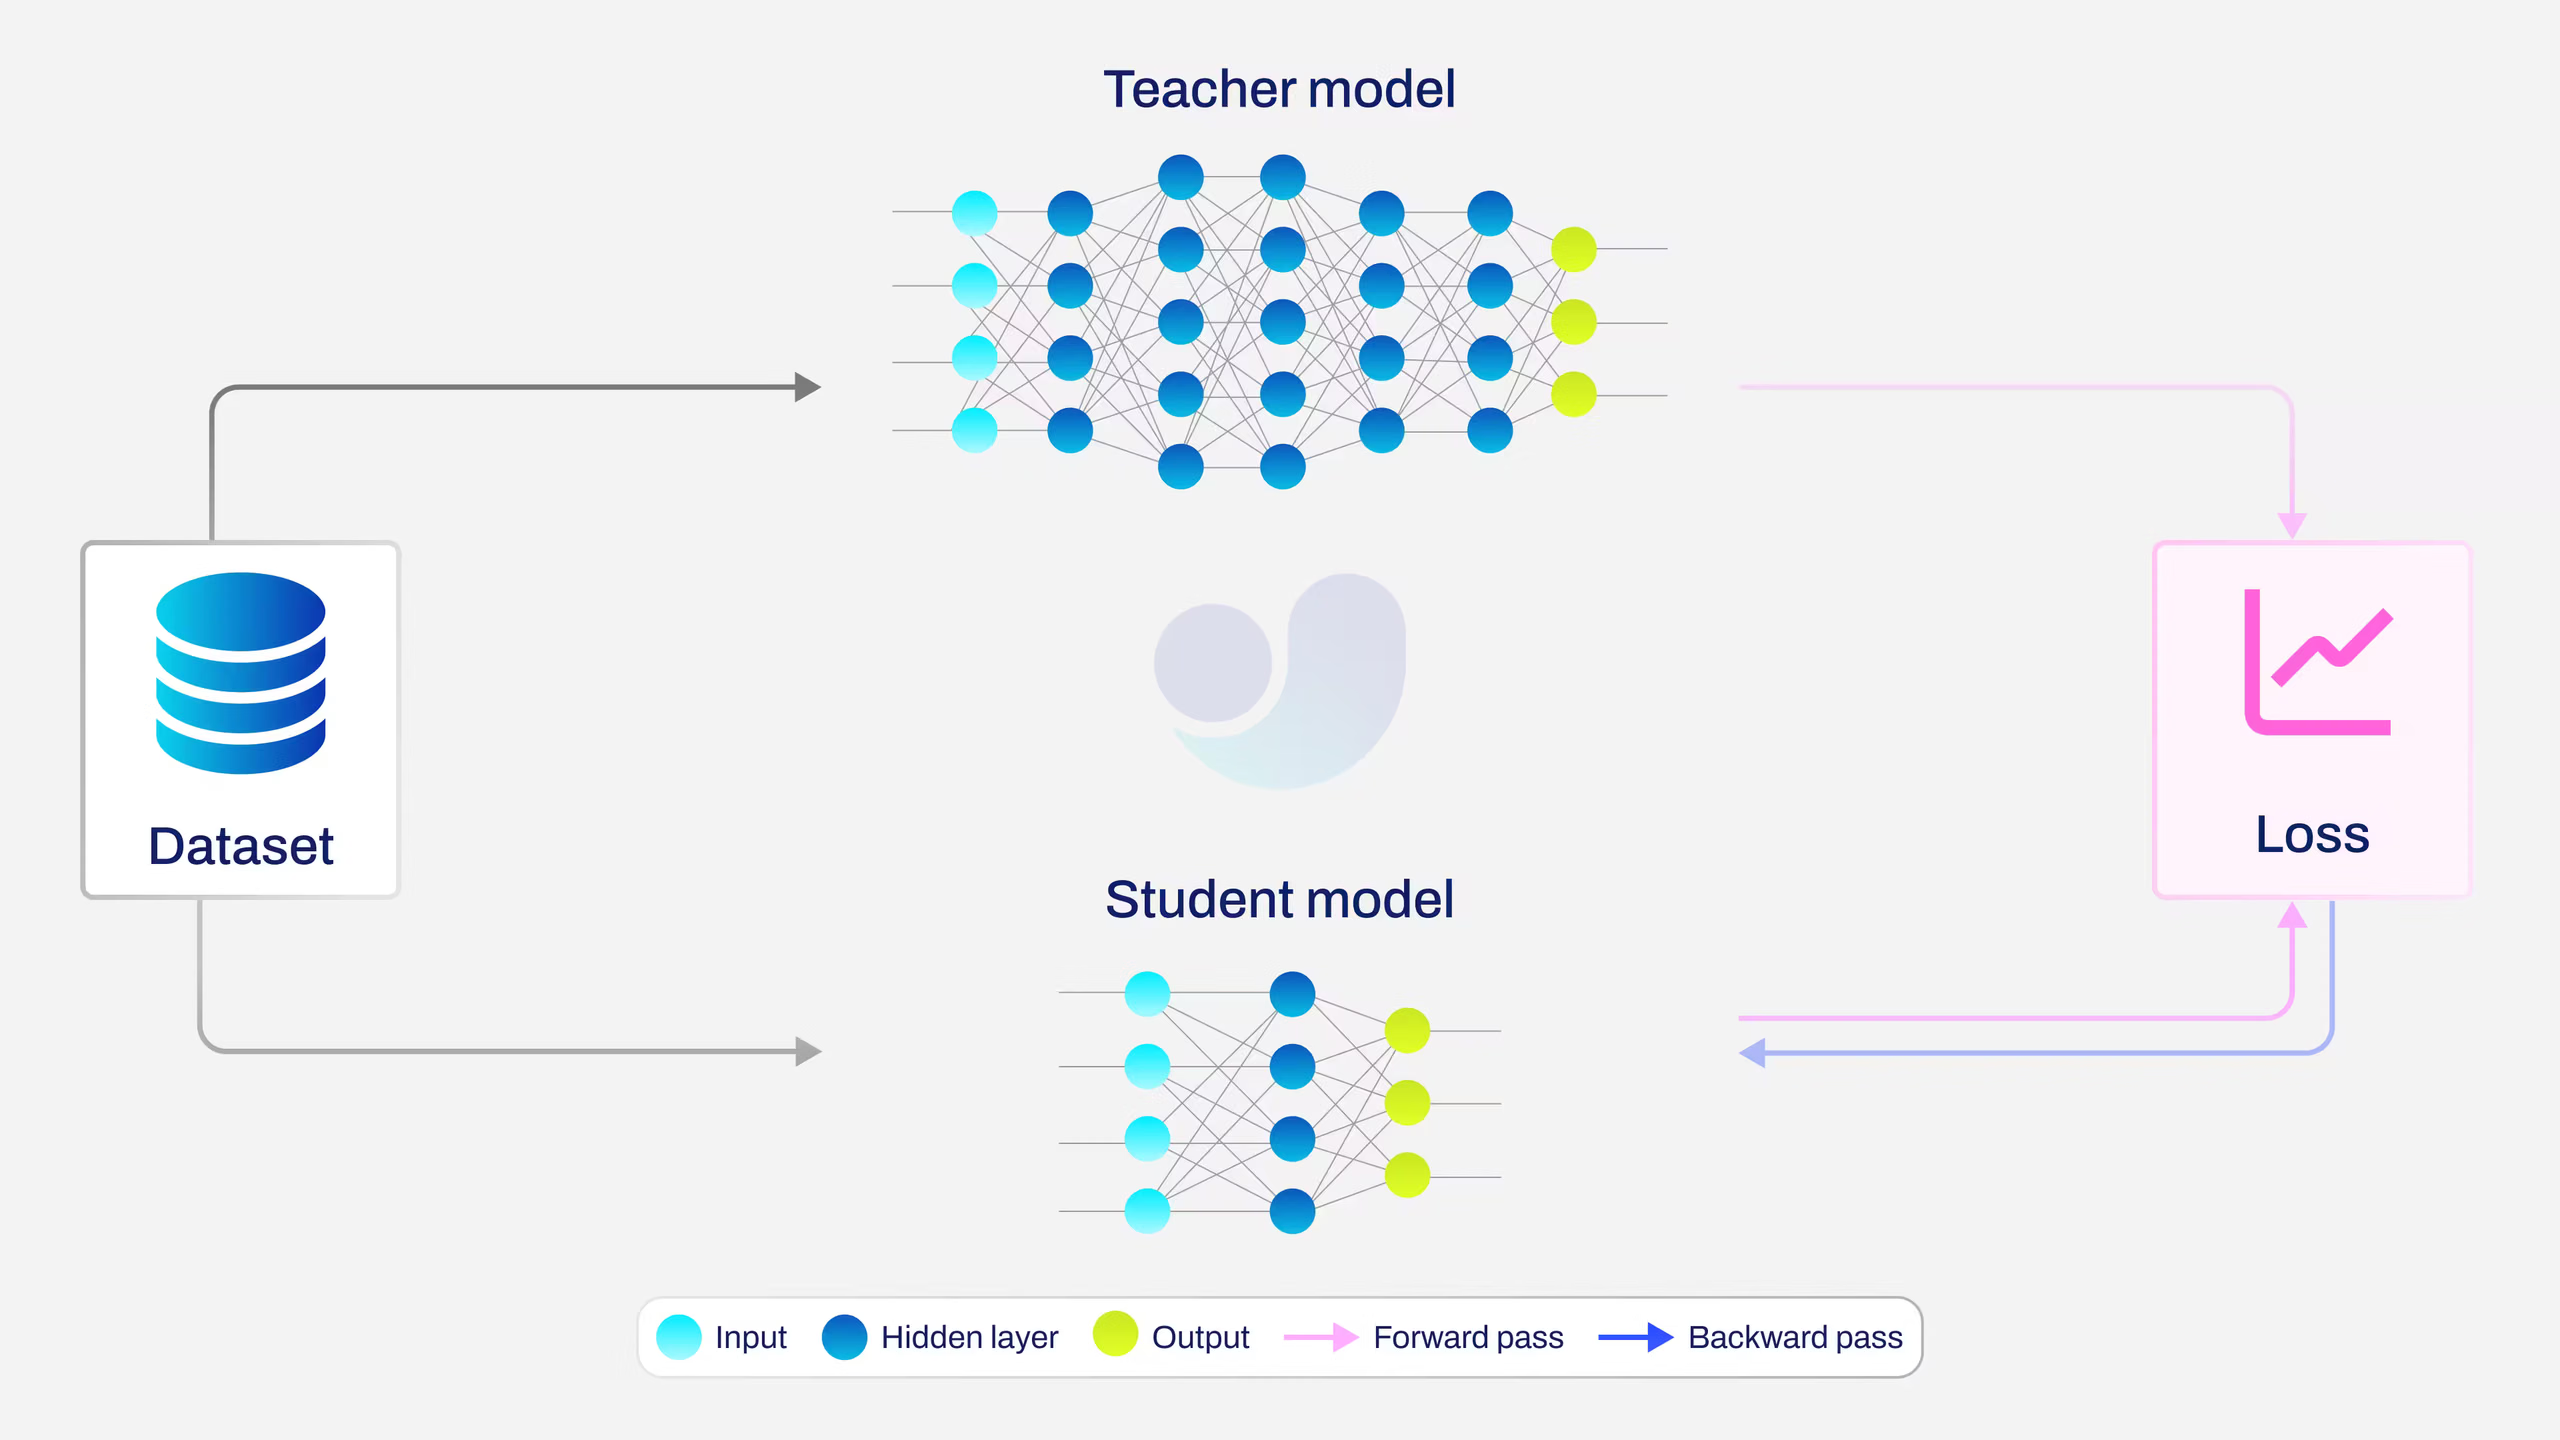
استخدم التقطير عندما:
- تحتاج إلى نموذج أصغر وأسرع للنشر
- لديك نموذج معلّم عالي الدقة مدرّب على البيانات نفسها
- تريد دقة أفضل مما يوفره التدريب التقليدي
يُطبّق تقطير المعرفة على مهام detect وsegment وpose وobb. وحتى الآن، جرى التحقق تجريبيًا من تحسينات الدقة لمهمة detect فقط.
الأداء#
يحسّن تقطير المعرفة mAP لنموذج الطالب عبر عائلة YOLO26 بأكملها على COCO، من دون زيادة تكلفة الاستدلال. يقارن الجدول أدناه نماذج YOLO26 القياسية (خط الأساس) بالنماذج نفسها بعد تدريبها بالتقطير من المعلّم الموصى به لكل منها.
| النموذج | الحجم (بكسل) | mAPالتحقق 50-95 خط الأساس | mAPالتحقق 50-95 مقطّر | mAPالتحقق 50-95 (e2e) خط الأساس | mAPالتحقق 50-95 (e2e) مقطّر |
|---|---|---|---|---|---|
| YOLO26n-distill | 640 | 40.9 | 41.5 | 40.1 | 40.9 |
| YOLO26s-distill | 640 | 48.6 | 49.2 | 47.8 | 48.6 |
| YOLO26m-distill | 640 | 53.1 | 53.9 | 52.5 | 53.3 |
| YOLO26l-distill | 640 | 55.0 | 56.0 | 54.4 | 55.5 |
| YOLO26x-distill | 640 | 57.5 | 57.9 | 56.9 | 57.4 |
- قيم mAPالتحقق محسوبة لنموذج واحد ومقياس واحد على مجموعة بيانات COCO val2017.
أعِد إنتاج صف مُقطّر باستخدامyolo val detect model=yolo26n-distill.pt data=coco.yaml device=0؛ وأضفnms=Falseلعمود e2e. - تستخدم قيم e2e مسار استدلال خاليًا من NMS (
nms=False)، بينما تستخدم القيم غير المتعلقة بـ e2e المعالجة اللاحقة الافتراضية لـ NMS (nms=None). راجع الكشف من البداية إلى النهاية لمزيد من التفاصيل.
المتطلبات الأساسية#
قبل البدء، تأكد من استيفاء المتطلبات التالية:
- نموذج معلّم مدرّب: نقطة تحقق
.ptمن عائلة YOLO نفسها التي ينتمي إليها الطالب. - تطابق المهمة: استخدم معلّمًا للمهمة نفسها التي ينفذها الطالب، ودرّبه على بيانات ذات صلة.
- موارد GPU: ذاكرة كافية لاستيعاب النموذجين؛ يعمل المعلّم في الاتجاه الأمامي فقط، من دون تدرجات أو حالة المحسّن.
أزواج النماذج الموصى بها#
| الطالب | المعلّم الموصى به |
|---|---|
yolo26n.pt | yolo26s.pt |
yolo26s.pt | yolo26m.pt |
yolo26m.pt | yolo26x.pt |
yolo26l.pt | yolo26x.pt |
التقطير بين عائلات مختلفة (مثل استخدام معلّم YOLO11 مع طالب YOLO26) غير مدعوم.
المعلمات الرئيسية#
| المعلمة | النوع | الافتراضي | الوصف |
|---|---|---|---|
distill_model | str | None | مسار ملف نموذج المعلّم (مثل yolo26x.pt). يؤدي تعيين هذا المسار إلى تفعيل تقطير المعرفة. |
dis | float | 6.0 | وزن خسارة التقطير. يتحكم في مقدار مساهمة خسارة التقطير في خسارة التدريب الإجمالية. |
آلية العمل#
- يبقى نموذج المعلّم مجمّدًا في وضع
eval، وينفذ الاستدلال على كل دفعة - يُدرّب نموذج الطالب باستخدام خسائر المهمة القياسية، بالإضافة إلى توجيه التقطير
- تُستخرج السمات من كلا النموذجين عند طبقات العنق الثلاث التي تغذي رأس عائلة Detect
- تُواءم أداة إسقاط تتكون من التفافين 1×1 مع ReLU كل خريطة سمات للطالب مع قنوات المعلّم
- تقارن خسارة L2 الموزونة بالدرجة سمات الطالب بعد الإسقاط بسمات المعلّم، مع ترجيحها وفق ثقة المعلّم في التصنيف
- تُدمج خسارة التقطير مع الخسائر القياسية باستخدام الوزن
dis
flowchart TD
    A[Input Image Batch]:::start --> T[Teacher Model<br/>frozen, eval mode]:::extern
    A --> S[Student Model<br/>trainable]:::proc

    T --> |Detect head inputs| TF[Teacher Features]:::extern
    S --> |Detect head inputs| SF[Student Features]:::proc

    SF --> P[1×1 Conv Projector<br/>with ReLU]:::decide
    P --> AF[Aligned Student Features]:::proc

    TF --> SW[Score-weighted L2 Loss]:::proc
    AF --> SW

    S --> D[Detection Head]:::proc
    D --> DL[box_loss + cls_loss + l1_loss]:::proc

    SW --> |× dis| DIS[distillation loss]:::proc
    DL --> TOTAL[Total Loss]:::out
    DIS --> TOTAL

    TOTAL --> BP[Backpropagate<br/>Student + Projector only]:::out

    classDef start fill:#4CAF50,color:#fff
    classDef proc fill:#2196F3,color:#fff
    classDef decide fill:#FF9800,color:#fff
    classDef out fill:#9C27B0,color:#fff
    classDef extern fill:#607D8B,color:#fff
دعم المهام#
يستخرج تطبيق التقطير السمات من طبقات العنق الثلاث التي تغذي رأس عائلة Detect في النموذج. وبما أن رأسي segment وpose وobb ترث البنية نفسها Detect، فإن التقطير متوافق تقنيًا مع هذه المهام أيضًا.
لا يستخدم التصنيف والتقسيم الدلالي وتقدير العمق وRT-DETR رأسًا متوافقًا من عائلة Detect، لذا فهي غير مدعومة.
لم يُختبر تجريبيًا ويُتحقق منه إلا لمهمة detect. يمكنك إجراء التقطير لمهام segment أو pose أو obb، لكن تحسينات الدقة لهذه المهام لم تُعتمد بعد.
from ultralytics import YOLO

# Segment
model = YOLO("yolo26n-seg.pt")
model.train(data="coco8-seg.yaml", epochs=100, distill_model="yolo26s-seg.pt")

# Pose
model = YOLO("yolo26n-pose.pt")
model.train(data="coco8-pose.yaml", epochs=100, distill_model="yolo26s-pose.pt")

# OBB
model = YOLO("yolo26n-obb.pt")
model.train(data="dota8.yaml", epochs=100, distill_model="yolo26s-obb.pt")التدريب#
التدريب الأساسي#
التدريب بالتقطير مماثل للتدريب القياسي. حدّد مسار distill_model لتفعيله:
from ultralytics import YOLO
# تحميل نموذج طالب
student = YOLO("yolo26m.pt")
# التدريب بتقطير المعرفة من نموذج معلّم أكبر
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26x.pt")ضبط وزن خسارة التقطير#
تتحكم المعلمة dis (القيمة الافتراضية: 6.0) في مساهمة خسارة التقطير:
from ultralytics import YOLO

student = YOLO("yolo26n.pt")
results = student.train(data="coco8.yaml", epochs=100, distill_model="yolo26s.pt", dis=10.0)
استئناف التدريب بالتقطير#
يدعم التدريب بالتقطير الاستئناف من نقاط التحقق. ويُعاد إنشاء نموذج المعلّم تلقائيًا من المسار distill_model المسجل في نقطة التحقق:
from ultralytics import YOLO

student = YOLO("runs/detect/train/weights/last.pt")
results = student.train(resume=True)
مخرجات التدريب#
عند تفعيل التقطير، يظهر عمود إضافي dis_loss في سجلات التدريب:
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss   dis_loss  Instances       Size
      1/80      46.2G      1.566      5.404    0.003249      6.658        231        640
يحتوي النموذج المُصدّر على أوزان الطالب فقط — ويتطابق حجم الملف وسرعة الاستدلال مع نموذج طالب دُرّب بالطريقة المعتادة.
الأسئلة الشائعة#
- تحقق من أن المعلّم والطالب ينتميان إلى جيل YOLO نفسه
- تأكد من صحة مسار
distill_modelومن إمكانية تحميل الملف - جرّب زيادة
disإذا كانت قيمة الخسارة صغيرة جدًا - تأكد من تدريب نموذج المعلّم على مجموعة البيانات نفسها
أضف المعلمة
distill_model— وسيعمل كل ما عدا ذلك بالطريقة نفسها. تُحسب خسارة تقطير إضافية أثناء التدريب، لكن النموذج المحفوظ هو نموذج YOLO قياسي بلا أي عبء إضافي.نعم. ينفذ المعلّم تمريرة أمامية لكل دفعة، لذا يعتمد العبء الإضافي على الوقت والذاكرة على زوج المعلّم والطالب. يعمل المعلّم في وضع
evalمن دون تدرجات أو حالة المحسّن.يعمل تقطير المعرفة مع مهام detect وsegment وpose وobb، لأنه يقطّر السمات من طبقات العنق الثلاث التي تغذي رأس عائلة Detect. أما classify وsemantic وdepth وRT-DETR فغير مدعومة.
لم يُتحقَّق تجريبيًا من تحسينات الدقة إلا في detect. تتوافق مهام segment وpose وobb تقنيًا، لكن لم تُقَيَّم معياريًا بعد.
يجب أن ينتمي المعلّم والطالب إلى عائلة YOLO نفسها (مثل YOLOv8 أو YOLO11 أو YOLO26). لا يُدعم التقطير بين عائلات مختلفة (مثل معلّم YOLO11 وطالب YOLO26).