دليل البدء السريع: NVIDIA DGX Spark مع Ultralytics YOLO26
يشرح هذا الدليل خطوات نشر Ultralytics YOLO26 على NVIDIA DGX Spark، وهو حاسوب NVIDIA الفائق للذكاء الاصطناعي والمخصص لسطح المكتب، ويتضمن اختبارات أداء YOLO11 عبر تنسيقات تصدير مختلفة على هذا النظام.
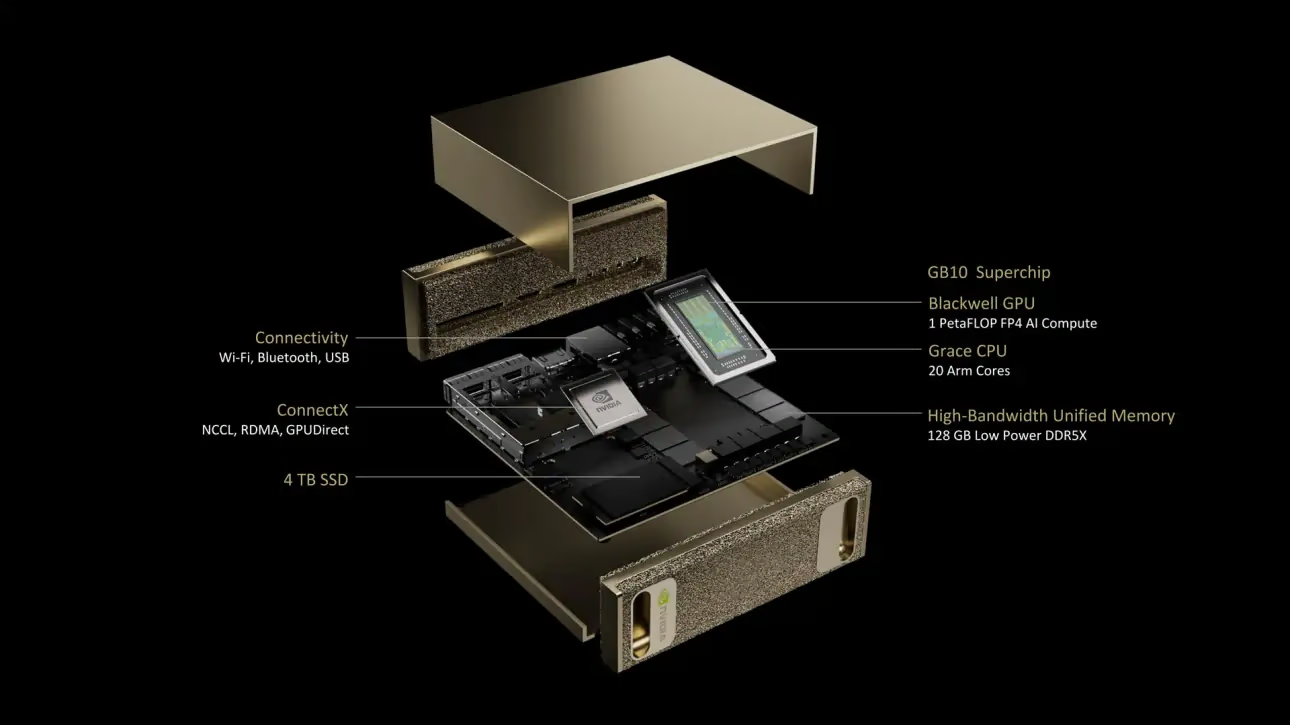
اختُبر هذا الدليل على NVIDIA DGX Spark Founders Edition الذي يعمل بنظام DGX OS المستند إلى Ubuntu. ومن المتوقع أن يعمل مع أحدث إصدارات DGX OS.
ما NVIDIA DGX Spark؟#
NVIDIA DGX Spark حاسوب فائق للذكاء الاصطناعي صغير الحجم ومخصص لسطح المكتب، يعمل بشريحة NVIDIA GB10 Grace Blackwell Superchip. ويوفر أداء حوسبة للذكاء الاصطناعي يصل إلى 1 petaFLOP بدقة FP4، وصُمم للمطورين والباحثين وعلماء البيانات الذين يحتاجون إلى إمكانات ذكاء اصطناعي قوية ضمن جهاز مكتبي.
شاهد: كيفية الوصول إلى 1000 FPS باستخدام Ultralytics YOLO26 على NVIDIA DGX Spark | TensorRT واستدلال الدُفعات
المواصفات الرئيسية#
| المواصفة | التفاصيل |
|---|---|
| أداء الذكاء الاصطناعي | حتى 1 PFLOP (FP4) |
| GPU | بنية NVIDIA Blackwell مع أنوية Tensor من الجيل الخامس وأنوية RT من الجيل الرابع |
| CPU | معالج Arm ذو 20 نواة (10 Cortex-X925 + 10 Cortex-A725) |
| الذاكرة | ذاكرة نظام موحّدة LPDDR5x بسعة 128 GB، وواجهة 256-bit، وتردد 4266 MHz، وعرض نطاق 273 GB/s |
| التخزين | NVMe M.2 بسعة 1 TB أو 4 TB مع التشفير الذاتي |
| الشبكة | منفذ RJ-45 واحد (10 GbE)، وبطاقة شبكة ذكية ConnectX-7، وWi-Fi 7، وBluetooth 5.4 |
| الاتصال | 4 منافذ USB Type-C، ومنفذ HDMI 2.1a واحد، وصوت متعدد القنوات عبر HDMI |
| معالجة الفيديو | وحدة NVENC واحدة، ووحدة NVDEC واحدة |
DGX OS#
يُعد NVIDIA DGX OS توزيعة Linux مخصصة توفر أساسًا مستقرًا ومختبرًا ومدعومًا لنظام التشغيل، لتشغيل تطبيقات الذكاء الاصطناعي والتعلم الآلي والتحليلات على أنظمة DGX. وتتضمن:
- أساسًا متينًا من Linux محسّنًا لأحمال عمل الذكاء الاصطناعي
- برامج تشغيل وإعدادات نظام مُهيأة مسبقًا لأجهزة NVIDIA
- تحديثات أمنية وإمكانات صيانة النظام
- التوافق مع منظومة برامج NVIDIA الأوسع
يتبع DGX OS جدول إصدار منتظمًا، وتُوفَّر التحديثات عادةً مرتين سنويًا (نحو فبراير وأغسطس)، مع توفير تصحيحات أمنية إضافية بين الإصدارات الرئيسية.
لوحة تحكم DGX#
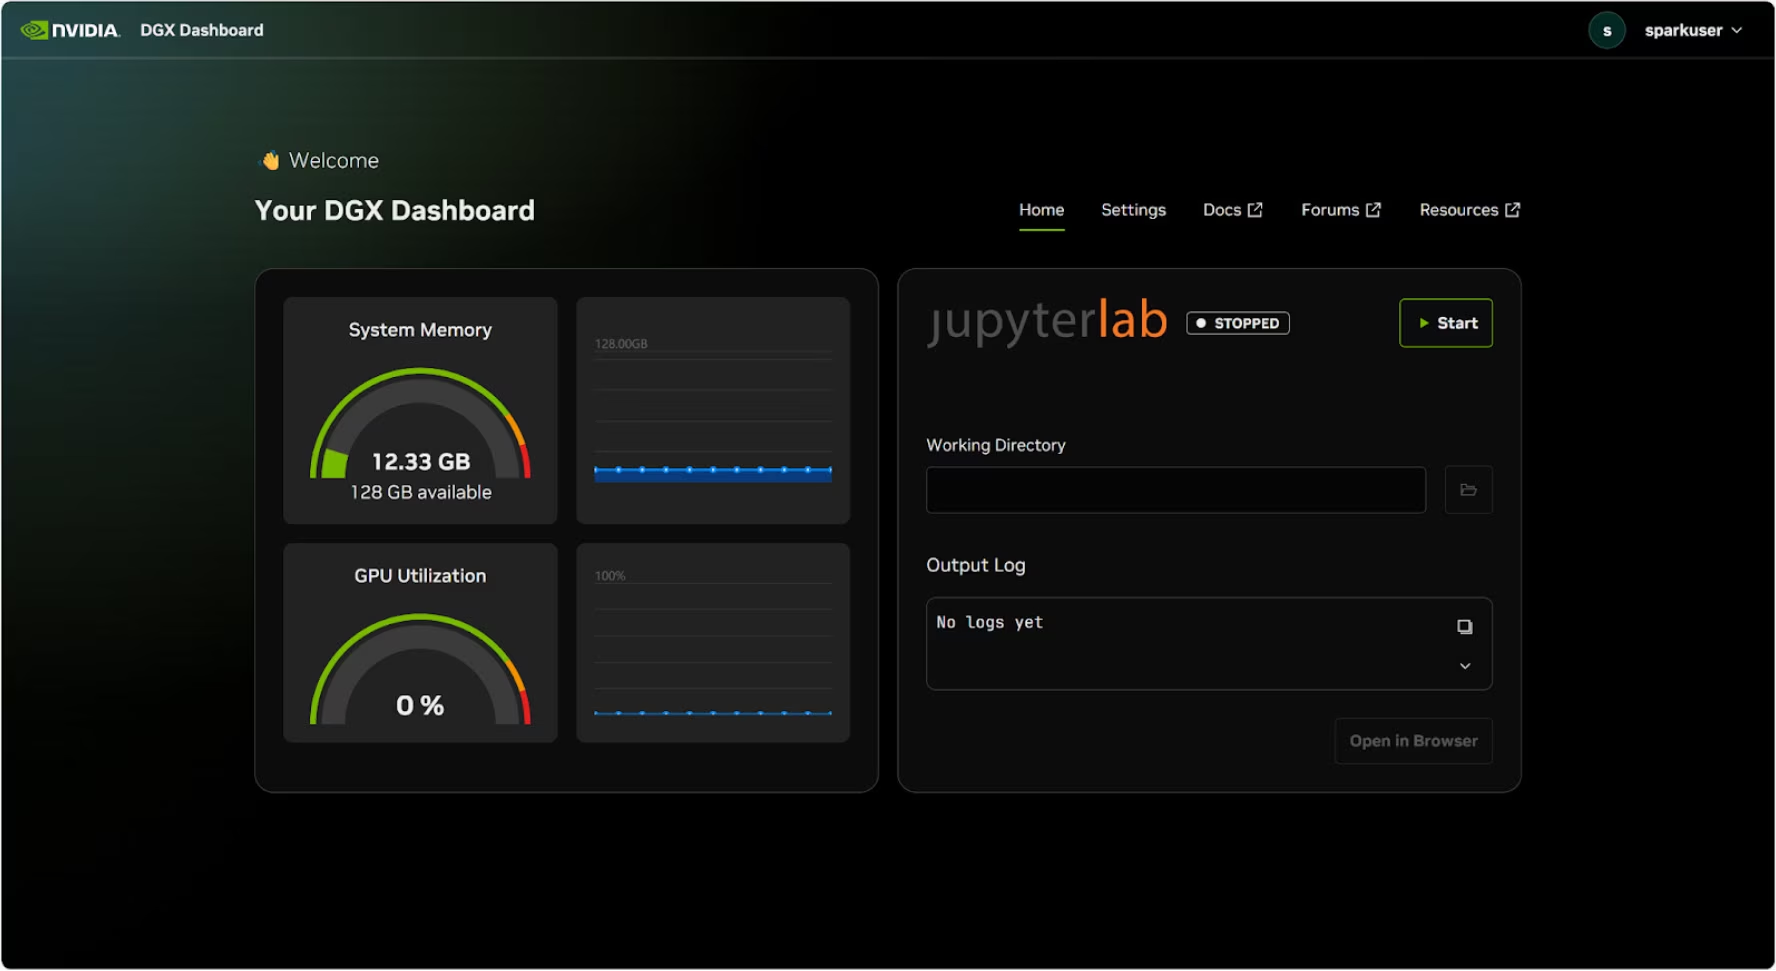
يأتي DGX Spark مزودًا بـلوحة تحكم DGX مدمجة توفر:
- مراقبة النظام في الوقت الفعلي: نظرة عامة على مقاييس التشغيل الحالية للنظام
- تحديثات النظام: إمكانية تطبيق التحديثات مباشرةً من لوحة التحكم
- إعدادات النظام: تغيير اسم الجهاز والإعدادات الأخرى
- JupyterLab مدمج: الوصول إلى دفاتر Jupyter المحلية لأغراض التطوير
الوصول إلى لوحة التحكم#
انقر زر "إظهار التطبيقات" في الزاوية السفلية اليسرى من سطح مكتب Ubuntu، ثم اختر "DGX Dashboard" لفتحها في المتصفح.
تتضمن لوحة التحكم نسخة مدمجة من JupyterLab تُنشئ تلقائيًا بيئة افتراضية وتثبّت الحزم الموصى بها عند تشغيلها. ويُخصَّص لكل حساب مستخدم منفذ مخصص للوصول إلى JupyterLab.
البدء السريع باستخدام Docker#
أسرع طريقة للبدء باستخدام Ultralytics YOLO26 على NVIDIA DGX Spark هي تشغيل صور Docker المُنشأة مسبقًا. تدعم صورة NVIDIA بمعمارية ARM64 جهاز DGX Spark مع DGX OS.
t=ultralytics/ultralytics:latest-nvidia-arm64
sudo docker pull $t && sudo docker run -it --ipc=host --device nvidia.com/gpu=all $t
ينطبق طلب جهاز CDI أعلاه على DGX Spark الذي يعمل بنظام DGX OS. لأحمال عمل PyTorch على Jetson AGX Thor، راجع متطلبات المضيف المنفصلة وقيد TensorRT في دليل NVIDIA Jetson.
تستخدم هذه الصورة NVIDIA PyTorch 26.10 وCUDA 13.4 وTensorRT 11.4. حدّث برنامج تشغيل المضيف على DGX OS إلى إصدار تدعمه NVIDIA PyTorch 26.10، وأعد بناء محركات TensorRT بعد تغيير الصورة أو وحدة GPU المستهدفة.
بعد إتمام ذلك، انتقل إلى استخدام TensorRT على NVIDIA DGX Spark.
ابدأ بالتثبيت الأصلي#
لإجراء تثبيت أصلي دون Docker، اتبع هذه الخطوات.
تثبيت حزمة Ultralytics#
سنثبّت هنا حزمة Ultralytics على DGX Spark. تُثبّت تبعيات التصدير تلقائيًا عند تصدير نموذج للمرة الأولى، لذا لا تحتاج هنا إلا إلى الحزمة الأساسية. يركز هذا الدليل على عمليات التصدير إلى NVIDIA TensorRT، لأن TensorRT يوفر أعلى أداء على DGX Spark.
-
حدّث قائمة الحزم، وثبّت pip، ثم رقِّه إلى أحدث إصدار
sudo apt update sudo apt install python3-pip -y pip install -U pip -
ثبّت حزمة pip المسماة
ultralyticspip install ultralytics -
أعِد تشغيل الجهاز
sudo reboot
تثبيت PyTorch وTorchvision#
يثبّت ultralytics المذكور أعلاه PyTorch وTorchvision. لكن هذه الحزم المثبتة عبر pip قد لا تكون محسّنة بالكامل لبنية ARM64 في DGX Spark مع CUDA 13. لذلك نوصي بتثبيت الإصدارات المتوافقة مع CUDA 13:
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu130عند تشغيل PyTorch 2.9.1 على NVIDIA DGX Spark، قد تواجه UserWarning التالية عند تهيئة CUDA (مثلًا عند تشغيل yolo checks وyolo predict وما إلى ذلك):
UserWarning: Found GPU0 NVIDIA GB10 which is of cuda capability 12.1.
Minimum and Maximum cuda capability supported by this version of PyTorch is (8.0) - (12.0)
يمكن تجاهل هذا التحذير بأمان.
ثبّت onnxruntime-gpu#
توفر إصدارات ONNX Runtime GPU الحالية حزم Linux ARM64، بما فيها Python 3.12. تثبّت صورة NVIDIA ARM64 لـDocker الحزمة الرسمية؛ أما عمليات التثبيت الأصلية باستخدام CUDA 13، فاستخدم:
pip install onnxruntime-gpuاستخدام TensorRT على NVIDIA DGX Spark#
من بين جميع تنسيقات تصدير النماذج التي يدعمها Ultralytics، يوفر TensorRT أعلى أداء للاستدلال على NVIDIA DGX Spark، ما يجعله خيارنا الأول لعمليات النشر.
تحويل النموذج إلى TensorRT وتشغيل الاستدلال#
يُحوّل نموذج YOLO26n بتنسيق PyTorch إلى TensorRT، ثم يُستخدم النموذج المُصدّر للاستدلال.
from ultralytics import YOLO
# تحميل نموذج YOLO26n بصيغة PyTorch
model = YOLO("yolo26n.pt")
# صدّر النموذج إلى TensorRT FP16
model.export(format="engine", quantize=16) # ينشئ 'yolo26n.engine'
# تحميل نموذج TensorRT المُصدَّر
trt_model = YOLO("yolo26n.engine")
# تنفيذ الاستدلال
results = trt_model("https://ultralytics.com/images/bus.jpg")معايير أداء YOLO11 على NVIDIA DGX Spark#
أجرى فريق Ultralytics اختبارات أداء YOLO11 على تنسيقات متعددة للنماذج، مع قياس السرعة والدقة: PyTorch وTorchScript وONNX وOpenVINO وTensorRT وTF SavedModel وTF GraphDef وTF Lite وMNN وNCNN وExecuTorch. أُجريت الاختبارات على NVIDIA DGX Spark بدقة FP32 وبحجم صورة الإدخال الافتراضي 640.
جدول مقارنة مفصل#
يعرض الجدول أدناه نتائج قياس الأداء لخمسة نماذج مختلفة (YOLO11n وYOLO11s وYOLO11m وYOLO11l وYOLO11x) عبر تنسيقات متعددة، موضحًا الحالة والحجم ومقياس mAP50-95(B) وزمن الاستدلال لكل تركيبة.
| التنسيق | الحالة | الحجم على القرص (MB) | mAP50-95(B) | وقت الاستدلال (ms/im) |
|---|---|---|---|---|
| PyTorch | ✅ | 5.4 | 0.5071 | 2.67 |
| TorchScript | ✅ | 10.5 | 0.5083 | 2.62 |
| ONNX | ✅ | 10.2 | 0.5074 | 5.92 |
| OpenVINO | ✅ | 10.4 | 0.5058 | 14.95 |
| TensorRT (FP32) | ✅ | 12.8 | 0.5085 | 1.95 |
| TensorRT (FP16) | ✅ | 7.0 | 0.5068 | 1.01 |
| TensorRT (INT8) | ✅ | 18.6 | 0.4880 | 1.62 |
| TF SavedModel | ✅ | 25.7 | 0.5076 | 36.39 |
| TF GraphDef | ✅ | 10.3 | 0.5076 | 41.06 |
| TF Lite | ✅ | 10.3 | 0.5075 | 64.36 |
| MNN | ✅ | 10.1 | 0.5075 | 12.14 |
| NCNN | ✅ | 10.2 | 0.5041 | 12.31 |
| ExecuTorch | ✅ | 10.2 | 0.5075 | 27.61 |
أُجري اختبار الأداء باستخدام Ultralytics 8.3.249
إعادة إنتاج نتائجنا#
لإعادة إنتاج اختبارات الأداء التي أجراها Ultralytics أعلاه على جميع تنسيقات التصدير، شغّل هذه الشيفرة:
from ultralytics import YOLO
# تحميل نموذج YOLO26n بصيغة PyTorch
model = YOLO("yolo26n.pt")
# اختبر سرعة YOLO26n ودقته على مجموعة البيانات COCO128 بجميع تنسيقات التصدير
results = model.benchmark(data="coco128.yaml", imgsz=640)لاحظ أن نتائج الاختبارات المعيارية قد تختلف بحسب تكوين الأجهزة والبرامج الدقيق للنظام، وكذلك بحسب الحمل الحالي على النظام عند تشغيل الاختبارات. للحصول على نتائج موثوقة قدر الإمكان، استخدم مجموعة بيانات تحتوي على عدد كبير من الصور، مثل data='coco.yaml' (5000 صورة تحقق).
دقة YOLO26 باستخدام TensorRT على DGX Spark#
عند حجم دفعة 1 على DGX Spark، يكون TensorRT INT8 أبطأ من FP16 مع YOLO26n وYOLO26s، ويكاد يساويه مع YOLO26m (ضمن 2% في كل من التحقق ووقت حساب GPU في trtexec). كما يخسر INT8 ما بين 1.1 و1.8 من mAP، لذا يُعد FP16 الخيار الأفضل لهذه النماذج. ويُظهر جدول YOLO11 أعلاه النمط نفسه: يكون TensorRT (INT8) أبطأ من TensorRT (FP16) مع النماذج الخمسة جميعها.
| النموذج | التنسيق | الحجم على القرص (MB) | mAP50-95(B) | وقت الاستدلال (ms/im) |
|---|---|---|---|---|
| YOLO26n | TensorRT (FP16) | 6.7 | 0.4032 | 0.79 |
| YOLO26n | TensorRT (INT8) | 28.4 | 0.3849 | 1.43 |
| YOLO26s | TensorRT (FP16) | 20.3 | 0.4793 | 1.49 |
| YOLO26s | TensorRT (INT8) | 34.4 | 0.4644 | 1.73 |
| YOLO26m | TensorRT (FP16) | 41.1 | 0.5266 | 2.70 |
| YOLO26m | TensorRT (INT8) | 45.0 | 0.5156 | 2.74 |
تستند الدقة والسرعة إلى التحقق باستخدام COCO val2017 (5000 صورة) بحجم صورة 640 وحجم دفعة 1. وتُعايَر محركات INT8 باستخدام COCO128. أُجري الاختبار باستخدام Ultralytics 8.4.192 في ultralytics/ultralytics:latest-nvidia-arm64 (NVIDIA PyTorch 26.08، وTensorRT 11.2.1.2، وModelOpt 0.45.0).
أفضل الممارسات لاستخدام NVIDIA DGX Spark#
عند استخدام NVIDIA DGX Spark، اتبع أفضل الممارسات التالية لتحقيق أفضل أداء عند تشغيل YOLO26.
-
مراقبة أداء النظام
استخدم أدوات المراقبة من NVIDIA لتتبّع استخدام GPU وCPU:
nvidia-smi -
تحسين استخدام الذاكرة
بفضل ذاكرة موحدة بسعة 128 GB، يستطيع DGX Spark التعامل مع أحجام الدُفعات والنماذج الكبيرة. فكّر في زيادة حجم الدفعة لتحسين معدل النقل:
from ultralytics import YOLO model = YOLO("yolo26n.engine") results = model.predict(source="path/to/images", batch=16) -
استخدم TensorRT FP16
عند حجم دفعة 1 على DGX Spark، يكون INT8 أبطأ من FP16 مع YOLO26n وYOLO26s، ولا يكون أسرع مع YOLO26m، كما أنه أقل دقة (انظر دقة YOLO26 باستخدام TensorRT على DGX Spark):
yolo export model=yolo26n.pt format=engine quantize=16 # FP16
تحديثات النظام (إصدار Founders Edition)#
يُعد إبقاء إصدار DGX Spark Founders Edition محدّثًا أمرًا بالغ الأهمية للأداء والأمان. توفر NVIDIA طريقتين أساسيتين لتحديث نظام التشغيل وبرامج التشغيل والبرامج الثابتة للنظام.
استخدام لوحة تحكم DGX (موصى به)#
تُعد لوحة تحكم DGX الطريقة الموصى بها لإجراء تحديثات النظام مع ضمان التوافق. وتتيح لك:
- عرض تحديثات النظام المتاحة
- تثبيت التصحيحات الأمنية وتحديثات النظام
- إدارة تحديثات برامج تشغيل NVIDIA والبرامج الثابتة
تحديثات النظام يدويًا#
يمكن للمستخدمين المتقدمين إجراء التحديثات يدويًا عبر الطرفية:
sudo apt update
sudo apt dist-upgrade
sudo fwupdmgr refresh
sudo fwupdmgr upgrade
sudo rebootتأكد من توصيل النظام بمصدر طاقة مستقر ونسخ البيانات المهمة احتياطيًا قبل إجراء التحديثات.
الخطوات التالية#
للمزيد من التعلّم والدعم، راجع وثائق Ultralytics YOLO26.
الأسئلة الشائعة#
يُعد نشر Ultralytics YOLO26 على NVIDIA DGX Spark أمرًا مباشرًا. يمكنك استخدام صورة Docker مُنشأة مسبقًا للإعداد السريع، أو تثبيت الحزم المطلوبة يدويًا. تتوفر الخطوات التفصيلية لكل طريقة في قسمي البدء السريع باستخدام Docker والبدء بالتثبيت الأصلي.
تعمل نماذج YOLO بسرعة على DGX Spark بفضل الشريحة الفائقة GB10 Grace Blackwell. ويوفر تنسيق TensorRT أفضل أداء للاستدلال. راجع قسم جدول المقارنة التفصيلي للاطلاع على نتائج قياس أداء YOLO11 على DGX Spark عبر أحجام النماذج والتنسيقات المختلفة، وقسم دقة YOLO26 باستخدام TensorRT على DGX Spark للاطلاع على نتائج YOLO26 باستخدام FP16 وINT8.
يوصى باستخدام TensorRT لنشر نماذج YOLO26 على DGX Spark، لأنه يوفر أسرع استدلال بين صيغ التصدير المدعومة، مستفيدًا من نوى Tensor في وحدة GPU من Blackwell بدقتي FP16 أو INT8.
يوفر DGX Spark أداءً للذكاء الاصطناعي يصل إلى 1 PFLOP وذاكرة موحدة بسعة 128 GB، مقارنةً بـ 2070 TFLOPS وذاكرة بسعة 128 GB في Jetson AGX Thor. صُمم DGX Spark بوصفه حاسوبًا فائقًا للذكاء الاصطناعي ومخصصًا لسطح المكتب، بينما أجهزة Jetson أنظمة مضمنة محسّنة للنشر على الأجهزة الطرفية.
لأعباء عمل PyTorch، تدعم
ultralytics/ultralytics:latest-nvidia-arm64جهاز DGX Spark مع DGX OS، وجهاز Thor مع JetPack 7.1. لا يدعم TensorRT 11.4 المضمّن JetPack، لذا يجب أن تستخدم مسارات عمل TensorRT على Jetson بيئة التشغيل TensorRT 10.x المدعومة لإصدار JetPack الخاص بها. راجع متطلبات Docker على Jetson.


التعليقات
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.