Caltech-256-Datensatz#
Der Caltech-256-Datensatz ist ein klassischer Benchmark für Bildklassifizierung mit 30.607 Bildern aus 256 Objektkategorien sowie einer Hintergrundklasse. Jede Kategorie enthält mindestens 80 Bilder realer Objekte – Tiere, Fahrzeuge, Haushaltsgegenstände und Menschen – und macht ihn zu einem größeren und anspruchsvolleren Nachfolger von Caltech-101 für Modelle zur Objekterkennung.
Erkunde Caltech-256 auf der Ultralytics Platform, um Beispiele in der Vorschau anzuzeigen, Datensatzstatistiken zu prüfen und den Datensatz für das Training zu klonen.
Caltech-256 wird ohne vordefinierte Aufteilung in Trainings- und Validierungsdaten bereitgestellt. Die folgenden Trainingsbefehle teilen den Datensatz automatisch im Verhältnis 80 % Training zu 20 % Validierung auf, sodass keine manuelle Vorbereitung erforderlich ist.
Wichtige Funktionen#
- Caltech-256 enthält 30.607 Farbbilder aus 256 Objektkategorien sowie einer
257.clutter-Hintergrundklasse (insgesamt 257 Klassenordner). - Die Kategorien umfassen eine große Vielfalt an Objekten aus der realen Welt, darunter Tiere, Fahrzeuge, Haushaltsgegenstände und Menschen.
- Jede Kategorie enthält mindestens 80 Bilder, wobei die größte Kategorie bis zu etwa 800 Bilder umfasst. Die Klassengrößen sind daher unausgewogen.
- Die Bilder haben unterschiedliche Größen und Auflösungen.
- Caltech-256 wird häufig zum Benchmarking von Algorithmen zur Bildklassifizierung und Objekterkennung verwendet.
Datensatzstruktur#
Caltech-256 wird als 257 Ordner bereitgestellt – einer pro Klasse, mit 256 Objektkategorien sowie einer 257.clutter-Hintergrundklasse – und ohne vordefinierte Aufteilung in Trainings- und Validierungsdaten. Wenn du das Training startest, teilt Ultralytics die Bilder automatisch auf, sodass Modelle ohne manuelle Einrichtung mit allen 257 Klassen trainiert werden:
- Klassen: 257 (256 Objektkategorien + 1 Hintergrundklasse)
- Bilder insgesamt: 30.607
- Aufteilung Training/Validierung: automatisch 80 % / 20 % (≈24.385 Training, ≈6.222 Validierung)
- Bilder pro Klasse: mindestens 80 (unausgewogen, bis zu etwa 800)
Anwendungen#
Der Caltech-256-Datensatz wird häufig zum Trainieren und Bewerten von Modellen für Bildklassifizierung und Objekterkennung verwendet, darunter Faltungsneuronale Netze (CNNs) und Support-Vector-Maschinen (SVMs). Die große Anzahl an Kategorien und die hochwertigen Bilder machen ihn zu einem beliebten Benchmark für die Forschung und Prototypentwicklung in den Bereichen maschinelles Lernen und Computer Vision.
Verwendung#
Trainiere ein YOLO-Modell 100 Epochen lang mit Caltech-256 bei einer Bildgröße von 416. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite Training und im Leitfaden zur Aufgabe Bildklassifizierung.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)
Beispielbilder und Annotationen#
Der Caltech-256-Datensatz enthält hochwertige Farbbilder verschiedener Objekte und stellt damit einen gut strukturierten Datensatz für Aufgaben der Bildklassifizierung bereit. Hier sind einige Beispiele aus dem Datensatz (Quelle):
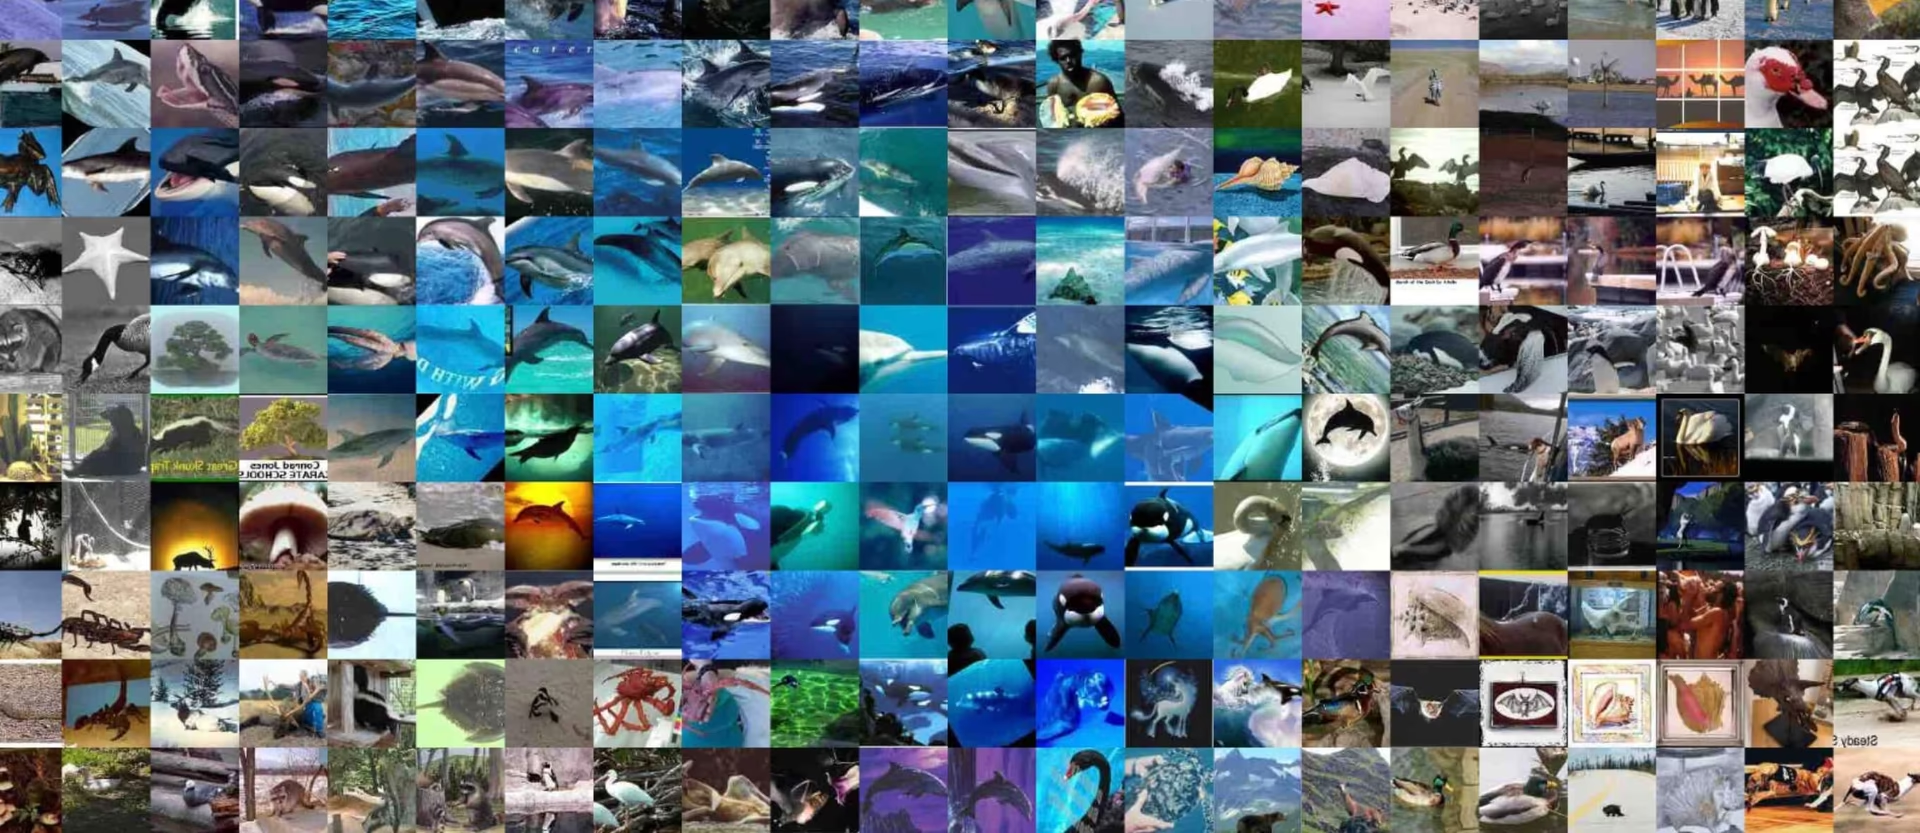
Die Beispiele zeigen die Vielfalt und Komplexität der Objekte im Caltech-256-Datensatz und verdeutlichen den Wert eines vielfältigen Datensatzes für das Training robuster Modelle zur Objekterkennung.
Zitate und Danksagungen#
Wenn du den Caltech-256-Datensatz in deiner Forschungs- oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Veröffentlichung:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Wir möchten Gregory Griffin, Alex Holub und Pietro Perona dafür danken, dass sie den Caltech-256-Datensatz erstellt und gepflegt haben und ihn damit der Forschungsgemeinschaft für maschinelles Lernen und Computer Vision als wertvolle Ressource zur Verfügung stellen. Weitere Informationen zum Caltech-256-Datensatz und seinen Erstellern findest du auf der Website des Caltech-256-Datensatzes.
FAQ#
Der Caltech-256-Datensatz wird häufig zum Trainieren und Benchmarking von Modellen für Bildklassifizierung und Objekterkennung verwendet. Er enthält 30.607 Bilder aus 256 Objektkategorien sowie einer Hintergrundklasse und stellt damit einen größeren und anspruchsvolleren Benchmark als Caltech-101 für Algorithmen wie faltende neuronale Netze (CNNs) und Support-Vector-Maschinen (SVMs) bereit.
Um ein Ultralytics-YOLO-Modell mit Caltech-256 zu trainieren, verwende die folgenden Codeausschnitte. Der Datensatz wird bei der ersten Verwendung automatisch heruntergeladen. Eine vollständige Liste der Argumente findest du auf der Seite Training des Modells.
Trainingsbeispielfrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 enthält 256 Objektkategorien sowie eine
257.clutter-Hintergrundklasse, also insgesamt 257 Klassenordner und 30.607 Bilder. Wenn du mit Ultralytics trainierst, lernt das Modell alle 257 Klassen. Jede Kategorie enthält mindestens 80 Bilder, die Klassengrößen sind jedoch unausgewogen und die größte Kategorie umfasst bis zu etwa 800 Bilder.Caltech-256 hat keine vordefinierte Aufteilung. Beim ersten Training teilt Ultralytics den Datensatz automatisch in 80 % Training und 20 % Validierung auf – etwa 24.385 Trainings- und 6.222 Validierungsbilder –, sodass du die Aufteilung nicht manuell erstellen musst. Wenn du die Aufteilung selbst steuern möchtest, ordne die Bilder vor dem Training in den Ordnern
train/undval/an.Ja. Mit der Ultralytics Platform kannst du Datensätze verwalten, Modelle für die Bildklassifizierung trainieren und sie ohne umfangreiche Programmierkenntnisse bereitstellen. Sie ist eine praktische Möglichkeit, Caltech-256-Experimente in der Cloud auszuführen. Weitere Optionen findest du in unserer Übersicht über Klassifizierungsdatensätze.