Signaturerkennungsdatensatz#
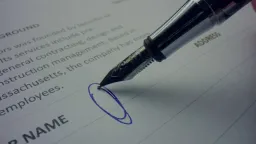
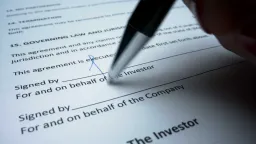
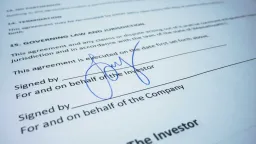
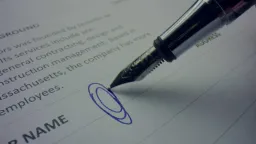
Der Ultralytics-Signaturerkennungsdatensatz ist ein Objekterkennungsdatensatz mit 178 Dokumentbildern, die mit einer einzigen Klasse signature annotiert sind. Er ist bereits in 143 Trainings- und 35 Validierungsbilder aufgeteilt. Der Datensatz wird beim ersten Training automatisch heruntergeladen (11,3 MB) und eignet sich als kompakter Einstieg in Bildverarbeitungsanwendungen wie Dokumentenprüfung, Betrugserkennung und digitale Dokumentenverarbeitung.
Datensatzstruktur#
Der Datensatz enthält 178 Bilder verschiedener Dokumenttypen mit handschriftlichen Signaturen, aufgeteilt in zwei Teilmengen:
| Aufteilung | Bilder | Beschreibung |
|---|---|---|
| Trainieren | 143 | Annotierte Bilder für das Modelltraining |
| Validierung | 35 | Zurückgehaltene Bilder für die Bewertung |
Jedes Bild enthält Bounding-Box-Annotationen für eine Klasse, signature, und die Konfiguration definiert keinen separaten Testsplit.
Der Signaturerkennungsdatensatz (11,3 MB) wird beim ersten Training automatisch aus den GitHub-Dateien von Ultralytics heruntergeladen. Ein manueller Download oder eine Vorbereitung ist daher nicht erforderlich.
Sieh dir Signature auf der Ultralytics Platform an, um die Bilder mit eingeblendeten Annotationen durchzugehen, die Klassenverteilung und Bounding-Box-Heatmaps im Tab Charts anzusehen und den Datensatz zu klonen, um dein eigenes Modell in der Cloud zu trainieren.
Anwendungsfälle#
Ein mit diesem Datensatz trainiertes Modell kann Signaturen in gescannten Dokumenten und Videos erkennen und verfolgen. Das unterstützt unter anderem:
- Dokumentenprüfung: Automatisierung der Signaturprüfung in Rechts- und Finanzdokumenten
- Betrugserkennung: Erkennung potenziell gefälschter oder nicht autorisierter Signaturen
- Digitale Dokumentenverarbeitung: Optimierung von Arbeitsabläufen in der Verwaltung und im Rechtswesen
- Bankwesen und Finanzen: Erhöhung der Sicherheit bei der Scheckbearbeitung und der Prüfung von Kreditunterlagen
- Archivforschung: Unterstützung der Analyse und Katalogisierung historischer Dokumente
- Bildung und Forschung: Untersuchung von Signaturmerkmalen verschiedener Dokumenttypen in Kursen zur Bildverarbeitung
YAML-Datei des Datensatzes#
Die Datei signature.yaml definiert die Datensatzkonfiguration – also die Datensatzpfade, Klassennamen und weitere Metadaten. Sie wird im Ultralytics-Repository unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/signature.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Signature dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/signature
# Example usage: yolo train data=signature.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── signature ← downloads here (11.3 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: signature # dataset root dir
train: images/train # train images (relative to 'path') 143 images
val: images/val # val images (relative to 'path') 35 images

# Classes
names:
  0: signature

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/signature.zipVerwendung#
Um ein YOLO26n-Modell mit dem Signaturerkennungsdatensatz 100 Epochen lang und mit einer Bildgröße von 640 zu trainieren, verwende die bereitgestellten Codebeispiele. Eine vollständige Liste der verfügbaren Parameter findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="signature.yaml", epochs=100, imgsz=640)
Nach dem Training kannst du mit dem feinabgestimmten Modell Dokumente oder Videos einer Inferenz unterziehen. Das folgende Beispiel führt mit einem Konfidenzschwellenwert von 0.75 eine Vorhersage für ein Beispielvideo aus:
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("path/to/best.pt")  # Ein feinabgestimmtes Modell zur Signaturerkennung laden

# Inferenz mit dem Modell
results = model.predict("https://ultralytics.com/assets/signature-s.mp4", conf=0.75)
Beispielbilder und Annotationen#
Der Datensatz deckt verschiedene Dokumentformate ab und hilft trainierten Modellen, auf Verträge, Formulare und Briefe zu generalisieren. Im Folgenden siehst du einen Trainingsbatch aus dem Datensatz:
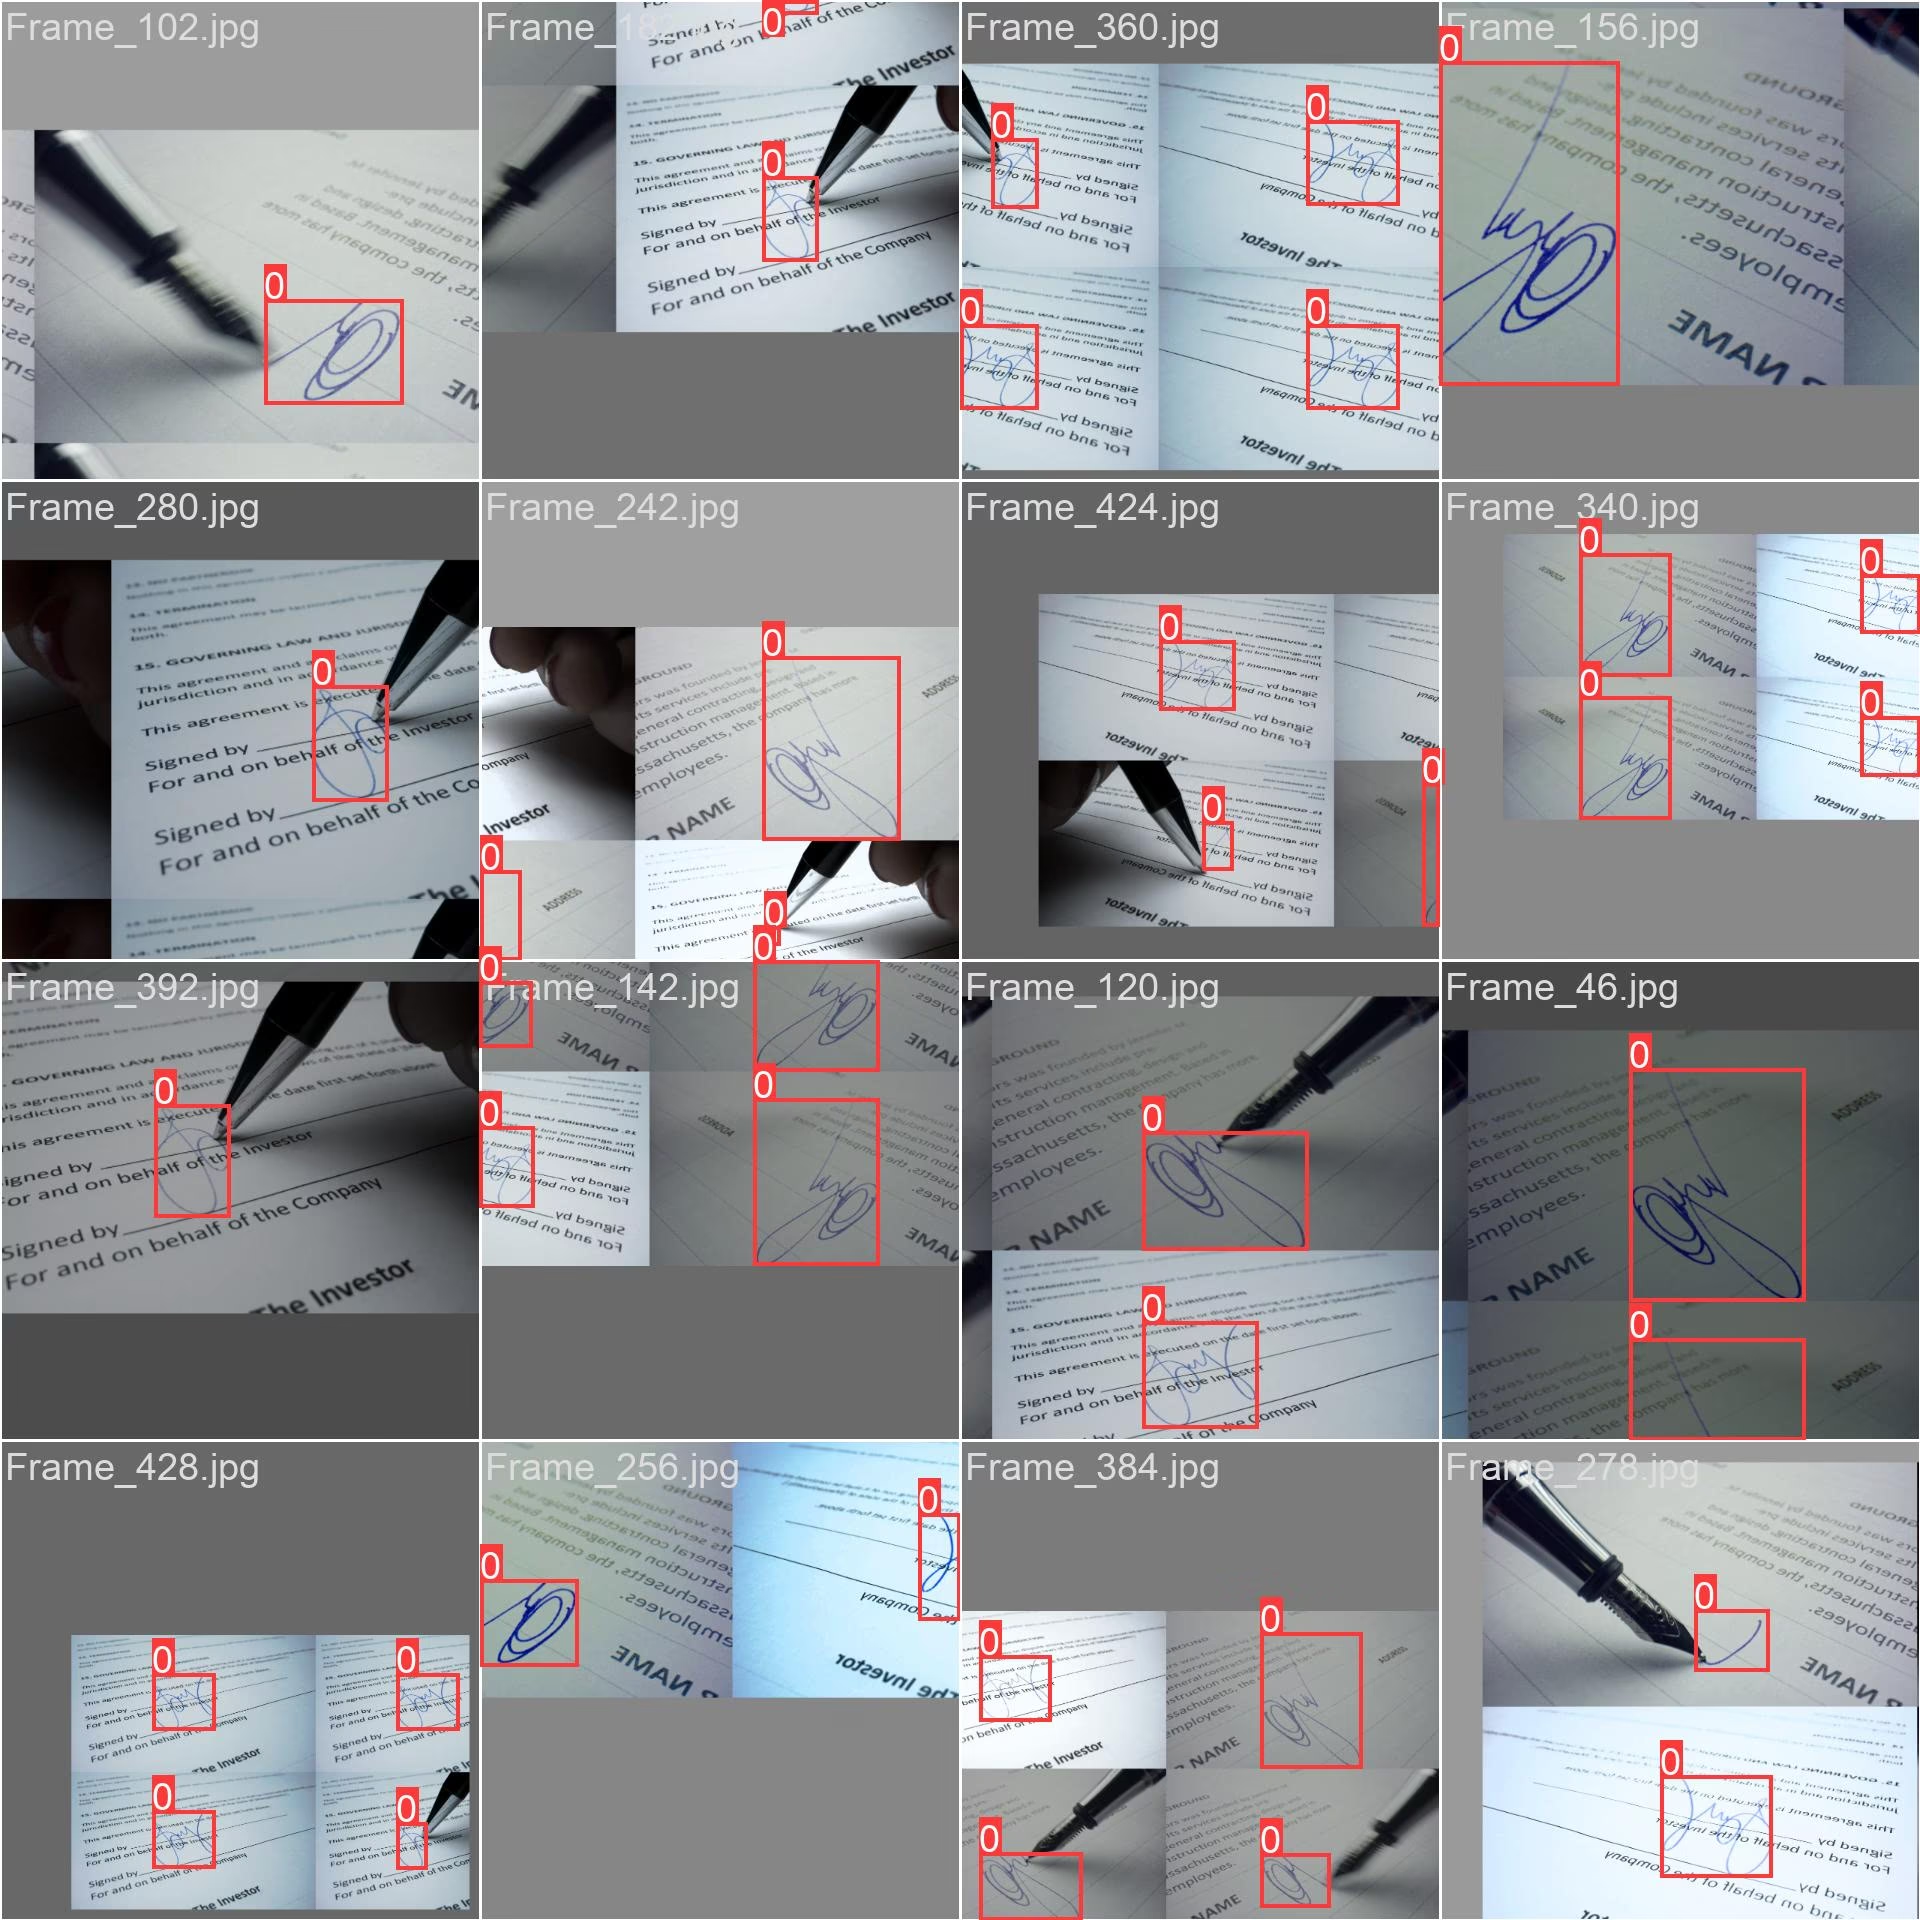
- Mosaikbild: Hier zeigen wir einen Trainingsbatch aus mosaikierten Datensatzbildern. Beim Mosaikverfahren, einer Trainingstechnik, werden mehrere Bilder zu einem zusammengefügt, wodurch die Vielfalt des Batches steigt. Diese Methode verbessert die Fähigkeit des Modells, über verschiedene Signaturgrößen, Seitenverhältnisse und Kontexte hinweg zu generalisieren.
Zitate und Danksagungen#
Der Datensatz wird unter der AGPL-3.0-Lizenz bereitgestellt.
Wenn du den Signature Detection Dataset für deine Forschungs- oder Entwicklungsarbeit verwendest, zitiere ihn bitte ordnungsgemäß:
@dataset{Ultralytics_Signature_Detection_Dataset_2024,
    author = {Ultralytics},
    title = {Signature Detection Dataset},
    year = {2024},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/signature}
}
Häufig gestellte Fragen#
Der Signature Detection Dataset umfasst 178 annotierte Dokumentbilder zum Trainieren von Modellen für die Erkennung handschriftlicher Signaturen. Er unterstützt die Dokumentenprüfung, Betrugserkennung und Archivforschung und bildet eine praktische Grundlage für die Entwicklung von Systemen zur intelligenten Dokumentenanalyse mit maschinellem Lernen.
Der Datensatz wird beim ersten Training mit
data="signature.yaml"automatisch (11.3 MB) aus den GitHub-Dateien von Ultralytics heruntergeladen – ein manueller Download ist nicht erforderlich. Weitere Datensätze findest du in der Übersicht der Erkennungsdatensätze.Der Signature Detection Dataset umfasst 143 Trainings- und 35 Validierungsbilder, insgesamt also 178 Bilder. Jedes ist mit einer einzigen Klasse annotiert:
signature. Es gibt keinen separaten Testsatz. Einzelheiten findest du im Abschnitt Datensatzstruktur und in der Konfigurationsignature.yaml.Du kannst ein YOLO26n-Modell 100 Epochen lang mit einer Bildgröße von 640 über Python oder die CLI trainieren:
Trainingsbeispielfrom ultralytics import YOLO # Vortrainiertes Modell laden model = YOLO("yolo26n.pt") # Das Modell trainieren results = model.train(data="signature.yaml", epochs=100, imgsz=640)Weitere Informationen findest du auf der Seite Training und unter Tipps zum Modelltraining.
Lade deine feinabgestimmten Gewichte und führe eine Vorhersage aus:
Inferenzbeispielfrom ultralytics import YOLO # Das feinabgestimmte Modell laden model = YOLO("path/to/best.pt") # Inferenz ausführen results = model.predict("https://ultralytics.com/assets/signature-s.mp4", conf=0.75)Der Datensatz steht unter der AGPL-3.0-Lizenz. Sie erlaubt die kommerzielle Nutzung, sofern abgeleitete Werke – einschließlich über ein Netzwerk angebotener Software – unter derselben Lizenz bereitgestellt werden. Lizenzoptionen ohne Open-Source-Auflagen findest du unter Ultralytics-Lizenzierung.