Dog-Pose-Datensatz
Einführung#
Der Ultralytics Dog-Pose-Datensatz ist ein Datensatz zur Posenschätzung, der für die Schätzung von Hunde-Keypoints zusammengestellt wurde und 6.773 Trainings- sowie 1.703 Validierungsbilder enthält.
Ansehen: So trainierst du ein Ultralytics-YOLO-Modell mit dem Stanford-Datensatz zur Posenschätzung von Hunden | Schritt-für-Schritt-Anleitung
Jedes annotierte Bild umfasst 24 Keypoints mit 3 Dimensionen pro Keypoint (x, y, Sichtbarkeit) und unterstützt so die Forschung und Anwendungen zur Schätzung von Hundeposen.
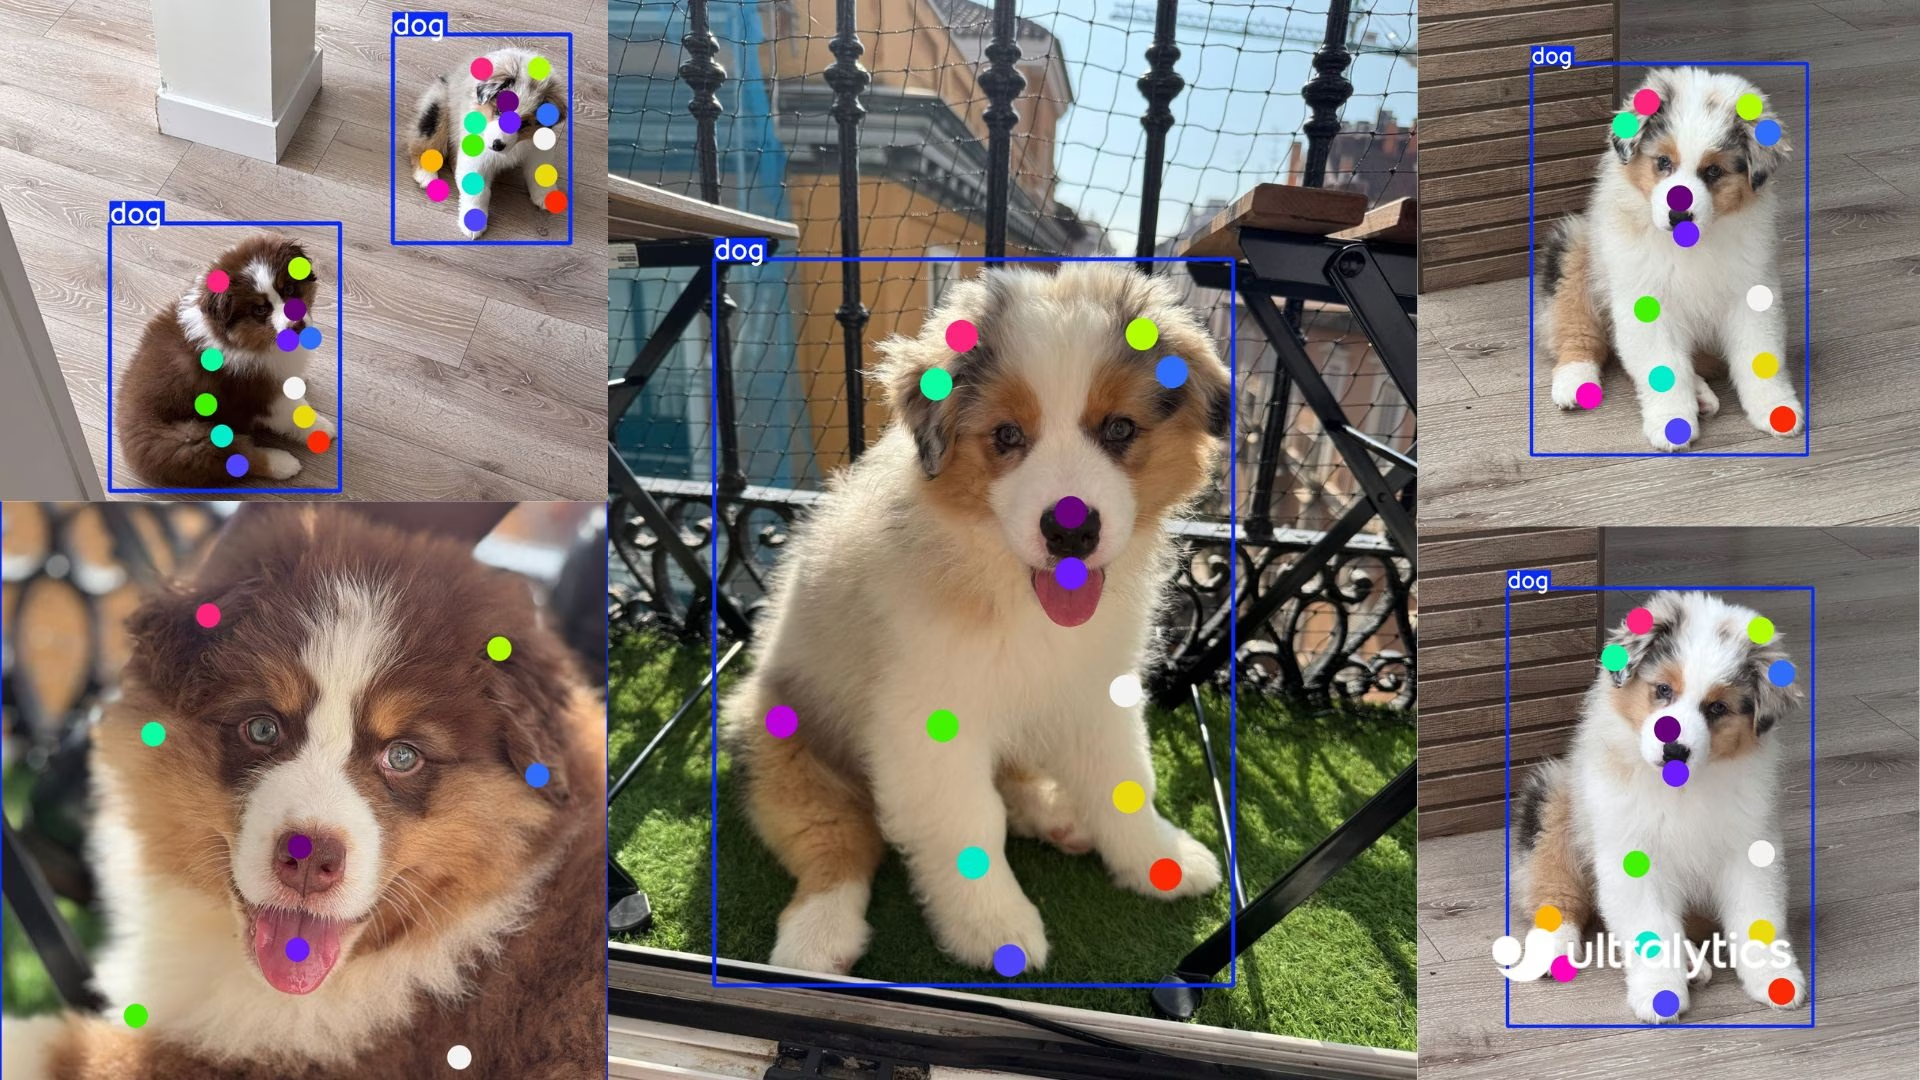
Für eine bestimmte Rasse oder eine ganz andere Tierart ermöglicht die Ultralytics Platform, ein eigenes Schlüsselpunktemodell mit deinen Daten hochzuladen, zu annotieren und zu trainieren, ohne dass du die Infrastruktur verwalten musst.
Datensatzstruktur#
-
Bilder insgesamt: 8.476 (6.773 train / 1.703 val) mit passenden Beschriftungsdateien im YOLO-Format.
-
Schlüsselpunkte: 24 pro Hund mit Tripeln aus
(x, y, visibility). -
Downloadgröße: ~337 MB.
-
Verzeichnisstruktur:
datasets/dog-pose/
├── images/{train,val}
└── labels/{train,val}
YAML-Datei des Datensatzes#
Eine YAML-Datei dient zum Festlegen der Datensatzkonfiguration. Sie enthält Pfade, Angaben zu den Schlüsselpunkten und weitere relevante Informationen. Für den Dog-Pose-Datensatz ist die Datei dog-pose.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml verfügbar.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Dogs dataset http://vision.stanford.edu/aditya86/ImageNetDogs/ by Stanford
# Documentation: https://docs.ultralytics.com/datasets/pose/dog-pose
# Example usage: yolo train data=dog-pose.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── dog-pose ← downloads here (337 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: dog-pose # dataset root dir
train: images/train # train images (relative to 'path') 6773 images
val: images/val # val images (relative to 'path') 1703 images

# Keypoints
kpt_shape: [24, 3] # number of keypoints, number of dims (2 for x,y or 3 for x,y,visible)

# Classes
names:
  0: dog

# Keypoint names per class
kpt_names:
  0:
    - front_left_paw
    - front_left_knee
    - front_left_elbow
    - rear_left_paw
    - rear_left_knee
    - rear_left_elbow
    - front_right_paw
    - front_right_knee
    - front_right_elbow
    - rear_right_paw
    - rear_right_knee
    - rear_right_elbow
    - tail_start
    - tail_end
    - left_ear_base
    - right_ear_base
    - nose
    - chin
    - left_ear_tip
    - right_ear_tip
    - left_eye
    - right_eye
    - withers
    - throat

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/dog-pose.zipVerwendung#
Um ein YOLO26n-pose-Modell für 100 Epochen mit einer Bildgröße von 640 auf dem Datensatz Dog-Pose zu trainieren, kannst du die folgenden Codebeispiele verwenden.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-pose.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="dog-pose.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Hier sind einige Beispielbilder aus dem Dog-Pose-Datensatz mit den zugehörigen Annotationen:
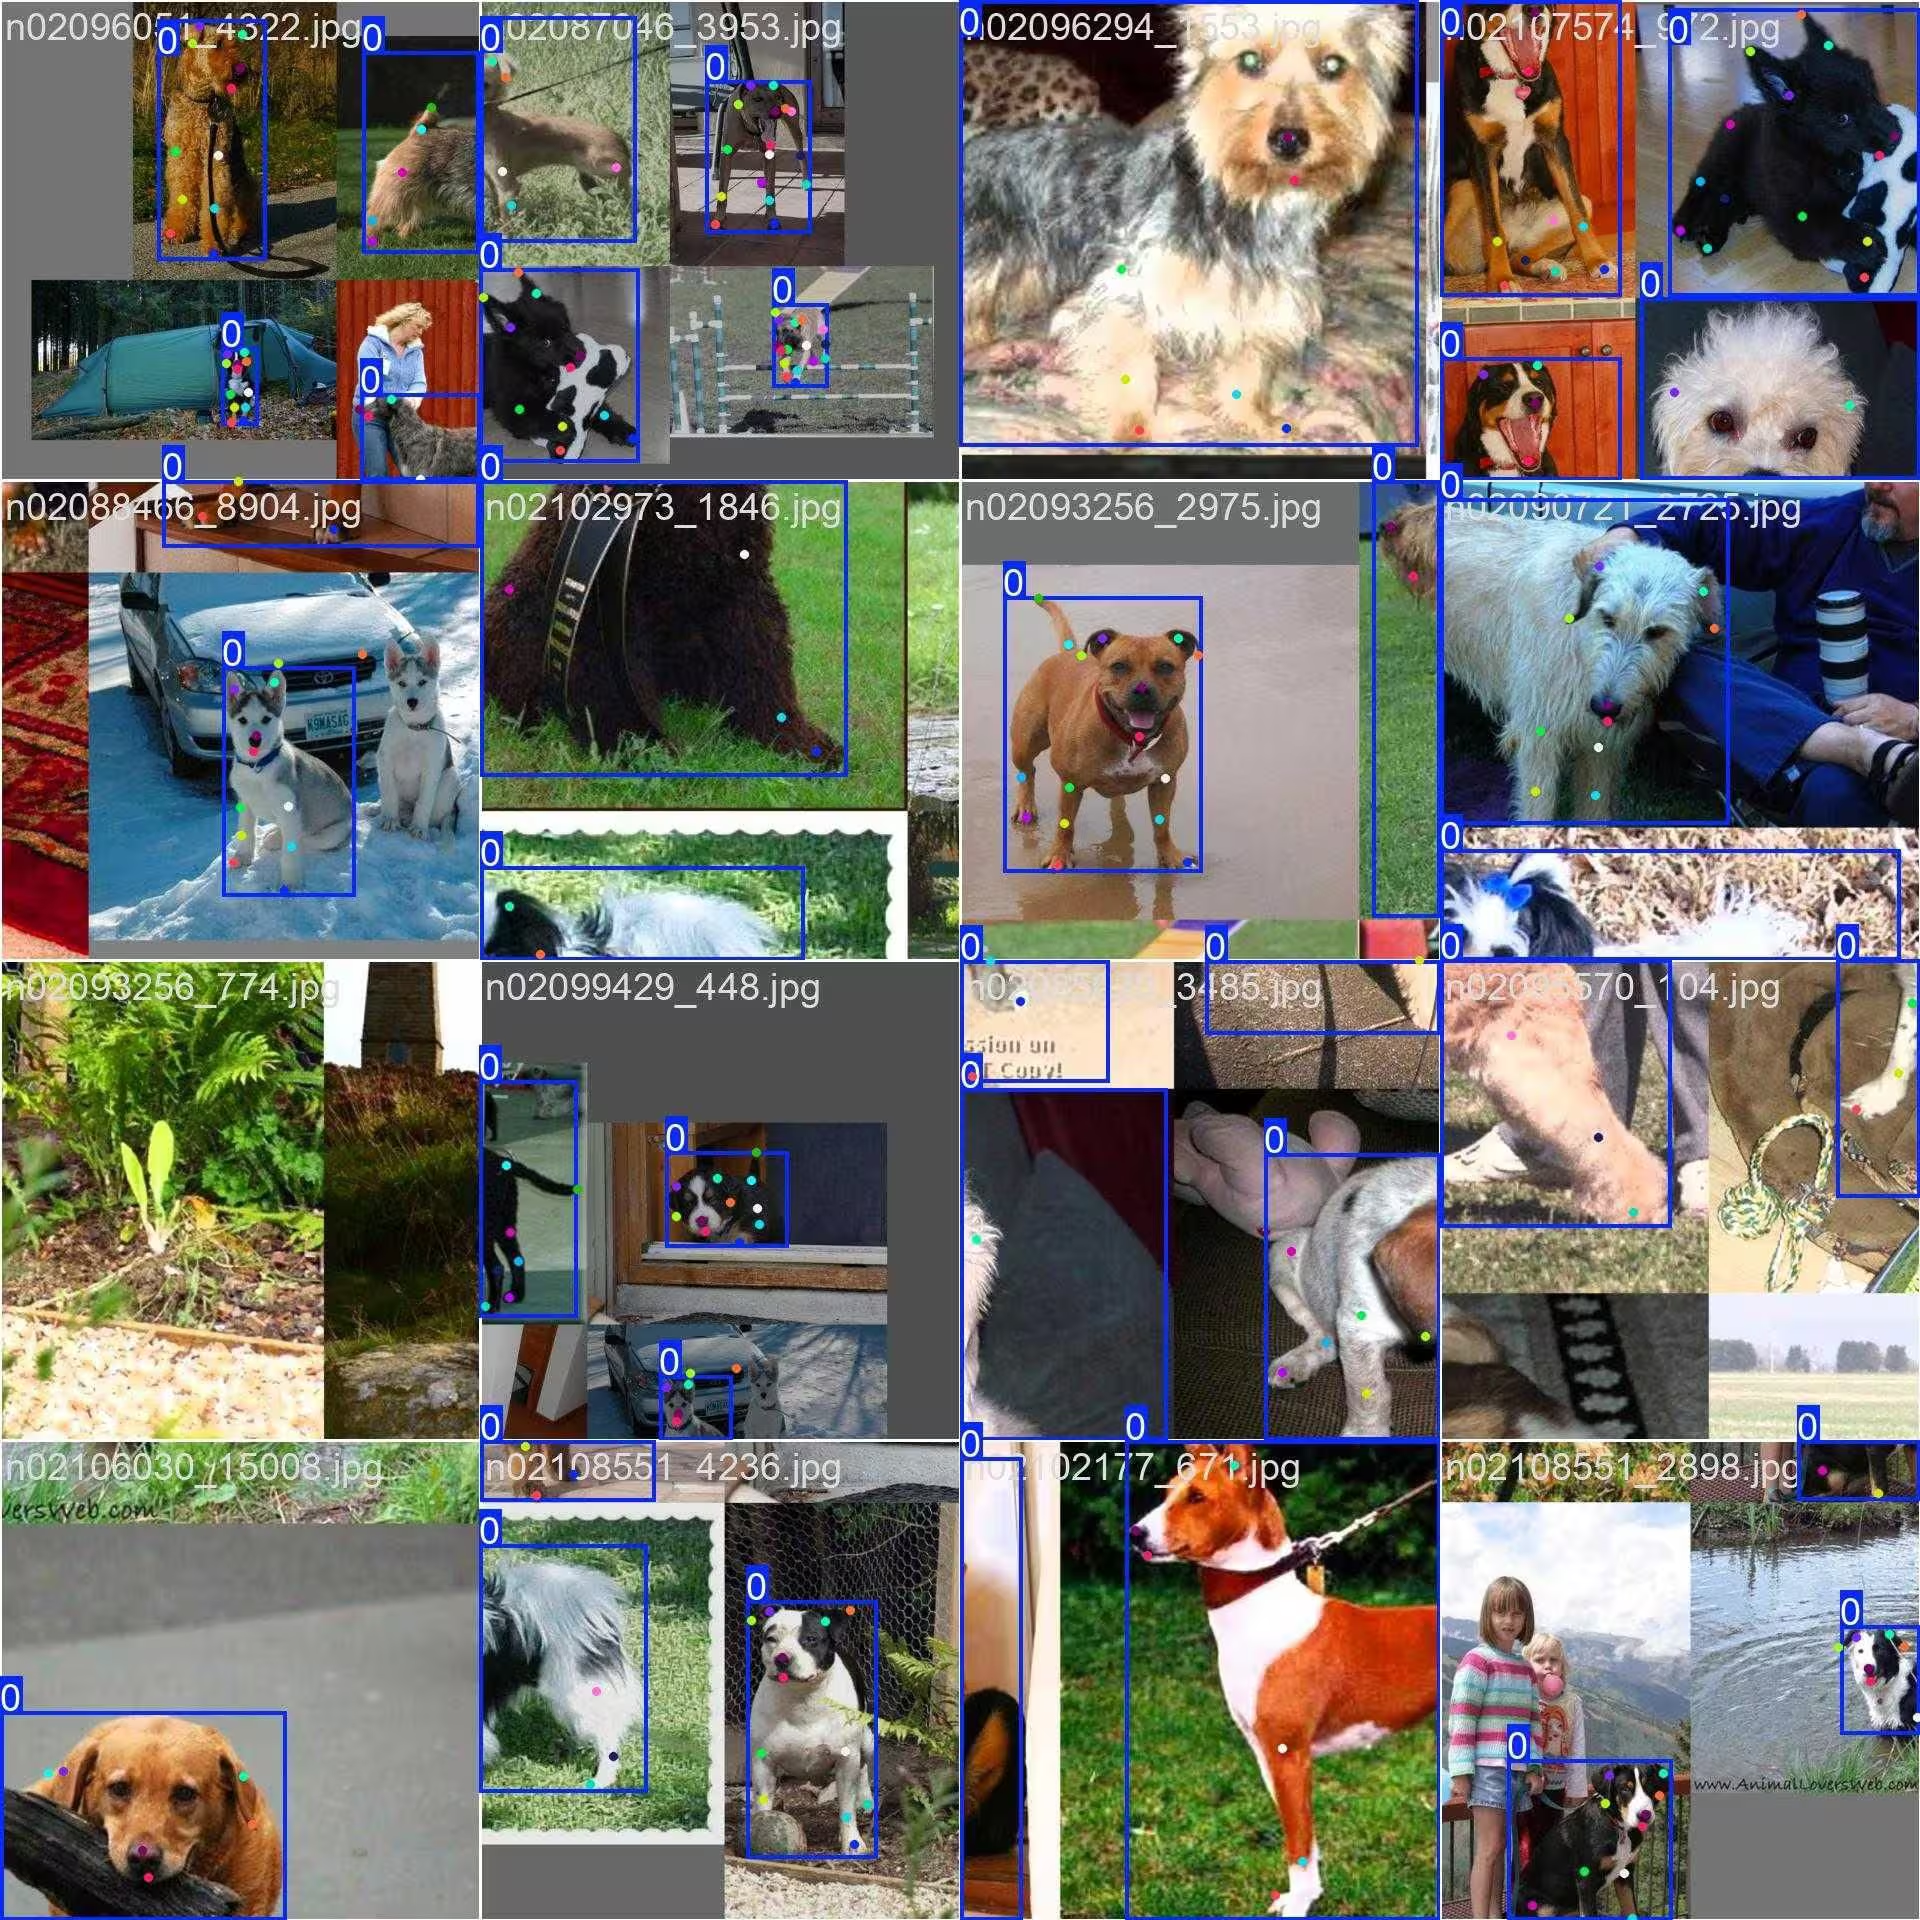
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig kombinierten Datensatzbildern. Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dadurch kann das Modell besser auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte generalisieren.
Das Beispiel veranschaulicht die Vielfalt und Komplexität der Bilder im Dog-Pose-Datensatz sowie die Vorteile des Mosaikverfahrens während des Trainings.
Zitate und Danksagungen#
Wenn du den Dog-Pose-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@inproceedings{khosla2011fgvc,
  title={Novel dataset for Fine-Grained Image Categorization},
  author={Aditya Khosla and Nityananda Jayadevaprakash and Bangpeng Yao and Li Fei-Fei},
  booktitle={First Workshop on Fine-Grained Visual Categorization (FGVC), IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
  year={2011}
}
@inproceedings{deng2009imagenet,
  title={ImageNet: A Large-Scale Hierarchical Image Database},
  author={Jia Deng and Wei Dong and Richard Socher and Li-Jia Li and Kai Li and Li Fei-Fei},
  booktitle={IEEE Computer Vision and Pattern Recognition (CVPR)},
  year={2009}
}
Wir möchten dem Stanford-Team dafür danken, dass es diese wertvolle Ressource für die Computer-Vision-Community geschaffen hat und pflegt. Weitere Informationen zum Dog-Pose-Datensatz und seinen Urhebern findest du auf der Website des Stanford Dogs Dataset.
Häufig gestellte Fragen#
Der Dog-Pose-Datensatz umfasst 6.773 Trainings- und 1.703 Validierungsbilder, die mit 24 Keypoints für die Schätzung von Hundeposen annotiert wurden. Er wurde zum Trainieren und Validieren von Modellen mit Ultralytics YOLO26 entwickelt und unterstützt Anwendungen wie die Analyse des Tierverhaltens, die Überwachung von Haustieren und veterinärmedizinische Studien. Dank der detaillierten Annotationen eignet er sich gut zur Entwicklung präziser Modelle für die Posenschätzung bei Hunden.
Lade
yolo26n-pose.ptund rufemodel.train(data="dog-pose.yaml", epochs=100, imgsz=640)auf – im obigen Trainingsbeispiel findest du die vollständigen Python- und CLI-Codeausschnitte. Eine umfassende Liste der Argumente enthält die Seite Training des Modells.Mit insgesamt 8.476 Bildern (6.773 Training / 1.703 Validierung), die eine große Bandbreite an Hunderassen und Posen abdecken, sowie 24 Keypoints in 3 Dimensionen (x, y, Sichtbarkeit) pro Annotation bietet der Datensatz Dog-Pose Modellen die Abdeckung realer Szenarien, die für Anwendungen wie die Überwachung von Haustieren und die Verhaltensanalyse erforderlich ist.
Beim Mosaikverfahren werden mehrere Dog-Pose-Bilder zu einem einzigen Trainingsbild zusammengefügt. Dadurch sieht das Modell bei jedem Schritt eine größere Vielfalt an Hundeposen, -größen und Hintergründen. Das verbessert die Generalisierung auf neue Kontexte und Maßstäbe und verringert zugleich Overfitting. Beispielbilder findest du im Abschnitt Beispielbilder und Annotationen.
Die YAML-Datei des Dog-Pose-Datensatzes findest du unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. Diese Datei legt die Datensatzkonfiguration fest, einschließlich Pfaden, Klassen, Angaben zu den Schlüsselpunkten und weiterer relevanter Informationen. Die YAML-Datei definiert 24 Schlüsselpunkte mit jeweils 3 Dimensionen und eignet sich damit für detaillierte Aufgaben zur Pose-Schätzung.
Um diese Datei mit YOLO26-Trainingsskripten zu verwenden, gib sie wie im Abschnitt Verwendung gezeigt in deinem Trainingsbefehl an. Der Datensatz wird bei der ersten Verwendung automatisch heruntergeladen, sodass die Einrichtung unkompliziert ist.
Weitere Informationen zu Schlüsselpunktemodellen findest du in der Dokumentation zur Aufgabe Pose-Schätzung.


Kommentare12
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
legend-zhen
Hello, although YOLOv11-pose can perform both object detection and pose estimation tasks simultaneously, there seems to be little correlation between the performance of pose estimation and object detection. What could be the reason for this? As I understand, YOLOv11-pose was specifically designed for human pose estimation, so can it also be perfectly adapted for animal pose estimation, as it is for humans? Are any special settings required when performing animal pose estimation?
 Glenn JocherUltralytics(bearbeitet)
@legend-zhen YOLO26 and YOLO11 pose models are indeed versatile and can be adapted for animal pose estimation, such as with the Dog-Pose dataset. While the architecture is optimized for human pose estimation, adapting it to animals typically requires a dataset with accurate annotations (e.g., 24 keypoints for dogs in Dog-Pose). No special settings are mandatory beyond ensuring the dataset YAML file is properly configured. For details on Dog-Pose, check here.
Peakednesss
I can just find 20 points, 4 for ears, 1 for nose, 1 for mouth, 2 for tail, and 12 for legs, where are the other four points?
- Glenn JocherUltralytics(bearbeitet)
@Peakednesss the Dog-Pose dataset has 24 keypoints. Beyond the 20 you found (ears, nose, chin, tail and legs), the other four are the left eye, right eye, withers and throat. The full list is in
kpt_namesin the dataset YAML: https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/dog-pose.yaml. thank you very much
goodbetterbest1
do you know where are the other 4 points’ definitions? I can’t find any useful information in the yaml document. thx
chengziNaomi
When we annotate the key point data set in a picture, if the two boxes have overlapping parts, how to annotate the key points in the overlapping boxes?
- Glenn JocherUltralytics
@chengziNaomi when annotating overlapping bounding boxes in a keypoint dataset, ensure that each object's keypoints are labeled independently, even if they share overlapping regions. Annotate each keypoint based on its respective object, maintaining clear separation to avoid ambiguity during model training. For guidelines on keypoint annotation, refer to Dog-Pose Dataset Documentation.
If I have multiple objects in a picture, should I frame all the objects at once and then label the key points together, or should I frame an object, label the key points of that object, then frame an object, and then label the key points of that object?
- Glenn JocherUltralytics
@chengziNaomi when annotating a single image with multiple objects, you should annotate each object separately. Frame one object, label its keypoints completely, then move to the next object. This ensures clarity and avoids confusion during model training. Refer to Dog-Pose Dataset Documentation for more annotation insights.
Thank you very much! and how can I draw heatmap for key point detection?
- Glenn JocherUltralytics
You're welcome! To draw a heatmap for keypoint detection, you can preprocess the keypoints into Gaussian blobs on a blank image using libraries like OpenCV or NumPy, then overlay them on the original image. For detailed implementation, check external heatmap solutions or visualization tools as it currently falls outside YOLO's built-in features. Let me know if you have further questions!