Bewährte Verfahren und Tipps zum maschinellen Lernen für das Modelltraining
Einführung#
Einer der wichtigsten Schritte bei der Arbeit an einem Computer-Vision-Projekt ist das Modelltraining. Bevor du diesen Schritt erreichst, musst du deine Ziele festlegen und deine Daten erfassen und annotieren. Nachdem du die Daten vorverarbeitet und sichergestellt hast, dass sie sauber und konsistent sind, kannst du mit dem Training deines Modells beginnen.
Beim Modelltraining lernt dein Modell, visuelle Muster zu erkennen und anhand deiner Daten Vorhersagen zu treffen. Dieser Prozess beeinflusst unmittelbar die Genauigkeit deiner Anwendung. Dieser Leitfaden behandelt bewährte Verfahren, Optimierungstechniken und Tipps zur Fehlerbehebung, damit du deine Computer-Vision-Modelle effektiv trainieren kannst.
Ansehen: Tipps zum Modelltraining | Umgang mit großen Datensätzen | Batch-Größe, GPU-Auslastung und gemischte Präzision
So trainierst du ein Machine-Learning-Modell#
Ein Computer-Vision-Modell wird trainiert, indem seine internen Parameter angepasst werden, um Fehler zu minimieren. Zunächst erhält das Modell eine große Menge annotierter Bilder. Es erstellt Vorhersagen darüber, was auf diesen Bildern zu sehen ist. Diese Vorhersagen werden mit den tatsächlichen Labels oder Inhalten verglichen, um Fehler zu berechnen. Die Fehler zeigen, wie stark die Vorhersagen des Modells von den tatsächlichen Werten abweichen.
Während des Trainings erstellt das Modell iterativ Vorhersagen, berechnet Fehler und aktualisiert seine Parameter in einem als Backpropagation bezeichneten Prozess. Dabei passt das Modell seine internen Parameter (Gewichte und Biases) an, um die Fehler zu verringern. Durch viele Wiederholungen dieses Zyklus verbessert sich die Genauigkeit des Modells schrittweise. Mit der Zeit lernt es, komplexe Muster wie Formen, Farben und Texturen zu erkennen.
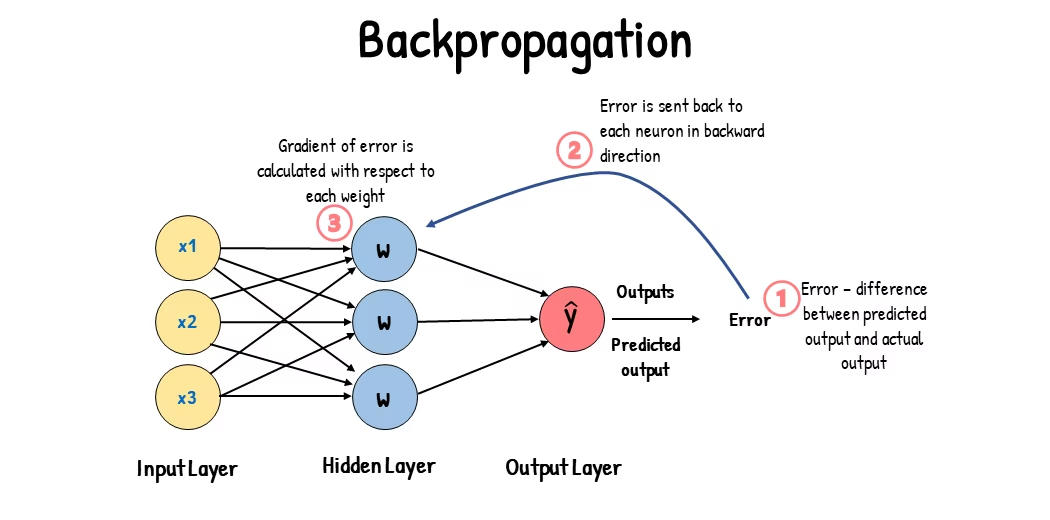
Durch diesen Lernprozess kann das Computer-Vision-Modell verschiedene Aufgaben ausführen, darunter Objekterkennung, Instanzsegmentierung, semantische Segmentierung und Bildklassifizierung. Das übergeordnete Ziel ist ein Modell, das sein Wissen auf neue, bisher unbekannte Bilder übertragen kann, um visuelle Daten in realen Anwendungen zuverlässig zu verstehen.
Nachdem wir nun wissen, was beim Training eines Modells im Hintergrund geschieht, sehen wir uns an, was beim Modelltraining zu beachten ist.
Training mit großen Datensätzen#
Wenn du ein Modell mit einem großen Dataset trainieren möchtest, solltest du mehrere Aspekte berücksichtigen. Du kannst zum Beispiel die Batchgröße anpassen, die GPU-Auslastung steuern oder Multiskalen-Training verwenden. Sehen wir uns diese Möglichkeiten im Detail an.
Batchgröße und GPU-Auslastung#
Beim Training von Modellen mit großen Datensätzen ist eine effiziente Nutzung deiner GPU entscheidend. Die Batchgröße ist dabei ein wichtiger Faktor. Sie gibt an, wie viele Datenbeispiele ein Machine-Learning-Modell in einem einzelnen Trainingsschritt verarbeitet. Wenn du die von deiner GPU unterstützte maximale Batchgröße verwendest, kannst du ihre Fähigkeiten voll ausschöpfen und die Trainingszeit verkürzen. Achte jedoch darauf, dass der GPU-Speicher nicht ausgeht. Falls Speicherfehler auftreten, verringere die Batchgröße schrittweise, bis das Modell reibungslos trainiert.
Ansehen: So beschleunigst du die Inferenz mit Ultralytics YOLO26 durch Batchverarbeitung um das 2-Fache | Python & GPU | MLOps 🚀
Im Hinblick auf YOLO26 kannst du den Parameter batch in den Argumenten für den Trainingsmodus festlegen, damit er zur Kapazität deiner GPU passt. Auf einem einzelnen Beschleuniger erstellt batch=-1 ein Profil des Modells und wählt eine Batchgröße aus, die auf eine Speicherauslastung von etwa 60 % abzielt; ein Anteil wie batch=0.70 zielt auf eine andere Auslastung ab. Läufe mit mehreren GPUs erfordern eine explizite globale Batchgröße, die mindestens der Anzahl der Geräte entspricht. Auf CPU und Apple silicon warnt AutoBatch und weicht auf batch=16 aus.
Training mit einer Teilmenge#
Das Training mit einer Teilmenge ist eine praktische Strategie, bei der dein Modell mit einer kleineren Datenmenge trainiert wird, die den größeren Datensatz repräsentiert. Das kann Zeit und Ressourcen sparen, besonders in der frühen Entwicklungs- und Testphase eines Modells. Wenn du wenig Zeit hast oder verschiedene Modellkonfigurationen ausprobierst, ist das Training mit einer Teilmenge eine gute Option.
Bei YOLO26 kannst du mit dem Parameter fraction mit Teilmengen trainieren. Verwende ein Verhältnis wie fraction=0.1 für 10 % der Trainingsdaten, eine ganze Zahl wie fraction=300 für genau 300 Trainingsbilder oder eine Liste wie [train, val, test] mit fraction=[300, 100, 0], um jede Aufteilung zu begrenzen und Testbilder auszulassen. Zweielementige Listen wie [300, 100] lassen die Testaufteilung unverändert. NDJSON-Datensätze wählen vor dem Herunterladen gleichmäßig verteilte Einträge aus, sodass bei wiederholten Durchläufen dieselbe Teilmenge verwendet wird. Klassifizierungsdatensätze mit Bildern in Ordnern wählen ebenfalls gleichmäßig verteilte Stichproben aus. Bei anderen Datensätzen mit Bildern in Ordnern wählt fraction die ersten N Bilder in der sortierten Reihenfolge der Bildpfade aus und keine zufällige Stichprobe. Stelle daher Teilmengen manuell zusammen, wenn die Reihenfolge dazu führen könnte, dass Quellen oder Klassen ausgeschlossen werden. Achte bei der Aufteilung in Trainings- und Validierungsdaten darauf, Gruppen nahezu identischer Bilder vollständig derselben Aufteilung zuzuweisen.
Multiskalen-Training#
Multiskalen-Training verbessert die Generalisierungsfähigkeit deines Modells, indem es mit Bildern unterschiedlicher Größe trainiert wird. So lernt dein Modell, Objekte in verschiedenen Größen und Entfernungen zu erkennen, und wird robuster.
Beim Training von YOLO26 kannst du die Maßstabsaugmentierung aktivieren, indem du den Parameter scale festlegst. Dieser Parameter passt die Größe der Trainingsbilder um einen angegebenen Faktor an und simuliert so Objekte in unterschiedlichen Entfernungen. Mit der Einstellung scale=0.5 werden Trainingsbilder beispielsweise während des Trainings zufällig um einen Faktor zwischen 0,5 und 1,5 vergrößert oder verkleinert. Durch die Konfiguration dieses Parameters sieht dein Modell verschiedene Bildmaßstäbe und kann Objekte unterschiedlicher Größe und in verschiedenen Szenarien besser erkennen.
Ultralytics unterstützt außerdem Multiskalen-Training mit unterschiedlichen Bildgrößen über den Parameter multi_scale. Anders als scale, das Bilder vergrößert oder verkleinert und anschließend wieder auf imgsz auffüllt oder zuschneidet, ändert multi_scale in jedem Batch imgsz selbst (gerundet auf den Modell-Stride). Bei imgsz=640 und multi_scale=0.25 wird die Trainingsgröße beispielsweise in Stride-Schritten von 480 bis 800 gezogen (z. B. 480, 512, 544, ..., 800), während multi_scale=0.0 eine feste Größe beibehält.
Caching#
Caching ist eine wichtige Technik, um das Training von Machine-Learning-Modellen effizienter zu machen. Durch das Speichern vorverarbeiteter Bilder im Arbeitsspeicher muss die GPU weniger darauf warten, dass Daten von der Festplatte geladen werden. Das Modell kann so kontinuierlich Daten erhalten, ohne dass Verzögerungen durch Festplatten-E/A entstehen.
Beim Training von YOLO26 lässt sich das Caching über den Parameter cache steuern:
cache=True: Speichert Dataset-Bilder im RAM. Das ermöglicht den schnellsten Zugriff, erhöht jedoch den Speicherbedarf.cache='disk': Speichert die Bilder auf der Festplatte. Das ist langsamer als RAM, aber schneller, als die Daten jedes Mal neu zu laden.cache=False: Deaktiviert das Caching. Die Daten werden vollständig über Festplatten-E/A geladen, was die langsamste Option ist.
Training mit gemischter Genauigkeit#
Beim Training mit gemischter Präzision kommen sowohl Gleitkommatypen mit 16 Bit (FP16) als auch mit 32 Bit (FP32) zum Einsatz: FP16 für schnellere Berechnungen und FP32, um bei Bedarf die Präzision zu erhalten. Die meisten Operationen des neuronalen Netzes werden in FP16 ausgeführt, um von den schnelleren Berechnungen und dem geringeren Speicherbedarf zu profitieren. Eine Kopie der Modellgewichte wird jedoch in FP32 beibehalten, um die Genauigkeit bei der Aktualisierung der Gewichte sicherzustellen. So kannst du größere Modelle oder größere Batch-Größen innerhalb derselben Hardwaregrenzen verarbeiten.
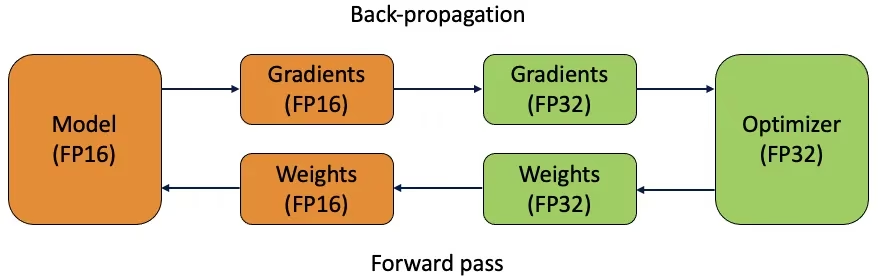
Für das Training mit gemischter Genauigkeit musst du deine Trainingsskripte anpassen und sicherstellen, dass deine Hardware (z. B. GPUs) diese Funktion unterstützt. Viele moderne Frameworks für Deep Learning, darunter PyTorch und TensorFlow, bieten integrierte Unterstützung für gemischte Genauigkeit.
Das Training mit gemischter Präzision ist bei YOLO26 unkompliziert: AMP ist standardmäßig aktiviert (amp=True). Auf einer CUDA-GPU führt YOLO zu Beginn des Trainings einmalig eine Kompatibilitätsprüfung durch und verwendet bei einem Fehlschlag stattdessen ausschließlich FP32. Auf CPU und Apple Silicon wird AMP vollständig übersprungen. Setze amp=False, um FP32 zu erzwingen, oder amp="bf16", um auf unterstützten GPUs mit bfloat16 zu trainieren.
Vortrainierte Gewichte#
Die Verwendung vortrainierter Gewichte ist eine effektive Möglichkeit, den Trainingsprozess deines Modells zu beschleunigen. Vortrainierte Gewichte stammen von Modellen, die bereits mit großen Datensätzen trainiert wurden, und verschaffen deinem Modell einen Vorsprung. Transferlernen passt vortrainierte Modelle an neue, verwandte Aufgaben an. Beim Fine-Tuning eines vortrainierten Modells beginnst du mit diesen Gewichten und setzt das Training mit deinem spezifischen Datensatz fort. Dadurch verkürzt sich die Trainingszeit, und oft verbessert sich auch die Leistung, da das Modell bereits ein solides Verständnis grundlegender Merkmale mitbringt.
Vortrainierte Gewichte werden über das Argument model geladen, sodass model=yolo26n.pt bereits mit COCO-Gewichten startet. Der Parameter pretrained legt fest, ob diese Gewichte beibehalten (True, Standard), verworfen (False) oder durch einen anderen Prüfpunkt ersetzt werden (pretrained=path/to/best.pt). Wenn du pretrained=True für ein *.yaml-Modell setzt, werden dadurch nicht automatisch Gewichte abgerufen. Den vollständigen Transfer-Learning-Workflow findest du unter YOLO mit einem benutzerdefinierten Dataset feinabstimmen.
Weitere Techniken für große Datensätze#
Für den Umgang mit großen Datensätzen solltest du noch einige weitere Techniken in Betracht ziehen:
- Lernraten-Scheduler: Lernraten-Scheduler passen die Lernrate während des Trainings dynamisch an. Eine gut abgestimmte Lernrate kann verhindern, dass das Modell Minima überschreitet, und die Stabilität verbessern. Beim Training von YOLO26 hilft der Parameter
lrfbei der Steuerung des Lernraten-Schedulers, indem er die endgültige Lernrate als Anteil der anfänglichen Lernrate festlegt. Für Verhaltensweisen, die sich nicht über ein Argument einstellen lassen, etwa Lernraten pro Ebene oder Gradienten-Clipping, leite den Trainer ab. - Verteiltes Training: Bei großen Datensätzen verkürzt verteiltes Training die Trainingszeit, indem die Arbeitslast auf mehrere GPUs oder Rechner verteilt wird. Dieser Ansatz ist besonders bei Projekten im Unternehmensmaßstab mit umfangreichen Rechenressourcen wertvoll.
- Speicherformat channels_last: Beim Training mit NVIDIA CUDA wird unter PyTorch 1.11 und neuer automatisch das schnellere Speicherlayout NHWC verwendet, außer unter Windows, wo es sich in Messungen als langsamer erwiesen hat. Beim Training mit AMD ROCm bleibt das Format bei NCHW, das sich dort in Messungen als schneller erwiesen hat. Setze
channels_last=True, um es zu erzwingen, oderchannels_last=False, um NCHW beizubehalten; mit PyTorch 1.10 und älter sowie auf CPU und MPS gilt standardmäßig weiterhin NCHW.
Die Anzahl der Trainingsepochen#
Beim Modelltraining bezeichnet eine Epoche einen vollständigen Durchlauf durch den gesamten Trainingsdatensatz. Während einer Epoche verarbeitet das Modell jedes Beispiel im Trainingsbestand einmal und aktualisiert seine Parameter entsprechend dem Lernalgorithmus. In der Regel sind mehrere Epochen nötig, damit das Modell seine Parameter im Laufe der Zeit erlernen und verfeinern kann.
Eine häufige Frage lautet, wie viele Epochen für das Modelltraining angesetzt werden sollten. Ein guter Ausgangspunkt sind 300 Epochen. Wenn das Modell früh überlernt, kannst du die Epochenzahl reduzieren. Tritt nach 300 Epochen kein Overfitting auf, kannst du das Training auf 600, 1200 oder mehr Epochen verlängern.
Die ideale Epochenzahl hängt jedoch von der Größe deines Datasets und den Zielen deines Projekts ab. Bei größeren Datensätzen sind möglicherweise mehr Epochen nötig, damit das Modell effektiv lernt. Kleinere Datensätze erfordern unter Umständen weniger Epochen, um Overfitting zu vermeiden. Bei YOLO26 kannst du den Parameter epochs in deinem Trainingsskript setzen.
Vorzeitiger Trainingsabbruch#
Ein vorzeitiger Trainingsabbruch ist eine nützliche Technik zur Optimierung des Modelltrainings. Wenn du die Validierungsleistung überwachst, kannst du das Training beenden, sobald sich das Modell nicht mehr verbessert. So sparst du Rechenressourcen und verhinderst Overfitting.
Dazu legst du einen Geduldsparameter fest, der bestimmt, wie viele Epochen auf eine Verbesserung der Validierungsmetriken gewartet wird, bevor das Training abgebrochen wird. Verbessert sich die Leistung des Modells innerhalb dieser Epochen nicht, wird das Training beendet, um Zeit und Ressourcen zu sparen.
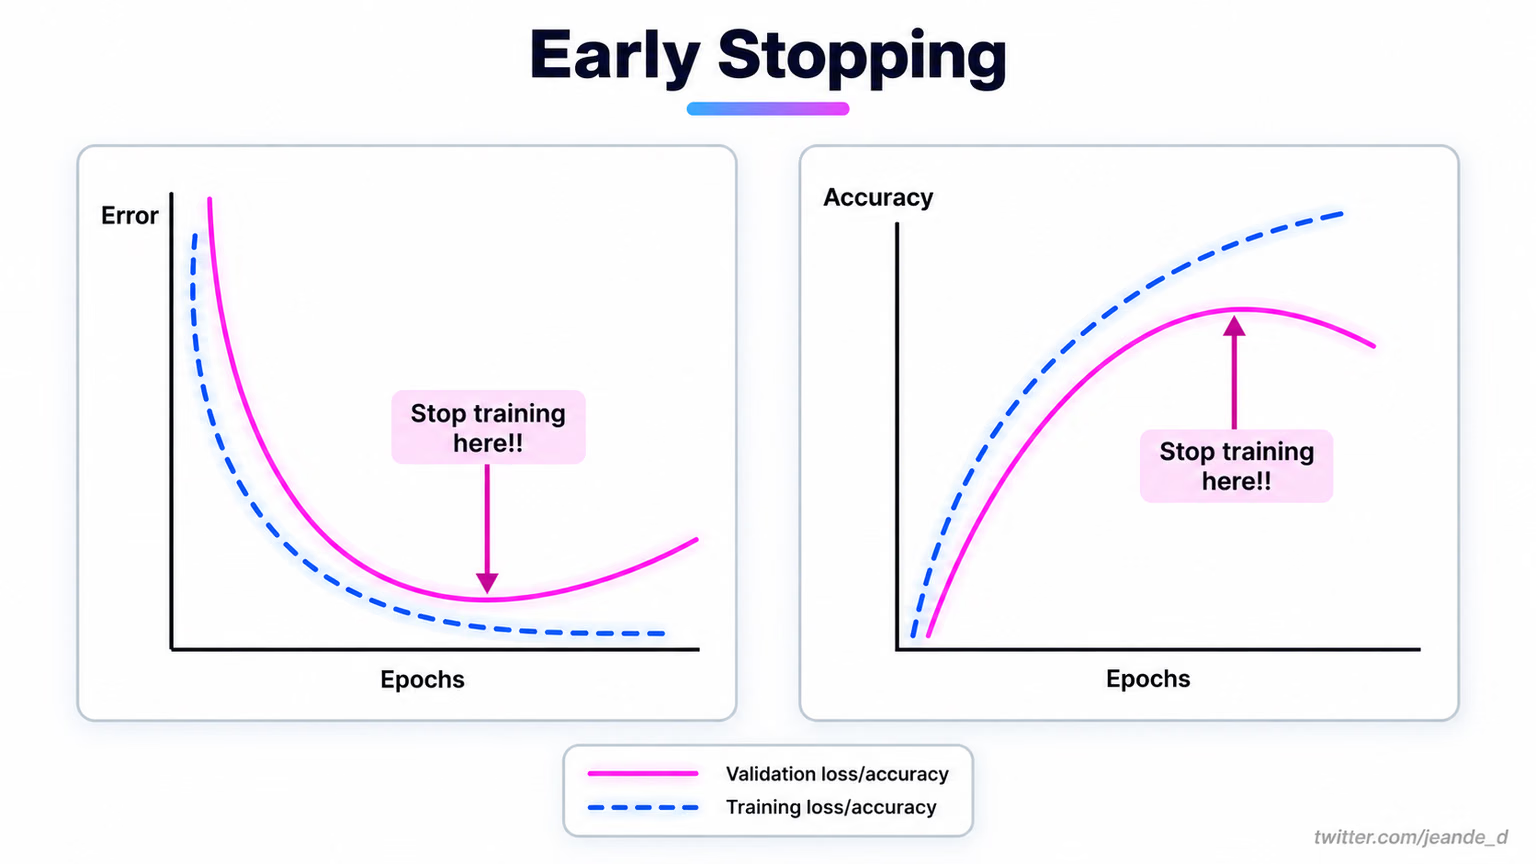
Für YOLO26 kannst du den vorzeitigen Trainingsabbruch aktivieren, indem du in deiner Trainingskonfiguration den Parameter patience festlegst. Zum Beispiel bedeutet patience=5, dass das Training beendet wird, wenn sich die Validierungsmetriken 5 Epochen in Folge nicht verbessern. So bleibt das Training effizient und unnötige Berechnungen werden vermieden.
Cloud-Training oder lokales Training auswählen#
Für das Training deines Modells gibt es zwei Möglichkeiten: Cloud-Training und lokales Training.
Cloud-Training bietet Skalierbarkeit und leistungsstarke Hardware und eignet sich ideal für große Datensätze und komplexe Modelle. Plattformen wie Google Cloud, AWS und Azure stellen leistungsstarke GPUs und TPUs bei Bedarf bereit. Dadurch verkürzen sich die Trainingszeiten und Experimente mit größeren Modellen werden möglich. Auch die Ultralytics Platform bietet verwaltetes Cloud-Training für YOLO-Modelle. Cloud-Training kann jedoch teuer sein, insbesondere bei längerer Nutzung. Auch die Datenübertragung kann zusätzliche Kosten und Verzögerungen verursachen.
Lokales Training bietet mehr Kontrolle und Anpassungsmöglichkeiten. So kannst du deine Umgebung auf bestimmte Anforderungen zuschneiden und laufende Cloud-Kosten vermeiden. Bei langfristigen Projekten kann es kostengünstiger sein. Da deine Daten vor Ort bleiben, ist es zudem sicherer. Die lokale Hardware kann jedoch Ressourcenbeschränkungen unterliegen und Wartung erfordern, was bei großen Modellen zu längeren Trainingszeiten führen kann.
Einen Optimierer auswählen#
Ein Optimierer ist ein Algorithmus, der die Gewichte deines neuronalen Netzwerks anpasst, um die Verlustfunktion zu minimieren, die misst, wie gut das Modell arbeitet. Einfach gesagt hilft der Optimierer dem Modell beim Lernen, indem er seine Parameter anpasst, um Fehler zu reduzieren. Die Wahl des richtigen Optimierers wirkt sich direkt darauf aus, wie schnell und genau das Modell lernt.
Du kannst auch die Optimiererparameter feinabstimmen, um die Modellleistung zu verbessern. Mit der Lernrate legst du die Schrittgröße beim Aktualisieren der Parameter fest. Für mehr Stabilität kannst du zunächst eine moderate Lernrate verwenden und sie mit der Zeit schrittweise senken, um das langfristige Lernen zu verbessern. Außerdem bestimmt der Momentum-Wert, wie stark sich frühere Aktualisierungen auf die aktuellen auswirken. Ein üblicher Momentum-Wert liegt bei etwa 0,9. Damit wird in der Regel eine gute Balance erreicht.
Gängige Optimierer#
Verschiedene Optimierer haben unterschiedliche Stärken und Schwächen. Hier sind einige gängige Optimierer.
-
SGD (stochastischer Gradientenabstieg):
- Aktualisiert Modellparameter anhand des Gradienten der Verlustfunktion bezüglich dieser Parameter.
- Einfach und effizient, aber die Konvergenz kann langsam sein, und der Optimierer kann in lokalen Minima stecken bleiben.
-
Adam (adaptive Momentenschätzung):
- Vereint die Vorteile von SGD mit Momentum und RMSProp.
- Passt die Lernrate für jeden Parameter anhand von Schätzungen des ersten und zweiten Moments der Gradienten an.
- Gut geeignet für verrauschte Daten und dünn besetzte Gradienten.
- Effizient und erfordert in der Regel weniger Abstimmung. Für kürzere Trainingsläufe wählt
optimizer=autovon YOLO26 das eng verwandte AdamW statt Adam selbst aus.
-
RMSProp (Fortpflanzung des quadratischen Mittelwerts):
- Passt die Lernrate für jeden Parameter an, indem der Gradient durch einen gleitenden Durchschnitt der Beträge der letzten Gradienten geteilt wird.
- Hilft bei der Bewältigung des Problems verschwindender Gradienten und eignet sich gut für rekurrente neuronale Netzwerke.
-
MuSGD (Muon- und SGD-Hybrid):
- Kombiniert Aktualisierungen im Stil von SGD mit von Muon inspiriertem Verhalten, um die Stabilität beim Training in großem Maßstab zu verbessern.
- Eine gute Wahl, wenn du eine Verallgemeinerungsfähigkeit wie bei SGD möchtest, aber eine gleichmäßigere Konvergenz als bei einfachem SGD benötigst.
- Besonders relevant für YOLO26-Trainingsrezepte; wenn du unsicher bist, beginne mit
optimizer=autound vergleiche MuSGD anhand deines Datensatzes.
Für YOLO26 kannst du mit dem Parameter optimizer aus verschiedenen Optimierern auswählen, darunter SGD, MuSGD, Adam, Adamax, AdamW, NAdam, RAdam und RMSProp. Du kannst den Parameter auch auf auto setzen, um je nach Anzahl der Trainingsiterationen automatisch einen Optimierer auszuwählen (AdamW bei kürzeren Trainingsläufen, MuSGD bei mehr als 10.000 Iterationen).
yolo train model=yolo26n.pt data=coco8.yaml optimizer=MuSGDMit der Community in Kontakt treten#
Als Teil einer Community von Computer-Vision-Begeisterten kannst du Probleme lösen und schneller lernen. Hier sind einige Möglichkeiten, Kontakte zu knüpfen, Hilfe zu erhalten und Ideen auszutauschen.
Ressourcen aus der Community#
- GitHub-Issues: Besuche das YOLO26-GitHub-Repository und nutze den Tab „Issues“, um Fragen zu stellen, Fehler zu melden und neue Funktionen vorzuschlagen. Die Community und die Maintainer sind sehr aktiv und helfen dir gerne.
- Ultralytics-Discord-Server: Tritt dem Ultralytics-Discord-Server bei, um dich mit anderen Nutzern und Entwicklern auszutauschen, Unterstützung zu erhalten und deine Erfahrungen zu teilen.
Mit diesen Ressourcen kannst du Herausforderungen bewältigen und dich über die neuesten Trends und bewährten Verfahren in der Computer-Vision-Community auf dem Laufenden halten.
Wichtigste Erkenntnisse#
Beim Training von Computer-Vision-Modellen solltest du bewährte Verfahren befolgen, deine Strategien optimieren und auftretende Probleme lösen. Techniken wie die Anpassung der Batch-Größen, das Training mit gemischter Präzision und der Einsatz vortrainierter Gewichte können die Leistung deiner Modelle verbessern und das Training beschleunigen. Mit Verfahren wie dem Training mit einer Teilmenge und Early Stopping sparst du Zeit und Ressourcen. Bleib mit der Community in Kontakt und verfolge neue Trends, um deine Fähigkeiten im Modelltraining kontinuierlich auszubauen.
Häufig gestellte Fragen#
Um die GPU-Auslastung zu verbessern, lege den Parameter
batchauf die maximale Größe fest, die deine GPU unterstützt. Auf einem einzelnen Beschleuniger erstelltbatch=-1ein Profil des Modells und zielt auf eine Speicherauslastung von etwa 60 % ab. Auf CPU und Apple silicon weicht es aufbatch=16aus, während Läufe mit mehreren GPUs eine explizite globale Batchgröße erfordern, die mindestens der Anzahl der Geräte entspricht. Weitere Informationen findest du in den Argumenten für den Trainingsmodus.Beim Training mit gemischter Genauigkeit werden Gleitkommatypen mit 16 Bit (FP16) und 32 Bit (FP32) kombiniert, um Rechengeschwindigkeit und Genauigkeit auszubalancieren. In YOLO26 ist diese Funktion standardmäßig über
amp=Trueaktiviert. Setzeamp=False, um FP32 zu erzwingen. AMP wird auf CPUs und Apple-Silicon-Chips übersprungen.Training mit mehreren Bildskalen verbessert die Modellleistung, indem mit Bildern unterschiedlicher Größe trainiert wird. Dadurch kann das Modell besser über verschiedene Maßstäbe und Entfernungen hinweg generalisieren. YOLO26 bietet dafür zwei separate Parameter.
scale=0.5wählt einen Zoomfaktor zwischen 0,5 und 1,5 aus und füllt das Bild anschließend auf eine festeimgszauf oder schneidet es darauf zu.multi_scale=0.25variiert dagegen in jedem Batchimgszselbst in Schritten der Schrittweite. Einstellungen und weitere Informationen findest du in der Dokumentation zum Train-Modus.Vortrainierte Gewichte können das Training erheblich beschleunigen und die Modellgenauigkeit verbessern, indem sie ein Modell nutzen, das grundlegende visuelle Merkmale bereits kennt. Lade sie über das Argument
model, beispielsweise mitmodel=yolo26n.pt. Anschließend entscheidetpretrained, ob diese Gewichte beibehalten werden (True, die Standardeinstellung), verworfen werden (False) oder durch einen anderen Checkpoint ersetzt werden (pretrained=path/to/best.pt, die Möglichkeit, Gewichte in einenmodel=*.yaml-Build zu übertragen). Weitere Informationen findest du in der Dokumentation zum Train-Modus.Die Anzahl der Epochen gibt an, wie oft das Modell während des Trainings den gesamten Trainingsdatensatz durchläuft. Ein typischer Ausgangswert sind 300 Epochen. Wenn dein Modell früh überanpasst, kannst du die Anzahl verringern. Wird keine Überanpassung festgestellt, kannst du das Training stattdessen auf 600, 1200 oder mehr Epochen verlängern. Um die Anzahl in YOLO26 festzulegen, verwende den Parameter
epochsin deinem Trainingsskript. Weitere Hinweise zur Bestimmung der idealen Epochenanzahl findest du in diesem Abschnitt zur Anzahl der Epochen.


Kommentare12
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
puzzlemindgames
Hello
I'm working on a browser-based puzzle solver that uses a custom YOLO model to detect visible objects from game screenshots.
Some examples include: Transparent ice/frost overlays on the lower part of objects Semi-transparent cloth or curtain overlays Small decorative objects inside larger objects (for example, keys inside containers) The visible objects are usually detected correctly, but these overlays often cause false negatives or incorrect class predictions.
At the moment I'm considering a few approaches: Training with many more occlusion-heavy examples Splitting the detection into multiple stages instead of one larger model
python results = model.predict( source="level_512.png", conf=0.25, iou=0.45, imgsz=1280 ) for box in results[0].boxes: print(box.cls, box.conf)
For anyone who has trained YOLO models on UI or game screenshots which approach gave you the biggest improvement? Or is there another strategy that tends to work better for partially occluded objects?
I'd really appreciate hearing about real-world experiences before I spend time retraining the dataset.
 Glenn JocherUltralytics
Start with targeted data: add representative occluded examples, keep annotations consistent for partially visible objects, and synthetically composite the actual frost/cloth overlays at realistic opacity and placement. Measure recall per class on a dedicated occlusion-heavy validation split, then tune
mosaic,mixup, orcutmixconservatively; higherimgszor tiled inference can help nested small objects. A multi-stage pipeline is usually worthwhile only if the first stage can reliably isolate containers or overlay regions. Please continue sharing results and questions here so the Ultralytics team and community can see them.1Thanks! I followed your suggestions and added more occluded samples. The main objects/tubes are much more stable as well as the colors now but I'm still struggling with very small objects.
i cant able to attach model training screenshots here for you to review.
For example, tiny keys or tags inside transparent containers are often missed or detected as the wrong class. For context the screenshots come from a puzzle game with objects similar to these shown in sample pictures embedded at product homepage: https://aimagicsortsolver.com/
results = model.predict( source="level.png", imgsz=1280, conf=0.35, iou=0.45 ) Would you recommend keep improving a single model or train a second YOLO model just for these small objects?
- Glenn JocherUltralytics(bearbeitet)
Keep the single model first: audit tiny-object annotations, add more balanced close-up examples, and test cropped or SAHI tiled inference so keys and tags occupy more pixels; also compare
conf=0.15–0.25, since higher thresholds may suppress weak detections. Train a second specialized model only if the first model reliably detects each container, allowing its crop to be passed to the small-object model at higher effective resolution.1 Thank you for your suggestions. I'll tweak it as per the recommendations.
TSHSLU
What is the minimum Dataset Size required if i use a pretrained model for custom projects. i barely find any sources online which recommend a minimum dataset size.
- Glenn JocherUltralytics
There isn’t a fixed “minimum” dataset size when fine-tuning a pretrained model; if your domain is close to the pretrained data and labels are clean, you can often start getting useful signal with ~50–200 images per class (or a few hundred labeled object instances), but for reliably robust results across different lighting/viewpoints/backgrounds you’ll usually want 500–2000+ images per class with good diversity—one practical way to find your true minimum is to train on a small pilot subset, check validation failures, then add data specifically where the model breaks (the
fractionworkflow in the Model training tips guide helps iterate quickly).from ultralytics import YOLO model = YOLO("yolo26n.pt") model.train(data="data.yaml", epochs=100, fraction=0.1)1
VeeranjaneyuluToka
Hi, I just noticed a thing, looks like the optimizer is getting chosen based on no.of iterations, would you mind telling me the reason for the same? I mean how does iterations matter when we choose optimizer?
Imran-ml
First of all its great to have another powerful model and congratulations. I have fine tuned and trained yolo11x.pt for my custom objects but I'm facing some issues. My images data resolution is around 6000 x 2000 but while trained the model I set the imgsz=(1280, 640). It work well when I adjust the video stream by zoom in-out and detect all my 60 objects well (objects are small) but when there is some zoom or squeezed then it completely dont detect any object or few only.
Please let me know if I'm missing something or I have to do something else? I have labelled the data on my original images so resizing making any issues? any ratio issues? Please guide me properly so I can use this power yolo11 model effectively.
- Glenn JocherUltralytics
@Imran-ml it sounds like the issue might be related to image resizing affecting object detection. Consider enabling multiscale training by adjusting the
scaleparameter to help the model generalize better across different image sizes. This can improve detection performance when objects appear at varying scales. For more detailed guidance, you can refer to our model training tips at https://docs.ultralytics.com/guides/model-training-tips/.
Taufiq-Ahmed
Hi I have a question. I am using Yolov8s for trained a dataset that has four class. fire, smoke, person, animal. all the images has areal view to detect forest fire . In my dataset I have forest fire images from drone so after training it detect fire smoke quite accurately. however, I do not have any dataset that has person or animal in forest fire. so I have to collect some other dataset from roboflow that has person and animal and the n I have merged them with my own dataset ( have changed the label of animal and person accordingly so 0 means smoke, 1 means fire, 2 means person and 3 means animal and also updated the data.yaml file) . this time the problem is it could not detect the animal and person properly some times it can detect them. The main reasons seems to me is that the drone is flying in a high altitude so it does not detect person and animal properly because in the dataset of person and animal the view of the drone is not that much high. is there any technique to solve this problem and detect all the objects as many as possible?
- Glenn JocherUltralytics
@Taufiq-Ahmed it sounds like the altitude difference between your training and test datasets is causing the detection issues. To address this, consider using data augmentation techniques to simulate higher altitude views in your training data. You can also try multiscale training to help the model generalize better across different scales. Additionally, fine-tuning the model with a mix of high-altitude and low-altitude images might improve its performance. For more detailed strategies, you can refer to our model training tips.