Anleitung: Kaggle zum Trainieren deiner YOLO26-Modelle verwenden
Wenn du dich mit KI beschäftigst und an kleinen Projekten arbeitest, hast du möglicherweise noch keinen Zugriff auf leistungsstarke Rechenressourcen, und hochwertige Hardware kann teuer sein. Kaggle, eine Plattform im Besitz von Google, bietet eine kostenlose cloudbasierte Umgebung, in der du auf GPU-Ressourcen zugreifen, große Datensätze verarbeiten und mit einer vielfältigen Community aus Datenwissenschaftlern und Fans des maschinellen Lernens zusammenarbeiten kannst.
Kaggle ist eine praktische Option, um Ultralytics-YOLO26-Modelle zu trainieren und mit ihnen zu experimentieren. Kaggle Notebooks enthalten bereits beliebte Bibliotheken und Frameworks für maschinelles Lernen. Dieser Leitfaden stellt die wichtigsten Funktionen von Kaggle vor und zeigt, wie du auf der Plattform YOLO26-Modelle trainierst.
Was ist Kaggle?#
Kaggle ist eine Plattform, auf der Datenwissenschaftler aus aller Welt zusammenkommen, um zusammenzuarbeiten, zu lernen und Lösungen für reale Datenwissenschaftsprobleme zu entwickeln. Kaggle wurde 2010 von Anthony Goldbloom und Jeremy Howard gegründet und 2017 von Google übernommen. Die Plattform ermöglicht es Nutzern, Kontakte zu knüpfen, Datensätze zu entdecken und zu teilen, Notebooks mit GPU-Unterstützung zu verwenden und an Wettbewerben im Bereich Datenwissenschaft teilzunehmen. Sie richtet sich sowohl an erfahrene Fachleute als auch an Lernende.
Mit mehr als 10 Millionen Nutzern im Jahr 2022 bietet Kaggle eine vielseitige Umgebung für die Entwicklung und das Experimentieren mit Modellen des maschinellen Lernens. Du musst dir keine Gedanken über die technische Ausstattung oder Einrichtung deines lokalen Computers machen – du brauchst lediglich ein Kaggle-Konto und einen Webbrowser.
Installation#
Bevor du mit dem Training von YOLO26-Modellen auf Kaggle beginnen kannst, musst du sicherstellen, dass deine Notebook-Umgebung richtig konfiguriert ist. Folge diesen Schritten:
Internetzugriff aktivieren#
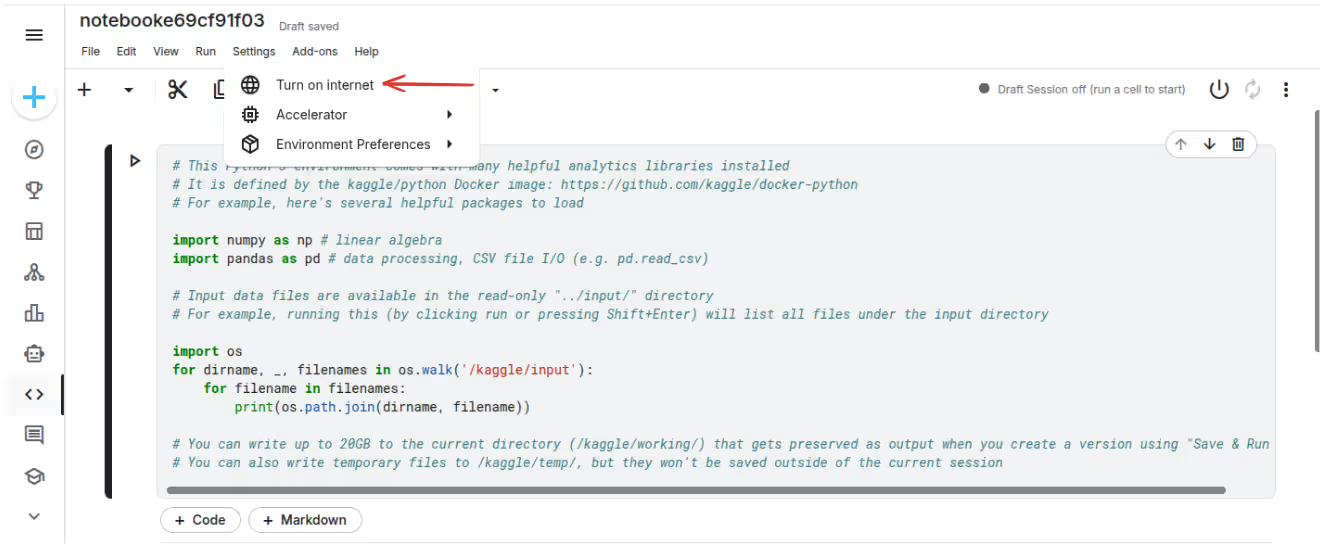
Kaggle-Notebooks benötigen Internetzugriff, um Pakete und Abhängigkeiten herunterzuladen. So aktivierst du den Internetzugriff in deinem Kaggle-Notebook:
- Öffne dein Kaggle-Notebook.
- Klicke rechts in der Notebook-Oberfläche auf den Bereich Settings.
- Scrolle nach unten zum Abschnitt Internet.
- Stelle den Schalter auf ON, um den Internetzugriff zu aktivieren.
Hinweis: Für die Installation des Ultralytics-Pakets und das Herunterladen vortrainierter Modelle oder Datensätze ist ein Internetzugang erforderlich. Ohne aktivierten Internetzugang schlagen Paketinstallationen fehl.
Ultralytics installieren#
Sobald der Internetzugriff aktiviert ist, installiere das Ultralytics-Paket, indem du den folgenden Befehl in einer Notebook-Zelle ausführst:
!pip install ultralyticsDie neueste Entwicklungsversion kannst du direkt von GitHub installieren:
!pip install git+https://github.com/ultralytics/ultralytics.gitAbhängigkeitskonflikte beheben#
Bei der Installation können Abhängigkeitskonflikte auftreten, insbesondere mit Paketen wie opencv-python, numpy oder torch. Hier sind einige gängige Lösungen:
Methode 1: Neuinstallation mit --upgrade erzwingen#
Wenn Konflikte mit vorhandenen Paketen auftreten, erzwinge ein Upgrade:
!pip install --upgrade --force-reinstall ultralyticsMethode 2: Kernel nach der Installation neu starten#
Manchmal musst du den Kernel nach der Installation neu starten, um Importprobleme zu beheben:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Lösungen für häufige Fehler#
Fehler: "No module named 'ultralytics'"
- Lösung: Stelle sicher, dass der Internetzugriff aktiviert ist, und führe den Installationsbefehl erneut aus.
- Starte den Kernel nach der Installation neu.
Fehler: "ERROR: pip's dependency resolver does not currently take into account..."
- Lösung: Dies ist normalerweise eine Warnung und kann bedenkenlos ignoriert werden. Die Installation wird in der Regel trotz dieser Meldung erfolgreich abgeschlossen.
Fehler: "ModuleNotFoundError" nach der Installation
- Lösung: Starte den Kernel über die Neustart-Schaltfläche in der Notebook-Oberfläche neu.
- Führe die Importanweisungen in einer neuen Zelle erneut aus.
Installation überprüfen#
Überprüfe nach der Installation, ob Ultralytics richtig installiert wurde, indem du Folgendes ausführst:
import ultralytics

ultralytics.checks()
Damit werden Systeminformationen angezeigt und es wird überprüft, ob alle Abhängigkeiten korrekt installiert sind.
YOLO26 mit Kaggle trainieren#
Mit den kostenlosen GPUs von Kaggle lassen sich YOLO26-Modelle ganz einfach trainieren.
Öffne zunächst das Ultralytics-YOLO26-Tutorial-Notebook auf Kaggle. In der Kaggle-Umgebung sind Bibliotheken wie TensorFlow und PyTorch bereits installiert, was die Einrichtung vereinfacht.
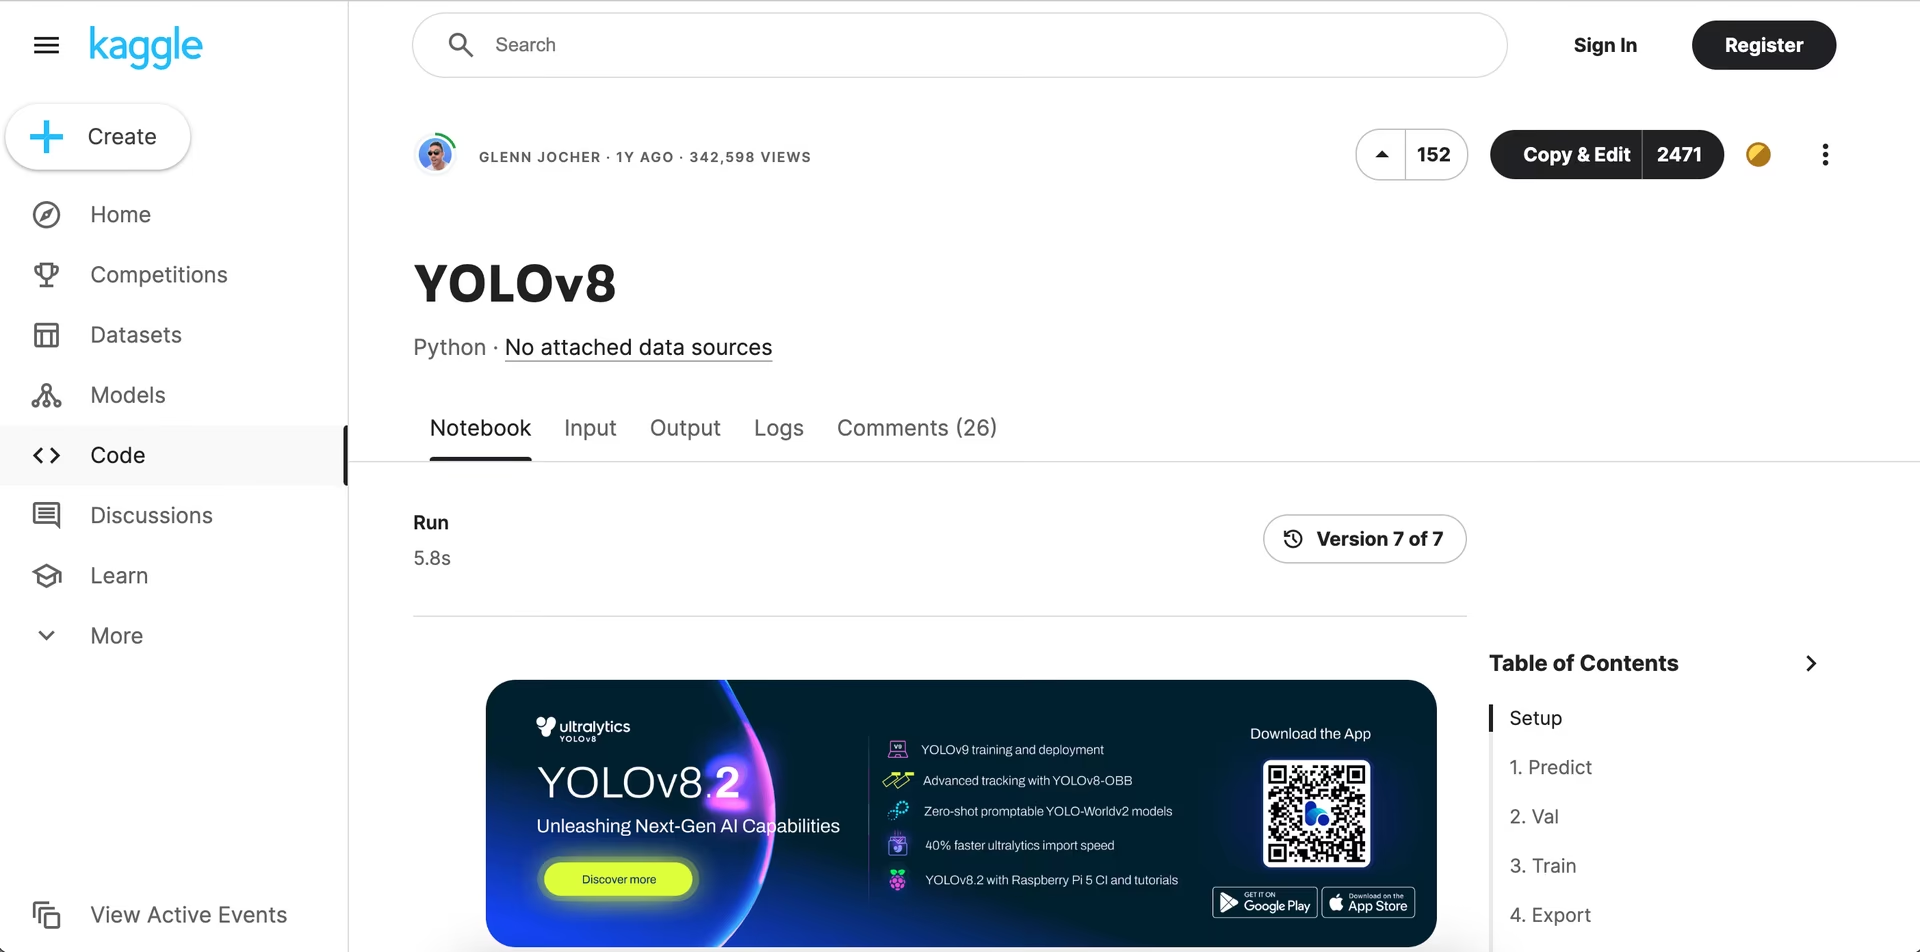
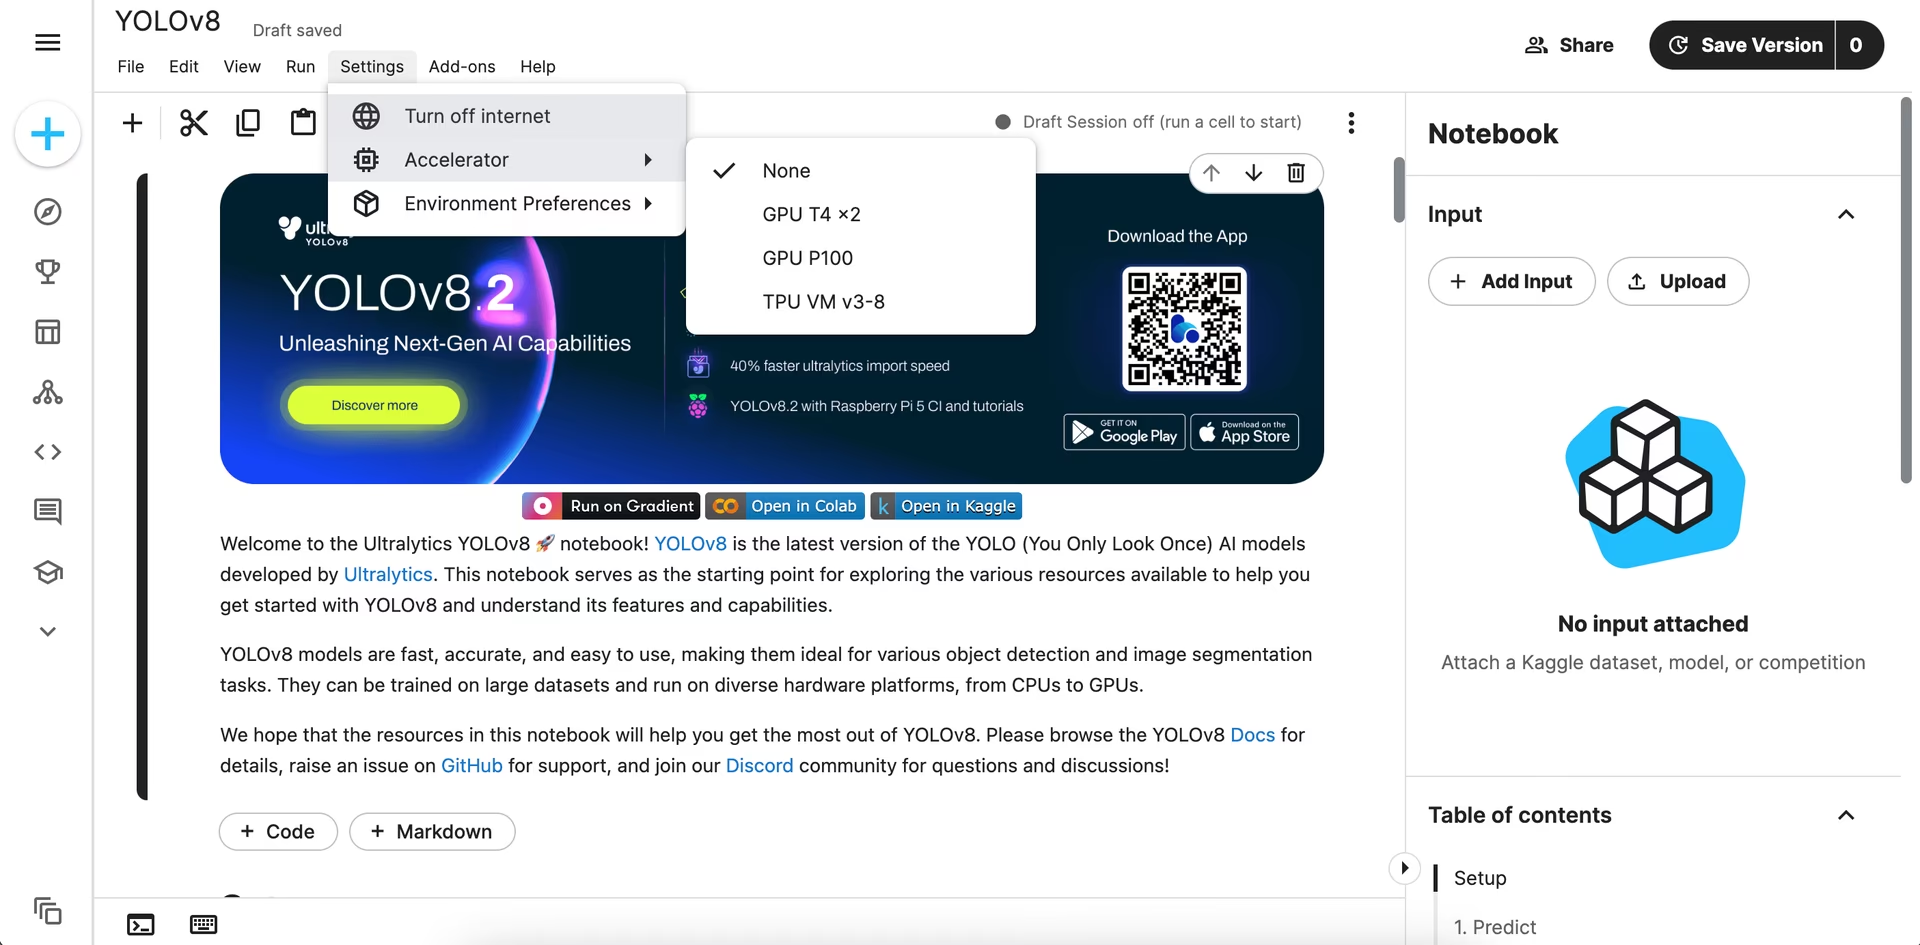
Sobald du dich bei deinem Kaggle-Konto angemeldet hast, wird das Notebook als deine eigene bearbeitbare Kopie geöffnet: Wähle in den Beschleunigereinstellungen eine GPU aus und führe die Zellen des Notebooks aus, um mit dem Modelltraining zu beginnen. Eine ausführliche Erläuterung des Modelltrainings und bewährte Vorgehensweisen findest du in unserer Anleitung zum YOLO26-Modelltraining.
Häufige Probleme bei der Arbeit mit Kaggle#
Bei der Arbeit mit Kaggle können einige häufige Probleme auftreten. Hier sind wichtige Hinweise, die dir die Nutzung der Plattform erleichtern:
- GPU-Zugriff: In deinen Kaggle-Notebooks kannst du jederzeit eine GPU aktivieren. Die Nutzung ist auf bis zu 30 Stunden pro Woche begrenzt. Kaggle stellt eine NVIDIA Tesla P100 GPU mit 16 GB Speicher bereit und bietet außerdem eine NVIDIA T4 x2-Option. GPU-Beschleunigung macht das Modelltraining und die Inferenz deutlich schneller.
- Kaggle-Kernels: Kaggle-Kernels sind kostenlose Jupyter-Notebook-Server, die GPUs einbinden können. Damit kannst du Machine-Learning-Aufgaben auf Cloud-Computern ausführen. Du musst dich nicht auf die CPU deines eigenen Computers verlassen, vermeidest so eine Überlastung und schonst deine lokalen Ressourcen.
- Kaggle-Datensätze: Kaggle-Datensätze können kostenlos heruntergeladen werden. Es ist jedoch wichtig, die Lizenz jedes Datensatzes zu prüfen, um etwaige Nutzungsbeschränkungen zu verstehen. Für manche Datensätze gelten möglicherweise Einschränkungen bei wissenschaftlichen Veröffentlichungen oder der kommerziellen Nutzung. Du kannst Datensätze direkt in dein Kaggle-Notebook oder an einen anderen Ort über die Kaggle API herunterladen.
- Notebooks speichern und übernehmen: Um ein Notebook auf Kaggle zu speichern und zu übernehmen, klicke auf „Version speichern“. Dadurch wird der aktuelle Zustand deines Notebooks gespeichert. Sobald der Hintergrund-Kernel die Ausgabedateien erstellt hat, kannst du über den Tab „Output“ auf der Hauptseite des Notebooks darauf zugreifen.
- Zusammenarbeit: Kaggle unterstützt die Zusammenarbeit, aber mehrere Nutzer können ein Notebook nicht gleichzeitig bearbeiten. Die Zusammenarbeit auf Kaggle erfolgt asynchron, das heißt, Nutzer können dasselbe Notebook zu unterschiedlichen Zeiten gemeinsam nutzen und bearbeiten.
- Zu einer früheren Version zurückkehren: Wenn du zu einer früheren Version deines Notebooks zurückkehren möchtest, öffne das Notebook und klicke oben rechts auf die drei vertikalen Punkte. Wähle „Versionen anzeigen“. Suche die Version, zu der du zurückkehren möchtest, klicke daneben auf das Menü „...“ und wähle „Zu dieser Version zurückkehren“. Nachdem das Notebook auf die frühere Version zurückgesetzt wurde, klicke auf „Version speichern“, um die Änderungen zu übernehmen.
Wichtige Funktionen von Kaggle#
Hier sind einige der wichtigsten Funktionen, die Kaggle für Datenwissenschaft und maschinelles Lernen bietet:
- Datensätze: Kaggle hostet eine große Auswahl an Datensätzen zu verschiedenen Themen. Du kannst diese Datensätze suchen und in deinen Projekten verwenden. Das ist besonders nützlich, um deine YOLO26-Modelle zu trainieren und zu testen.
- Wettbewerbe: Bei Kaggle-Wettbewerben lösen Datenwissenschaftler und Fachleute für maschinelles Lernen Probleme aus der Praxis. Durch die Teilnahme kannst du deine Fähigkeiten verbessern, neue Methoden kennenlernen und in der Community Anerkennung gewinnen.
- Kostenloser Zugriff auf TPUs: Kaggle bietet kostenlosen Zugriff auf TPUs für Frameworks, die diese unterstützen. Das Training von Ultralytics YOLO26 läuft auf den GPUs oder der CPU von Kaggle, nicht auf TPUs.
- Integration mit GitHub: Mit Kaggle kannst du dein GitHub-Repository verbinden, um Notebooks hochzuladen und deine Arbeit zu speichern. Dank dieser Integration lassen sich deine Dateien bequem verwalten und aufrufen.
- Community und Diskussionen: Kaggle hat eine große Community aus Datenwissenschaftlern und Fachleuten für maschinelles Lernen. Die Diskussionsforen und geteilten Notebooks sind nützliche Ressourcen zum Lernen und zur Fehlerbehebung. Du kannst Hilfe finden, dein Wissen teilen und mit anderen zusammenarbeiten.
Warum solltest du Kaggle für deine YOLO26-Projekte nutzen?#
Es gibt verschiedene Plattformen zum Trainieren und Auswerten von Modellen des maschinellen Lernens. Hier sind einige Vorteile von Kaggle für deine Projekte im Bereich maschinelles Lernen:
- Öffentliche Notebooks: Du kannst deine Kaggle-Notebooks öffentlich zugänglich machen, damit andere Nutzer deine Arbeit ansehen, bewerten, forken und diskutieren können. Kaggle fördert Zusammenarbeit, Feedback und den Austausch von Ideen und hilft dir so, deine YOLO26-Modelle zu verbessern.
- Umfassender Verlauf der Notebook-Commits: Kaggle erstellt einen detaillierten Verlauf deiner Notebook-Commits. So kannst du Änderungen im Laufe der Zeit überprüfen und nachverfolgen, die Entwicklung deines Projekts leichter nachvollziehen und bei Bedarf zu früheren Versionen zurückkehren.
- Konsolenzugriff: Kaggle bietet eine Konsole, mit der du mehr Kontrolle über deine Umgebung erhältst. So kannst du verschiedene Aufgaben direkt über die Befehlszeile ausführen.
- Verfügbare Ressourcen: Für jede Notebook-Bearbeitungssitzung auf Kaggle stehen umfangreiche Ressourcen zur Verfügung: 12 Stunden Ausführungszeit für CPU- und GPU-Sitzungen, 9 Stunden Ausführungszeit für TPU-Sitzungen und 20 Gigabyte automatisch gespeicherter Speicherplatz.
- Notebook-Zeitplanung: Mit Kaggle kannst du festlegen, dass deine Notebooks zu bestimmten Zeiten ausgeführt werden. So automatisierst du wiederkehrende Aufgaben ohne manuelles Eingreifen, etwa das regelmäßige Training deines Modells.
Mehr über Kaggle erfahren#
Wenn du mehr über Kaggle erfahren möchtest, findest du hier hilfreiche Ressourcen:
- Kaggle Learn: Entdecke zahlreiche kostenlose, interaktive Tutorials auf Kaggle Learn. Diese Kurse behandeln wichtige Themen der Datenwissenschaft anhand praktischer Übungen.
- Erste Schritte mit Kaggle: Dieser Leitfaden führt dich durch die Grundlagen von Kaggle – von der Teilnahme an Wettbewerben bis zur Erstellung deines ersten Notebooks.
- Kaggle-Seite auf Medium: Entdecke Tutorials, Neuigkeiten und Beiträge aus der Community auf Kaggles Medium-Seite.
- Ultralytics-YOLO-Modelle mit der Kaggle-Integration trainieren: Dieser Blogbeitrag zeigt, wie du Kaggle speziell für Ultralytics-YOLO-Modelle verwendest.
Zusammenfassung#
Kaggle bietet deinen YOLO26-Projekten kostenlosen GPU-Zugriff für das Modelltraining und die Auswertung sowie vorinstallierte Bibliotheken für eine schnelle Einrichtung. Mit Ultralytics YOLO26 und Kaggle kannst du Computer-Vision-Modelle ohne teure Hardware entwickeln, trainieren und bereitstellen.
Weitere Informationen findest du in der Kaggle-Dokumentation.
Häufig gestellte Fragen#
So installierst du Ultralytics YOLO26 auf Kaggle:
- Internet aktivieren: Öffne den Einstellungsbereich und schalte den Internet-Schalter ein.
- Paket installieren: Führe
!pip install ultralyticsin einer Notebook-Zelle aus. - Installation überprüfen: Führe zur Bestätigung
import ultralytics; ultralytics.checks()aus.
Wenn es zu Abhängigkeitskonflikten kommt, versuche es mit
!pip install --upgrade --force-reinstall ultralyticsoder starte den Kernel nach der Installation neu. Ausführliche Hinweise zur Fehlerbehebung findest du weiter oben im Abschnitt Installation.Ein YOLO26-Modell auf Kaggle zu trainieren ist unkompliziert. Öffne zunächst das Ultralytics-YOLO26-Tutorial-Notebook in Kaggle. Melde dich bei deinem Kaggle-Konto an und wähle in den Beschleunigereinstellungen eine GPU aus. Führe die Zellen des Notebooks aus, um das Training zu starten. Eine ausführlichere Anleitung findest du in unserer Anleitung zum YOLO26-Modelltraining.
Kaggle bietet mehrere Vorteile für das Training von YOLO26-Modellen:
- Kostenloser GPU-Zugriff: Nutze GPUs wie die NVIDIA Tesla P100 oder T4 x2 bis zu 30 Stunden pro Woche.
- Vorinstallierte Bibliotheken: Bibliotheken wie TensorFlow und PyTorch sind bereits installiert und vereinfachen die Einrichtung.
- Zusammenarbeit in der Community: Tausche dich mit einer großen Community aus Datenwissenschaftlern und Fans des maschinellen Lernens aus.
- Versionsverwaltung: Verwalte verschiedene Versionen deiner Notebooks und setze sie bei Bedarf auf frühere Versionen zurück.
Zu den häufigen Problemen gehören:
- Zugriff auf GPUs: Aktiviere in den Notebook-Einstellungen eine GPU. Kaggle erlaubt eine GPU-Nutzung von bis zu 30 Stunden pro Woche.
- Internet nicht aktiviert: Aktiviere im Einstellungsbereich das Internet, bevor du Pakete installierst.
- Abhängigkeitskonflikte: Verwende
!pip install --upgrade --force-reinstall ultralytics. - Datensatzlizenzen: Prüfe die Lizenz jedes Datensatzes, um die Nutzungsbeschränkungen zu verstehen.
- Notebooks speichern und übernehmen: Klicke auf „Version speichern“, um den Zustand deines Notebooks zu speichern und über den Tab „Output“ auf die Ausgabedateien zuzugreifen.
- Zusammenarbeit: Kaggle unterstützt asynchrone Zusammenarbeit; mehrere Nutzer können ein Notebook nicht gleichzeitig bearbeiten.
Weitere Tipps zur Fehlerbehebung findest du im Abschnitt Installation und in unserem Leitfaden zu häufigen Problemen.
Kaggle bietet mehrere Funktionen, durch die es sich von Google Colab unterscheidet:
- Öffentliche Notebooks: Teile deine Arbeit mit der Community, um Feedback zu erhalten und zusammenzuarbeiten.
- Umfassender Verlauf: Verfolge Änderungen im Laufe der Zeit mithilfe eines detaillierten Verlaufs der Notebook-Commits.
- Verfügbare Ressourcen: Für jede Notebook-Sitzung stehen umfangreiche Ressourcen bereit, darunter 12 Stunden Ausführungszeit für CPU- und GPU-Sitzungen.
So kehrst du zu einer früheren Version zurück:
- Öffne das Notebook und klicke oben rechts auf die drei vertikalen Punkte.
- Wähle „Versionen anzeigen“.
- Suche die Version, zu der du zurückkehren möchtest, klicke daneben auf das Menü „...“ und wähle „Zu dieser Version zurückkehren“.
- Klicke auf „Version speichern“, um die Änderungen zu übernehmen.


Kommentare3
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?