TensorRT-Export für YOLO26-Modelle
TensorRT ist das SDK von NVIDIA für schnelle Inferenz mit Deep Learning. Wenn du ein Ultralytics-YOLO26-Modell mit format="engine" exportierst, wird eine Datei .engine erstellt, die für die NVIDIA-GPU optimiert ist, auf der sie erstellt wird, und zwar mit FP32-, FP16- oder INT8-Genauigkeit.
TensorRT stimmt eine Engine auf die GPU ab, auf der sie erstellt wird. Erstelle die Engine auf der GPU des Zielsystems oder auf einer GPU desselben Modells und mit derselben TensorRT-Version. Eine Datei .engine ist kein portables Modellformat. Für Edge-Einsätze bietet die Ultralytics Platform acht Jetson-Zielsysteme zur Auswahl. Der Status des physischen Builds und der Validierung ist für jedes Zielsystem dokumentiert. Alternativ kannst du lokal auf dem Zielgerät exportieren.
Auf einen Blick#
| Eigenschaft | Details |
|---|---|
Argument format | engine (Aliase: tensorrt, trt) |
| Ausgabe | yolo26n.engine: eine Datei, die mit einem JSON-Metadatenheader beginnt (Klassennamen, Aufgabe, Bildgröße). Die Zwischendatei yolo26n.onnx bleibt daneben liegen. |
| Ausführbar auf | NVIDIA-GPUs: Rechenzentrum, Workstation und Jetson, einschließlich Jetson-DLA-Kernen (nicht unter TensorRT 11) |
| Laufzeitumgebung | TensorRT 7.0 oder neuer (10.2.0 wird nicht unterstützt) |
| Precision | FP32, FP16, INT8 |
| Exportrechner | Ein Rechner mit NVIDIA-GPU und CUDA. Erstelle die Engine auf der GPU des Zielsystems oder einer GPU desselben Modells. |
Die Ultralytics Platform kann eine TensorRT-Engine für dich auf dem von dir ausgewählten GPU-Typ erstellen, einschließlich NVIDIA-Jetson-Zielsystemen. Du benötigst daher keine lokale Exportumgebung.
Schnellstart#
Installiere das Ultralytics-Paket auf einem Rechner mit NVIDIA-GPU und CUDA. Unter Linux installiert der erste Export das zu deiner CUDA-Version passende TensorRT-Python-Paket, falls es noch fehlt. Verwende auf NVIDIA Jetson die mit JetPack ausgelieferte TensorRT-Version. Installiere TensorRT unter Windows selbst, bevor du exportierst.
pip install ultralyticsWeitere Installationsmethoden findest du im Installationsleitfaden. Anschließend kannst du dein Modell exportieren und die exportierte Engine laden, um Inferenz auszuführen oder ihre Genauigkeit zu validieren. Für Inferenz und Validierung ist eine NVIDIA-GPU erforderlich. Das Erstellen einer YOLO26n-Engine dauert auf einer NVIDIA T4 ein bis drei Minuten.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Exportiere das Modell im TensorRT-Format
model.export(format="engine")  # erstellt 'yolo26n.engine'

# Oder stattdessen eine FP16-Engine exportieren
model.export(format="engine", quantize=16) # erstellt 'yolo26n.engine'from ultralytics import YOLO
# Das exportierte TensorRT-Modell laden
model = YOLO("yolo26n.engine")
# Inferenz ausführen
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Das exportierte TensorRT-Modell laden
model = YOLO("yolo26n.engine")
# Die Genauigkeit anhand des COCO8-Datensatzes validieren
metrics = model.val(data="coco8.yaml")Unterstützte Aufgaben#
Der TensorRT-Export unterstützt alle sieben Ultralytics-Aufgaben mit YOLOv8-, YOLO11- und YOLO26-Modellen: Erkennung, Segmentierung, semantische Segmentierung, Tiefenschätzung, Klassifizierung, Posenschätzung und OBB. Semantische Segmentierung und Tiefenschätzung sind nur mit YOLO26 verfügbar, der einzigen Modellfamilie, die diese Köpfe enthält.
Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'engine' | Zielformat des exportierten Modells, das die Kompatibilität mit verschiedenen Bereitstellungsumgebungen festlegt. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Kann eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width) für bestimmte Abmessungen sein. |
quantize | int oder str | None | Quantisierungsgenauigkeit: 16 (FP16) oder 8 (INT8/PTQ; benötigt Kalibrierungs-data/fraction); 32/nicht gesetzt bedeutet FP32. Ein mit quantize=8 trainierter Checkpoint exportiert INT8 anhand der darin enthaltenen Wertebereiche, ohne Kalibrierung, auch wenn quantize nicht gesetzt ist; quantize=16 oder quantize=32 führt zu einem Fehler. Ersetzt die veralteten Flags half/int8. |
dynamic | bool | False | Erstellt eine Engine, die Batchgrößen von 1 bis batch und Bildgrößen von 32 Pixeln bis zum Doppelten von imgsz akzeptiert. Bei dynamischen INT8-Engines auf älteren GPUs liegt der Mindestwert höher. Wenn False gesetzt ist, akzeptiert die Engine nur die beim Export verwendeten Werte batch und imgsz. |
simplify | bool | True | Vereinfacht den Modellgraphen mit onnxslim und kann dadurch Leistung und Kompatibilität verbessern. |
opset | int | None | Gibt die ONNX-opset-Version für den Zwischen-ONNX-Graphen an. Wenn nicht angegeben, wird opset 18 verwendet (niedriger bei PyTorch < 2.4), höchstens jedoch die installierte Version onnx. |
workspace | float oder None | None | Obergrenze in GiB für den Speicher, den TensorRT beim Erstellen der Engine verwendet. Lass den Wert auf None, damit TensorRT den Speicher automatisch zuweist. |
nms | bool, optional | None | Wähle Rohdaten als Ausgabe (None, Standardwert), integriertes NMS (True) oder den NMS-freien Kopf (False). Mit nms=True sind conf (Standardwert 0.25), iou, max_det und agnostic_nms beim Export festgelegt. nms=True wird bei semantischen Segmentierungs- und Tiefenmodellen ignoriert und führt bei Klassifizierungsmodellen zu einem Fehler. |
batch | int | 1 | Batchgröße der Engine oder maximale Batchgröße bei dynamic=True. Wird auch als Batchgröße für die INT8-Kalibrierung verwendet. |
data | str | None | Pfad zur YAML-Datei des Datensatzes, die für die INT8-Kalibrierung verwendet wird. Bei der Klassifizierung wird stattdessen ein Datensatzverzeichnis oder ein integrierter Datensatzname verwendet. Für die Kalibrierung wird die Aufteilung val des Datensatzes verwendet, sofern split nicht gesetzt ist. Wenn der Wert bei quantize=8 fehlt, verwendet Ultralytics den kleinen Standarddatensatz für die jeweilige Modellaufgabe, zum Beispiel coco8.yaml für die Erkennung. Für einen mit quantize=8 trainierten Checkpoint ist kein Datensatz erforderlich. |
fraction | float, int oder list | 1.0 | Kalibrierungsteilstichprobe als Verhältnis, Bildanzahl oder [train, val, test]-Verhältnisse/-Anzahlen. Bei Listen mit zwei Elementen bleibt test vollständig erhalten, während 0 es überspringt. |
device | str | None | Gibt das Gerät für den Export an: GPU (device=0, wenn nicht gesetzt), DLA für NVIDIA Jetson (device=dla:0 oder device=dla:1, mit quantize=16 oder quantize=8). |
Auf NVIDIA Jetson exportiert Ultralytics mit der TensorRT-Laufzeitumgebung deiner JetPack-Version. Unter JetPack 7 erfordert der Export TensorRT 10.15 oder neuer, aber niedriger als 11. device=dla:0 und device=dla:1 führen unter TensorRT 11 zu einem Fehler. NVIDIA führt TensorRT 10.7 als letzte 10.x-Version mit DLA-Unterstützung auf. TensorRT 11.4.1 bietet Unterstützung für JetPack 7.2.2, die Ultralytics derzeit noch nicht verwendet.
Die für alle Formate geltenden Argumente findest du in der Dokumentation zum Exportmodus.
TensorRT-Export mit INT8-Quantisierung#
quantize=8 erstellt eine INT8-Engine mit Quantisierung nach dem Training (PTQ): Beim Export werden Kalibrierungsbilder durch das Modell geleitet, um den Wertebereich jedes Tensors zu messen. Ein Checkpoint, der durch quantisierungsbewusstes Training mit quantize=8 feinabgestimmt wurde, enthält bereits seine INT8-Wertebereiche. Daher wird beim Export die Kalibrierung übersprungen.
Die Argumente quantize und data sind bei allen TensorRT-Versionen gleich, aber der Export eines Checkpoints, der nicht mit quantize=8 trainiert wurde, funktioniert im Hintergrund unterschiedlich:
| TensorRT 7–10 | TensorRT 11 | |
|---|---|---|
| INT8-Methode | Implizite Quantisierung mit der Schnittstelle IInt8Calibrator | Explizite Quantisierung: NVIDIA ModelOpt fügt Q/DQ-Knoten in den ONNX-Graphen ein |
| Kalibrierungsalgorithmus | MINMAX_CALIBRATION auf der GPU, ENTROPY_CALIBRATION_2 für DLA | ModelOpt max, auf der CPU ausgeführt |
| Verwendete Kalibrierungsbilder | Jeder vollständige Batch der Aufteilung | Etwa 512 Bilder in zufälliger Reihenfolge oder jeder vollständige Batch einer kleineren Aufteilung |
dynamic=True mit quantize=8 | Nicht durch Tests abgedeckt; ohne dynamic=True exportieren | Unterstützt |
FP16 (quantize=16) | TensorRT-Builder-Flag | ModelOpt-Konvertierung mit gemischter Genauigkeit |
ModelOpt wird bei der ersten Verwendung installiert. Ultralytics verwendet einen Kalibrierungscache nicht erneut, daher wird bei jedem Export erneut kalibriert. Einzelheiten zu beiden Methoden findest du unter Arbeiten mit quantisierten Datentypen in der TensorRT-Dokumentation.
Übergib für einen Checkpoint, der nicht mit quantize=8 trainiert wurde, Kalibrierungsbilder mit data, zum Beispiel data="my_dataset.yaml". Für die Kalibrierung wird die Aufteilung val dieses Datensatzes verwendet, sofern du nicht split festlegst. fraction begrenzt die Anzahl der Bilder. NVIDIA empfiehlt mindestens 500 Bilder, die deine Einsatzdaten repräsentieren. Bei weniger als 300 Bildern gibt der Export eine Warnung aus. Wenn data fehlt, gibt der Export eine Warnung aus und verwendet den kleinen Beispieldatensatz für die jeweilige Modellaufgabe, zum Beispiel coco8.yaml für die Erkennung. Die Validierungsaufteilung umfasst 4 Bilder. Das reicht aus, um den Export zu testen, nicht aber, um ein Modell für den Einsatz zu kalibrieren.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Mit 10 % der COCO-Validierungsbilder kalibrieren (500 Bilder); coco.yaml durch deinen eigenen Datensatz ersetzen
model.export(format="engine", quantize=8, data="coco.yaml", fraction=0.1)

# Die exportierte INT8-Engine laden und Inferenz ausführen
model = YOLO("yolo26n.engine")
result = model.predict("https://ultralytics.com/images/bus.jpg")
Auf der Benchmark-GPU waren INT8-Engines 1,04- bis 2,3-mal schneller als FP32-Engines, aber nur bei drei von zehn Modellen schneller als FP16-Engines. Bei YOLO26n bis YOLO26l sank mAP mit INT8 um 1,7 bis 2,9 Punkte, bei YOLO26x und YOLO26n-pose sogar deutlich stärker. Die YOLO26n-INT8-Engine war größer als ihre FP32-Engine (30 MB gegenüber 11 MB), während große Modelle kleiner wurden (53 MB gegenüber 103 MB bei YOLO26l). INT8 kann außerdem die Konfidenzwerte verschieben. Wähle den Konfidenzschwellenwert daher anhand der F1-Kurve der INT8-Engine selbst. Benchmarks für alle Modelle findest du unter Benchmarks.
Ausgabeformat#
Die Engine hat eine Eingabe namens images und gibt dieselben Ausgaben wie der ONNX-Export zurück, aus dem sie erstellt wurde. Eine Ausnahme gilt für TensorRT-Versionen vor 10: Semantische Modelle geben Klassenscores als Floatwerte mit der Form (batch, classes, height, width) statt der Klassenkarte uint8 zurück. Die Ausgabeform für jede Aufgabe und jede Einstellung von nms findest du im ONNX-Ausgabeformat.
Engine außerhalb von Ultralytics laden#
Eine Ultralytics-Datei .engine ist keine gewöhnliche TensorRT-Engine. Sie beginnt mit einer 4 Byte langen Little-Endian-Angabe zur Länge, gefolgt von genau dieser Anzahl an JSON-Metadatenbytes und anschließend der serialisierten Engine. Die TensorRT-Methode deserialize_cuda_engine gibt None zurück, wenn du ihr die gesamte Datei übergibst. Überspringe den Header, um die Engine mit der TensorRT-API zu laden:
import json

import tensorrt as trt

with open("yolo26n.engine", "rb") as f:
    n = int.from_bytes(f.read(4), byteorder="little")  # Länge des Metadatenheaders
    metadata = json.loads(f.read(n))  # Klassennamen, Aufgabe, imgsz, Batchgröße, Exportargumente
    engine = trt.Runtime(trt.Logger(trt.Logger.WARNING)).deserialize_cuda_engine(f.read())
Wenn ein anderes Werkzeug eine reine TensorRT-Engine-Datei erwartet, schreibe die Bytes nach dem Header in eine neue Datei oder erstelle die Engine mit diesem Werkzeug anhand der Datei yolo26n.onnx, die der Export neben der Engine ablegt. Unter TensorRT 11 legt der Export mit FP16 und kalibriertem INT8 auch die Dateien yolo26n.fp16.onnx und yolo26n.int8.onnx ab. Erstelle eine INT8-Engine mit einem anderen Werkzeug anhand der Datei .int8.onnx. Bei einem mit quantize=8 trainierten Checkpoint enthält yolo26n.onnx bereits die Q/DQ-Knoten, und es wird keine Datei .int8.onnx geschrieben. Unter TensorRT 11 legt dieser Export yolo26n.fp16.onnx ab: denselben Q/DQ-Graphen, dessen übrige Schichten in FP16 vorliegen.
Bereitstellen#
YOLO("yolo26n.engine") lädt die Engine mit der TensorRT-Python-Laufzeitumgebung. Die Engine läuft standardmäßig auf GPU 0, auch wenn du device="cpu" übergibst. Übergib device=1, um sie auf einer anderen GPU desselben Modells auszuführen. Eine mit device=dla:0 oder device=dla:1 exportierte Engine läuft auf diesem DLA-Kern.
Eine Engine, die ohne dynamic=True exportiert wurde, hat eine feste Eingabeform. Bei Predict und Val wird der beim Export verwendete Wert imgsz übernommen und ein abweichendes Argument imgsz ignoriert. Ultralytics teilt größere Batches in Batches der Exportgröße auf und füllt kleinere Batches auf, sodass eine beliebige Anzahl von Bildern verarbeitet werden kann. Eine Engine, die mit dynamic=True exportiert wurde, akzeptiert jede Batch- und Bildgröße innerhalb ihres Bereichs und löst bei einer Form außerhalb dieses Bereichs ValueError: input size ... is outside the TensorRT optimization profile aus. Mit nms=True wird ein Batch oberhalb des Bereichs stattdessen in Batches der Exportgröße aufgeteilt.
Leitfäden zur Bereitstellung#
-
NVIDIA Triton Inference Server: Stelle einen ONNX-Export mit Tritons TensorRT-Beschleuniger bereit, der die Engine auf der Server-GPU erstellt.
-
NVIDIA-Jetson-Schnellstart: Richte Ultralytics auf Jetson-Geräten ein und exportiere TensorRT-Engines mit JetPack, einschließlich DLA.
-
NVIDIA-DGX-Spark-Schnellstart: Richte Ultralytics und TensorRT auf NVIDIA DGX Spark ein.
-
DeepStream auf NVIDIA Jetson: Führe exportierte Modelle in NVIDIA-DeepStream-Videopipelines aus.
-
NVIDIA TensorRT auf GitHub: Quellcode, Beispiele und Werkzeuge für TensorRT.
Einschränkungen und Fehlerbehebung#
- Engines sind nicht portabel: Eine Engine wird für ein GPU-Modell und eine TensorRT-Version erstellt. Erstelle sie neu, wenn du die GPU, die TensorRT-Version oder die JetPack-Version wechselst. Wenn eine Engine nicht geladen werden kann, protokolliert Ultralytics
TensorRT model exported with a different version than expected. - GPU erforderlich: Wenn
devicenicht gesetzt ist, verwendet der Exportdevice=0und schlägt beidevice=cpumitexport running on CPU but must be on GPUfehl. - Engine lässt sich nicht mit anderen Werkzeugen laden: Die Datei
.enginebeginnt mit einem Metadatenheader, daher kann die TensorRT-API sie nicht direkt lesen. Weitere Informationen findest du unter Engine außerhalb von Ultralytics laden. - TensorRT-Version: Ultralytics erfordert TensorRT 7.0.0 oder neuer. TensorRT 10.2.0 wird nicht unterstützt und bei der automatischen Installation übersprungen. Unter JetPack 7 und auf NVIDIA-DGX-Systemen erfordert der Export TensorRT 10.15 oder neuer (auf Jetson jedoch eine Version unter 11) und versucht, TensorRT zu installieren, wenn die installierte Version außerhalb dieses Bereichs liegt.
- NMS-freier Kopf mit älterem TensorRT: TensorRT-Versionen vor 8.5.0 können den NMS-freien YOLO26-Kopf nicht erstellen. Der Export gibt eine Warnung aus und schreibt Rohvorhersagen, die NMS erfordern. Aktualisiere TensorRT auf Version 8.5.0 oder neuer, um mit
nms=Falsezu exportieren. - INT8 unter JetPack 6: Mit TensorRT 10.3.0 unter JetPack 6 schlägt ein INT8-Export mit
nms=Truefehl. Bei einem INT8-Export mitnms=Falsewird auf Rohvorhersagen zurückgegriffen. Die Lösung findest du im Jetson-Leitfaden. - INT8 unter TensorRT 10.16: Der INT8-Export mit TensorRT 10.16.1 schlug auf NVIDIA RTX PRO 6000 Blackwell- und RTX 6000D-GPUs mit
Could not find any implementation for nodefehl. Auf der RTX PRO 6000 Blackwell erstellten TensorRT 10.13, 10.14, 10.15 und 11.4 die INT8-Engine. - DLA:
device=dla:0unddevice=dla:1funktionieren nur auf NVIDIA Jetson und nur mitquantize=16oderquantize=8. Unter TensorRT 11 löst der Export einen Fehler aus. Schichten, die DLA nicht unterstützt, werden auf der GPU ausgeführt. - Dynamische Formen:
dynamic=Truebenötigt eine maximale Batchgröße. Lege daher auchbatchfest, zum Beispielbatch=8. Ohne diesen Wert gibt der Export eine Warnung aus, und die maximale Batchgröße beträgt 1. Die Engine akzeptiert Batchgrößen von 1 bisbatchund Bildgrößen von 32 Pixeln bis zum Doppelten des beim Export verwendeten Wertsimgsz. Eine mitimgsz=320 batch=4exportierte Engine läuft beispielsweise mit 640 Pixeln, lehnt aber 704 Pixel oder einen Batch von 6 mitinput size ... is outside the TensorRT optimization profileab. Verwendedynamic=Truenur unter TensorRT 11 zusammen mitquantize=8. Auf GPUs mit Compute Capability 7.5 oder niedriger, etwa der T4, beträgt die Mindestgröße dieser dynamischen INT8-Engines 64 Pixel (128 bei P6-Modellen). - Feste Eingabegröße: Eine Engine, die ohne
dynamic=Trueexportiert wurde, läuft immer mit dem beim Export verwendeten Wertimgsz. Wenn du bei Predict oder Val einen anderen Wertimgszübergibst, hat das keine Auswirkung. Exportiere das Modell daher erneut, um die Eingabegröße zu ändern. - INT8-Export ohne
data: Wenn der Checkpoint nicht mitquantize=8trainiert wurde, kalibriert der Export das Modell mit dem kleinen Standarddatensatz für die jeweilige Aufgabe. Dieser umfasst für die Erkennung 4 Validierungsbilder, und der Export gibt eine Warnung aus. Übergibdatamit repräsentativen Bildern. Bei weniger als 300 Bildern gibt der Export eine Warnung aus. - Langsame erste Inferenzläufe: Die ersten Aufrufe mit einer neuen Engine oder mit einem neuen
imgszbei einer dynamischen Engine dauern länger als spätere Aufrufe.
Weitere Fehler findest du im Leitfaden zu häufigen Problemen.
Benchmarks#
Die YOLO26-Modellseite führt die TensorRT-10-Geschwindigkeit jedes Modells auf einer NVIDIA-T4-GPU für alle Aufgaben außer der semantischen Segmentierung auf.
FP32, FP16 und INT8 im Vergleich#
Die folgenden Tabellen vergleichen PyTorch mit TensorRT-11.4-Engines in FP32, FP16 und INT8 für alle YOLO26-Erkennungsmodelle sowie für das YOLO26n-Modell bei fünf weiteren Aufgaben. Alle Werte wurden auf einer einzelnen NVIDIA RTX PRO 6000 Blackwell Server Edition-GPU gemessen.
Millisekunden pro Bild; niedrigere Werte sind besser. Das schnellste Format für jedes Modell ist fett hervorgehoben. Die INT8-Engine von YOLO26x ist ausgeschlossen, da ihre Genauigkeit instabil war.
| Modell | imgsz | PyTorch | TensorRT FP32 | TensorRT FP16 | TensorRT INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 0.67 | 0.48 | 0.53 |
| YOLO26s | 640 | 2.98 | 1.15 | 0.61 | 0.66 |
| YOLO26m | 640 | 3.29 | 2.22 | 1.03 | 1.08 |
| YOLO26l | 640 | 4.70 | 3.03 | 1.49 | 1.43 |
| YOLO26x | 640 | 5.93 | 4.31 | 2.09 | 1.84 |
| YOLO26n-seg | 640 | 3.18 | 0.93 | 0.65 | 0.72 |
| YOLO26n-sem | 1024 | 1.74 | 0.74 | 0.45 | 0.71 |
| YOLO26n-cls | 224 | 1.75 | 0.29 | 0.24 | 0.20 |
| YOLO26n-pose | 640 | 3.39 | 0.76 | 0.51 | 0.59 |
| YOLO26n-obb | 1024 | 4.55 | 1.03 | 0.64 | 0.88 |
- FP16 hielt die Genauigkeit von FP32 bei jedem Modell innerhalb von 0,1 Punkten. Bei den Erkennungsmodellen lief es 1,4- bis 2,2-mal schneller als die FP32-Engine und 2,8- bis 5,9-mal schneller als PyTorch.
- INT8 erreichte bei den Erkennungsmodellen eine Latenz, die höchstens 12 % über der von FP16 lag, und verlor bei YOLO26n, YOLO26s, YOLO26m und YOLO26l 1,7 bis 2,9 mAP-Punkte. Auf dieser GPU war es nur bei YOLO26l, YOLO26x und YOLO26n-cls schneller als FP16.
- Die Genauigkeit von YOLO26x INT8 sank in drei Builds auf einen Bereich zwischen 25,3 und 38,5 mAP, gegenüber 57,5 bei FP32. YOLO26n-pose INT8 fiel von 56,7 auf 33,4 Pose-mAP. Überprüfe jede INT8-Engine anhand deiner eigenen Daten, bevor du sie einsetzt.
- Die FP32- und FP16-Engines von TensorRT 10.16 für YOLO26n und YOLO26s erreichten dieselbe Genauigkeit wie mit TensorRT 11.4. Ihre FP16-Engines waren etwa 7 % schneller, ihre FP32-Engines 4 % bis 9 % langsamer als mit TensorRT 11.4.
Informationen zu NVIDIA Jetson und DGX Spark findest du in den Jetson-Benchmarks und im DGX-Spark-Leitfaden.
Gemessen mit ultralytics 8.4.211, TensorRT 11.4.0, PyTorch 2.15.0 und CUDA 13.2 auf batch=1 am 13. November 2026. Die Latenz bezieht sich auf die Inferenzphase, die val meldet, und umfasst weder die Vorverarbeitung noch die Nachverarbeitung.
Über TensorRT#
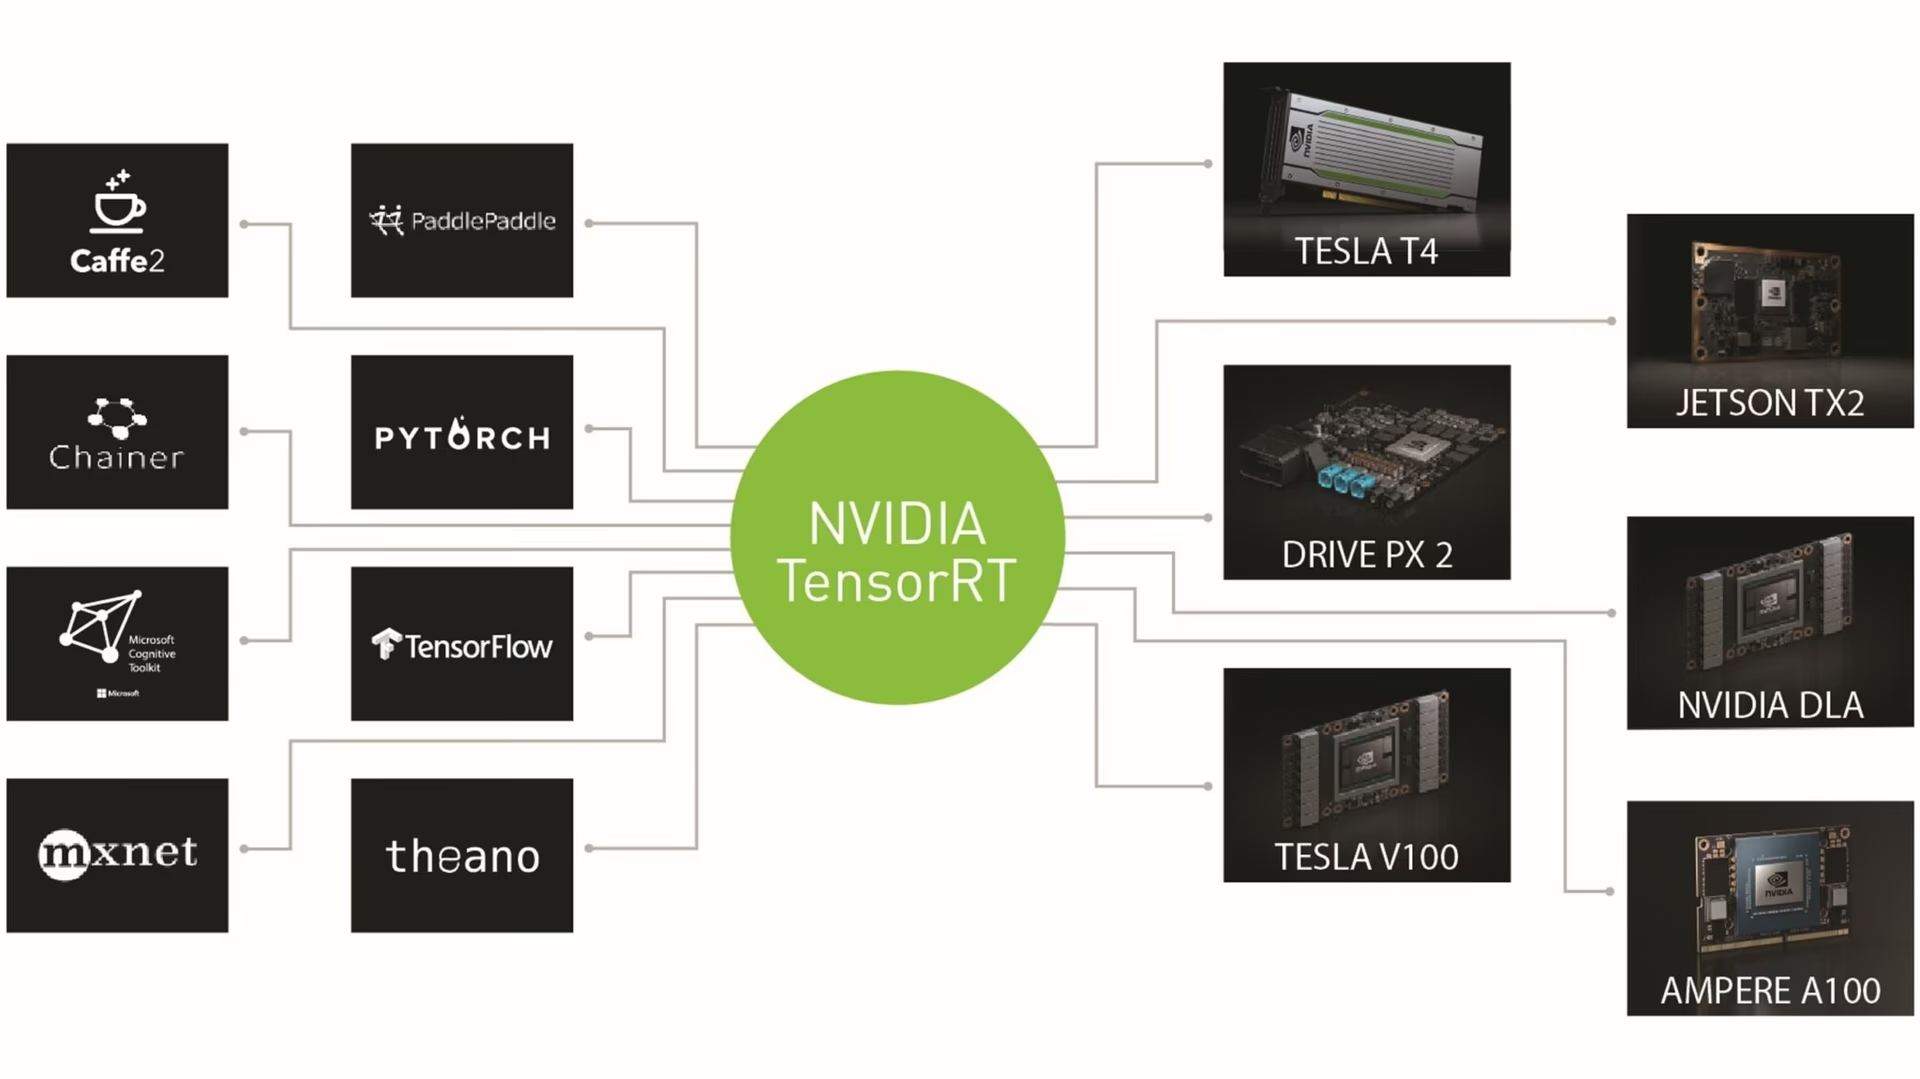
TensorRT erstellt eine Engine, indem es Schichten zusammenführt, für jede Schicht den schnellsten Kernel auf der Build-GPU auswählt und die Genauigkeit optional auf FP16 oder INT8 reduziert. Die vollständige Referenz findest du in der TensorRT-Dokumentation.
Häufig gestellte Fragen#
Nur auf einer GPU desselben Modells mit derselben TensorRT-Version. Eine Engine wird für ein bestimmtes GPU-Modell und eine bestimmte TensorRT-Version erstellt. Wenn du eine Datei auf unterschiedlicher Hardware verwenden möchtest, exportiere das Modell nach ONNX und erstelle die Engine auf jedem Gerät. Für NVIDIA Jetson kann die Ultralytics Platform Engines für acht Jetson-Zielgeräte erstellen.
Beginne mit FP16 (
quantize=16). Dafür sind keine Kalibrierungsdaten erforderlich, und die Genauigkeit von FP32 bleibt erhalten. In den Benchmarks auf einer NVIDIA RTX PRO 6000 Blackwell mit TensorRT 11.4 sank die Latenz von YOLO26s mit FP16 von 1,15 ms auf 0,61 ms pro Bild, bei unverändert 48,5 mAPVal 50-95. INT8 (quantize=8) erreichte 0,66 ms und 46,3 mAPVal 50-95. Auf dieser GPU war INT8 also nicht schneller als FP16 und benötigt repräsentative Kalibrierungsdaten, sofern der Checkpoint nicht mitquantize=8trainiert wurde. Auf anderer Hardware kann sich INT8 lohnen: Die Jetson-Benchmarks enthalten FP16- und INT8-Ergebnisse für eingebettete Geräte. Miss beide Genauigkeiten auf deinem Zielgerät, bevor du dich für INT8 entscheidest.Exportiere das Modell mit
dynamic=Trueund setzebatchauf die größte Batchgröße, die du ausführen möchtest. Die Engine verarbeitet dann Batches von 1 bisbatchsowie Bildgrößen von 32 Pixeln bis zum Doppelten der Exportgrößeimgsz. Für dynamische INT8-Engines auf älteren GPUs gilt eine höhere Mindestgröße. Ohnedynamic=Truehat die Engine eine feste Eingabeform, und Ultralytics teilt jeden Batch auf oder füllt ihn auf, damit er passt.Dynamische Enginefrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", dynamic=True, batch=8, quantize=16) model = YOLO("yolo26n.engine") results = model(["https://ultralytics.com/images/bus.jpg"] * 4, batch=4) # ein Batch mit 4 BildernFühre den Export direkt auf dem Jetson mit der TensorRT-Version deiner JetPack-Version aus. Um einen DLA-Kern zu verwenden, füge
device=dla:0mitquantize=16oderquantize=8hinzu. Informationen zur Einrichtung und zu Benchmarks findest du im NVIDIA-Jetson-Leitfaden.Export auf Jetsonfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="engine", quantize=16) # FP16-Engine auf der Jetson-GPU # Oder erstelle stattdessen die FP16-Engine für DLA-Kern 0 model.export(format="engine", quantize=16, device="dla:0")Der Leitfaden zum Triton Inference Server exportiert das Modell nach ONNX und aktiviert Tritons TensorRT-Beschleuniger in
config.pbtxt. Triton erstellt die TensorRT-Engine dann beim ersten Laden auf der Server-GPU und speichert sie zwischen. So passt die Engine immer zur GPU und TensorRT-Version des Servers. Der Leitfaden behandelt den Aufbau des Modell-Repositorys, den Server-Container und die Inferenz mit Ultralytics über einen Client.


Kommentare116
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
AgbajeAyomipo
Hi Ultralytics team, I’ve trained a YOLOv11 model on (1024x1024) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True) but it fails silently. If I use a dynamic=true without specifying the imgsz parameter, the export succeeds and uses (1024, 1024). My questions:
Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround? Are there ways to improve performance with high-res inference on Jetson Orin Nano? What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1martinmclee
Have you gotten any workaround? Perhaps with the YOLO26?
Hi Ultralytics team, I’ve trained a YOLOv11 model on full-size 5MP (2592x1944) images from a camera feed and now I’m trying to run real-time inference on live streams using a Jetson Orin Nano. I want to maintain full resolution for inference because of accuracy requirements, but currently I'm getting only 1-2 FPS. When I reduce the input size, the FPS improves significantly, but it's not acceptable due to missed detections at lower resolutions. I attempted to export the model to TensorRT using:
model.export(format="engine", imgsz=(2592, 1944), half=True)but it fails silently. If I use a dynamic=true, the export succeeds and uses (1024, 1024). My questions:- Is TensorRT export for such high-resolution input supported/recommended with YOLOv11? If not, is there any known limitation or workaround?
- Are there ways to improve performance with high-res inference on Jetson Orin Nano?
- What hardware would you recommend for real-time inference on 1-3 camera streams with 5MP inputs, assuming we need at least ~15-20 FPS per stream? Device: AAEON BOXER-8621AI Module: NVIDIA® Jetson Orin Nano™ (4GB LPDDR5, Super Mode Enabled) Memory: 4 GB LPDDR5 I/O: USB 3.2 Gen 2, M.2 Expansion Operating System: JetPack 5.1.4 (L4T 35.6.0, Ubuntu 20.04) Use Case: Real-time multi-stream 5MP video inference
1020423lzl
m的模型大小比n大的多,速度也慢了很多,输入图像尺寸越大,越吃显存,速度也越慢
李子乐控制工程 @.***
---Original--- From: @.> Date: Sat, May 9, 2026 10:30 AM To: @.>; Cc: @.@.>; Subject: Re: [ultralytics/ultralytics] zh/integrations/tensorrt/ (Discussion #9868)
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令: yolo export model=yolo11m.pt imgsz=1280 format='engine 推理代码为: model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')
另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
— Reply to this email directly, view it on GitHub, or unsubscribe. Triage notifications on the go with GitHub Mobile for iOS or Android. You are receiving this because you commented.Message ID: @.***>
 User
能不能读完再说话,肯定是m和m比,n和n比,同样尺寸输入和同样尺寸输入的比啊。 该显卡的RT core算力是普通fp32算力的近两倍。
 Glenn JocherUltralytics
是的,性能应当在同一模型、同一
imgsz、同一batch、同一后处理参数下比较;m比n更大、1280比640更吃显存且更慢是正常现象。对 RTX A6000 来说,FP32的 TensorRT 往往不会比.pt明显更快,建议先按 TensorRT 导出文档 用half=True重新导出,并在相同输入上预热后再统计平均耗时;如果engine与.pt结果仍明显不一致,请贴出!yolo checks、完整控制台日志文本和一个最小可复现示例,我们好继续排查环境或后处理差异。
- User
现在有一个奇怪的现象,我导出的tensorrt模型的推理速度几乎和原来的.pt几乎没有差别甚至更慢,并且导出的tensorrt模型的推理结果和.pt模型的差别很大。 我的设备是i914900k+64G RAM+RTX A6000 我的环境是cuda12.4.131+tensorrt10.10.0.31+torch2.5.1+ultralytics8.3.252 导出命令:
yolo export model=yolo11m.pt imgsz=1280 format='engine推理代码为:model.predict(stream_path, imgsz=1280, classes=[14], conf=0.2, iou=0.5, stream=True, task='detect')另外我试了下yolo11n.pt的640输入尺寸导出,推理速度就有明显提升,当然推理结果差别仍然较大。 请问这是什么道理,有什么解决办法?
etson@yahboom:~/ultralytics/ultralytics$ yolo predict model=best.engine source=0 save=False show WARNING ⚠️ Unable to automatically guess model task, assuming 'task=detect'. Explicitly define task for your model, i.e. 'task=detect', 'segment', 'classify','pose' or 'obb'. Ultralytics 8.3.172 🚀 Python-3.10.12 torch-2.5.0a0+872d972e41.nv24.08 CUDA:0 (Orin, 7620MiB) Loading best.engine for TensorRT inference... [12/18/2025-17:11:05] [TRT] [I] Loaded engine size: 75 MiB [12/18/2025-17:11:05] [TRT] [I] [MS] Running engine with multi stream info [12/18/2025-17:11:05] [TRT] [I] [MS] Number of aux streams is 7 [12/18/2025-17:11:05] [TRT] [I] [MS] Number of total worker streams is 8 [12/18/2025-17:11:05] [TRT] [I] [MS] The main stream provided by execute/enqueue calls is the first worker stream [12/18/2025-17:11:05] [TRT] [I] [MemUsageChange] TensorRT-managed allocation in IExecutionContext creation: CPU +1, GPU +88, now: CPU 1, GPU 158 (MiB)
[ WARN:0@2.771] global cap_gstreamer.cpp:1777 open OpenCV | GStreamer warning: Cannot query video position: status=0, value=-1, duration=-1 1/1: 0... Success ✅ (inf frames of shape 1920x1080 at 5.00 FPS)
Traceback (most recent call last): File "/home/jetson/.local/bin/yolo", line 7, in sys.exit(entrypoint()) File "/home/jetson/Downloads/ultralytics-main/ultralytics/cfg/init.py", line 983, in entrypoint getattr(model, mode)(**overrides) # default args from model File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/model.py", line 555, in predict return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 247, in predict_cli for _ in gen: # sourcery skip: remove-empty-nested-block, noqa File "/usr/local/lib/python3.10/dist-packages/torch/utils/_contextlib.py", line 36, in generator_context response = gen.send(None) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 351, in stream_inference s[i] += self.write_results(i, Path(paths[i]), im, s) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/predictor.py", line 434, in write_results string += f"{result.verbose()}{result.speed['inference']:.1f}ms" File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in verbose return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) File "/home/jetson/Downloads/ultralytics-main/ultralytics/engine/results.py", line 694, in return "".join(f"{n} {self.names[i]}{'s' * (n > 1)}, " for i, n in enumerate(counts) if n > 0) KeyError: 171 terminate called without an active exception Aborted (core dumped) jetson@yahboom:~/ultralytics/ultralytics$ How to solve it
- Glenn JocherUltralytics
KeyError: 171表示模型输出了类别171,但当前names里没有这个索引(通常是自定义数据集的标签类别编号不在0..nc-1范围内、data.yaml里的names数量与nc不匹配,或导出/推理用的模型与数据配置不一致导致的元数据错配);请先把所有标注.txt的 class id 修正为连续的0..nc-1,同步修正data.yaml的nc/names,修正后删除数据集labels/下的*.cache,再用同一套环境从best.pt重新导出.engine(参考 TensorRT 导出文档),并在推理时显式加上task=detect。另外请把下面命令的完整输出(文本)贴在这个 discussion 里,以及你当时的导出命令,方便我们确认是否有多环境/路径冲突:yolo checks Thank you for your reply. The issue has been resolved. I was using the RT-DETR model, but I mistakenly used "from ultralytics import YOLO" when exporting
- Glenn JocherUltralytics
Glad you found it — RT-DETR models should be loaded/exported with
RTDETR(...)(mixing them withYOLO(...)can produce mismatched metadata likenames), see the RT-DETR model docs for details:from ultralytics import RTDETR model = RTDETR("best.pt") model.export(format="engine") # creates best.engine
fly2skyToEnjoy
May I ask : The following command exports the file, whether the box and mask are both nmsed at the same time ???
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("yolo11n.pt")
Export the model to TensorRT format
model.export(format="engine") # creates 'yolo11n.engine'
Load the exported TensorRT model
tensorrt_model = YOLO("yolo11n.engine")
Run inference
results = tensorrt_model("https://ultralytics.com/images/bus.jpg")
AK993
这个方法适用于rt-detr吗
dilanpatel195
I am trying to prediction model for the YOLOv11n-seg, I have exported the .py to .engine to back it run faster but keep getting a KEY error message:
KeyError Traceback (most recent call last) Cell In[4], line 109 106 # Inside the main loop after grabbing a frame 107 if inference_active and not inpainting_active: 108 # Perform YOLO inference --> 109 results = model(rgb_frame)[0] 110 masked_image = rgb_frame.copy() # Make a copy for masking 112 # Process YOLO masks (original functionality remains unchanged)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:176, in Model.call(self, source, stream, **kwargs) 147 def call( 148 self, 149 source: Union[str, Path, int, Image.Image, list, tuple, np.ndarray, torch.Tensor] = None, 150 stream: bool = False, 151 **kwargs, 152 ) -> list: 153 """ 154 Alias for the predict method, enabling the model instance to be callable for predictions. 155 (...) 174 ... print(f"Detected {len(r)} objects in image") 175 """ --> 176 return self.predict(source, stream, **kwargs)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\model.py:554, in Model.predict(self, source, stream, predictor, **kwargs) 552 if prompts and hasattr(self.predictor, "set_prompts"): # for SAM-type models 553 self.predictor.set_prompts(prompts) --> 554 return self.predictor.predict_cli(source=source) if is_cli else self.predictor(source=source, stream=stream)
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:168, in BasePredictor.call(self, source, model, stream, *args, **kwargs) 166 return self.stream_inference(source, model, *args, **kwargs) 167 else: --> 168 return list(self.stream_inference(source, model, *args, **kwargs))
File c:\ProgramData\miniconda3\Lib\site-packages\torch\utils_contextlib.py:36, in _wrap_generator..generator_context(*args, **kwargs) 33 try: 34 # Issuing None to a generator fires it up 35 with ctx_factory(): ---> 36 response = gen.send(None) 38 while True: 39 try: 40 # Forward the response to our caller and get its next request
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:274, in BasePredictor.stream_inference(self, source, model, *args, **kwargs) 268 self.results[i].speed = { 269 "preprocess": profilers[0].dt * 1e3 / n, 270 "inference": profilers[1].dt * 1e3 / n, 271 "postprocess": profilers[2].dt * 1e3 / n, 272 } 273 if self.args.verbose or self.args.save or self.args.save_txt or self.args.show: --> 274 s[i] += self.write_results(i, Path(paths[i]), im, s) 276 # Print batch results 277 if self.args.verbose:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\predictor.py:334, in BasePredictor.write_results(self, i, p, im, s) 332 result = self.results[i] 333 result.save_dir = self.save_dir.str() # used in other locations --> 334 string += f"{result.verbose()}{result.speed['inference']:.1f}ms" 336 # Add predictions to image 337 if self.args.save or self.args.show:
File c:\ProgramData\miniconda3\Lib\site-packages\ultralytics\engine\results.py:663, in Results.verbose(self) 661 for c in boxes.cls.unique(): 662 n = (boxes.cls == c).sum() # detections per class --> 663 log_string += f"{n} {self.names[int(c)]}{'s' * (n > 1)}, " 664 return log_string
KeyError: 2
Any help would be greatly appreciated!
Ranjith3436
Now, My TensorRT Sengment model used for track. if any detections not there the processing FPS is 75-80 in jetson. But once the person or people detected suddenly reused to 15-20. processing time going to 40ms. only when the object detected. What's the issue in model.track(), could i run all the tracking thing on GPU.
- Glenn JocherUltralytics(bearbeitet)
@Ranjith3436 the performance drop when objects are detected is expected behavior, as tracking introduces additional computational overhead. When objects are detected, the model.track() method performs several CPU-bound operations including feature extraction, association, and trajectory management.
To improve performance:
- Try using a smaller model variant (like YOLO26n-seg instead of larger variants)
- Consider reducing the image resolution for tracking
- Optimize tracking parameters by setting
persist=Trueand adjustingconfthresholds higher to track fewer objects - Use
half=True(FP16) orint8=Truewhen exporting your model to TensorRT for maximum GPU acceleration
For the tracking components specifically, the BoT-SORT or ByteTrack algorithms used by Ultralytics do have some CPU-bound operations, but you can minimize their impact with the above optimizations. For more details on tracking optimization, check our tracking documentation.
1
I convert Classification model that i retrained. But it throw the error "amax(): Expected reduction dim 1 to have non-zero size."
- Glenn JocherUltralytics
@Ranjith3436 this error typically occurs when TensorRT encounters an empty dimension during model conversion. For classification models, this could happen if:
- Your model architecture was modified or if you're using a custom architecture
- There might be an issue with batch normalization layers during export
- The class count in your retrained model might be causing dimension mismatches
Try these solutions:
- Ensure your model's forward pass works correctly before export
- Try exporting with
simplify=Falseto preserve the original graph structure - Check if your classification model has the correct output dimension for your number of classes
If the issue persists, share more details about your model architecture and export command for better assistance. For more guidance, refer to our TensorRT integration documentation.
The model trained use yolov8l-cls.pt and the error come from jetson device.
(model): ClassificationModel( (model): Sequential( (0): Conv( (conv): Conv2d(3, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (1): Conv( (conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (2): C2f( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(320, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (3): Conv( (conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (4): C2f( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(1024, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (5): Conv( (conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (6): C2f( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2048, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-5): 6 x Bottleneck( (cv1): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (7): Conv( (conv): Conv2d(512, 1024, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (8): C2f( (cv1): Conv( (conv): Conv2d(1024, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(2560, 1024, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (m): ModuleList( (0-2): 3 x Bottleneck( (cv1): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (cv2): Conv( (conv): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) (bn): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) ) ) ) (9): Classify( (conv): Conv( (conv): Conv2d(1024, 1280, kernel_size=(1, 1), stride=(1, 1), bias=False) (bn): BatchNorm2d(1280, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True) (act): SiLU(inplace=True) ) (pool): AdaptiveAvgPool2d(output_size=1) (drop): Dropout(p=0.0, inplace=True) (linear): Linear(in_features=1280, out_features=2, bias=True) ) ) ) )
model architecture
This error sorted out