Aus einem YOLO26-Modell in das TF.js-Modellformat exportieren#
Seit Ultralytics 8.4.83 wurde das Exportformat tfjs (TensorFlow.js) entfernt und durch das einheitliche Format Google LiteRT ersetzt. LiteRT läuft im Browser über LiteRT.js (mit WebGPU-Beschleunigung) und deckt damit die vom TF.js unterstützten Anwendungsfälle im Browser und mit Node.js sowie Mobilgeräte, eingebettete Systeme und Edge-Geräte ab – mit einem einzigen .tflite-Modell.
format="tfjs" funktioniert weiterhin, gibt jedoch eine Warnung zur Einstellung aus und exportiert stattdessen ein LiteRT-Modell. Verwende künftig format="litert". Die aktuellen Exportanweisungen und den Bereitstellungsweg für Browser findest du in der LiteRT-Exportanleitung.
Die direkte Bereitstellung von Modellen für maschinelles Lernen im Browser oder mit Node.js kann schwierig sein. Du musst darauf achten, dass dein Modellformat für eine höhere Leistung optimiert ist, damit das Modell interaktive Anwendungen lokal auf dem Gerät des Nutzers ausführen kann. Das TensorFlow.js- oder TF.js-Modellformat wurde so entwickelt, dass es wenig Energie verbraucht und zugleich eine hohe Leistung bietet.
Mit der Funktion „In das TF.js-Modellformat exportieren“ kannst du deine Ultralytics YOLO26-Modelle für eine schnelle, lokal ausgeführte Objekterkennung optimieren. In dieser Anleitung zeigen wir dir, wie du deine Modelle in das TF.js-Format konvertierst, damit sie in verschiedenen lokalen Browsern und Node.js-Anwendungen gute Leistung erbringen.
Warum solltest du in das TF.js-Format exportieren?#
Der Export deiner Modelle für maschinelles Lernen in TensorFlow.js, das vom TensorFlow-Team als Teil des umfassenderen TensorFlow-Ökosystems entwickelt wurde, bietet zahlreiche Vorteile für die Bereitstellung von Anwendungen für maschinelles Lernen. Er verbessert den Datenschutz und die Sicherheit der Nutzer, indem vertrauliche Daten auf dem Gerät bleiben. Die folgende Abbildung zeigt die TensorFlow.js-Architektur und wie Modelle für maschinelles Lernen konvertiert und sowohl in Webbrowsern als auch mit Node.js bereitgestellt werden.
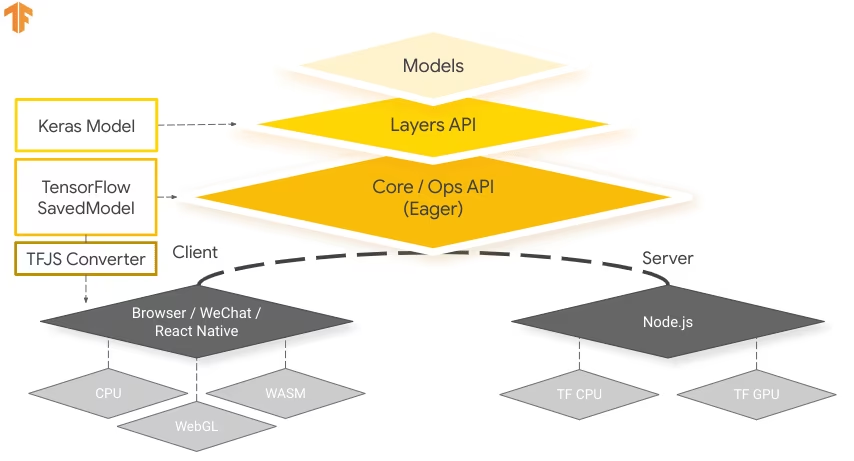
Die lokale Ausführung von Modellen verringert außerdem die Latenz und sorgt für ein reaktionsschnelleres Nutzungserlebnis. TensorFlow.js bietet auch Offline-Funktionen, sodass Nutzer deine Anwendung selbst ohne Internetverbindung verwenden können. TF.js wurde für die effiziente Ausführung komplexer Modelle auf Geräten mit begrenzten Ressourcen entwickelt und ist auf Skalierbarkeit ausgelegt; außerdem unterstützt es GPU-Beschleunigung.
Wichtige Funktionen von TF.js#
Hier sind die wichtigsten Funktionen, die TF.js zu einem leistungsstarken Werkzeug für Entwickler machen:
-
Plattformübergreifende Unterstützung: TensorFlow.js kann sowohl in Browsern als auch in Node.js-Umgebungen verwendet werden und bietet so Flexibilität bei der Bereitstellung auf verschiedenen Plattformen. Damit können Entwickler Anwendungen einfacher erstellen und bereitstellen.
-
Unterstützung mehrerer Backends: TensorFlow.js unterstützt verschiedene Backends für Berechnungen, darunter CPU, WebGL für GPU-Beschleunigung, WebAssembly (WASM) für eine nahezu native Ausführungsgeschwindigkeit und WebGPU für erweiterte Funktionen des maschinellen Lernens im Browser.
-
Offline-Funktionen: Mit TensorFlow.js können Modelle ohne Internetverbindung im Browser ausgeführt werden. So lassen sich Anwendungen entwickeln, die auch offline funktionieren.
Bereitstellungsoptionen mit TensorFlow.js#
Bevor wir den Export von YOLO26-Modellen in das TF.js-Format näher betrachten, sehen wir uns einige typische Bereitstellungsszenarien für dieses Format an.
TF.js bietet verschiedene Möglichkeiten, deine Modelle für maschinelles Lernen bereitzustellen:
-
Anwendungen für maschinelles Lernen im Browser: Du kannst Webanwendungen erstellen, die Modelle für maschinelles Lernen direkt im Browser ausführen. Dadurch entfällt die Notwendigkeit serverseitiger Berechnungen und die Serverlast sinkt.
-
Node.js-Anwendungen: TensorFlow.js unterstützt auch die Bereitstellung in Node.js-Umgebungen und ermöglicht so die Entwicklung serverseitiger Anwendungen für maschinelles Lernen. Das ist besonders nützlich für Anwendungen, die Rechenleistung eines Servers oder Zugriff auf serverseitige Daten benötigen.
-
Chrome-Erweiterungen: Ein interessantes Bereitstellungsszenario ist die Entwicklung von Chrome-Erweiterungen mit TensorFlow.js. Du kannst beispielsweise eine Erweiterung entwickeln, mit der Nutzer per Rechtsklick ein Bild auf einer beliebigen Webseite mithilfe eines vortrainierten ML-Modells klassifizieren können. TensorFlow.js lässt sich in alltägliche Webbrowser-Erlebnisse integrieren, um unmittelbare Erkenntnisse oder Erweiterungen auf Grundlage maschinellen Lernens bereitzustellen.
YOLO26-Modelle in TensorFlow.js exportieren#
Du kannst die Modellkompatibilität und Flexibilität bei der Bereitstellung erweitern, indem du YOLO26-Modelle in TF.js konvertierst.
Installation#
Führe zum Installieren des erforderlichen Pakets Folgendes aus:
# Install the required package for YOLO26
pip install ultralytics
Ausführliche Anweisungen und bewährte Vorgehensweisen zur Installation findest du in unserer Installationsanleitung von Ultralytics. Falls bei der Installation der für YOLO26 erforderlichen Pakete Probleme auftreten, findest du Lösungen und Tipps in unserer Anleitung zu häufigen Problemen.
Verwendung#
Alle Ultralytics YOLO26-Modelle sind so ausgelegt, dass sie sofort exportiert werden können. Dadurch lassen sie sich problemlos in deinen bevorzugten Bereitstellungsablauf integrieren. In der vollständigen Liste der unterstützten Exportformate und Konfigurationsoptionen findest du die passende Konfiguration für deine Anwendung.
Das Argument tfjs exportiert jetzt ein LiteRT-.tflite-Modell, das lokal die Modi Export, Predict und Validate unterstützt und über LiteRT.js im Browser läuft. Den aktuellen Bereitstellungsweg für Browser und Geräte findest du in der LiteRT-Exportanleitung.
from ultralytics import YOLO

# Ein YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Das Modell in das LiteRT-Format exportieren (ersetzt TF.js)
model.export(format="litert", imgsz=640) # für die Klassifizierung imgsz=224 verwendenDas exportierte LiteRT-.tflite-Modell lässt sich direkt mit yolo predict und yolo val laden und läuft über LiteRT.js im Browser. Siehe die LiteRT-Exportanleitung.
Exportargumente#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
format | str | 'litert' | Zielformat für das exportierte Modell; der veraltete Wert 'tfjs' exportiert LiteRT. |
imgsz | int oder tuple | 640 | Gewünschte Bildgröße für die Modelleingabe. Kann eine Ganzzahl für quadratische Bilder oder ein Tupel (height, width) für bestimmte Abmessungen sein. |
quantize | int oder str | None | Quantisierungsgenauigkeit: 8 (statisches INT8, INT8-Gewichte + INT8-Aktivierungen; benötigt Kalibrierung data/fraction), 'w8a16' (statisch, INT8-Gewichte + INT16-Aktivierungen; benötigt Kalibrierung data/fraction), 'w8a32' (dynamisches INT8, INT8-Gewichte + FP32-Aktivierungen; keine Kalibrierung erforderlich) oder 32/nicht festgelegt (FP32). FP16 wird nicht separat exportiert – ein FP32-Modell wird auf GPU-Delegaten automatisch mit FP16 ausgeführt. Ersetzt die veralteten Flags half/int8. |
batch | int | 1 | Gibt die Batchgröße für die Inferenz des Exportmodells oder die Höchstzahl der Bilder an, die das exportierte Modell gleichzeitig im predict-Modus verarbeiten kann. |
data | str | None | Pfad zur YAML-Datei des Datensatzes, die für die Quantisierung erforderlich ist; bei der Klassifizierung wird stattdessen ein Datensatzverzeichnis oder der Name eines integrierten Datensatzes verwendet. Wenn die Angabe bei quantize=8 oder 'w8a16' fehlt, wählt Ultralytics den standardmäßigen Kalibrierungsdatensatz für die Modellaufgabe aus. |
fraction | float, int oder list | 1.0 | Kalibrierungsteilstichprobe als Verhältnis, Bildanzahl oder [train, val, test]-Verhältnisse/-Anzahlen. Bei Listen mit zwei Elementen bleibt test vollständig erhalten, während 0 es überspringt. |
device | str | None | Gibt das Gerät für den Export an: CPU (device=cpu), MPS für Apple-Chips (device=mps). |
Weitere Informationen zum Exportvorgang findest du auf der Ultralytics-Dokumentationsseite zum Export.
Exportierte YOLO26-TensorFlow.js-Modelle bereitstellen#
Nachdem du dein YOLO26-Modell exportiert hast, besteht der nächste Schritt darin, es bereitzustellen. Beim Export entsteht ein LiteRT-.tflite-Modell, das auf dem Gerät und über LiteRT.js im Browser läuft. Den aktuellen Bereitstellungsweg findest du in der LiteRT-Exportanleitung.
Als Referenz findest du hier die Ressourcen zur älteren TensorFlow.js-Laufzeitumgebung:
-
Chrome-Erweiterung: In der Entwicklerdokumentation erfährst du, wie du deine TF.js-Modelle in einer Chrome-Erweiterung bereitstellst.
-
TensorFlow.js mit Node.js ausführen: Ein TensorFlow-Blogbeitrag zur direkten Ausführung von TensorFlow.js mit Node.js.
-
TensorFlow.js bereitstellen – Node-Projekt auf einer Cloud-Plattform: Ein TensorFlow-Blogbeitrag zur Bereitstellung eines TensorFlow.js-Modells auf einer Cloud-Plattform.
Zusammenfassung#
In dieser Anleitung haben wir gelernt, wie du Ultralytics YOLO26-Modelle in das TensorFlow.js-Format exportierst. Durch den Export in TF.js kannst du deine YOLO26-Modelle flexibel optimieren, bereitstellen und auf einer Vielzahl von Plattformen skalieren.
Weitere Informationen zur Verwendung findest du in der offiziellen Dokumentation zu TensorFlow.js.
Weitere Informationen zur Integration von Ultralytics YOLO26 mit anderen Plattformen und Frameworks findest du auf unserer Seite mit Integrationsanleitungen. Dort findest du zahlreiche hilfreiche Ressourcen, mit denen du das Beste aus YOLO26 in deinen Projekten herausholen kannst.
Häufig gestellte Fragen#
Der Export von Ultralytics YOLO26-Modellen in das TensorFlow.js-Format (TF.js) ist ganz einfach. Folge einfach diesen Schritten:
Verwendungfrom ultralytics import YOLO # Ein YOLO26-Modell laden model = YOLO("yolo26n.pt") # Das Modell in das LiteRT-Format exportieren (ersetzt TF.js) model.export(format="litert", imgsz=640) # für die Klassifizierung imgsz=224 verwenden # Das exportierte Modell „.tflite“ läuft über LiteRT.js im Browser oder lokal mit yolo predict/val.Weitere Informationen zu den unterstützten Exportoptionen findest du auf der Ultralytics-Dokumentationsseite zu Bereitstellungsoptionen.
Der Export von YOLO26-Modellen in TensorFlow.js bietet mehrere Vorteile, darunter:
- Lokale Ausführung: Modelle können direkt im Browser oder mit Node.js ausgeführt werden. Das verringert die Latenz und verbessert das Nutzungserlebnis.
- Plattformübergreifende Unterstützung: TF.js unterstützt mehrere Umgebungen und bietet dadurch Flexibilität bei der Bereitstellung.
- Offline-Funktionen: Anwendungen können ohne Internetverbindung ausgeführt werden, was Zuverlässigkeit und Datenschutz gewährleistet.
- GPU-Beschleunigung: Nutzt WebGL zur GPU-Beschleunigung und optimiert so die Leistung auf Geräten mit begrenzten Ressourcen.
TensorFlow.js wurde speziell für die effiziente Ausführung von ML-Modellen in Browsern und Node.js-Umgebungen entwickelt. Anwendungen im Browser profitieren davon folgendermaßen:
- Verringert die Latenz: Führt Modelle für maschinelles Lernen lokal aus und liefert sofortige Ergebnisse, ohne auf serverseitige Berechnungen angewiesen zu sein.
- Verbessert den Datenschutz: Vertrauliche Daten bleiben auf dem Gerät des Nutzers, wodurch Sicherheitsrisiken minimiert werden.
- Ermöglicht die Offline-Nutzung: Modelle funktionieren ohne Internetverbindung und gewährleisten so einen zuverlässigen Betrieb.
- Unterstützt mehrere Backends: Bietet Flexibilität mit Backends wie CPU, WebGL, WebAssembly (WASM) und WebGPU für unterschiedliche Rechenanforderungen.
Möchtest du mehr über TF.js erfahren? Sieh dir die offizielle TensorFlow.js-Anleitung an.
Zu den wichtigsten Funktionen von TensorFlow.js gehören:
- Plattformübergreifende Unterstützung: TF.js kann sowohl in Webbrowsern als auch mit Node.js verwendet werden und bietet umfassende Flexibilität bei der Bereitstellung.
- Mehrere Backends: Unterstützt CPU, WebGL für GPU-Beschleunigung, WebAssembly (WASM) und WebGPU für anspruchsvolle Vorgänge.
- Offline-Funktionen: Modelle können direkt im Browser ohne Internetverbindung ausgeführt werden. Damit eignet sich TF.js ideal für die Entwicklung reaktionsschneller Webanwendungen.
Informationen zu Bereitstellungsszenarien und weitere Einzelheiten findest du in unserem Abschnitt zu Bereitstellungsoptionen mit TensorFlow.js.
Ja, mit TensorFlow.js kannst du YOLO26-Modelle in Node.js-Umgebungen bereitstellen. So lassen sich serverseitige Anwendungen für maschinelles Lernen entwickeln, die von der Rechenleistung eines Servers und dem Zugriff auf serverseitige Daten profitieren. Typische Anwendungsfälle sind die Echtzeitverarbeitung von Daten und ML-Pipelines auf Backend-Servern.
Die Anleitung von TensorFlow unter TensorFlow.js mit Node.js ausführen hilft dir beim Einstieg in die Bereitstellung mit Node.js.