RT-DETR von Baidu: Ein auf einem Vision-Transformer basierender Echtzeit-Objektdetektor#
Übersicht#
Der Echtzeit-Detektions-Transformer (RT-DETR), entwickelt von Baidu, ist ein hochmoderner, durchgängiger Objektdetektor, der Echtzeit-Leistung bei gleichzeitig hoher Genauigkeit bietet. Er basiert auf der Idee von DETR (dem NMS-freien Framework) und führt zugleich ein konvolutionsbasiertes Backbone sowie einen effizienten hybriden Encoder ein, um Echtzeitgeschwindigkeit zu erreichen. RT-DETR verarbeitet Merkmale verschiedener Maßstäbe effizient, indem die Interaktion innerhalb eines Maßstabs von der Fusion über mehrere Maßstäbe hinweg entkoppelt wird. Das Modell ist sehr anpassungsfähig und unterstützt die flexible Anpassung der Inferenzgeschwindigkeit über verschiedene Decoder-Schichten, ohne dass ein erneutes Training erforderlich ist. RT-DETR zeichnet sich auf beschleunigten Backends wie CUDA mit TensorRT aus und übertrifft viele andere Echtzeit-Objektdetektoren.
Ansehen: So verwendest du Baidus RT-DETR zur Objekterkennung | Inferenz und Leistungsmessung mit Ultralytics 🚀
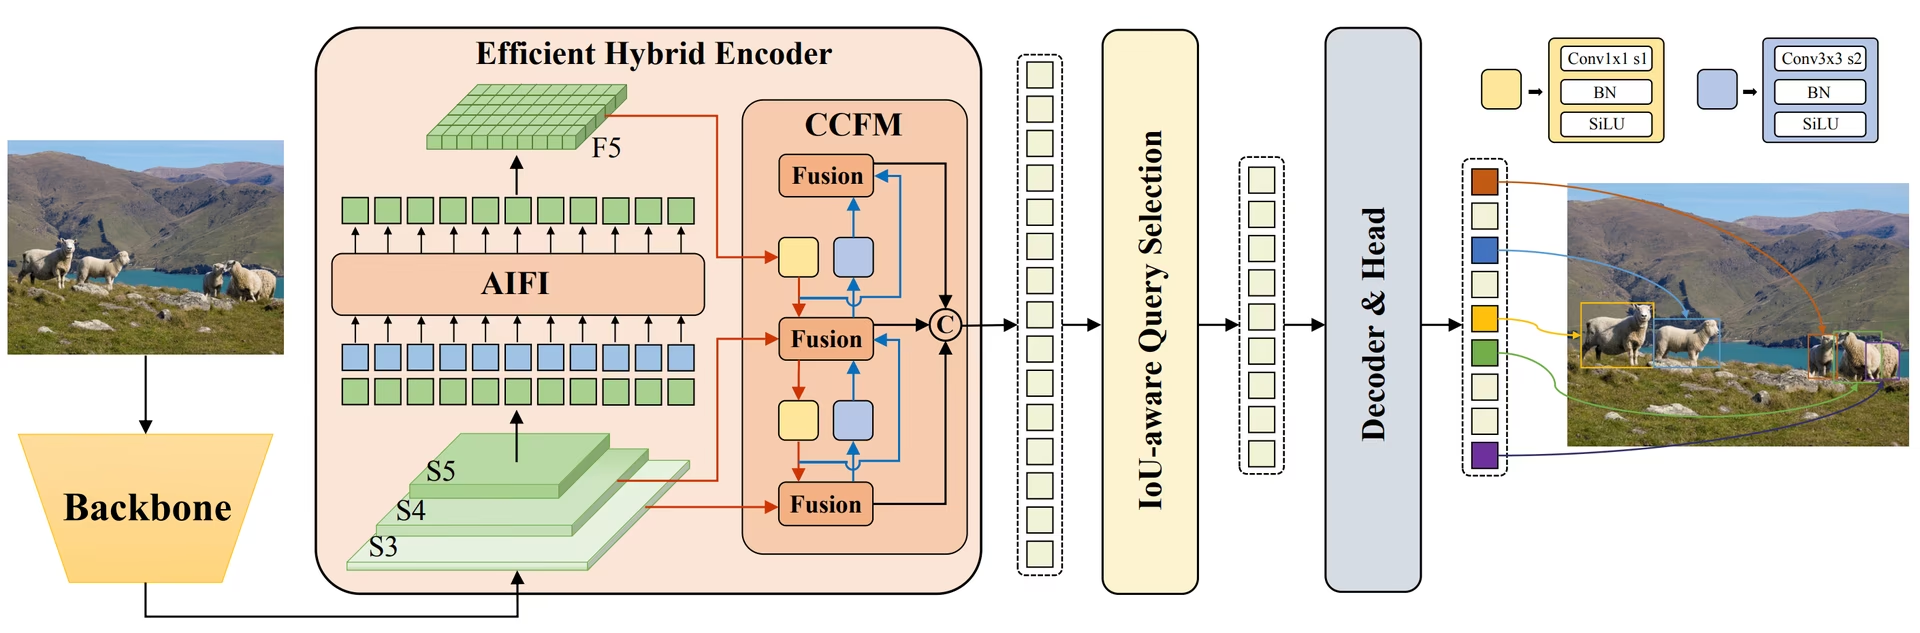 Übersicht über Baidus RT-DETR. Das Diagramm der RT-DETR-Modellarchitektur zeigt die letzten drei Stufen des Backbones {S3, S4, S5} als Eingabe für den Encoder. Der effiziente hybride Encoder wandelt Merkmale verschiedener Maßstäbe durch die Interaktion von Merkmalen innerhalb eines Maßstabs (AIFI) und das Modul zur Fusion von Merkmalen über mehrere Maßstäbe hinweg (CCFM) in eine Sequenz von Bildmerkmalen um. Die IoU-gestützte Auswahl von Abfragen wählt eine feste Anzahl von Bildmerkmalen als anfängliche Objektabfragen für den Decoder aus. Schließlich optimiert der Decoder mit zusätzlichen Vorhersageköpfen die Objektabfragen iterativ, um Boxen und Konfidenzwerte zu erzeugen (Quelle).
Wichtige Funktionen#
- Effizienter hybrider Encoder: RT-DETR von Baidu verwendet einen effizienten hybriden Encoder, der Merkmale verschiedener Maßstäbe verarbeitet, indem er die Interaktion innerhalb eines Maßstabs von der Fusion über mehrere Maßstäbe hinweg entkoppelt. Dieses einzigartige, auf Vision Transformers basierende Design senkt den Rechenaufwand und ermöglicht die Objekterkennung in Echtzeit.
- IoU-gestützte Auswahl von Abfragen: RT-DETR von Baidu verbessert die Initialisierung von Objektabfragen durch eine IoU-gestützte Auswahl von Abfragen. Dadurch kann sich das Modell auf die relevantesten Objekte in der Szene konzentrieren und die Erkennungsgenauigkeit erhöhen.
- Anpassbare Inferenzgeschwindigkeit: RT-DETR von Baidu unterstützt die flexible Anpassung der Inferenzgeschwindigkeit durch verschiedene Decoder-Schichten, ohne dass ein erneutes Training erforderlich ist. Diese Anpassungsfähigkeit erleichtert den praktischen Einsatz in verschiedenen Szenarien der Echtzeit-Objekterkennung.
- NMS-freies Framework: RT-DETR basiert auf DETR und macht eine Nachbearbeitung durch Non-Maximum Suppression überflüssig. Das vereinfacht die Erkennungspipeline und kann die Effizienz verbessern.
- Ankerfreie Erkennung: Als ankerfreier Detektor vereinfacht RT-DETR den Erkennungsprozess und kann die Verallgemeinerungsfähigkeit auf verschiedene Datensätze verbessern.
Vortrainierte Modelle#
Die Ultralytics Python-API stellt vortrainierte PaddlePaddle-RT-DETR-Modelle in verschiedenen Größen bereit:
- RT-DETR-L: 53,0 % AP auf COCO val2017, 114 FPS auf einer T4-GPU
- RT-DETR-X: 54,8 % AP auf COCO val2017, 74 FPS auf einer T4-GPU
Außerdem veröffentlichte Baidu im Juli 2024 RTDETRv2, das die ursprüngliche Architektur mit verbesserten Leistungskennzahlen weiter optimiert.
Anwendungsbeispiele#
Dieses Beispiel enthält einfache Beispiele für das Training und die Inferenz mit RT-DETR. Die vollständige Dokumentation zu diesen und weiteren Modi findest du auf den Dokumentationsseiten zu Vorhersage, Training, Validierung und Export. Modelle können auch auf Cloud-GPUs über die Ultralytics-Plattform trainiert werden.
from ultralytics import RTDETR

# Ein auf COCO vortrainiertes RT-DETR-l-Modell laden
model = RTDETR("rtdetr-l.pt")

# Modellinformationen anzeigen (optional)
model.info()

# Das Modell 100 Epochen lang mit dem COCO8-Beispieldatensatz trainieren
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Mit dem RT-DETR-l-Modell eine Inferenz für das Bild „bus.jpg“ ausführen
results = model("path/to/bus.jpg")Setze deterministic=False, wenn du RT-DETR mit CUDA und PyTorch 2.0 oder höher trainierst. Die deformierbare Attention verwendet F.grid_sample, für das kein deterministischer CUDA-Backward-Pass verfügbar ist. Daher kann deterministic=True den Lauf nicht reproduzierbar machen und den Trainingsdurchsatz verringern. seed steuert weiterhin die Initialisierung der Gewichte, die Datenreihenfolge und die Auswahl der Augmentierungen.
Die vortrainierten RT-DETR-Gewichte unterstützen zwei Einstellungen zur Verringerung der Latenz während der Inferenz, ohne dass ein erneutes Training erforderlich ist:
eval_idx: Beende das Decoding früher. Verwende beim standardmäßigen Decoder mit 6 Schichten einen nullbasierten Index (0–5).eval_idx=5verwendet alle Schichten;eval_idx=3verwendet 4 Schichten. Auf einer T4-GPU mit TensorRT v10.11 verbessert sich RT-DETR-L von 8,0 ms / 52,7 mAP auf 7,4 ms / 52,5 mAP mit 4 Schichten.num_queries: Verringere die Anzahl der Objektabfragen (Standard: 300). Eine Verringerung auf 100 kann COCO in derselben Konfiguration auf 7,4 ms / 51,7 mAP beschleunigen. Bei Datensätzen mit weniger Objekten pro Bild ist der Rückgang von mAP normalerweise geringer; der Wert sollte jedoch über der maximal erwarteten Objektanzahl pro Bild liegen.
Beide Einstellungen können mAP verringern – prüfe die Abwägung anhand deines Datensatzes, bevor du das Modell einsetzt.
from ultralytics import RTDETR

rtdetr = RTDETR("rtdetr-l.pt")
head = rtdetr.model.model[-1]

# Wähle nach Prüfung des Verhältnisses zwischen Geschwindigkeit und Genauigkeit eine oder beide Einstellungen aus.
head.decoder.eval_idx = 3  # 4 von 6 Decoder-Schichten verwenden.
head.num_queries = 100  # Weniger Objektabfragen verwenden.

results = rtdetr("path/to/image.jpg")

# Beim Export werden dieselben Decoder- und Abfrageeinstellungen verwendet, auch bei TensorRT-Exporten.
rtdetr.export(format="engine", device=0, quantize=16)
Unterstützte Aufgaben und Modi#
Diese Tabelle zeigt die Modelltypen, die jeweiligen vortrainierten Gewichte, die von jedem Modell unterstützten Aufgaben sowie die unterstützten Modi (Training, Validierung, Vorhersage, Export), die durch ✅-Emojis gekennzeichnet sind.
| Modelltyp | Vortrainierte Gewichte | Unterstützte Aufgaben | Training | Validierung | Inferenz | Exportieren |
|---|---|---|---|---|---|---|
| RT-DETR Large | rtdetr-l.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
| RT-DETR Extra-Large | rtdetr-x.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
rtdetr-resnet50.yaml und rtdetr-resnet101.yaml werden nur als YAML-Architekturen bereitgestellt. Ultralytics veröffentlicht vortrainierte Gewichte nur für rtdetr-l und rtdetr-x. Erstelle Instanzen der ResNet-Varianten aus YAML (zum Beispiel RTDETR("rtdetr-resnet50.yaml")) und trainiere oder feinabstimme sie nach Bedarf.
Ideale Anwendungsfälle#
RT-DETR eignet sich besonders gut für Anwendungen, die sowohl hohe Genauigkeit als auch Echtzeit-Leistung erfordern:
- Autonomes Fahren: Für eine zuverlässige Umgebungswahrnehmung in selbstfahrenden Systemen, in denen sowohl Geschwindigkeit als auch Genauigkeit entscheidend sind. Erfahre mehr über KI in selbstfahrenden Autos.
- Fortgeschrittene Robotik: Damit Roboter komplexe Aufgaben ausführen können, die eine präzise Objekterkennung und Interaktion in dynamischen Umgebungen erfordern. Entdecke die Rolle von KI in der Robotik.
- Medizinische Bildgebung: Für Anwendungen im Gesundheitswesen, bei denen eine präzise Objekterkennung für die Diagnose entscheidend sein kann. Entdecke KI im Gesundheitswesen.
- Überwachungssysteme: Für Sicherheitsanwendungen, die eine Echtzeitüberwachung mit hoher Erkennungsgenauigkeit erfordern. Erfahre mehr über Sicherheitsalarmsysteme.
- Satellitenbildanalyse: Für die detaillierte Analyse hochauflösender Bilder, bei der das Verständnis des globalen Kontexts wichtig ist. Lies mehr über Computer Vision bei Satellitenbildern.
Zitate und Danksagungen#
Wenn du RT-DETR von Baidu in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die Originalarbeit:
@misc{lv2023detrs,
      title={DETRs Beat YOLOs on Real-time Object Detection},
      author={Wenyu Lv and Shangliang Xu and Yian Zhao and Guanzhong Wang and Jinman Wei and Cheng Cui and Yuning Du and Qingqing Dang and Yi Liu},
      year={2023},
      eprint={2304.08069},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Für RTDETRv2 kannst du die Arbeit aus dem Jahr 2024 zitieren:
@misc{lv2024rtdetrv2,
      title={RTDETRv2: All-in-One Detection Transformer Beats YOLO and DINO},
      author={Wenyu Lv and Yian Zhao and Qinyao Chang and Kui Huang and Guanzhong Wang and Yi Liu},
      year={2024},
      eprint={2407.17140},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Wir möchten Baidu und dem PaddlePaddle-Team dafür danken, dass sie diese wertvolle Ressource für die Computer-Vision-Community entwickelt haben und pflegen. Ihr Beitrag zum Fachgebiet durch die Entwicklung des auf Vision Transformers basierenden Echtzeit-Objektdetektors RT-DETR wird sehr geschätzt.
Häufig gestellte Fragen#
RT-DETR (Echtzeit-Detektions-Transformer) von Baidu ist ein fortschrittlicher Echtzeit-Objektdetektor auf Basis der Vision-Transformer-Architektur. Sein effizienter hybrider Encoder verarbeitet Merkmale verschiedener Maßstäbe, indem er die Interaktion innerhalb eines Maßstabs von der Fusion über mehrere Maßstäbe hinweg entkoppelt. Mithilfe der IoU-gestützten Auswahl von Abfragen konzentriert sich das Modell auf die relevantesten Objekte und verbessert so die Erkennungsgenauigkeit. Die anpassbare Inferenzgeschwindigkeit, die durch die Änderung der Decoder-Schichten ohne erneutes Training erreicht wird, macht RT-DETR für verschiedene Szenarien der Echtzeit-Objekterkennung geeignet. Erfahre mehr über die Funktionen von RT-DETR im RT-DETR-arXiv-Artikel.
Du kannst die Ultralytics Python-API nutzen, um vortrainierte PaddlePaddle-RT-DETR-Modelle zu verwenden. Um beispielsweise ein auf COCO val2017 vortrainiertes RT-DETR-l-Modell zu laden und eine hohe FPS-Zahl auf einer T4-GPU zu erreichen, kannst du das folgende Beispiel verwenden:
Beispielfrom ultralytics import RTDETR # Ein auf COCO vortrainiertes RT-DETR-l-Modell laden model = RTDETR("rtdetr-l.pt") # Modellinformationen anzeigen (optional) model.info() # Das Modell 100 Epochen lang mit dem COCO8-Beispieldatensatz trainieren results = model.train(data="coco8.yaml", epochs=100, imgsz=640) # Mit dem RT-DETR-l-Modell eine Inferenz für das Bild „bus.jpg“ ausführen results = model("path/to/bus.jpg")RT-DETR von Baidu zeichnet sich durch seinen effizienten hybriden Encoder und die IoU-gestützte Auswahl von Abfragen aus, die den Rechenaufwand erheblich verringern und gleichzeitig eine hohe Genauigkeit gewährleisten. Die einzigartige Möglichkeit, die Inferenzgeschwindigkeit durch unterschiedliche Decoder-Schichten ohne erneutes Training anzupassen, bietet zusätzliche Flexibilität. Das macht RT-DETR besonders vorteilhaft für Anwendungen, die Echtzeit-Leistung auf beschleunigten Backends wie CUDA mit TensorRT erfordern, und lässt viele andere Echtzeit-Objektdetektoren hinter sich. Die Transformer-Architektur bietet außerdem im Vergleich zu herkömmlichen CNN-basierten Detektoren ein besseres Verständnis des globalen Kontexts.
RT-DETR von Baidu ermöglicht die flexible Anpassung der Inferenzgeschwindigkeit durch verschiedene Decoder-Schichten, ohne dass ein erneutes Training erforderlich ist. Diese Anpassungsfähigkeit ist entscheidend, um die Leistung für verschiedene Echtzeit-Objekterkennungsaufgaben zu skalieren. Ob du für geringere Anforderungen an die Präzision eine schnellere Verarbeitung oder langsamere, genauere Erkennungen benötigst – RT-DETR lässt sich an deine spezifischen Anforderungen anpassen. Diese Funktion ist besonders wertvoll, wenn Modelle auf Geräten mit unterschiedlichen Rechenkapazitäten eingesetzt werden.
Nein. Bei RT-DETR begrenzt
max_detdie Anzahl der nach der Inferenz zurückgegebenen Vorhersagen, erhöht aber nicht die Anzahl der vom Decoder erzeugten Objektabfragen. Die vortrainierten Ultralytics-RT-DETR-Prüfpunkte verwenden 300 Objektabfragen. Daher können sie pro Bild nicht mehr als 300 Erkennungen zurückgeben, selbst wenn dumax_detauf einen höheren Wert setzt.Verwende
max_det, um weniger Erkennungen zurückzugeben, zum Beispielmax_det=100, wenn du nur wenige Vorhersagen mit hoher Konfidenz benötigst. Wenn dein Datensatz mehr als 300 Objekte pro Bild enthalten kann, trainiere ein eigenes RT-DETR-Modell mit einer höheren Anzahl von Decoder-Abfragen (nq) in der Modell-YAML-Datei. Diesen Wert nach dem Training in einem vortrainierten Prüfpunkt zu ändern, ist nicht gleichwertig; damit die zusätzlichen Abfragen gelernt werden, ist ein erneutes Training erforderlich.Ja, RT-DETR-Modelle sind mit verschiedenen Ultralytics-Modi kompatibel, darunter Training, Validierung, Vorhersage und Export. Ausführliche Anleitungen zur Verwendung dieser Modi findest du in der jeweiligen Dokumentation: Training, Validierung, Vorhersage und Export. So erhältst du einen umfassenden Arbeitsablauf für die Entwicklung und Bereitstellung deiner Objekterkennungslösungen. Das Ultralytics-Framework stellt für verschiedene Modellarchitekturen eine einheitliche API bereit, sodass sich RT-DETR-Modelle einfach verwenden lassen.