YOLO-World-Modell#
Das YOLO-World-Modell führt einen fortschrittlichen Echtzeitansatz auf Basis von Ultralytics YOLOv8 für Aufgaben der Erkennung mit offenem Vokabular ein. Diese Innovation ermöglicht die Erkennung beliebiger Objekte in einem Bild anhand beschreibender Texte. Durch die deutliche Senkung des Rechenaufwands bei gleichzeitig wettbewerbsfähiger Leistung erweist sich YOLO-World als vielseitiges Werkzeug für zahlreiche bildverarbeitungsbasierte Anwendungen.
Watch: YOLO World training workflow on custom dataset
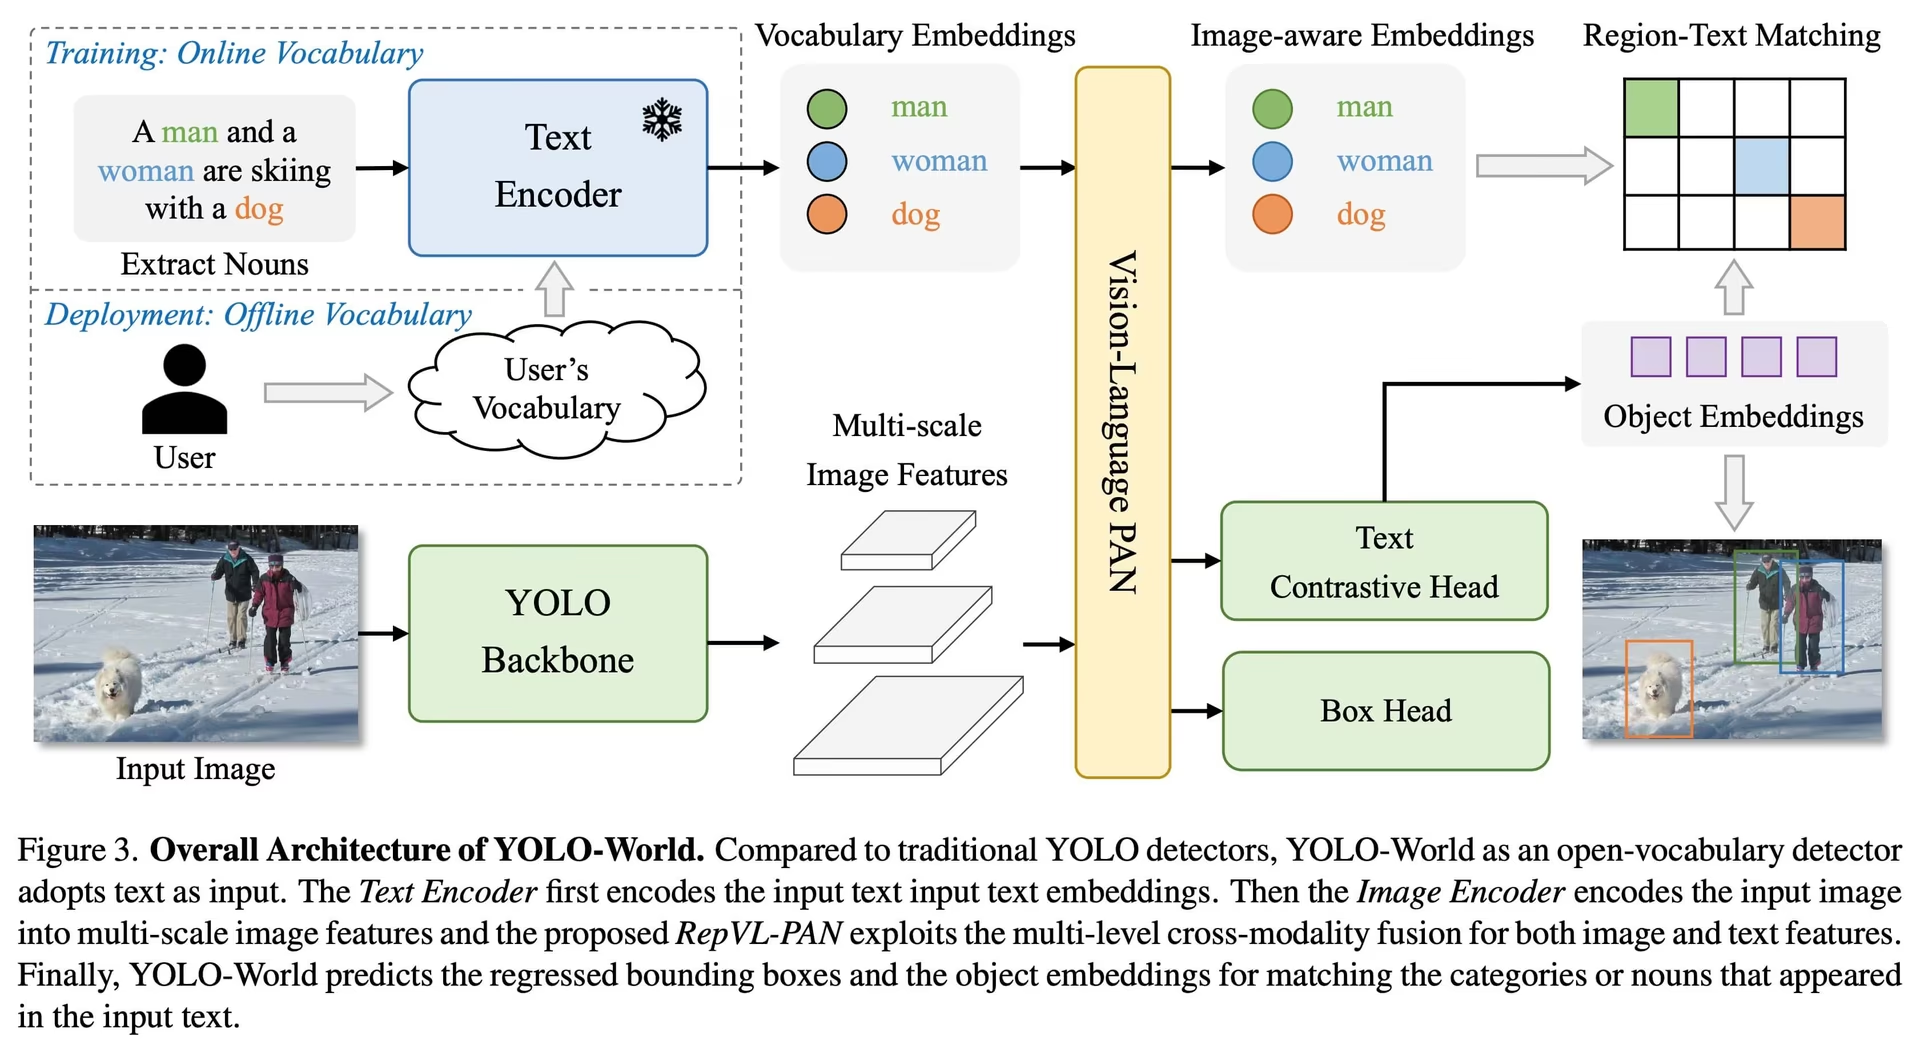
Übersicht#
YOLO-World bewältigt die Herausforderungen herkömmlicher Modelle zur Erkennung mit offenem Vokabular, die häufig auf umfangreichen Transformer-Modellen basieren und erhebliche Rechenressourcen erfordern. Die Abhängigkeit dieser Modelle von vordefinierten Objektkategorien schränkt ihre Einsatzmöglichkeiten in dynamischen Szenarien zusätzlich ein. YOLO-World erweitert das YOLOv8-Framework um Fähigkeiten zur Erkennung mit offenem Vokabular und nutzt Vision-Language Modeling sowie das Vortraining auf umfangreichen Datensätzen, um in Zero-Shot-Szenarien eine breite Palette von Objekten mit beispielloser Effizienz zu erkennen.
Wenn du für Aufgaben mit offenem Vokabular außerdem Instanzmasken, visuelle Prompts oder einen promptfreien Modus benötigst, sieh dir YOLOE an, das dieselbe set_classes()-API verwendet.
Wichtige Funktionen#
-
Echtzeitlösung: YOLO-World nutzt die Rechengeschwindigkeit von CNNs und liefert eine schnelle Lösung zur Erkennung mit offenem Vokabular für Branchen, die sofortige Ergebnisse benötigen.
-
Effizienz und Leistung: YOLO-World reduziert den Rechen- und Ressourcenbedarf erheblich, ohne die Leistung zu beeinträchtigen. Dadurch bietet es eine robuste Alternative zu Modellen wie SAM – bei einem Bruchteil des Rechenaufwands und mit Unterstützung von Echtzeitanwendungen.
-
Inferenz mit Offline-Vokabular: YOLO-World führt eine Strategie nach dem Muster „Prompt, dann erkennen“ ein und verwendet ein Offline-Vokabular, um die Effizienz weiter zu steigern. Dieser Ansatz ermöglicht die Verwendung vorab berechneter benutzerdefinierter Prompts, darunter Bildunterschriften oder Kategorien, die als Einbettungen des Offline-Vokabulars kodiert und gespeichert werden, wodurch der Erkennungsprozess optimiert wird.
-
Basiert auf YOLOv8: YOLO-World basiert auf Ultralytics YOLOv8 und nutzt die neuesten Fortschritte bei der Objekterkennung in Echtzeit, um die Erkennung mit offenem Vokabular mit beispielloser Genauigkeit und Geschwindigkeit zu ermöglichen.
-
Hervorragende Benchmark-Ergebnisse: YOLO-World übertrifft bestehende Detektoren mit offenem Vokabular, darunter die MDETR- und GLIP-Reihen, bei Geschwindigkeit und Effizienz auf Standardbenchmarks und demonstriert die überlegenen Fähigkeiten von YOLOv8 auf einer einzelnen NVIDIA V100 GPU.
-
Vielseitige Anwendungen: Der innovative Ansatz von YOLO-World eröffnet neue Möglichkeiten für zahlreiche Bildverarbeitungsaufgaben und bietet gegenüber bestehenden Methoden Geschwindigkeitssteigerungen um Größenordnungen.
Verfügbare Modelle, unterstützte Aufgaben und Betriebsmodi#
In diesem Abschnitt werden die verfügbaren Modelle mit ihren jeweiligen vortrainierten Gewichten, den von ihnen unterstützten Aufgaben und ihrer Kompatibilität mit verschiedenen Betriebsmodi wie Inferenz, Validierung, Training und Export beschrieben. ✅ kennzeichnet unterstützte Modi, ❌ nicht unterstützte Modi.
Alle YOLOv8-World-Gewichte wurden direkt aus dem offiziellen YOLO-World-Repository übernommen und unterstreichen dessen hervorragende Beiträge.
| Modelltyp | Vortrainierte Gewichte | Unterstützte Aufgaben | Training | Validierung | Inferenz | Export |
|---|---|---|---|---|---|---|
| YOLOv8s-world | yolov8s-world.pt | Objekterkennung | ✅ | ✅ | ✅ | ❌ |
| YOLOv8s-worldv2 | yolov8s-worldv2.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
| YOLOv8m-world | yolov8m-world.pt | Objekterkennung | ✅ | ✅ | ✅ | ❌ |
| YOLOv8m-worldv2 | yolov8m-worldv2.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
| YOLOv8l-world | yolov8l-world.pt | Objekterkennung | ✅ | ✅ | ✅ | ❌ |
| YOLOv8l-worldv2 | yolov8l-worldv2.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
| YOLOv8x-world | yolov8x-world.pt | Objekterkennung | ✅ | ✅ | ✅ | ❌ |
| YOLOv8x-worldv2 | yolov8x-worldv2.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
Zero-Shot-Transfer auf dem COCO-Datensatz#
| Modelltyp | mAP | mAP50 | mAP75 |
|---|---|---|---|
| yolov8s-world | 37.4 | 52.0 | 40.6 |
| yolov8s-worldv2 | 37.7 | 52.2 | 41.0 |
| yolov8m-world | 42.0 | 57.0 | 45.6 |
| yolov8m-worldv2 | 43.0 | 58.4 | 46.8 |
| yolov8l-world | 45.7 | 61.3 | 49.8 |
| yolov8l-worldv2 | 45.8 | 61.3 | 49.8 |
| yolov8x-world | 47.0 | 63.0 | 51.2 |
| yolov8x-worldv2 | 47.1 | 62.8 | 51.4 |
Verwendungsbeispiele#
Die YOLO-World-Modelle lassen sich einfach in deine Python-Anwendungen integrieren. Ultralytics stellt eine benutzerfreundliche Python-API und CLI-Befehle bereit, um die Entwicklung zu optimieren.
Watch: YOLO-World Model Usage examples with Ultralytics | Open Vocab, Prompt-Free & others 🚀
Trainingsverwendung#
Für das Training benutzerdefinierter Modelle empfehlen wir dringend die Verwendung von yolov8-worldv2, da es deterministisches Training unterstützt und sich einfacher in Formate wie ONNX und TensorRT exportieren lässt.
Die Objekterkennung ist mit der Methode train unkompliziert, wie unten gezeigt:
Vortrainierte *.pt-Modelle für PyTorch sowie Konfigurationsdateien *.yaml können an die Klasse YOLOWorld() übergeben werden, um eine Modellinstanz in Python zu erstellen:
from ultralytics import YOLOWorld

# Load a pretrained YOLOv8s-worldv2 model
model = YOLOWorld("yolov8s-worldv2.pt")

# Train the model on the COCO8 example dataset for 100 epochs
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Run inference with the YOLO-World model on the 'bus.jpg' image
results = model("path/to/bus.jpg")
Verwendung für Vorhersagen#
Die Objekterkennung ist mit der Methode predict unkompliziert, wie unten gezeigt:
from ultralytics import YOLOWorld

# Initialize a YOLO-World model
model = YOLOWorld("yolov8s-world.pt")  # or select yolov8m/l-world.pt for different sizes

# Execute inference with the YOLOv8s-world model on the specified image
results = model.predict("path/to/image.jpg")

# Show results
results[0].show()
Dieses Beispiel zeigt, wie einfach sich ein vortrainiertes Modell laden und eine Vorhersage für ein Bild ausführen lässt.
Verwendung für die Validierung#
Die Validierung eines Modells auf einem Datensatz läuft wie folgt ab:
from ultralytics import YOLO

# Create a YOLO-World model
model = YOLO("yolov8s-world.pt")  # or select yolov8m/l-world.pt for different sizes

# Conduct model validation on the COCO8 example dataset
metrics = model.val(data="coco8.yaml")
Verwendung für die Verfolgung#
Das Objekt-Tracking mit dem YOLO-World-Modell auf einem Video oder Bildern läuft wie folgt ab:
from ultralytics import YOLO

# Create a YOLO-World model
model = YOLO("yolov8s-world.pt")  # or select yolov8m/l-world.pt for different sizes

# Track with a YOLO-World model on a video
results = model.track(source="path/to/video.mp4")Die von Ultralytics bereitgestellten YOLO-World-Modelle sind im Rahmen ihres Offline-Vokabulars bereits mit COCO-Datensatz-Kategorien vorkonfiguriert, was ihre Effizienz für den sofortigen Einsatz erhöht. Durch diese Integration können die YOLOv8-World-Modelle die 80 standardmäßigen, im COCO-Datensatz definierten Kategorien direkt erkennen und vorhersagen, ohne dass eine zusätzliche Einrichtung oder Anpassung erforderlich ist.
Prompts festlegen#
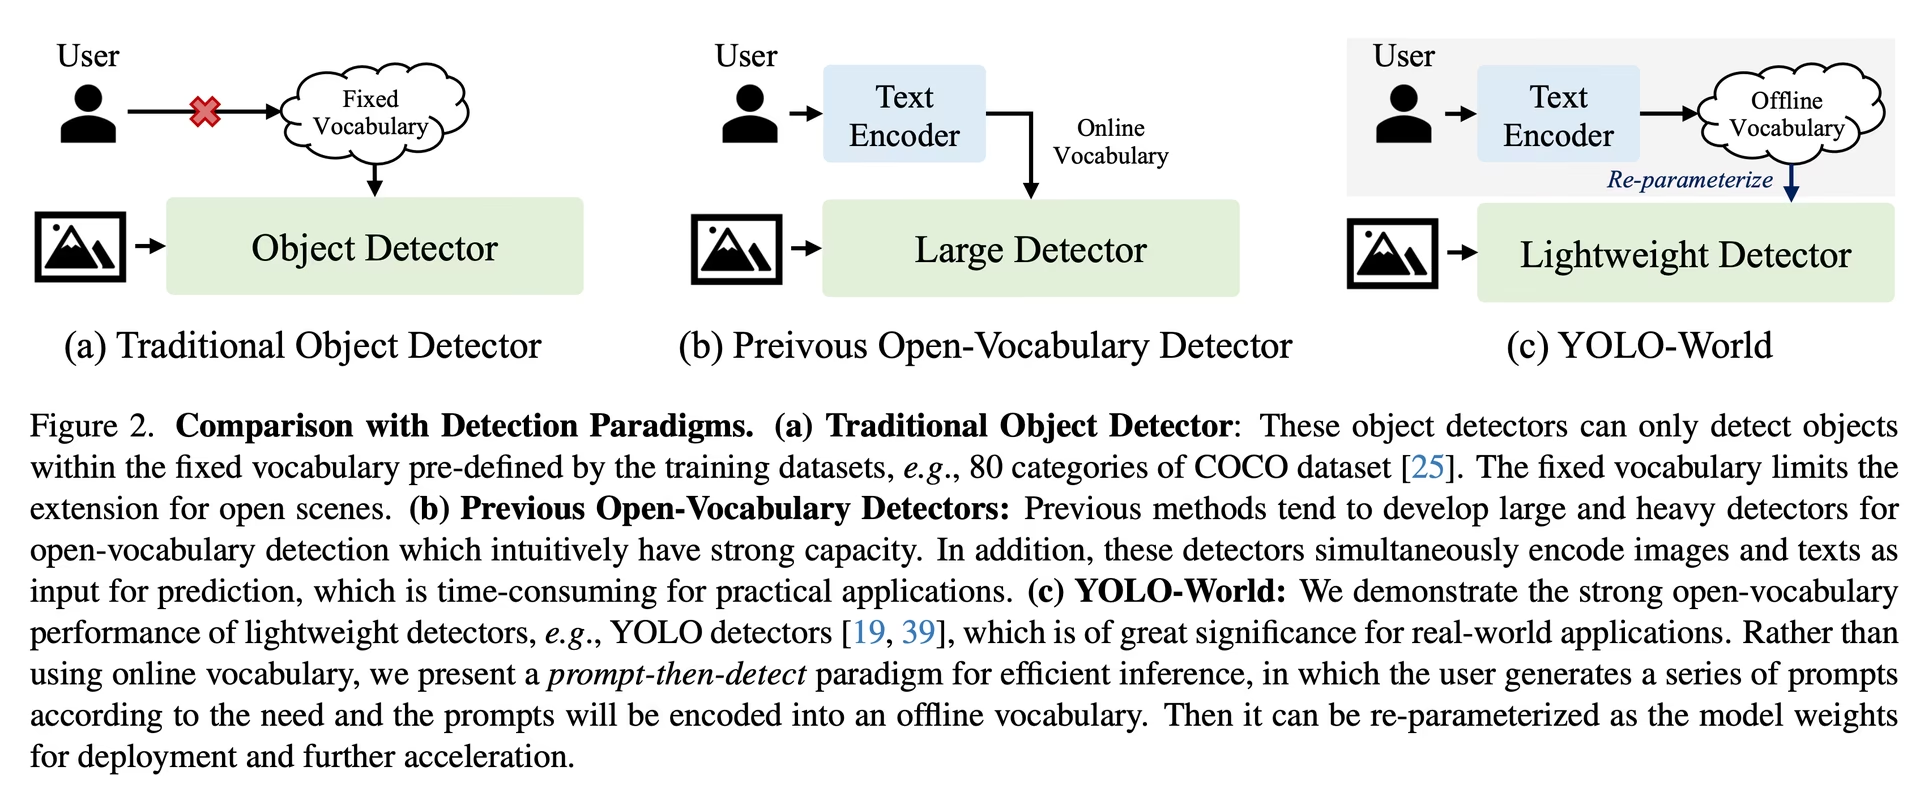
Das YOLO-World-Framework ermöglicht die dynamische Festlegung von Klassen durch benutzerdefinierte Prompts und gibt dir die Möglichkeit, das Modell ohne erneutes Training an deine spezifischen Anforderungen anzupassen. Diese Funktion ist besonders nützlich, um das Modell an neue Domänen oder spezifische Aufgaben anzupassen, die ursprünglich nicht Teil der Trainingsdaten waren. Durch das Festlegen benutzerdefinierter Prompts kannst du den Fokus des Modells gezielt auf relevante Objekte lenken und so die Relevanz und Genauigkeit der Erkennungsergebnisse erhöhen.
Wenn deine Anwendung beispielsweise nur die Objekte „person“ und „bus“ erkennen muss, kannst du diese Klassen direkt angeben:
from ultralytics import YOLO

# Initialize a YOLO-World model
model = YOLO("yolov8s-world.pt")  # or choose yolov8m/l-world.pt

# Define custom classes
model.set_classes(["person", "bus"])

# Execute prediction for specified categories on an image
results = model.predict("path/to/image.jpg")

# Show results
results[0].show()Einige Benutzer haben festgestellt, dass das Anhängen einer leeren Zeichenfolge "" als Hintergrundklasse die Erkennungsleistung in bestimmten Szenarien verbessern kann. Dieses Verhalten scheint vom jeweiligen Szenario abzuhängen, und der genaue Mechanismus ist noch nicht vollständig verstanden:
model.set_classes(["person", "bus", ""])Du kannst ein Modell auch nach dem Festlegen benutzerdefinierter Klassen speichern. Dadurch erstellst du eine Version des YOLO-World-Modells, die auf deinen spezifischen Anwendungsfall spezialisiert ist. Bei diesem Vorgang werden deine benutzerdefinierten Klassendefinitionen direkt in die Modelldatei eingebettet, sodass das Modell ohne weitere Anpassungen mit den von dir festgelegten Klassen verwendet werden kann. Führe die folgenden Schritte aus, um dein benutzerdefiniertes YOLO-World-Modell zu speichern und zu laden:
Lade zunächst ein YOLO-World-Modell, lege dafür benutzerdefinierte Klassen fest und speichere es:
from ultralytics import YOLO

# Initialize a YOLO-World model
model = YOLO("yolov8s-world.pt")  # or select yolov8m/l-world.pt

# Define custom classes
model.set_classes(["person", "bus"])

# Save the model with the defined offline vocabulary
model.save("custom_yolov8s.pt")
Nach dem Speichern verhält sich das Modell custom_yolov8s.pt wie jedes andere vortrainierte YOLOv8-Modell, mit einem entscheidenden Unterschied: Es ist nun darauf optimiert, ausschließlich die von dir definierten Klassen zu erkennen. Diese Anpassung kann die Erkennungsleistung und Effizienz für deine spezifischen Anwendungsszenarien deutlich verbessern.
from ultralytics import YOLO

# Load your custom model
model = YOLO("custom_yolov8s.pt")

# Run inference to detect your custom classes
results = model.predict("path/to/image.jpg")

# Show results
results[0].show()
Vorteile des Speicherns mit benutzerdefiniertem Vokabular#
- Effizienz: Optimiert den Erkennungsprozess, indem der Fokus auf relevante Objekte gelegt, der Rechenaufwand reduziert und die Inferenz beschleunigt wird.
- Flexibilität: Ermöglicht die einfache Anpassung des Modells an neue oder spezielle Erkennungsaufgaben, ohne umfangreiches erneutes Training oder das Sammeln zusätzlicher Daten.
- Einfachheit: Vereinfacht die Bereitstellung, da benutzerdefinierte Klassen nicht bei jeder Ausführung erneut angegeben werden müssen. Dadurch kann das Modell direkt mit seinem eingebetteten Vokabular verwendet werden.
- Leistung: Erhöht die Erkennungsgenauigkeit für die festgelegten Klassen, indem die Aufmerksamkeit und Ressourcen des Modells auf die Erkennung der definierten Objekte konzentriert werden.
Dieser Ansatz bietet eine leistungsstarke Möglichkeit, hochmoderne Objekterkennungsmodelle für spezifische Aufgaben anzupassen und fortschrittliche KI für ein breiteres Spektrum praktischer Anwendungen zugänglicher und nutzbarer zu machen.
Offizielle Ergebnisse von Grund auf reproduzieren (experimentell)#
Datensätze vorbereiten#
- Trainingsdaten
| Datensatz | Typ | Beispiele | Boxen | Annotationsdateien |
|---|---|---|---|---|
| Objects365v1 | Erkennung | 609k | 9621k | objects365_train.json |
| GQA | Grounding | 621k | 3681k | final_mixed_train_no_coco.json |
| Flickr30k | Grounding | 149k | 641k | final_flickr_separateGT_train.json |
- Validierungsdaten
| Datensatz | Typ | Annotationsdateien |
|---|---|---|
| LVIS minival | Erkennung | minival.txt |
Training von Grund auf starten#
WorldTrainerFromScratch ist stark angepasst und ermöglicht das gleichzeitige Training von yolo-world-Modellen auf Erkennungs- und Grounding-Datensätzen. Weitere Informationen findest du unter ultralytics.models.yolo.world.train_world.py.
from ultralytics import YOLOWorld
from ultralytics.models.yolo.world.train_world import WorldTrainerFromScratch

# Option 1: Use Python dictionary
data = {
    "train": {
        "yolo_data": ["Objects365.yaml"],
        "grounding_data": [
            {
                "img_path": "flickr30k/images",
                "json_file": "flickr30k/final_flickr_separateGT_train.json",
            },
            {
                "img_path": "GQA/images",
                "json_file": "GQA/final_mixed_train_no_coco.json",
            },
        ],
    },
    "val": {"yolo_data": ["lvis.yaml"]},
}

# Option 2: Use YAML file (yolo_world_data.yaml)
# train:
#   yolo_data:
#     - Objects365.yaml
#   grounding_data:
#     - img_path: flickr/full_images/
#       json_file: flickr/annotations/final_flickr_separateGT_train_segm.json
#     - img_path: mixed_grounding/gqa/images
#       json_file: mixed_grounding/annotations/final_mixed_train_no_coco_segm.json
# val:
#   yolo_data:
#     - lvis.yaml

model = YOLOWorld("yolov8s-worldv2.yaml")
model.train(
    data=data,  # or data="yolo_world_data.yaml" if using YAML file
    batch=128,
    epochs=100,
    trainer=WorldTrainerFromScratch,
)
Zitate und Danksagungen#
Wir danken dem Tencent AILab Computer Vision Center herzlich für seine wegweisende Arbeit zur Echtzeit-Objekterkennung mit offenem Vokabular mit YOLO-World:
@article{cheng2024yolow,
title={YOLO-World: Real-Time Open-Vocabulary Object Detection},
author={Cheng, Tianheng and Song, Lin and Ge, Yixiao and Liu, Wenyu and Wang, Xinggang and Shan, Ying},
journal={arXiv preprint arXiv:2401.17270},
year={2024}
}
Weitere Informationen findest du im Originalartikel zu YOLO-World auf arXiv. Der Quellcode des Projekts und zusätzliche Ressourcen sind über das zugehörige GitHub-Repository verfügbar. Wir schätzen das Engagement des Teams, dieses Gebiet voranzubringen und der Community wertvolle Erkenntnisse zur Verfügung zu stellen.
FAQ#
Das YOLO-World-Modell ist ein fortschrittlicher Echtzeitansatz zur Objekterkennung, der auf dem Ultralytics YOLOv8-Framework basiert. Es eignet sich besonders für Aufgaben der Erkennung mit offenem Vokabular, indem es Objekte in einem Bild anhand beschreibender Texte identifiziert. Durch Vision-Language Modeling und das Vortraining auf großen Datensätzen erreicht YOLO-World eine hohe Effizienz und Leistung bei deutlich geringerem Rechenaufwand und eignet sich damit ideal für Echtzeitanwendungen in verschiedenen Branchen.
YOLO-World unterstützt eine Strategie nach dem Muster „Prompt, dann erkennen“, bei der ein Offline-Vokabular zur Steigerung der Effizienz verwendet wird. Benutzerdefinierte Prompts wie Bildunterschriften oder bestimmte Objektkategorien werden vorab kodiert und als Einbettungen des Offline-Vokabulars gespeichert. Dieser Ansatz optimiert den Erkennungsprozess, ohne dass ein erneutes Training erforderlich ist. Du kannst diese Prompts dynamisch im Modell festlegen, um es an bestimmte Erkennungsaufgaben anzupassen, wie unten gezeigt:
from ultralytics import YOLOWorld # Initialize a YOLO-World model model = YOLOWorld("yolov8s-world.pt") # Define custom classes model.set_classes(["person", "bus"]) # Execute prediction on an image results = model.predict("path/to/image.jpg") # Show results results[0].show()YOLO-World bietet gegenüber herkömmlichen Modellen zur Erkennung mit offenem Vokabular mehrere Vorteile:
- Echtzeitleistung: Das Modell nutzt die Rechengeschwindigkeit von CNNs und ermöglicht eine schnelle, effiziente Erkennung.
- Effizienz und geringer Ressourcenbedarf: YOLO-World bietet eine hohe Leistung bei deutlich geringerem Rechen- und Ressourcenbedarf.
- Anpassbare Prompts: Das Modell unterstützt die dynamische Festlegung von Prompts, sodass du benutzerdefinierte Erkennungsklassen angeben kannst, ohne das Modell erneut zu trainieren.
- Hervorragende Benchmark-Ergebnisse: Das Modell übertrifft andere Detektoren mit offenem Vokabular wie MDETR und GLIP bei Geschwindigkeit und Effizienz auf Standardbenchmarks.
Das Training eines YOLO-World-Modells auf deinem Datensatz ist über die bereitgestellte Python-API oder CLI-Befehle unkompliziert. So startest du das Training mit Python:
from ultralytics import YOLOWorld

# Load a pretrained YOLOv8s-worldv2 model
model = YOLOWorld("yolov8s-worldv2.pt")

# Train the model on the COCO8 dataset for 100 epochs
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)
Oder über die CLI:
yolo train model=yolov8s-worldv2.pt data=coco8.yaml epochs=100 imgsz=640Ultralytics bietet mehrere vortrainierte YOLO-World-Modelle, die verschiedene Aufgaben und Betriebsmodi unterstützen:
Modelltyp Vortrainierte Gewichte Unterstützte Aufgaben Training Validierung Inferenz Export YOLOv8s-world yolov8s-world.pt Objekterkennung ✅ ✅ ✅ ❌ YOLOv8s-worldv2 yolov8s-worldv2.pt Objekterkennung ✅ ✅ ✅ ✅ YOLOv8m-world yolov8m-world.pt Objekterkennung ✅ ✅ ✅ ❌ YOLOv8m-worldv2 yolov8m-worldv2.pt Objekterkennung ✅ ✅ ✅ ✅ YOLOv8l-world yolov8l-world.pt Objekterkennung ✅ ✅ ✅ ❌ YOLOv8l-worldv2 yolov8l-worldv2.pt Objekterkennung ✅ ✅ ✅ ✅ YOLOv8x-world yolov8x-world.pt Objekterkennung ✅ ✅ ✅ ❌ YOLOv8x-worldv2 yolov8x-worldv2.pt Objekterkennung ✅ ✅ ✅ ✅ Um die offiziellen Ergebnisse von Grund auf zu reproduzieren, musst du die Datensätze vorbereiten und das Training mit dem bereitgestellten Code starten. Der Trainingsablauf umfasst das Erstellen eines Datenverzeichnisses und das Ausführen der Methode
trainmit einem benutzerdefinierten Trainer:from ultralytics import YOLOWorld from ultralytics.models.yolo.world.train_world import WorldTrainerFromScratch data = { "train": { "yolo_data": ["Objects365.yaml"], "grounding_data": [ { "img_path": "flickr30k/images", "json_file": "flickr30k/final_flickr_separateGT_train.json", }, { "img_path": "GQA/images", "json_file": "GQA/final_mixed_train_no_coco.json", }, ], }, "val": {"yolo_data": ["lvis.yaml"]}, } model = YOLOWorld("yolov8s-worldv2.yaml") model.train(data=data, batch=128, epochs=100, trainer=WorldTrainerFromScratch)