YOLO12: Aufmerksamkeitszentrierte Objekterkennung
Übersicht#
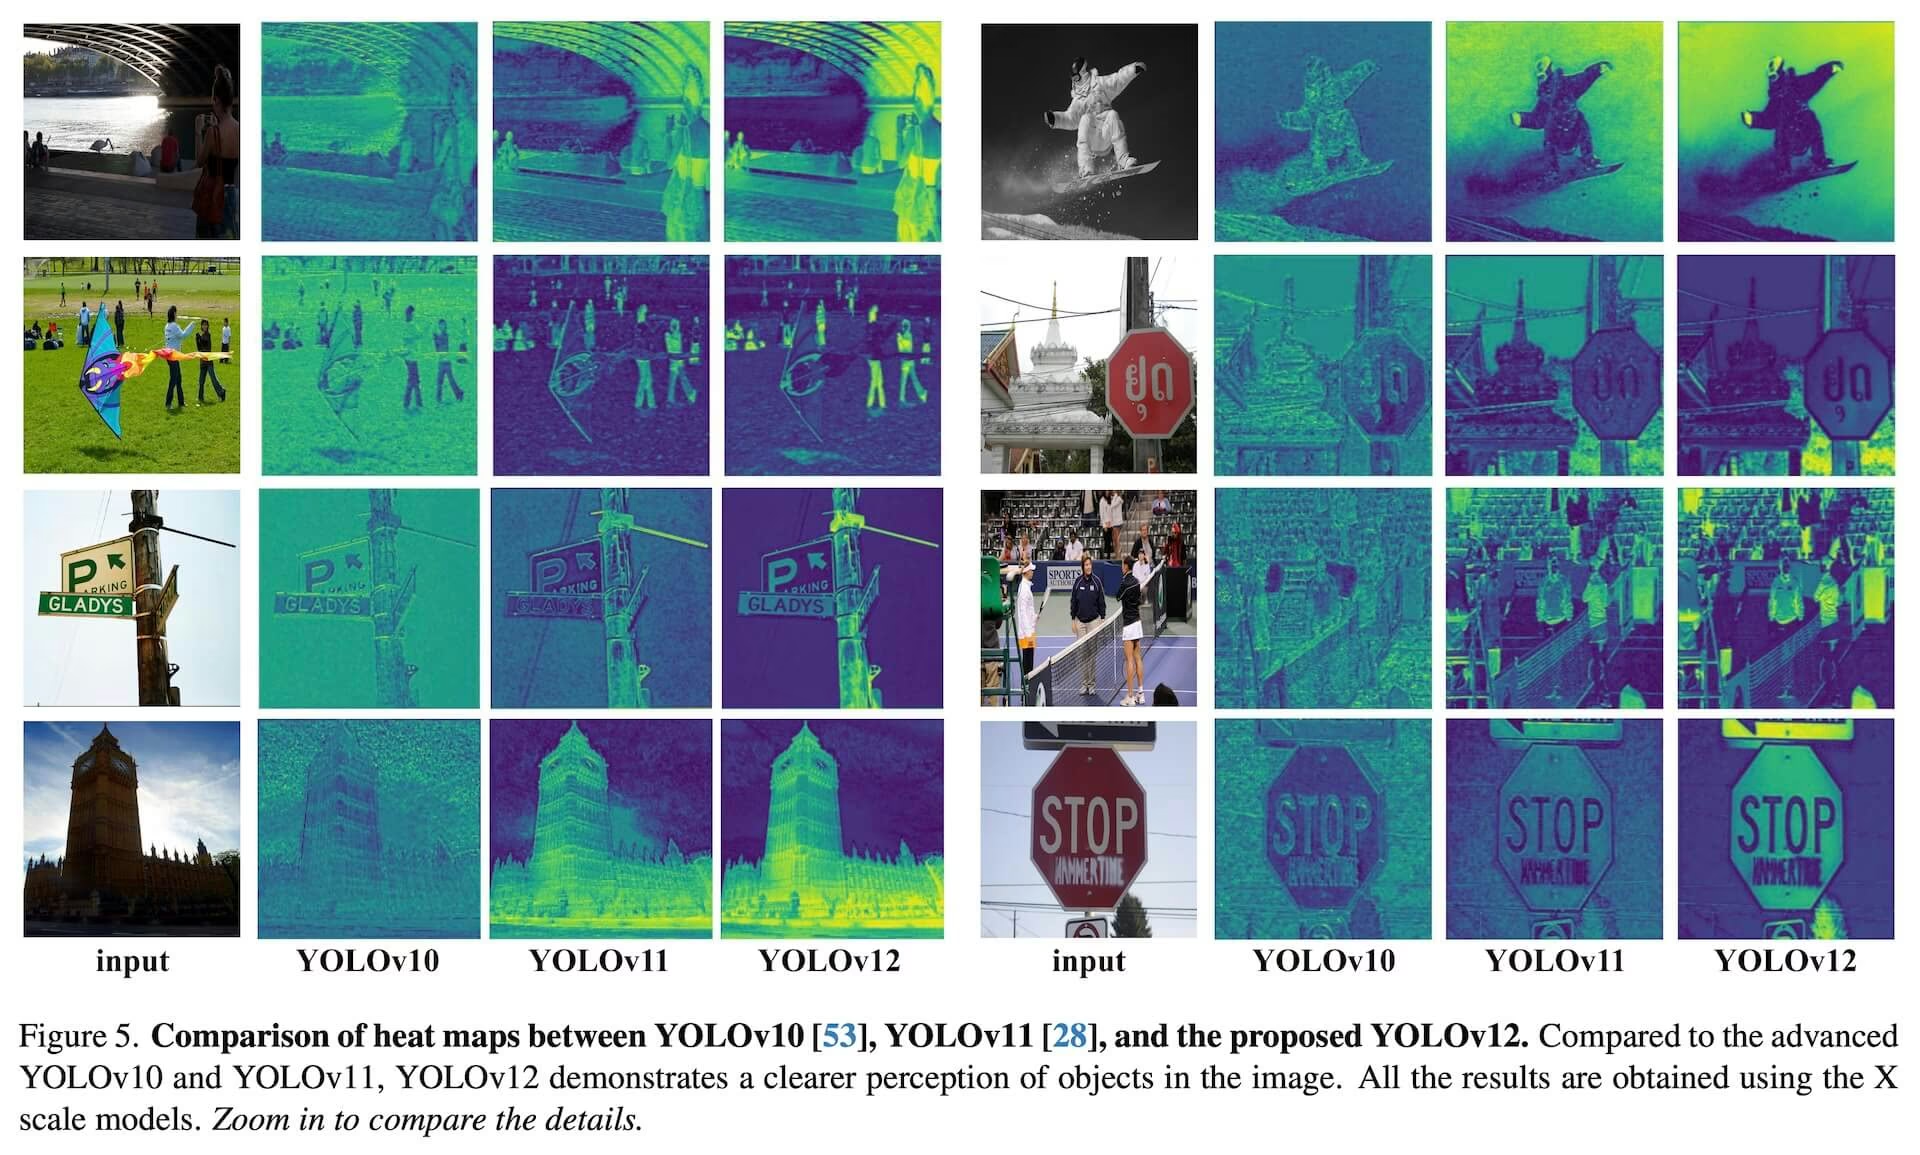
YOLO12, Anfang 2025 veröffentlicht, führt eine auf Aufmerksamkeit ausgerichtete Architektur ein, die von den traditionellen CNN-basierten Ansätzen früherer YOLO-Modelle abweicht und dennoch die für viele Anwendungen wichtige Inferenzgeschwindigkeit in Echtzeit beibehält. Durch Änderungen an den Aufmerksamkeitsmechanismen und der gesamten Netzwerkarchitektur erreicht das Modell eine hohe Genauigkeit bei der Objekterkennung. Trotz dieser Vorteile bleibt YOLO12 eine von der Community getragene Veröffentlichung, bei der es aufgrund der aufwendigen Aufmerksamkeitsblöcke zu instabilem Training, erhöhtem Speicherverbrauch und geringerem CPU-Durchsatz kommen kann. Für die meisten Produktionslasten empfiehlt Ultralytics daher YOLO11 oder YOLO26.
YOLO12 wird hauptsächlich für Benchmarking und Forschung gepflegt. Wenn du stabiles Training, vorhersehbaren Speicherverbrauch und optimierte CPU-Inferenz brauchst, wähle YOLO11 oder YOLO26 für die Bereitstellung.
Ansehen: So verwendest du YOLO12 mit dem Ultralytics-Paket zur Objekterkennung | Ist YOLO12 schnell oder langsam?
Wichtige Funktionen#
- Area-Attention-Mechanismus: Ein neuer Ansatz für Self-Attention, der große rezeptive Felder effizient verarbeitet. Dabei werden Feature-Maps horizontal oder vertikal in l gleich große Bereiche unterteilt (standardmäßig 4), wodurch komplexe Operationen vermieden und ein großes effektives rezeptives Feld beibehalten werden. Im Vergleich zu standardmäßiger Self-Attention werden die Rechenkosten dadurch deutlich reduziert.
- Residual Efficient Layer Aggregation Networks (R-ELAN): Ein verbessertes Merkmalsaggregationsmodul auf ELAN-Basis, das Optimierungsprobleme insbesondere bei größeren aufmerksamkeitzentrierten Modellen beheben soll. R-ELAN führt Folgendes ein:
- Residualverbindungen auf Blockebene mit Skalierung (ähnlich der Skalierung von Schichten).
- Eine neu gestaltete Methode zur Merkmalsaggregation, die eine bottleneckartige Struktur erzeugt.
- Optimierte Aufmerksamkeitsarchitektur: YOLO12 vereinfacht den standardmäßigen Aufmerksamkeitsmechanismus, um Effizienz und Kompatibilität mit dem YOLO-Framework zu erhöhen. Dazu gehören:
- Verwendung von FlashAttention, um den Aufwand für Speicherzugriffe zu minimieren.
- Der Verzicht auf Positionskodierung für ein einfacheres und schnelleres Modell.
- Die Anpassung des MLP-Verhältnisses (vom üblichen Wert 4 auf 1,2 oder 2), um die Berechnungen zwischen Aufmerksamkeits- und Feedforward-Schichten besser auszubalancieren.
- Die Verringerung der Tiefe gestapelter Blöcke für eine bessere Optimierung.
- Verwendung von Faltungsoperationen (sofern geeignet), um die Recheneffizienz zu nutzen.
- Das Hinzufügen einer separierbaren 7x7-Faltung (des „Position Perceiver“) zum Aufmerksamkeitsmechanismus, um Positionsinformationen implizit zu kodieren.
- Umfassende Unterstützung von Aufgaben: YOLO12 unterstützt eine Reihe grundlegender Computer-Vision-Aufgaben: Objekterkennung, Instanzsegmentierung, Bildklassifizierung, Posenschätzung und die Erkennung orientierter Objekte (OBB).
- Höhere Effizienz: Erzielt im Vergleich zu vielen früheren Modellen eine höhere Genauigkeit mit weniger Parametern und bietet damit eine bessere Balance zwischen Geschwindigkeit und Genauigkeit.
- Flexible Bereitstellung: Entwickelt für den Einsatz auf verschiedensten Plattformen, von Edge-Geräten bis hin zu Cloud-Infrastrukturen.
Unterstützte Aufgaben und Modi#
YOLO12 unterstützt verschiedene Computer-Vision-Aufgaben. Die folgende Tabelle zeigt die unterstützten Aufgaben und die jeweils verfügbaren Betriebsmodi (Training, Validierung, Inferenz und Export):
Auf ultralytics/assets werden nur Gewichte für die Erkennung (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt) veröffentlicht. Die Architekturen für Segmentierung, Klassifizierung, Pose und OBB sind in ultralytics/cfg/models/12/ definiert. Diese Varianten können daher anhand der Konfiguration .yaml von Grund auf trainiert werden; vortrainierte Dateien .pt sind dafür derzeit jedoch nicht verfügbar. Für vortrainierte Checkpoints zur Segmentierung, Posenschätzung, Klassifizierung oder OBB empfiehlt Ultralytics YOLO11 oder YOLO26.
| Modelltyp | Aufgabe | Vortrainierte Gewichte | Training | Validierung | Inferenz | Exportieren |
|---|---|---|---|---|---|---|
| YOLO12 | Erkennung | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Segmentierung | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Klassifizierung | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Pose | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Sobald ein trainierter Checkpoint verfügbar ist, unterstützen alle YOLO12-Architekturen sämtliche Modi. Die Spalte Pretrained Weights gibt lediglich an, ob Ultralytics einen offiziellen vortrainierten .pt auf ultralytics/assets veröffentlicht: Für Segmentierung, Pose, Klassifizierung und OBB musst du deinen eigenen Checkpoint anhand der entsprechenden .yaml trainieren, bevor du Inferenz, Validierung oder Export ausführst.
Leistungskennzahlen#
YOLO12 verbessert die Genauigkeit bei allen Modellgrößen, wobei gegenüber den schnellsten früheren YOLO-Modellen gewisse Geschwindigkeitseinbußen auftreten. Nachfolgend findest du quantitative Ergebnisse zur Objekterkennung auf dem COCO-Validierungsdatensatz:
Erkennungsleistung (COCO val2017)#
| Modell | Größe (Pixel) | mAPval50-95 | Geschwindigkeit CPU ONNX (ms) | Geschwindigkeit T4 TensorRT (ms) | Parameter (M) | FLOPs (B) | Vergleich (mAP/Geschwindigkeit) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1%/-9% (im Vergleich zu YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1%/+42% (im Vergleich zu RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0%/-3% (im Vergleich zu YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4%/-8% (im Vergleich zu YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6%/-4% (im Vergleich zu YOLO11x) |
- Die Inferenzgeschwindigkeit wurde auf einer NVIDIA T4 GPU mit TensorRT-FP16-Genauigkeit gemessen.
- Die Vergleiche zeigen die relative Verbesserung bei mAP und die prozentuale Änderung der Geschwindigkeit (positive Werte stehen für schneller, negative für langsamer). Verglichen wird, sofern verfügbar, mit veröffentlichten Ergebnissen für YOLOv10, YOLO11 und RT-DETR.
Anwendungsbeispiele#
Dieser Abschnitt enthält Beispiele für Training und Inferenz mit YOLO12.
Die folgenden Beispiele beziehen sich auf YOLO12-Detect-Modelle (für die Objekterkennung). Informationen zu anderen unterstützten Aufgaben (Segmentierung, Klassifizierung, Posenschätzung und Erkennung orientierter Objekte) findest du in der jeweiligen aufgabenspezifischen Dokumentation: Segment, Classify, Pose und OBB.
Vortrainierte Modelle *.pt (mit PyTorch) und Konfigurationsdateien *.yaml können an die Klasse YOLO() übergeben werden, um in Python eine Modellinstanz zu erstellen:
from ultralytics import YOLO

# # Ein mit COCO vortrainiertes YOLO12n-Modell laden
model = YOLO("yolo12n.pt")

# Das Modell 100 Epochen lang mit dem COCO8-Beispieldatensatz trainieren
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# # Mit dem YOLO12n-Modell eine Inferenz für das Bild „bus.jpg“ ausführen
results = model("path/to/bus.jpg")
Wichtige Verbesserungen#
-
Verbesserte Merkmalsextraktion:
- Area Attention: Verarbeitet große rezeptive Felder effizient und senkt dadurch die Rechenkosten.
- Optimierte Balance: Verbesserte Balance zwischen den Berechnungen für Aufmerksamkeit und Feedforward-Netzwerk.
- R-ELAN: Verbessert die Merkmalsaggregation mithilfe der R-ELAN-Architektur.
-
Innovationen bei der Optimierung:
- Residualverbindungen: Führt skalierte Residualverbindungen ein, um das Training insbesondere bei größeren Modellen zu stabilisieren.
- Verfeinerte Merkmalsintegration: Setzt eine verbesserte Methode zur Merkmalsintegration innerhalb von R-ELAN um.
- FlashAttention: Integriert FlashAttention, um den Speicherzugriffsaufwand zu verringern.
-
Architektonische Effizienz:
- Weniger Parameter: Erreicht im Vergleich zu vielen früheren Modellen eine geringere Parameterzahl bei gleichbleibender oder höherer Genauigkeit.
- Vereinfachte Aufmerksamkeit: Verwendet eine vereinfachte Implementierung des Aufmerksamkeitsmechanismus und verzichtet auf Positionskodierung.
- Optimierte MLP-Verhältnisse: Passt die MLP-Verhältnisse an, um Rechenressourcen effektiver zuzuweisen.
Voraussetzungen#
Die Ultralytics-Implementierung von YOLO12 benötigt standardmäßig keine FlashAttention. FlashAttention kann jedoch optional kompiliert und mit YOLO12 verwendet werden. Zum Kompilieren von FlashAttention wird eine der folgenden NVIDIA-GPUs benötigt:
- Turing-GPUs (z. B. T4, Quadro-RTX-Serie)
- Ampere-GPUs (z. B. RTX30-Serie, A30/40/100)
- Ada-Lovelace-GPUs (z. B. RTX40-Serie)
- Hopper-GPUs (z. B. H100/H200)
Zitate und Danksagungen#
Wenn du YOLO12 in deiner Forschung verwendest, zitiere bitte die Originalarbeit der University at Buffalo und der University of Chinese Academy of Sciences:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
Das YOLO12-Paper wurde in den NeurIPS-2025-Proceedings veröffentlicht; ein Preprint ist auf arXiv verfügbar.
Häufig gestellte Fragen#
YOLO12 umfasst mehrere wichtige Neuerungen, die Geschwindigkeit und Genauigkeit in Einklang bringen. Der Area-Attention-Mechanismus verarbeitet große rezeptive Felder effizient und senkt im Vergleich zu standardmäßiger Self-Attention die Rechenkosten. Die Residual Efficient Layer Aggregation Networks (R-ELAN) verbessern die Aggregation von Merkmalen und begegnen so Optimierungsproblemen größerer, auf Aufmerksamkeit ausgerichteter Modelle. Eine optimierte Aufmerksamkeitsarchitektur, darunter die Verwendung von FlashAttention und der Verzicht auf Positionskodierung, steigert die Effizienz zusätzlich. Dank dieser Eigenschaften erreicht YOLO12 eine hohe Genauigkeit und behält zugleich die für viele Anwendungen erforderliche Inferenzgeschwindigkeit in Echtzeit bei.
YOLO12 unterstützt ein breites Spektrum wichtiger Aufgaben aus dem Bereich Computer Vision: Objekterkennung, Instanzsegmentierung, Bild-Klassifizierung, Posenschätzung und orientierte Objekterkennung (OBB). Dadurch eignet sich YOLO12 für vielfältige Einsatzbereiche, von der Robotik und dem autonomen Fahren bis hin zur medizinischen Bildgebung und industriellen Inspektion. Beachte, dass vortrainierte Gewichte für
.ptderzeit nur für die Objekterkennung veröffentlicht sind; die Architekturen für Segmentierung, Pose, Klassifizierung und OBB werden als.yaml-Konfigurationen für das Training von Grund auf bereitgestellt.YOLO12 verbessert die Genauigkeit über alle Modellgrößen hinweg gegenüber früheren YOLO-Modellen wie YOLOv10 und YOLO11, wobei es gegenüber den schnellsten Vorgängermodellen gewisse Geschwindigkeitseinbußen gibt. Beispielsweise erzielt YOLO12n auf dem COCO-val2017-Datensatz eine um 2,1 % höhere mAP als YOLOv10n und eine um 1,2 % höhere mAP als YOLO11n. Im Vergleich zu Modellen wie RT-DETR bietet YOLO12s eine um 1,5 % höhere mAP und eine um 42 % höhere Geschwindigkeit. Diese Kennzahlen zeigen, wie gut YOLO12 Genauigkeit und Effizienz vereint.
Die Ultralytics-YOLO12-Implementierung benötigt FlashAttention standardmäßig nicht. FlashAttention kann jedoch optional kompiliert und mit YOLO12 verwendet werden, um den Aufwand für Speicherzugriffe zu minimieren. Zum Kompilieren von FlashAttention wird eine der folgenden NVIDIA-GPUs benötigt: Turing-GPUs (z. B. T4, Quadro-RTX-Serie), Ampere-GPUs (z. B. RTX30-Serie, A30/40/100), Ada-Lovelace-GPUs (z. B. RTX40-Serie) oder Hopper-GPUs (z. B. H100/H200). So können Nutzer FlashAttention einsetzen, sofern ihre Hardware dies unterstützt.
Diese Seite enthält grundlegende Anwendungsbeispiele für Training und Inferenz. YOLO12 verwendet dieselben Modi für Training, Validierung, Vorhersage und Export sowie dieselben Aufgaben und Schnittstellen für Segmentierung, Klassifizierung, Pose und OBB wie andere Ultralytics-Modelle.


Kommentare69
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(bearbeitet)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?