Ultralytics-YOLOv5-Architektur
YOLOv5 (v6.0/6.1) ist ein von Ultralytics entwickelter Algorithmus zur Objekterkennung. Dieser Artikel erläutert die YOLOv5-Architektur, Strategien zur Datenerweiterung, Trainingsmethoden und Verfahren zur Berechnung des Verlusts. Wenn du diese Aspekte verstehst, kannst du Objekterkennung in Bereichen wie Überwachung, autonomen Fahrzeugen und Bilderkennung einsetzen.
1. Modellstruktur#
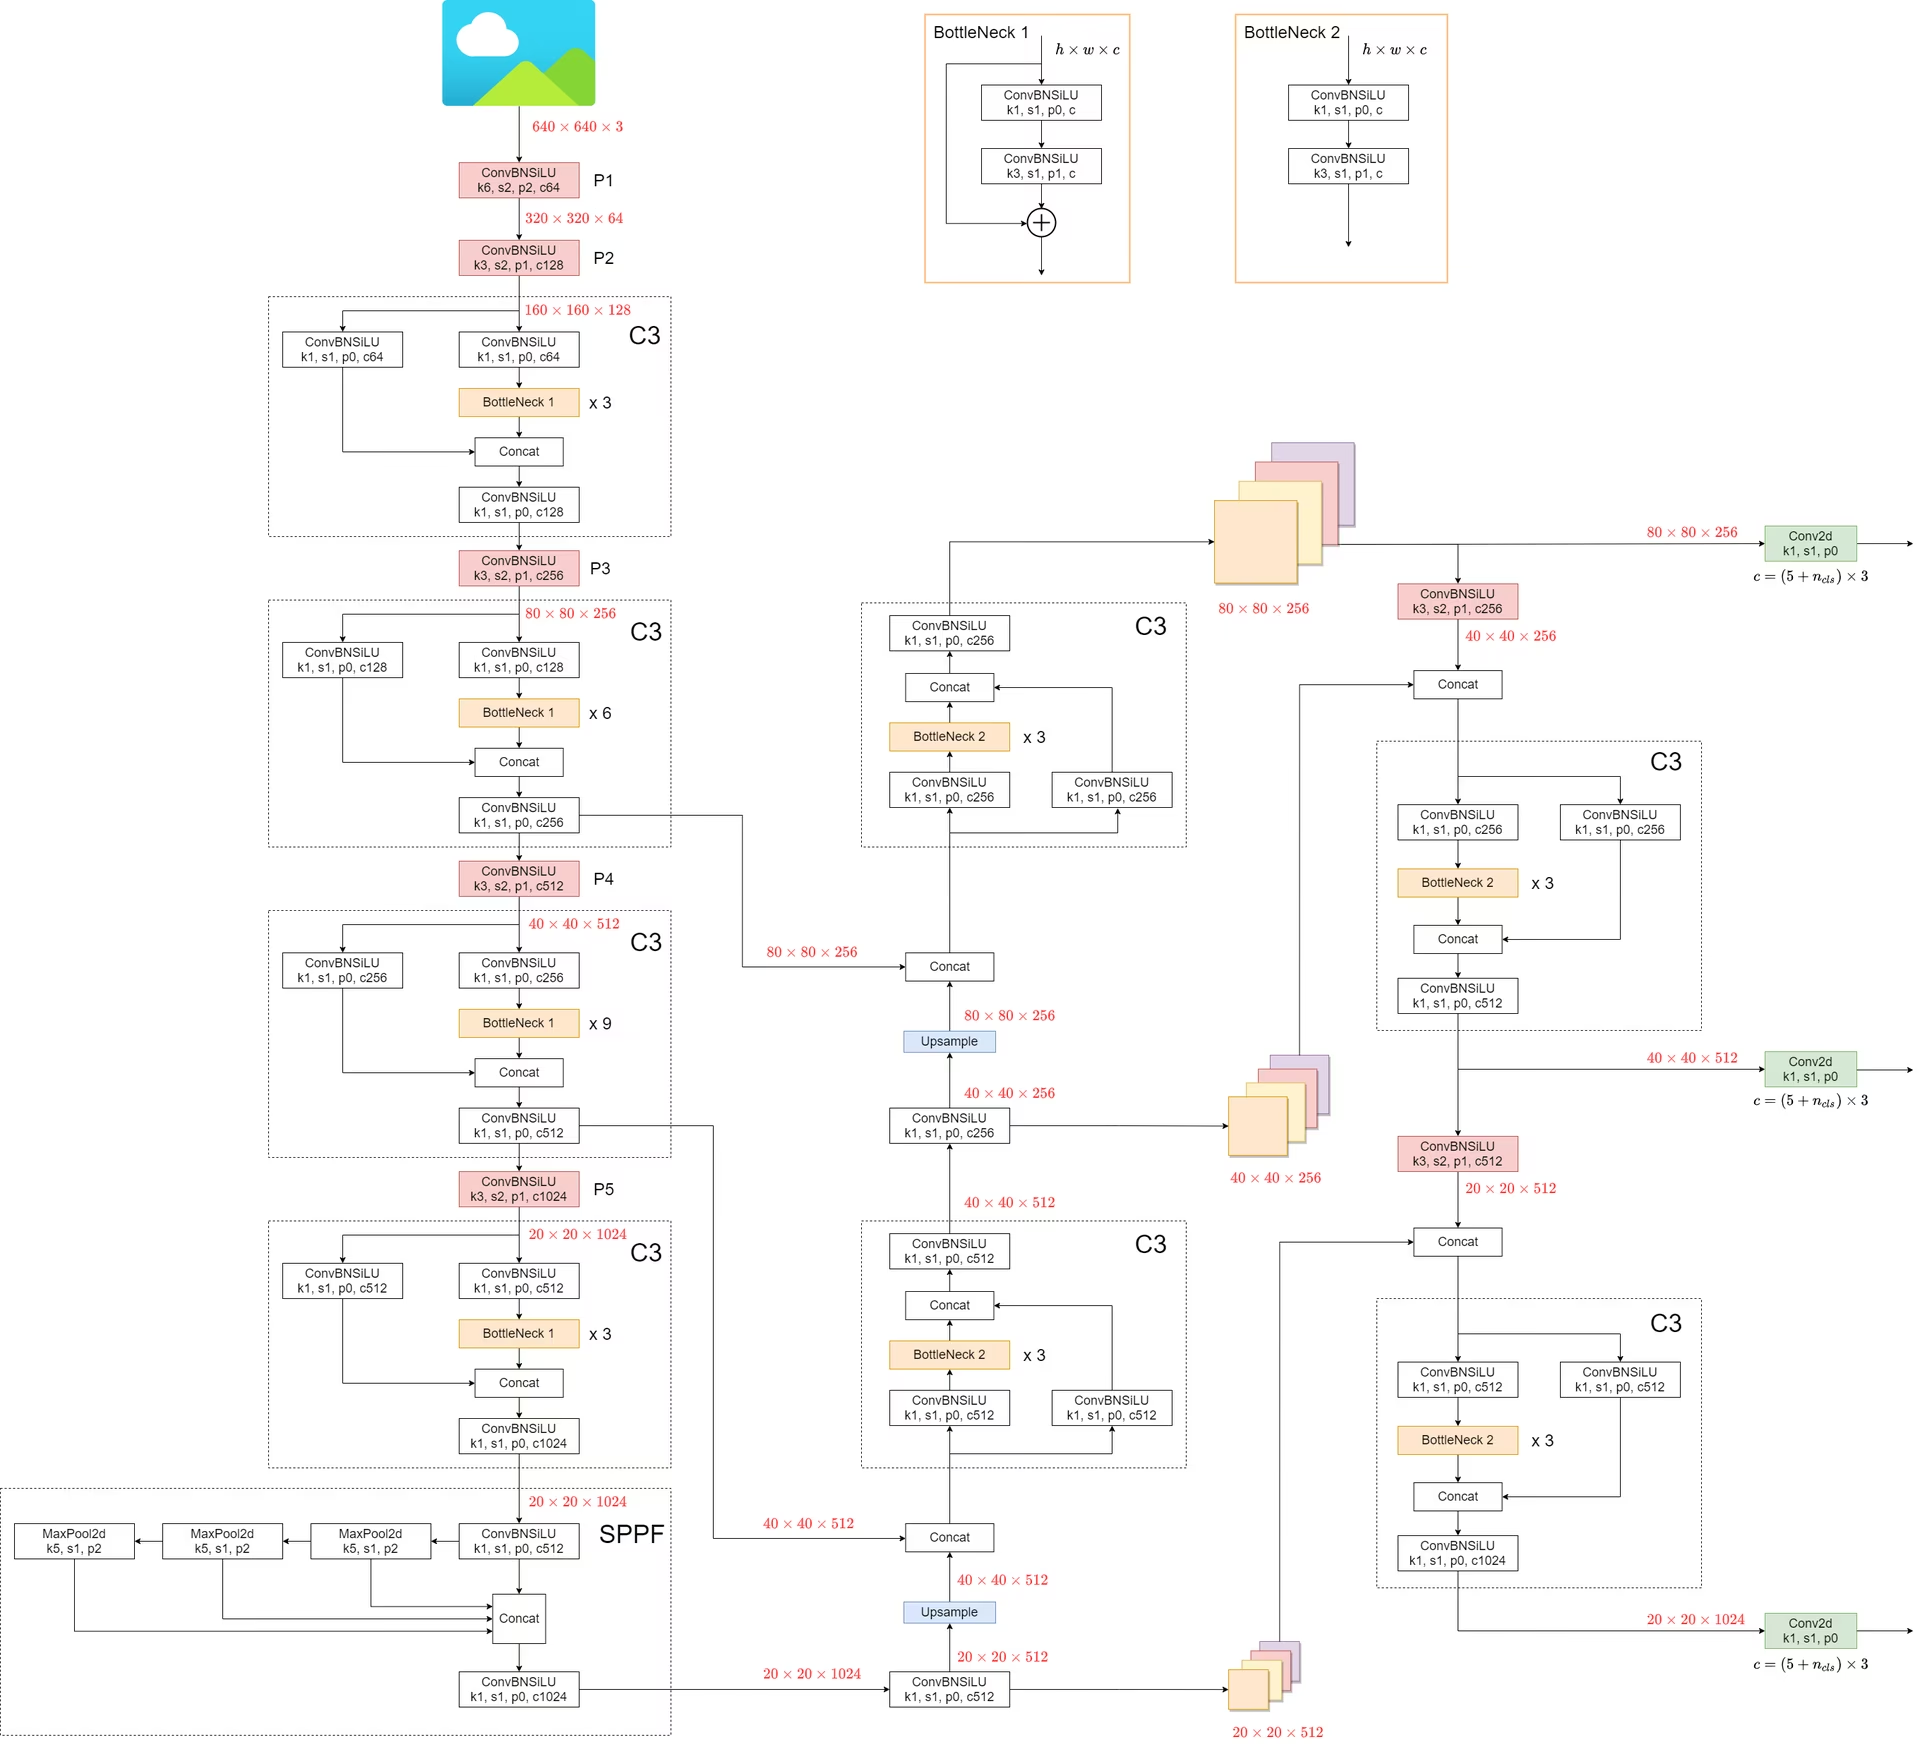
Die Architektur von YOLOv5 besteht aus drei Hauptkomponenten:
- Backbone: Das ist der Hauptteil des Netzwerks. Bei YOLOv5 basiert der Backbone auf der Struktur
CSPDarknet53, einer Abwandlung der Darknet-Architektur aus früheren Versionen. - Neck: Diese Komponente verbindet Backbone und Kopf. In YOLOv5 kommen die Strukturen
SPPF(Spatial Pyramid Pooling – Fast) undPANet(Path Aggregation Network) zum Einsatz. - Head: Dieser Teil erzeugt die endgültige Ausgabe. YOLOv5 verwendet dafür
YOLOv3 Head.
Die Modellstruktur ist in der folgenden Abbildung dargestellt. Details zur Modellstruktur findest du in models/yolov5l.yaml.
YOLOv5 bietet gegenüber seinen Vorgängern einige bemerkenswerte Verbesserungen:
- Die in früheren Versionen verwendete Struktur
Focuswurde durch die Struktur6x6 Conv2dersetzt. Diese Änderung steigert die Effizienz #4825. - Die Struktur
SPPwurde durchSPPFersetzt. Dadurch hat sich die Verarbeitungsgeschwindigkeit mehr als verdoppelt, während die Ausgabe gleich bleibt.
Um die Geschwindigkeit von SPP und SPPF zu testen, kannst du folgenden Code verwenden:
Beispiel für das Geschwindigkeitsprofiling von SPP und SPPF (zum Öffnen klicken)
import time

import torch
from torch import nn

class SPP(nn.Module):
    def __init__(self):
        """Initializes an SPP module with three different sizes of max pooling layers."""
        super().__init__()
        self.maxpool1 = nn.MaxPool2d(5, 1, padding=2)
        self.maxpool2 = nn.MaxPool2d(9, 1, padding=4)
        self.maxpool3 = nn.MaxPool2d(13, 1, padding=6)

    def forward(self, x):
        """Applies three max pooling layers on input `x` and concatenates results along channel dimension."""
        o1 = self.maxpool1(x)
        o2 = self.maxpool2(x)
        o3 = self.maxpool3(x)
        return torch.cat([x, o1, o2, o3], dim=1)

class SPPF(nn.Module):
    def __init__(self):
        """Initializes an SPPF module with a specific configuration of MaxPool2d layer."""
        super().__init__()
        self.maxpool = nn.MaxPool2d(5, 1, padding=2)

    def forward(self, x):
        """Applies sequential max pooling and concatenates results with input tensor."""
        o1 = self.maxpool(x)
        o2 = self.maxpool(o1)
        o3 = self.maxpool(o2)
        return torch.cat([x, o1, o2, o3], dim=1)

def main():
    """Compares outputs and performance of SPP and SPPF on a random tensor (8, 32, 16, 16)."""
    input_tensor = torch.rand(8, 32, 16, 16)
    spp = SPP()
    sppf = SPPF()
    output1 = spp(input_tensor)
    output2 = sppf(input_tensor)

    print(torch.equal(output1, output2))

    t_start = time.time()
    for _ in range(100):
        spp(input_tensor)
    print(f"SPP time: {time.time() - t_start}")

    t_start = time.time()
    for _ in range(100):
        sppf(input_tensor)
    print(f"SPPF time: {time.time() - t_start}")

if __name__ == "__main__":
    main()
Ergebnis:
True
SPP time: 0.5373051166534424
SPPF time: 0.20780706405639648
2. Techniken zur Datenerweiterung#
YOLOv5 verwendet verschiedene Techniken zur Datenerweiterung, um die Fähigkeit des Modells zur Verallgemeinerung zu verbessern und Überanpassung zu verringern. Dazu gehören:
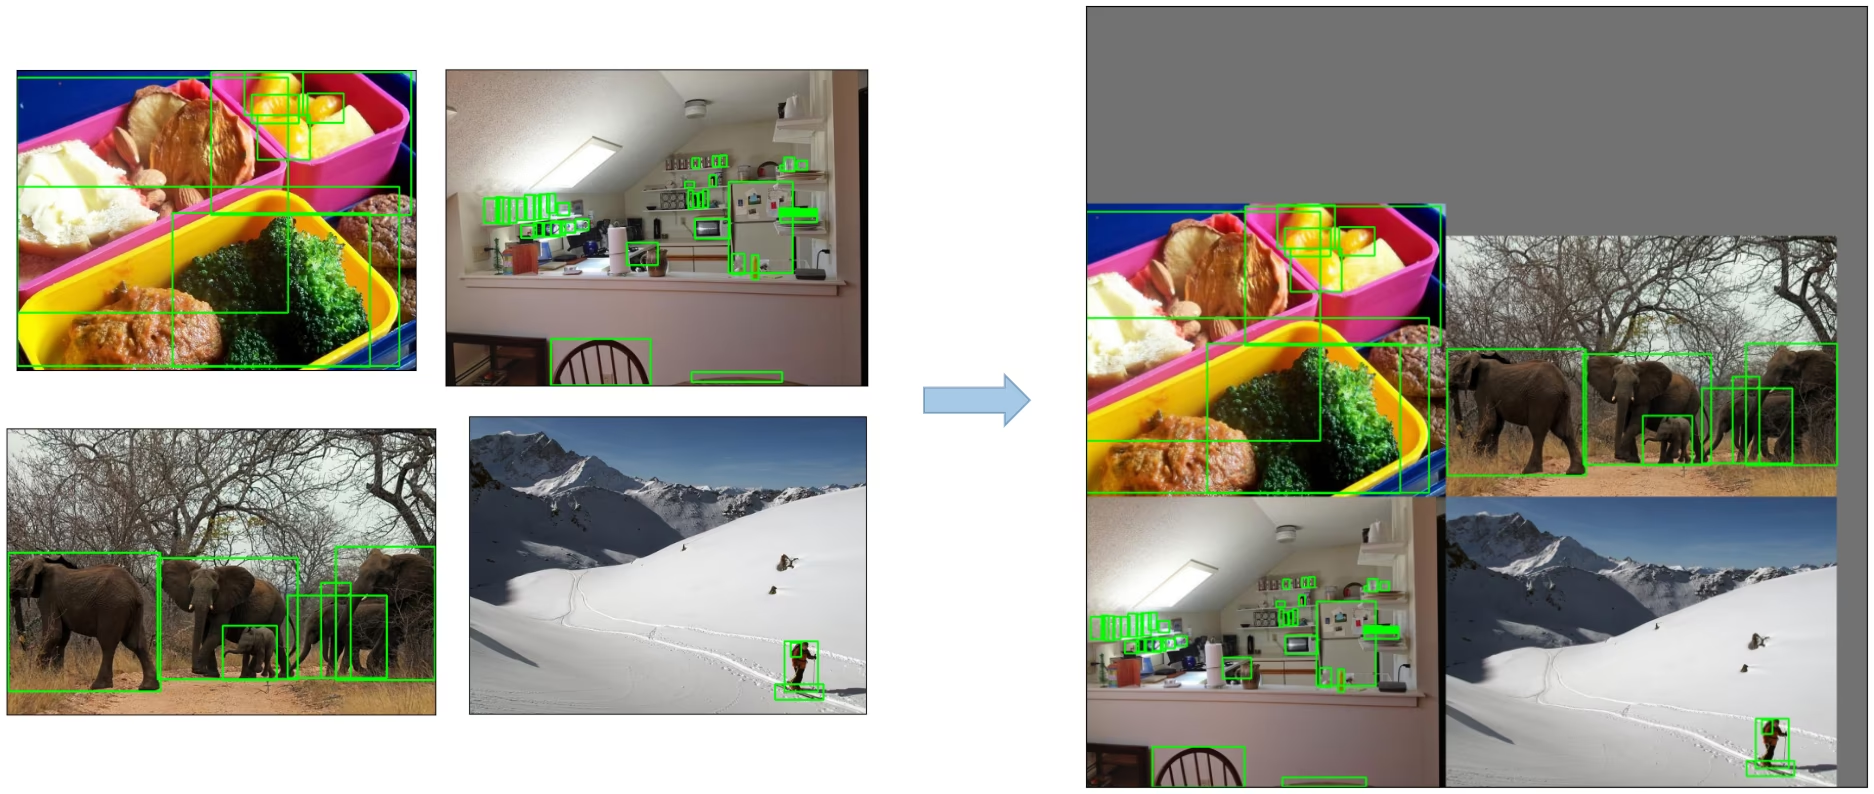
-
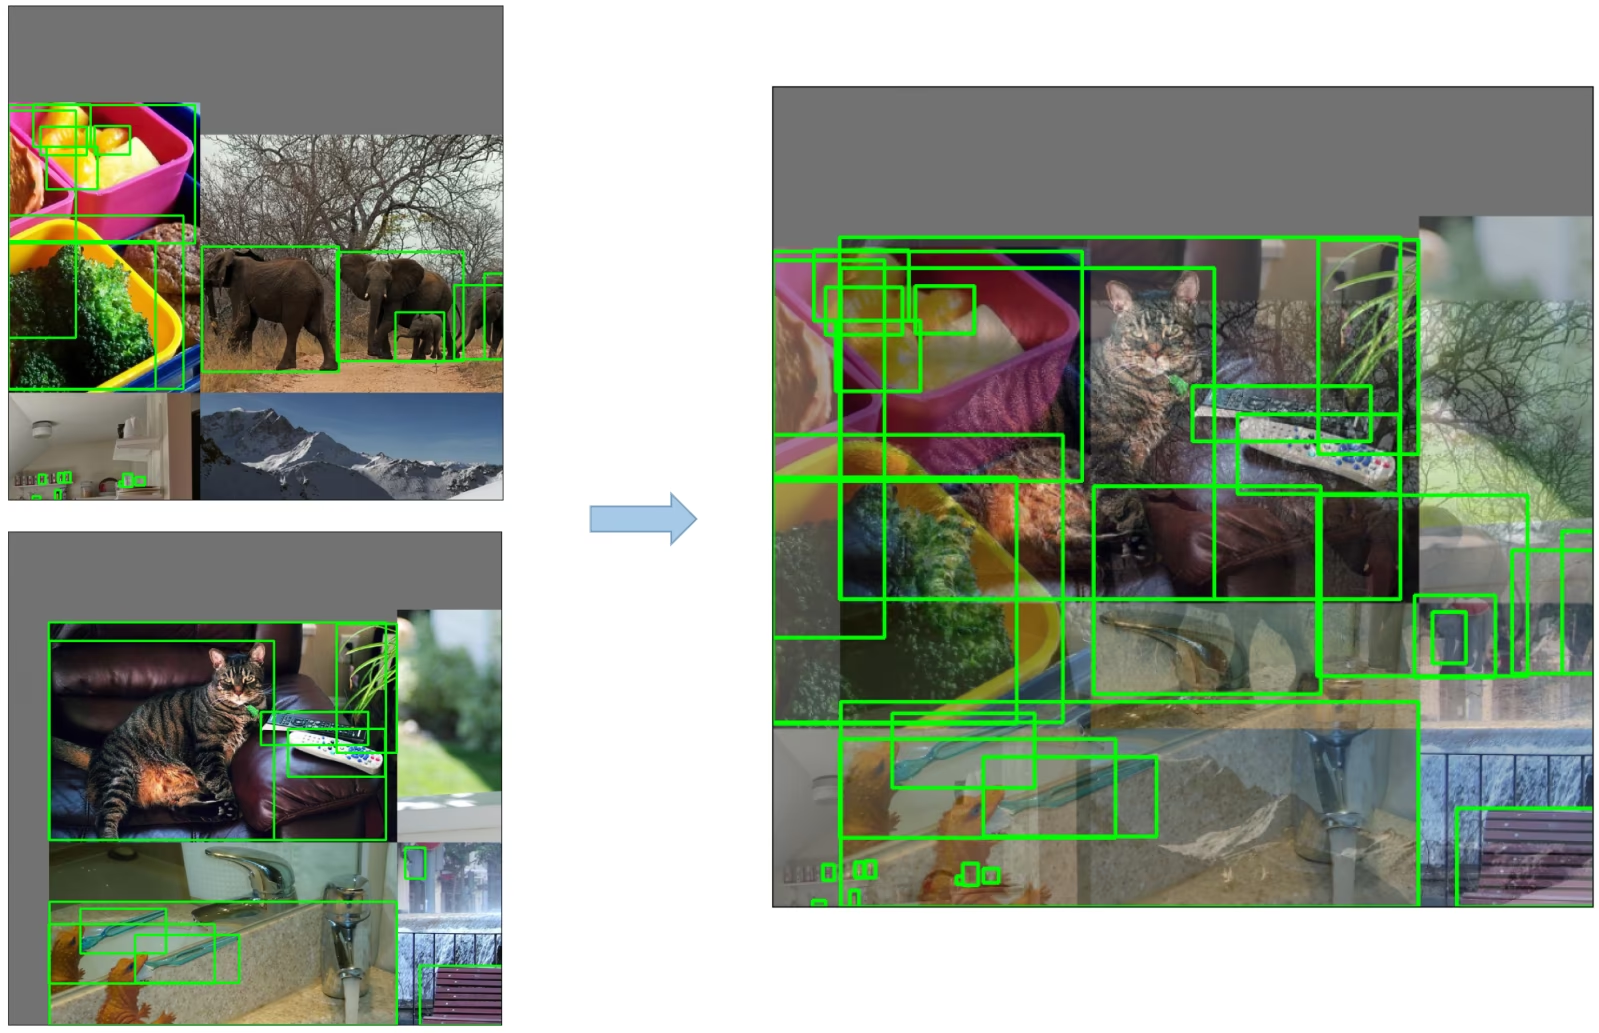
Mosaic-Augmentation: Ein Bildverarbeitungsverfahren, bei dem vier Trainingsbilder zu einem Bild kombiniert werden. Dadurch können Objekterkennungsmodelle besser mit verschiedenen Objektgrößen und Verschiebungen umgehen.
-
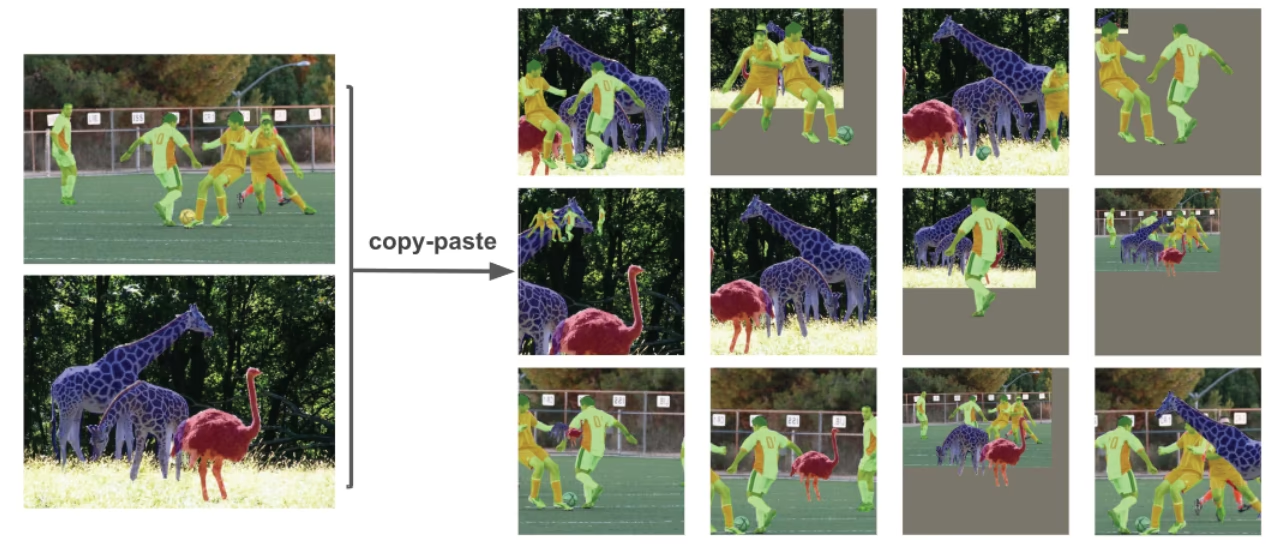
Copy-Paste-Augmentation: Ein Verfahren zur Datenerweiterung, bei dem Objektinstanzen mithilfe ihrer Segmentierungsmasken kopiert und in Trainingsbilder eingefügt werden, um neue Trainingsbeispiele zu erzeugen.
-
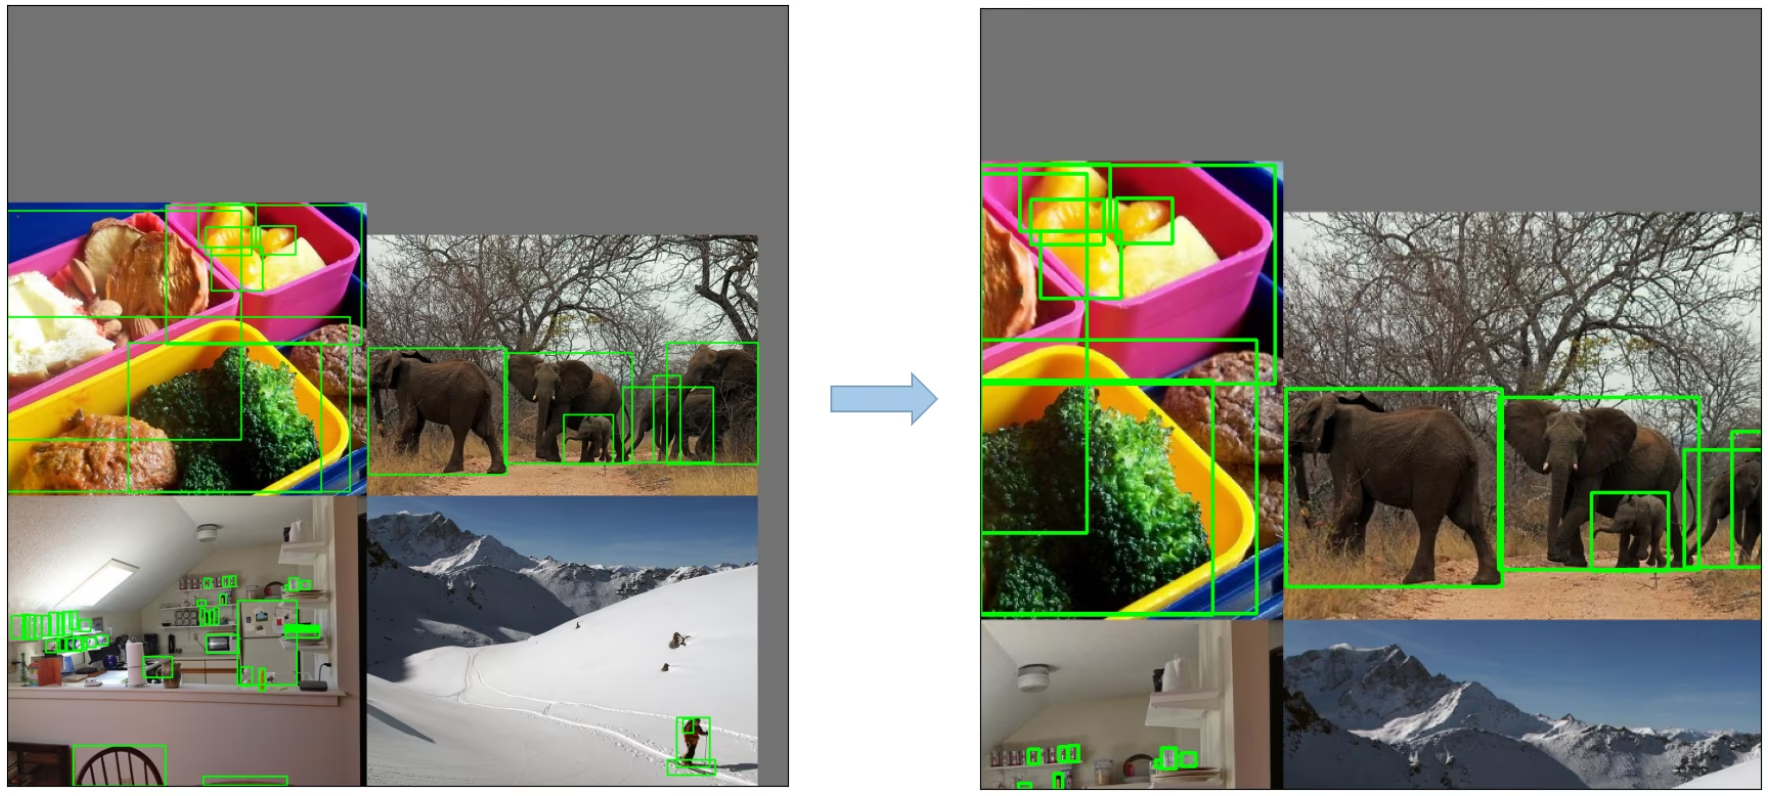
Zufällige affine Transformationen: Dazu gehören zufällige Drehungen, Skalierungen, Verschiebungen und Scherungen der Bilder.
-
MixUp-Erweiterung: Eine Methode, bei der durch lineare Kombination zweier Bilder und der dazugehörigen Beschriftungen zusammengesetzte Bilder entstehen.
-
Albumentations: Eine Bibliothek zur Bildaugmentierung, die eine große Auswahl an Augmentierungstechniken unterstützt.
-
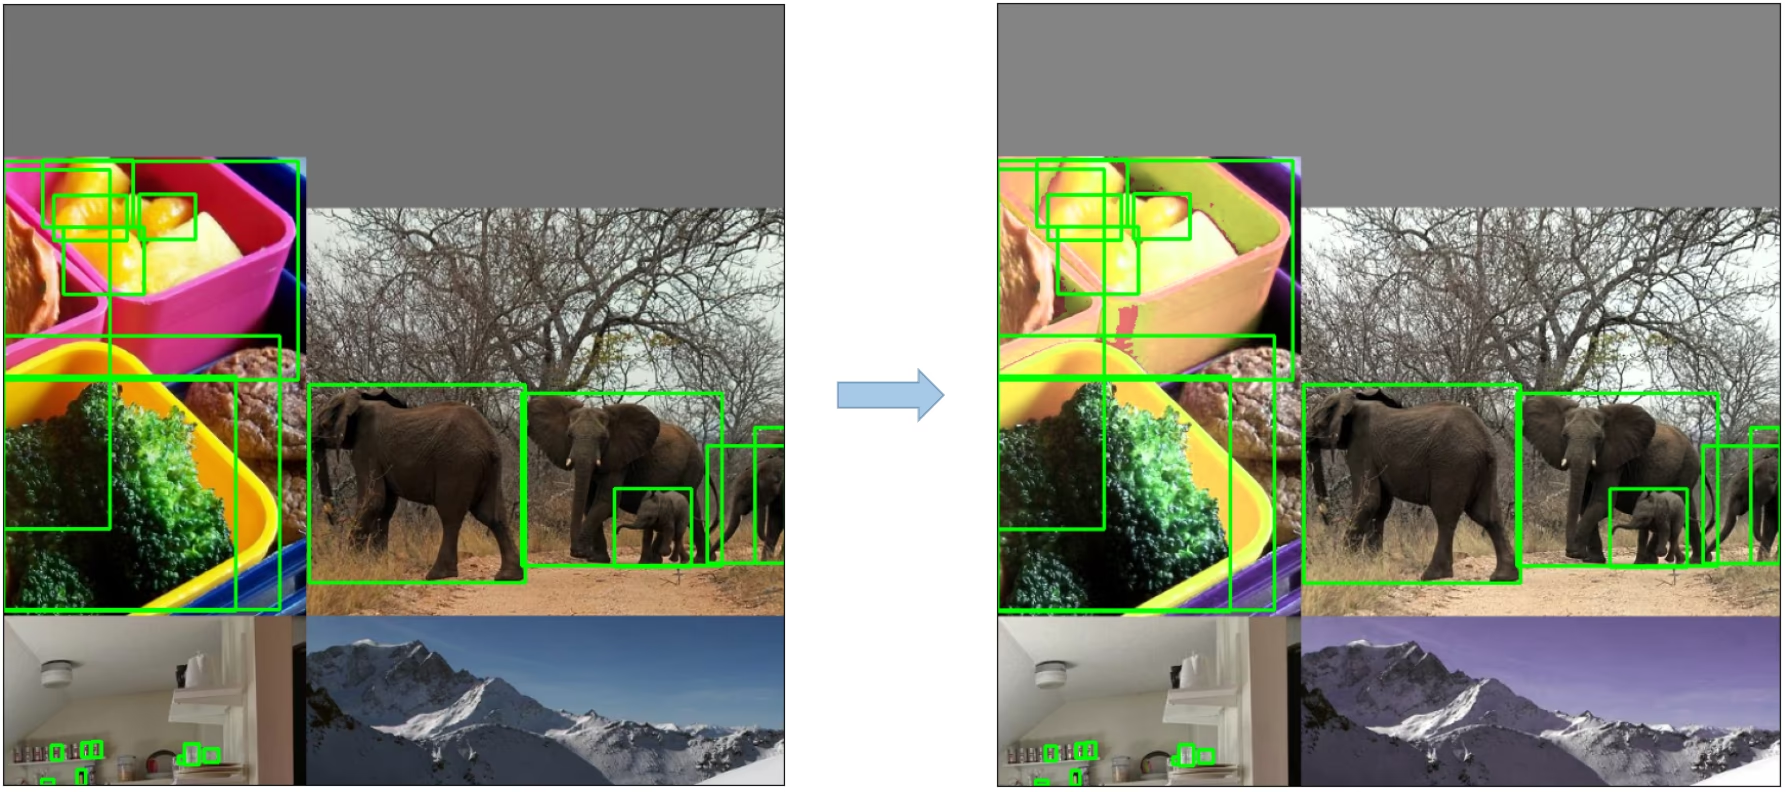
HSV-Erweiterung: Zufällige Änderungen an Farbton, Sättigung und Helligkeitswert der Bilder.
-
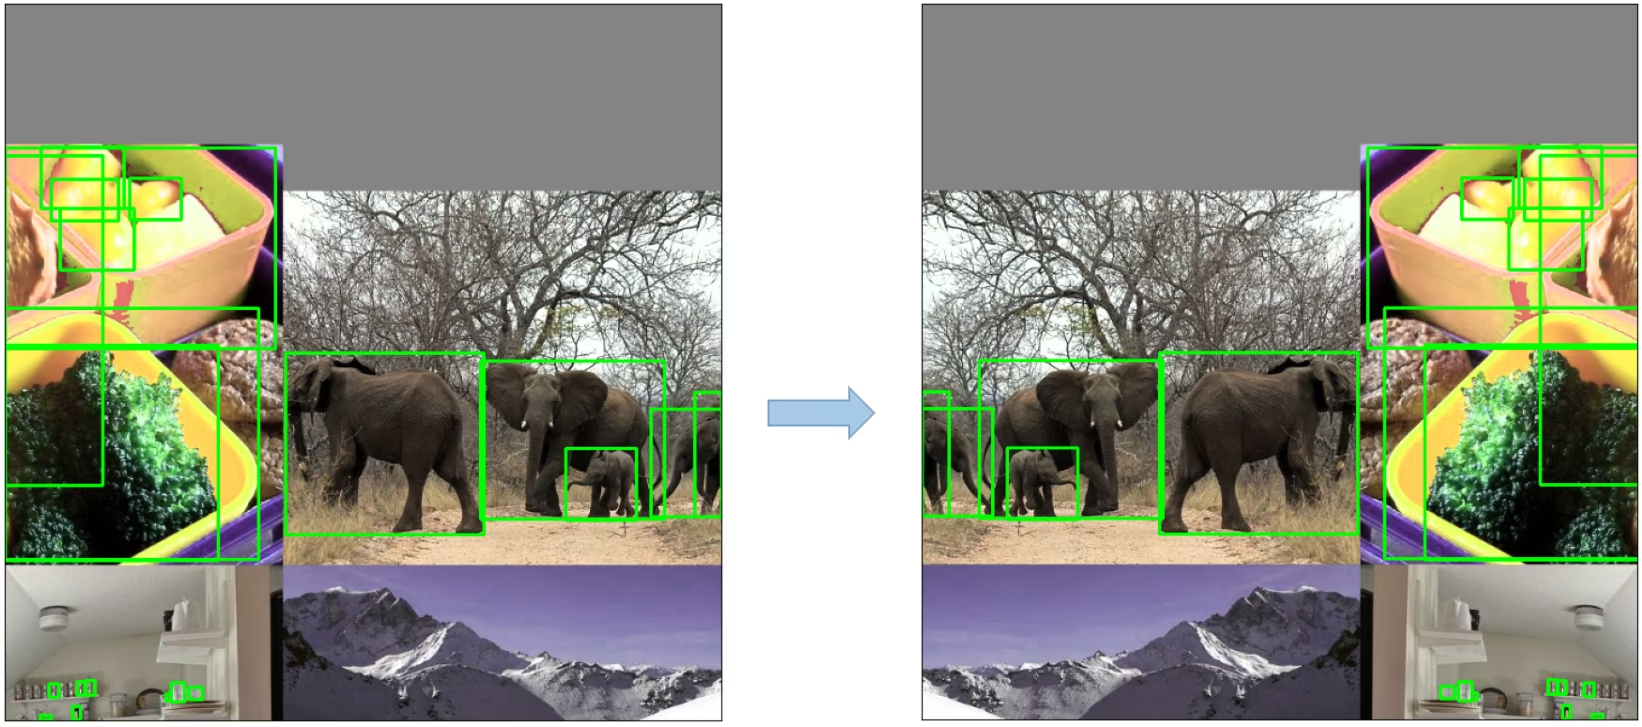
Zufälliges horizontales Spiegeln: Eine Erweiterungsmethode, bei der Bilder zufällig horizontal gespiegelt werden.
3. Trainingsstrategien#
YOLOv5 verwendet verschiedene Trainingsstrategien, um die Leistung des Modells zu verbessern. Dazu gehören:
- Training mit mehreren Bildgrößen: Während des Trainings werden die Eingabebilder innerhalb eines Bereichs vom 0,5- bis zum 1,5-Fachen ihrer ursprünglichen Größe zufällig skaliert.
- AutoAnchor: Diese Strategie optimiert die vorgegebenen Ankerboxen, damit sie den statistischen Eigenschaften der Ground-Truth-Boxen in deinen benutzerdefinierten Daten entsprechen.
- Aufwärmphase und Cosine-LR-Scheduler: Eine Methode zur Anpassung der Lernrate, um die Modellleistung zu verbessern.
- Exponentieller gleitender Durchschnitt (EMA): Eine Strategie, die den Durchschnitt der Parameter über vorherige Schritte hinweg verwendet, um den Trainingsprozess zu stabilisieren und den Generalisierungsfehler zu verringern.
- Training mit gemischter Genauigkeit: Ein Verfahren, bei dem Operationen mit dem Format halbe Genauigkeit ausgeführt werden, um den Speicherbedarf zu senken und die Rechengeschwindigkeit zu erhöhen.
- Hyperparameter-Evolution: Eine Strategie zur automatischen Optimierung von Hyperparametern, um eine optimale Leistung zu erzielen. Siehe das Tutorial zur Hyperparameter-Evolution.
4. Zusätzliche Funktionen#
4.1 Verluste berechnen#
Der Verlust von YOLOv5 wird als Kombination aus drei einzelnen Verlustkomponenten berechnet:
- Klassifikationsverlust (BCE-Verlust): Der binäre Kreuzentropieverlust misst den Fehler bei der Klassifikationsaufgabe.
- Objektheitsverlust (BCE-Verlust): Ein weiterer binärer Kreuzentropieverlust, der den Fehler bei der Erkennung berechnet, ob sich ein Objekt in einer bestimmten Gitterzelle befindet.
- Positionsverlust (CIoU-Verlust): Der vollständige IoU-Verlust misst den Fehler bei der Lokalisierung des Objekts innerhalb der Gitterzelle.
Die gesamte Verlustfunktion wird wie folgt dargestellt:
4.2 Verluste gewichten#
Die Objektheitsverluste der drei Vorhersageschichten (P3, P4, P5) werden unterschiedlich gewichtet. Die entsprechenden Gewichtungsfaktoren sind [4.0, 1.0, 0.4]. So wird sichergestellt, dass die Vorhersagen auf unterschiedlichen Maßstäben angemessen zum Gesamtverlust beitragen.
4.3 Gitterempfindlichkeit beseitigen#
Die YOLOv5-Architektur nimmt im Vergleich zu früheren YOLO-Versionen wichtige Änderungen an der Strategie zur Boxvorhersage vor. In YOLOv2 und YOLOv3 wurden die Boxkoordinaten direkt mithilfe der Aktivierung der letzten Schicht vorhergesagt.

In YOLOv5 wurde die Formel zur Vorhersage der Boxkoordinaten jedoch überarbeitet, um die Gitterempfindlichkeit zu verringern und zu verhindern, dass das Modell unbegrenzte Boxabmessungen vorhersagt.
Die überarbeiteten Formeln zur Berechnung der vorhergesagten Bounding Box lauten:
Vergleiche die Verschiebung des Mittelpunkts vor und nach der Skalierung. Der Wertebereich der Verschiebung des Mittelpunkts ändert sich von (0, 1) zu (-0.5, 1.5). Dadurch kann die Verschiebung leichter 0 oder 1 erreichen.

Vergleiche das Skalierungsverhältnis von Höhe und Breite (relativ zum Anker) vor und nach der Anpassung. Die ursprünglichen YOLO-/Darknet-Boxgleichungen weisen einen schwerwiegenden Fehler auf. Breite und Höhe sind vollständig unbeschränkt, da sie einfach out=exp(in) entsprechen. Das ist gefährlich, weil es zu außer Kontrolle geratenden Gradienten, Instabilitäten, NaN-Verlusten und letztlich zum vollständigen Scheitern des Trainings führen kann.

4.4 Zielwerte erstellen#
Das Erstellen der Zielwerte in YOLOv5 ist entscheidend für die Trainingseffizienz und Modellgenauigkeit. Dabei werden Ground-Truth-Boxen den passenden Gitterzellen in der Ausgabekarte zugeordnet und mit den entsprechenden Ankerboxen abgeglichen.
Dieser Prozess umfasst die folgenden Schritte:
- Berechne das Verhältnis zwischen den Abmessungen der Ground-Truth-Box und den Abmessungen jeder Ankervorlage.

- Liegt das berechnete Verhältnis innerhalb des Schwellenwerts, gleiche die Ground-Truth-Box mit dem entsprechenden Anker ab.

- Weise den abgeglichenen Anker den passenden Zellen zu. Beachte dabei, dass eine Ground-Truth-Box aufgrund des überarbeiteten Versatzes des Mittelpunkts mehreren Ankern zugeordnet werden kann: Der Wertebereich des Versatzes wurde von (0, 1) auf (-0.5, 1.5) erweitert, wodurch weitere Zuordnungen möglich sind.

So wird beim Erstellen der Zielwerte sichergestellt, dass jedes Ground-Truth-Objekt während des Trainings korrekt zugeordnet und abgeglichen wird. Dadurch kann YOLOv5 die Objekterkennung effektiver erlernen.
Fazit#
YOLOv5 ist ein bedeutender Fortschritt in der Entwicklung der Objekterkennung in Echtzeit. Die Architekturentscheidungen, Trainingsstrategien und technischen Verbesserungen sorgen im Vergleich zu früheren YOLO-Versionen für hohe Leistung und Effizienz.
Zu den wichtigsten Verbesserungen in YOLOv5 gehören Verfeinerungen der Architektur wie der 6x6 Conv2d-Stem und SPPF, eine breite Palette an Datenerweiterungstechniken, Trainingsstrategien wie AutoAnchor und EMA sowie Anpassungen der Verlustberechnung und des Target-Buildings. Zusammen verbessern diese Maßnahmen die Genauigkeit und Effizienz der Objekterkennung, ohne die für YOLO-Modelle typische Geschwindigkeit zu beeinträchtigen.
Häufig gestellte Fragen#
Ein CSPDarknet53-Backbone extrahiert Merkmale, ein SPPF- und PANet-Neck führt sie über verschiedene Maßstäbe hinweg zusammen, und ein Head im Stil von YOLOv3 sagt Boxen, Objektheit und Klassen bei den Strides 8, 16 und 32 vorher. Die vollständige Schichtenliste findest du unter
models/yolov5l.yaml.SPPF reiht drei Max-Pooling-Operationen mit 5x5 hintereinander, statt 5x5-, 9x9- und 13x13-Pooling parallel auszuführen. Die Ausgabe ist mathematisch identisch, wird aber mehr als doppelt so schnell berechnet, wie das obige Profiling-Beispiel zeigt.
Der ursprüngliche YOLO-Versatz konnte nie genau 0 oder 1 erreichen, weshalb Objekte mit einem Mittelpunkt auf den Gittergrenzen schwer vorherzusagen waren. Durch die Skalierung der Sigmoid-Funktion auf den Bereich (-0.5, 1.5) wird diese Gitterempfindlichkeit beseitigt. Das Quadrieren von
2σfür Breite und Höhe begrenzt die Vorhersagen auf das Vierfache der Ankergröße und verhindert so die außer Kontrolle geratenden Gradienten der unbeschränkten Exponentialfunktion.Jeder Anker, dessen Breiten- und Höhenverhältnisse zur Box innerhalb von
anchor_tliegen (standardmäßig 4.0), gilt als Treffer. Durch den erweiterten Versatzbereich kann die Box außerdem den beiden benachbarten Gitterzellen zugewiesen werden. Ein einzelnes Objekt kann daher mehrere positive Zielwerte erzeugen, was die Konvergenz beschleunigt.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.