YOLOv5 mit DeepSparse von Neural Magic bereitstellen#
Neural Magic wurde im Januar 2025 von Red Hat übernommen und stellte die Community-Versionen von DeepSparse, SparseML, SparseZoo und Sparsify am 2. Juni 2025 ein. Die Tools funktionieren weiterhin, erhalten aber keine Aktualisierungen oder Unterstützung mehr. Für weiterhin gepflegte CPU-Beschleunigung siehe die Integrationen für OpenVINO und ONNX.
Diese Anleitung erklärt, wie du YOLOv5 mit Neural Magics DeepSparse bereitstellst. Im Paket ultralytics übernimmt die Neural-Magic-Integration dieselbe Funktion.
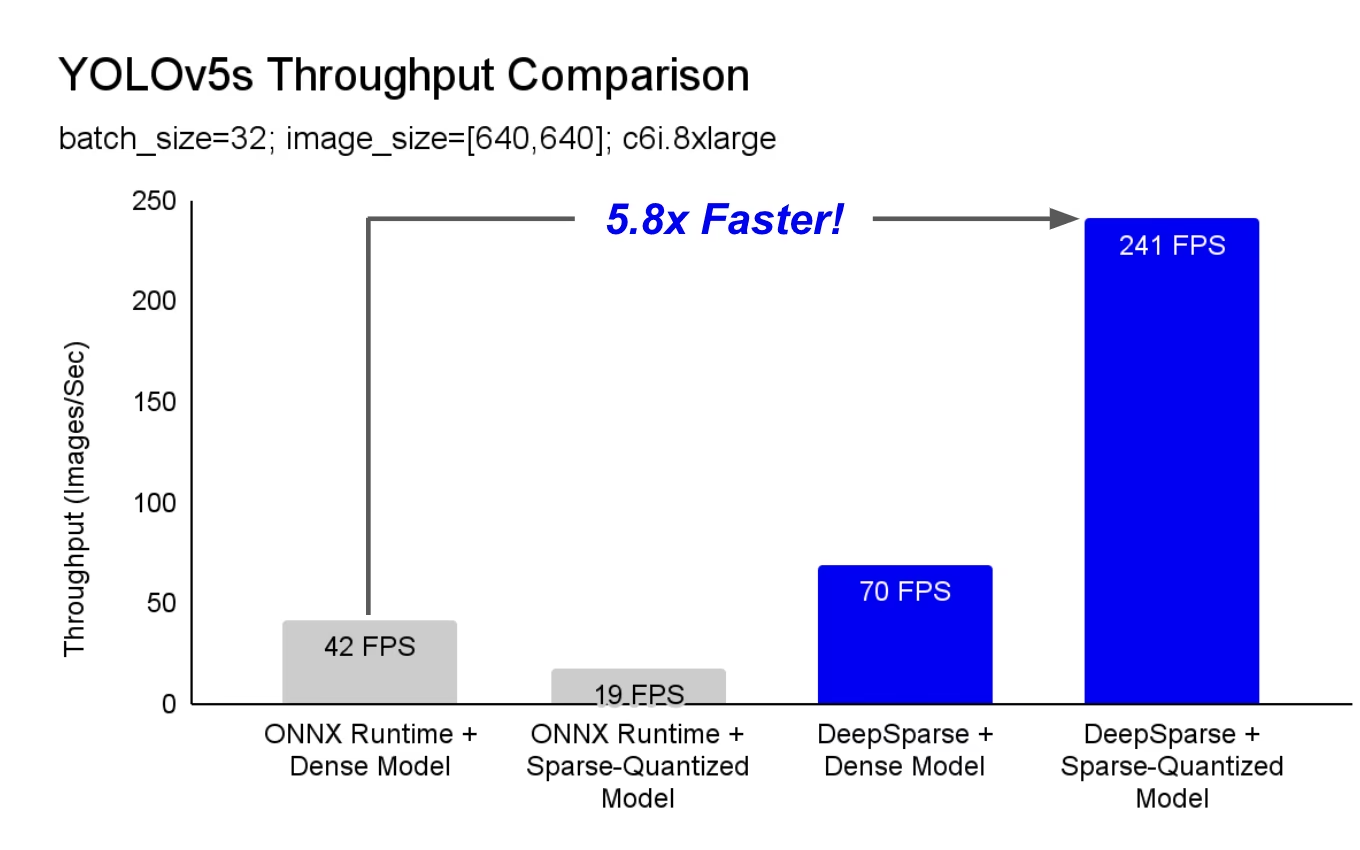
DeepSparse ist eine für CPUs optimierte Inferenzlaufzeitumgebung. In den folgenden Benchmarks läuft ein beschnittenes und quantisiertes YOLOv5s mit DeepSparse auf demselben Rechner 5,8-mal schneller als das dichte Modell in ONNX Runtime.
DeepSparse soll Deep-Learning-Workloads ermöglichen, die Leistungsanforderungen der Produktion auf CPUs zu erfüllen – ohne die Komplexität und Kosten dedizierter Hardwarebeschleuniger:
- Flexible Bereitstellung: Sorge für einen einheitlichen Betrieb in der Cloud, im Rechenzentrum und am Netzwerkrand – mit beliebiger Hardware von Intel, AMD oder ARM.
- Skalierbarkeit: Vertikal auf Hunderte von Kernen skalieren, mit Standard-Kubernetes horizontal skalieren oder mit Serverless vollständig abstrahieren.
- Einfache Integration: APIs zur Integration deines Modells in eine Anwendung und zur Überwachung im Produktivbetrieb.
Wie erreicht DeepSparse eine Leistung auf GPU-Niveau?#
DeepSparse nutzt die Sparsität des Modells, um die Leistung zu steigern.
Die durch Beschneidung und Quantisierung erzielte Ausdünnung ist ein breit untersuchtes Verfahren. Damit lassen sich Größe und Rechenaufwand für die Ausführung eines Netzwerks um Größenordnungen verringern, während eine hohe Genauigkeit erhalten bleibt. DeepSparse berücksichtigt die Sparsität und überspringt daher auf null gesetzte Parameter, wodurch sich der Rechenaufwand eines Forward-Passes verringert. Da die dünnbesetzte Berechnung nun durch den Speicher begrenzt ist, führt DeepSparse das Netzwerk schichtweise aus und zerlegt das Problem in Tensorkolumnen, also vertikale Berechnungsstreifen, die in den Cache passen.
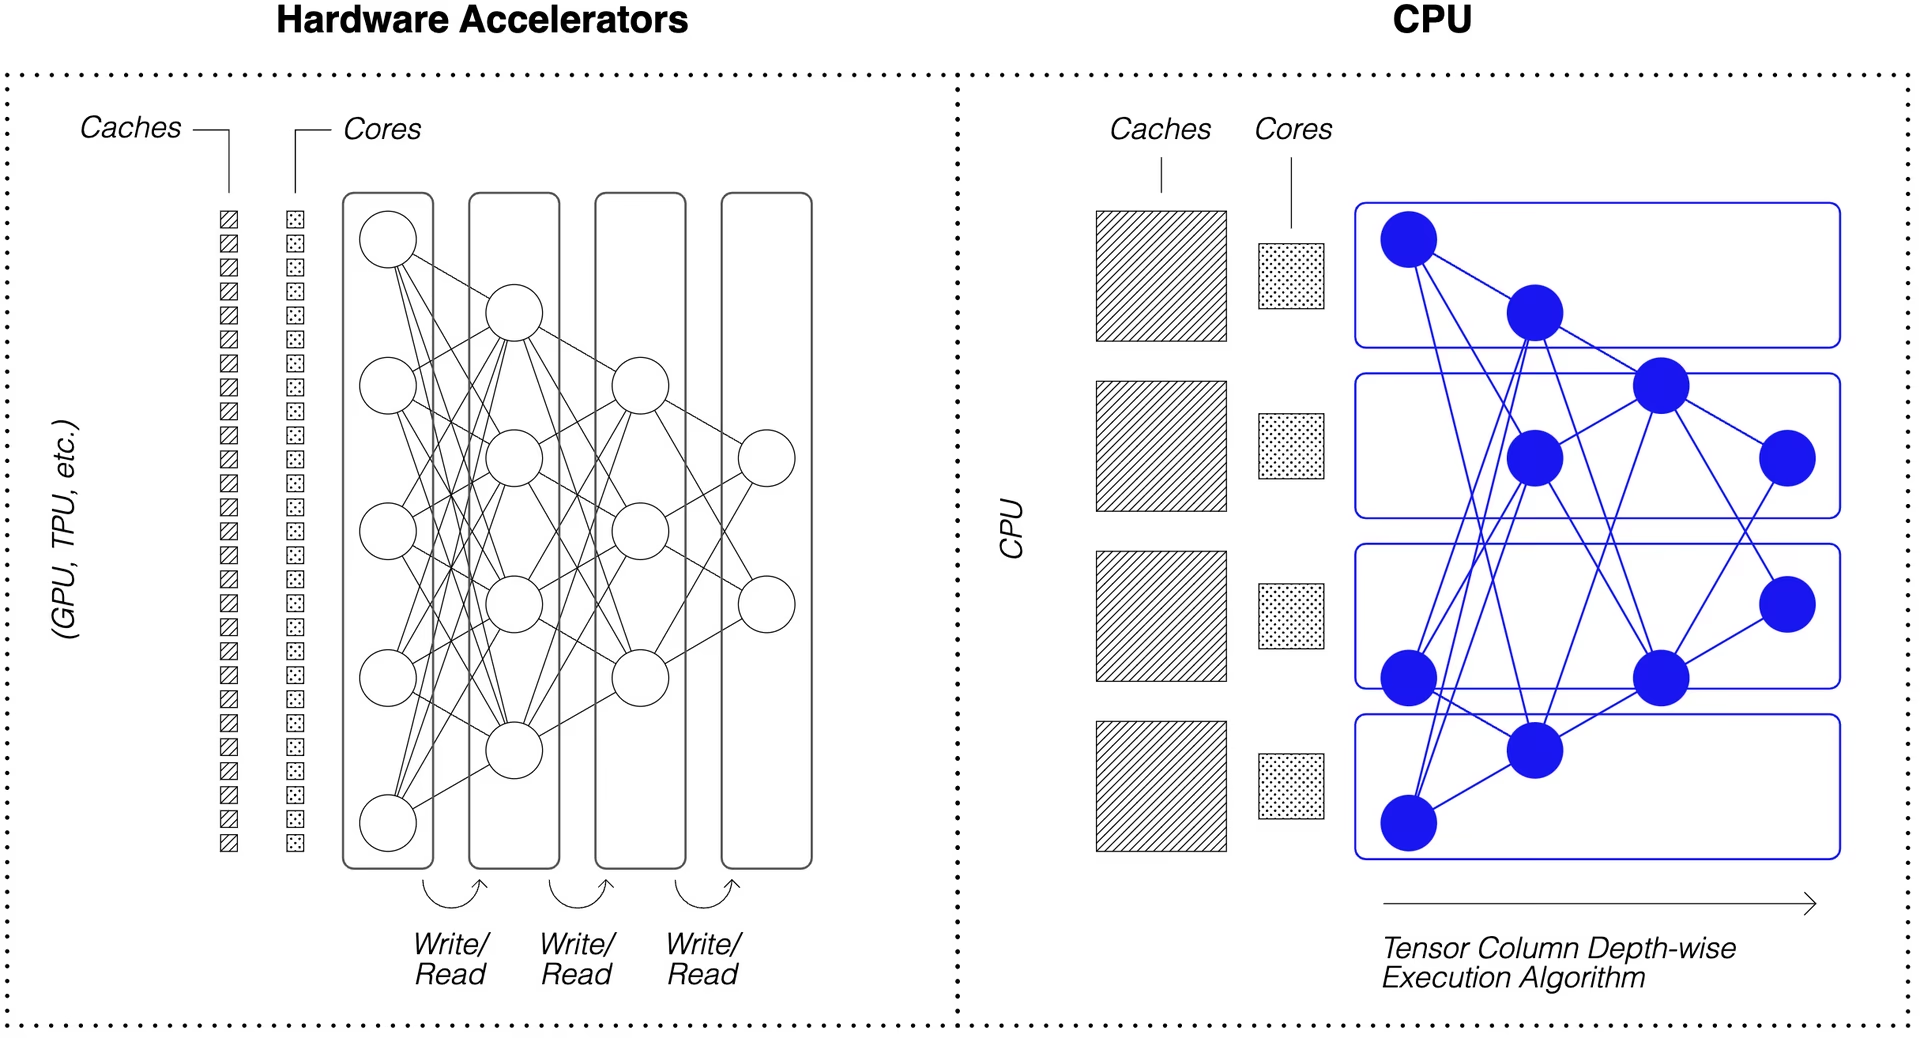
Die schichtweise Ausführung dünnbesetzter Netzwerke im Cache ermöglicht DeepSparse eine schnelle Inferenz auf CPUs.
Wie erstelle ich eine dünnbesetzte Version von YOLOv5, die mit meinen Daten trainiert wurde?#
Das Open-Source-Modellrepository SparseZoo von Neural Magic enthält bereits dünnbesetzte Checkpoints für jedes YOLOv5-Modell. Mit SparseML, das in Ultralytics integriert ist, kannst du einen dünnbesetzten Checkpoint mit nur einem CLI-Befehl auf deine Daten feinabstimmen.
Weitere Informationen findest du in der SparseML-Integration für YOLOv5.
DeepSparse verwenden#
Wir führen dich durch ein Beispiel, in dem wir eine dünnbesetzte Version von YOLOv5s mit DeepSparse benchmarken und bereitstellen.
DeepSparse installieren#
Führe den folgenden Befehl aus, um DeepSparse zu installieren. Wir empfehlen, eine virtuelle Python-Umgebung zu verwenden.
pip install "deepsparse[server,yolo,onnxruntime]"Eine ONNX-Datei beschaffen#
DeepSparse akzeptiert ein Modell im ONNX-Format, das auf eine der folgenden Arten angegeben wird:
- Als SparseZoo-Stub, der eine ONNX-Datei in SparseZoo referenziert
- Als lokaler Pfad zu einem ONNX-Modell im Dateisystem
Die folgenden Beispiele verwenden die Standard- und die geprunten und quantisierten YOLOv5s-Checkpoints, die durch die folgenden SparseZoo-Stubs identifiziert werden:
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Ein Modell bereitstellen#
DeepSparse bietet praktische APIs, mit denen du dein Modell in eine Anwendung integrieren kannst.
Um die folgenden Bereitstellungsbeispiele auszuprobieren, lade ein Beispielbild herunter und speichere es unter basilica.jpg:
wget -O basilica.jpg https://raw.githubusercontent.com/neuralmagic/deepsparse/main/src/deepsparse/yolo/sample_images/basilica.jpgPython-API#
Pipelines kapselt die Vorverarbeitung und die Nachverarbeitung der Ausgabe um die Laufzeitumgebung und bietet so eine klare Schnittstelle, um DeepSparse in eine Anwendung einzubinden. Die DeepSparse-Ultralytics-Integration umfasst eine sofort einsatzbereite Pipeline, die Rohbilder entgegennimmt und die Begrenzungsrahmen ausgibt.
Erstelle eine Pipeline und führe eine Inferenz aus:
from deepsparse import Pipeline

# # Liste der Bilder im lokalen Dateisystem
images = ["basilica.jpg"]

# # Pipeline erstellen
model_stub = "zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none"
yolo_pipeline = Pipeline.create(
    task="yolo",
    model_path=model_stub,
)

# # Inferenz mit den Bildern ausführen und Bounding Boxes sowie Klassen erhalten
pipeline_outputs = yolo_pipeline(images=images, iou_thres=0.6, conf_thres=0.001)
print(pipeline_outputs)
Wenn du in der Cloud arbeitest, kann ein Fehler auftreten, weil OpenCV libGL.so.1 nicht findet. Du kannst die fehlende Bibliothek installieren:
apt-get install libgl1Oder verwende die Headless-Version von OpenCV, die vollständig auf GUI-Abhängigkeiten verzichtet:
pip install opencv-python-headlessHTTP-Server#
DeepSparse Server läuft auf dem beliebten FastAPI-Webframework und dem Uvicorn-Webserver. Mit einem einzigen CLI-Befehl kannst du mit DeepSparse einen Modellservice-Endpunkt einrichten. Der Server unterstützt jede Pipeline von DeepSparse, darunter Objekterkennung mit YOLOv5. So kannst du Rohbilder an den Endpunkt senden und die Begrenzungsrahmen empfangen.
Starte den Server mit der geprunten und quantisierten Version von YOLOv5s:
deepsparse.server \
  --task yolo \
  --model_path zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
Eine Beispielanfrage mit dem Python-Paket requests:
import json
from contextlib import ExitStack

import requests

# # Liste der Bilder für die Inferenz (lokale Dateien auf der Clientseite)
path = ["basilica.jpg"]

# # Anfrage über HTTP an den Endpunkt /predict/from_files senden
url = "http://0.0.0.0:5543/predict/from_files"
with ExitStack() as stack:
    files = [("request", stack.enter_context(open(img, "rb"))) for img in path]
    resp = requests.post(url=url, files=files)

# # Antwort wird als JSON zurückgegeben
annotations = json.loads(resp.text)  # # Wörterbuch mit den Annotationsergebnissen
bounding_boxes = annotations["boxes"]
labels = annotations["labels"]Annotate-CLI#
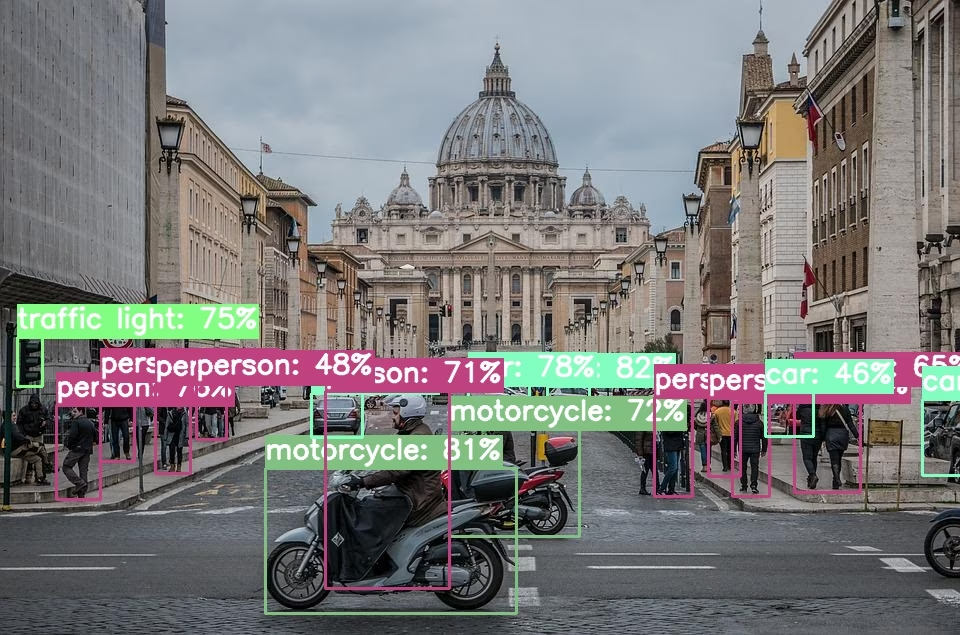
Du kannst außerdem den annotate-Befehl verwenden, damit die Engine ein annotiertes Foto auf der Festplatte speichert. Probiere --source 0 aus, um deinen Live-Webcam-Stream zu annotieren.
deepsparse.object_detection.annotate --model_filepath zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none --source basilica.jpgWenn du den obigen Befehl ausführst, wird ein Ordner namens annotation-results erstellt und das annotierte Bild darin gespeichert.
Leistungsvergleich#
Wir vergleichen den Durchsatz von DeepSparse mit dem Durchsatz von ONNX Runtime für YOLOv5s und verwenden dafür das Benchmarkskript von DeepSparse.
Die Benchmarks wurden auf einer AWS-c6i.8xlarge-Instanz mit 16 Kernen ausgeführt.
Leistungsvergleich mit Batchgröße 32#
ONNX Runtime als Referenz#
Bei einer Batchgröße von 32 erreicht ONNX Runtime mit dem standardmäßigen dichten YOLOv5s 42 Bilder/s:
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 41.9025
DeepSparse-Leistung mit dichtem Modell#
DeepSparse erzielt zwar die beste Leistung mit optimierten dünn besetzten Modellen, arbeitet aber auch mit dem standardmäßigen dichten YOLOv5s gut.
Bei einer Batchgröße von 32 verarbeitet DeepSparse mit dem standardmäßigen dichten YOLOv5s 70 Bilder pro Sekunde – eine 1,7-fache Steigerung gegenüber ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 69.5546
DeepSparse-Leistung mit dünn besetztem Modell#
Wird das Modell dünn besetzt, fällt der Leistungsvorsprung von DeepSparse gegenüber ONNX Runtime noch deutlicher aus.
Bei einer Batchgröße von 32 verarbeitet DeepSparse mit dem beschnittenen und quantisierten YOLOv5s 241 Bilder pro Sekunde – eine 5,8-fache Steigerung gegenüber ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 32 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 32
# Scenario: sync
# Throughput (items/sec): 241.2452
Leistungsvergleich mit Batchgröße 1#
Auch bei der latenzkritischen Batchgröße 1 erzielt DeepSparse eine höhere Geschwindigkeit als ONNX Runtime.
ONNX Runtime als Referenz#
Bei einer Batchgröße von 1 erreicht ONNX Runtime mit dem standardmäßigen dichten YOLOv5s 48 Bilder/s.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none -s sync -b 1 -nstreams 1 -e onnxruntime

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/base-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 48.0921
DeepSparse-Leistung mit dünn besetztem Modell#
Bei einer Batchgröße von 1 verarbeitet DeepSparse mit einem beschnittenen und quantisierten YOLOv5s 135 Elemente pro Sekunde – eine 2,8-fache Steigerung gegenüber ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned65_quant-none
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 134.9468
Da c6i.8xlarge-Instanzen VNNI-Befehle unterstützen, lässt sich der Durchsatz von DeepSparse noch weiter steigern, wenn die Gewichte in Blöcken zu je 4 beschnitten werden.
Bei einer Batchgröße von 1 verarbeitet DeepSparse mit einem beschnittenen und quantisierten YOLOv5s mit vier Blöcken 180 Elemente pro Sekunde – eine 3,7-fache Steigerung gegenüber ONNX Runtime.
deepsparse.benchmark zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni -s sync -b 1 -nstreams 1

# Original Model Path: zoo:cv/detection/yolov5-s/pytorch/ultralytics/coco/pruned35_quant-none-vnni
# Batch Size: 1
# Scenario: sync
# Throughput (items/sec): 179.7375
Erste Schritte mit DeepSparse#
Forschung oder Tests? DeepSparse Community ist für Forschung und Tests kostenlos. Starte mit der DeepSparse-README.
Weitere Informationen zum Bereitstellen von YOLOv5 mit DeepSparse findest du in den DeepSparse-Beispielen für YOLOv5 und im Ultralytics-Blogbeitrag zur DeepSparse-Integration.
Häufig gestellte Fragen#
Nein. DeepSparse ist eine CPU-Laufzeitumgebung, und die obigen Benchmarks wurden auf einer AWS-
c6i.8xlarge-Instanz mit 16 Kernen und ohne Beschleuniger gemessen.Exportiere es mit
python export.py --weights best.pt --include onnxnach ONNX und übergib den Dateipfad alsmodel_pathstatt eines SparseZoo-Platzhalters. Auch dichte Modelle profitieren von der Laufzeitumgebung, beschnittene und quantisierte Modelle jedoch am meisten.Passe einen der vorab dünn besetzten SparseZoo-Checkpoints mit SparseML an deine Daten an. Dabei bleibt die Struktur der dünnen Besetzung während des Trainings erhalten. Exportiere das Modell anschließend nach ONNX.
Nein. Die Community-Versionen wurden am 2. Juni 2025 eingestellt, und die Pakete auf PyPI werden nicht mehr aktualisiert. Bestehende Pipelines funktionieren weiterhin, aber für neue Bereitstellungen solltest du die aktiv gepflegten Varianten OpenVINO oder ONNX Runtime in Betracht ziehen.
Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.