Modell-Ensembling mit YOLOv5#
📚 Diese Anleitung erklärt, wie du beim Testen und bei der Inferenz Modell-Ensembling mit Ultralytics YOLOv5 🚀 einsetzt, um mAP und Recall zu verbessern.
Ausgehend von Ensemble-Lernen:
Beim Ensemble-Modellieren werden mehrere unterschiedliche Modelle erstellt, um ein Ergebnis vorherzusagen. Dafür können verschiedene Modellierungsalgorithmen oder unterschiedliche Sätze von Trainingsdaten verwendet werden. Das Ensemble-Modell führt anschließend die Vorhersagen der einzelnen Basismodelle zusammen und erstellt eine endgültige Vorhersage für bisher unbekannte Daten. Ensemble-Modelle sollen den Generalisierungsfehler der Vorhersage verringern. Solange die Basismodelle unterschiedlich und unabhängig sind, sinkt der Vorhersagefehler des Modells beim Einsatz des Ensemble-Ansatzes. Der Ansatz nutzt die Weisheit der Vielen für eine Vorhersage. Obwohl das Ensemble-Modell mehrere Basismodelle enthält, verhält es sich wie ein einzelnes Modell und funktioniert auch so.
Vor dem Start#
Klone das Repository und installiere requirements.txt in einer Umgebung mit Python>=3.8.0, einschließlich PyTorch>=1.8. Modelle und Datensätze werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Normal testen#
Ermittle vor dem Ensembling die Ausgangsleistung eines einzelnen Modells. Mit diesem Befehl testest du YOLOv5x auf COCO val2017 mit einer Bildgröße von 640 Pixeln. yolov5x.pt ist das größte und genaueste verfügbare Modell. Weitere Optionen sind yolov5n.pt, yolov5s.pt, yolov5m.pt und yolov5l.pt oder dein eigener Checkpoint, der mit einem benutzerdefinierten Datensatz trainiert wurde, zum Beispiel runs/train/exp/weights/best.pt. Einzelheiten zu allen verfügbaren Modellen findest du in der Tabelle der vortrainierten Checkpoints.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfAusgabe:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
Average Recall (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826Ensemble-Test#
Du kannst mehrere vortrainierte Modelle während des Tests und der Inferenz zu einem Ensemble kombinieren, indem du in einem vorhandenen val.py- oder detect.py-Befehl einfach weitere Modelle an das Argument --weights anhängst. Dieses Beispiel testet ein Ensemble aus zwei Modellen:
- YOLOv5x
- YOLOv5l6
python val.py --weights yolov5x.pt yolov5l6.pt --data coco.yaml --img 640 --halfDu kannst beliebig viele Checkpoints auflisten, darunter benutzerdefinierte Gewichte wie runs/train/exp5/weights/best.pt. YOLOv5 führt jedes Modell automatisch aus und führt die Vorhersagen für jedes Bild zusammen, bevor NMS angewendet wird.
Ausgabe:
val: data=./data/coco.yaml, weights=['yolov5x.pt', 'yolov5l6.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients  # Model 1
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients  # Model 2
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']  # Ensemble notice

val: Scanning '../datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:00<00:00, 49695545.02it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [03:58<00:00,  1.52s/it]
                 all       5000      36335      0.747      0.637      0.692      0.502
Speed: 0.1ms pre-process, 39.5ms inference, 2.0ms NMS per image at shape (32, 3, 640, 640)  # <--- ensemble speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.515  # <--- ensemble mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.699
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.557
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.356
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.563
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.668
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.387
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.638
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.689  # <--- ensemble mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.743
Average Recall (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.844Ensemble-Inferenz#
Hänge weitere Modelle an das Argument --weights an, um Ensemble-Inferenz auszuführen:
python detect.py --weights yolov5x.pt yolov5l6.pt --img 640 --source data/imagesAusgabe:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients
Fusing layers...
Model Summary: 501 layers, 77218620 parameters, 0 gradients
Ensemble created with ['yolov5x.pt', 'yolov5l6.pt']

image 1/2 /content/yolov5/data/images/bus.jpg: 640x512 4 persons, 1 bus, 1 tie, Done. (0.063s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 384x640 3 persons, 2 ties, Done. (0.056s)
Results saved to runs/detect/exp2
Done. (0.223s)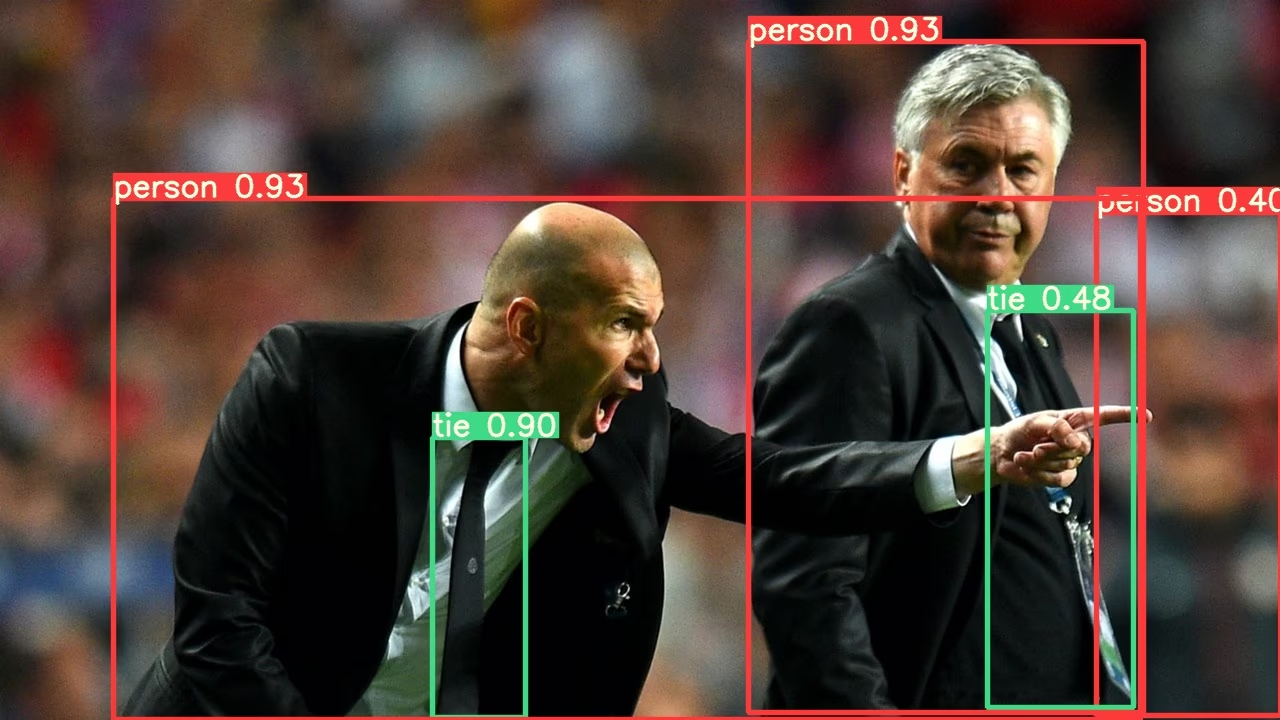
Vorteile des Modell-Ensemblings#
Modell-Ensembling mit YOLOv5 bietet mehrere Vorteile:
- Höhere Genauigkeit: Wie die obigen Beispiele zeigen, erhöht das Zusammenführen mehrerer Modelle mAP von 0.504 auf 0.515 und mAR von 0.681 auf 0.689.
- Bessere Generalisierung: Durch die Kombination unterschiedlicher Modelle lässt sich Overfitting verringern und die Leistung bei vielfältigen Daten verbessern.
- Höhere Robustheit: Ensembles sind in der Regel robuster gegenüber Rauschen und Ausreißern in den Daten.
- Ergänzende Stärken: Verschiedene Modelle können sich bei der Erkennung unterschiedlicher Objektarten oder unter verschiedenen Umgebungsbedingungen auszeichnen.
Der wichtigste Nachteil ist die längere Inferenzzeit, wie die Geschwindigkeitsmessungen zeigen (22.4 ms für ein einzelnes Modell gegenüber 39.5 ms für das Ensemble).
Wann solltest du Modell-Ensembling einsetzen?#
Modell-Ensembling bietet sich in folgenden Szenarien an:
- Wenn die Genauigkeit wichtiger ist als die Inferenzgeschwindigkeit
- Bei kritischen Anwendungen, bei denen falsch negative Ergebnisse minimiert werden müssen
- Bei der Verarbeitung anspruchsvoller Bilder mit wechselnder Beleuchtung, Verdeckung oder Skalierung
- Bei Wettbewerben oder Benchmarks, bei denen die maximale Leistung gefragt ist
Für Echtzeitanwendungen mit strengen Latenzanforderungen ist die Inferenz mit einem einzelnen Modell möglicherweise besser geeignet.
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen, in denen wichtige Abhängigkeiten wie CUDA, CUDNN, Python und PyTorch bereits installiert sind, damit du schnell mit deinen Projekten loslegen kannst.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Badge zeigt an, dass alle GitHub-Actions von YOLOv5 für die kontinuierliche Integration (CI) erfolgreich durchlaufen. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 in verschiedenen wichtigen Bereichen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden alle 24 Stunden sowie bei jedem neuen Commit ausgeführt.
Häufig gestellte Fragen#
Beliebig viele. Liste jeden Checkpoint nach
--weightsauf, zum Beispiel--weights yolov5x.pt yolov5l6.pt runs/train/exp/weights/best.pt. Die Inferenzzeit steigt ungefähr proportional zur Anzahl der Modelle.Ja. Da die Vorhersagen vor der Anwendung von NMS zusammengeführt werden, muss jedes Modell mit derselben Klassenliste in derselben Reihenfolge trainiert worden sein. Eingabegrößen und Architekturen dürfen sich unterscheiden.
Ja. Füge
--augmentdemselben Befehlval.pyoderdetect.pyhinzu, um TTA auf jedes Modell im Ensemble anzuwenden.Das Ensembling wird vom PyTorch-Modul
Ensembleinmodels/experimental.pyübernommen und gilt daher nur für.pt-Checkpoints. Exportiere jedes Modell einzeln, wenn du ONNX- oder TensorRT-Dateien benötigst.