Modellbeschneidung und Sparsität in YOLOv5#
📚 Diese Anleitung erklärt, wie du Modellbeschneidung auf YOLOv5-Modelle 🚀 anwendest, um effizientere Netzwerke zu erstellen und dabei die Leistung zu erhalten.
Was ist Modellbeschneidung?#
Modellbeschneidung ist eine Methode, mit der sich Größe und Komplexität neuronaler Netze verringern lassen, indem weniger wichtige Parameter (Gewichte und Verbindungen) entfernt werden. Dadurch entsteht ein effizienteres Modell mit mehreren Vorteilen:
- Geringere Modellgröße für eine einfachere Bereitstellung auf Geräten mit begrenzten Ressourcen
- Höhere Inferenzgeschwindigkeit bei minimalen Auswirkungen auf die Genauigkeit
- Geringerer Speicherbedarf und Energieverbrauch
- Höhere Gesamteffizienz für Echtzeitanwendungen
Bei der Modellbeschneidung werden Parameter ermittelt und entfernt, die nur wenig zur Leistung des Modells beitragen. So entsteht ein kompakteres Modell mit ähnlicher Genauigkeit.
Vor dem Start#
Klone das Repository und installiere requirements.txt in einer Umgebung mit Python>=3.8.0, einschließlich PyTorch>=1.8. Modelle und Datensätze werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Ausgangsleistung testen#
Ermittle vor der Modellbeschneidung die Ausgangsleistung, mit der du die Ergebnisse vergleichen kannst. Mit diesem Befehl testest du YOLOv5x auf COCO val2017 mit einer Bildgröße von 640 Pixeln. yolov5x.pt ist das größte und genaueste verfügbare Modell. Weitere Optionen sind yolov5s.pt, yolov5m.pt und yolov5l.pt oder dein eigener Checkpoint, der mit einem benutzerdefinierten Datensatz trainiert wurde, zum Beispiel runs/train/exp/weights/best.pt. Einzelheiten zu allen verfügbaren Modellen findest du in der Tabelle in der README.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfAusgabe:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:12<00:00,  2.16it/s]
                 all       5000      36335      0.732      0.628      0.683      0.496
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- base speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.507  # <--- base mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.689
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.552
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.345
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.559
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.652
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.381
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.630
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.682
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.526
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.731
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.829
Results saved to runs/val/exp2
Modellbeschneidung auf YOLOv5x anwenden (30 % Sparsität)#
Mit der in utils/torch_utils.py definierten Funktion prune() können wir das Modell beschneiden. Um ein beschnittenes Modell zu testen, ändern wir val.py, damit YOLOv5x auf eine Sparsität von 0.3 beschnitten wird (30 % der Gewichte werden auf null gesetzt):
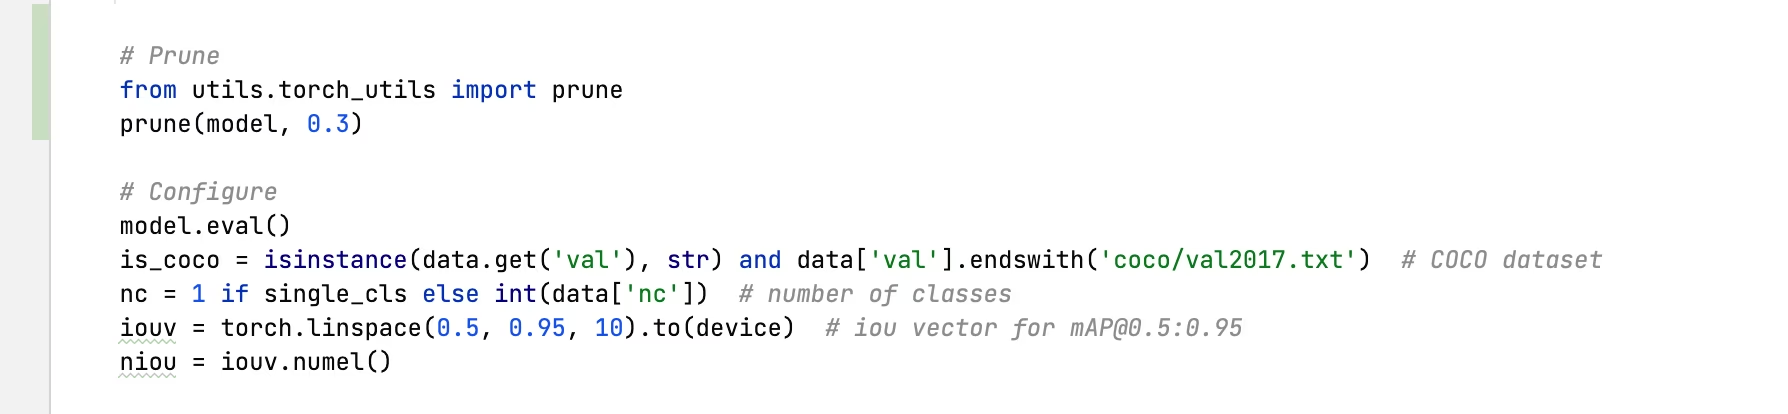
Ausgabe nach der Beschneidung um 30 %:
val: data=/content/yolov5/data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, workers=8, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True, dnn=False
YOLOv5 🚀 v6.0-224-g4c40933 torch 1.10.0+cu111 CUDA:0 (Tesla V100-SXM2-16GB, 16160MiB)

Fusing layers...
Model Summary: 444 layers, 86705005 parameters, 0 gradients
Pruning model...  0.3 global sparsity
val: Scanning '/content/datasets/coco/val2017.cache' images and labels... 4952 found, 48 missing, 0 empty, 0 corrupt: 100% 5000/5000 [00:00<?, ?it/s]
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [01:11<00:00,  2.19it/s]
                 all       5000      36335      0.724      0.614      0.671      0.478
Speed: 0.1ms pre-process, 5.2ms inference, 1.7ms NMS per image at shape (32, 3, 640, 640)  # <--- prune speed

Evaluating pycocotools mAP... saving runs/val/exp3/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.489  # <--- prune mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.677
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.537
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.334
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.542
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.635
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.370
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.612
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.664
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.496
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.722
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.803
Results saved to runs/val/exp3
Analyse der Ergebnisse#
Aus den Ergebnissen lässt sich Folgendes ablesen:
- 30 % Sparsität erreicht: 30 % der Gewichtsparameter des Modells in den
nn.Conv2d-Schichten sind jetzt null - Inferenzzeit unverändert: Trotz der Modellbeschneidung bleibt die Verarbeitungsgeschwindigkeit im Wesentlichen gleich
- Minimale Auswirkungen auf die Leistung: mAP sank leicht von 0.507 auf 0.489 (nur 3.6 % weniger)
- Modellgröße unverändert: Auf null gesetzte Gewichte werden weiterhin dicht gespeichert, daher wird die Datei nur mit sparsitätsbewussten Formaten oder durch Komprimierung kleiner
Das zeigt, dass sich die Modellkomplexität durch Beschneidung deutlich verringern lässt, ohne die Leistung wesentlich zu beeinträchtigen. Damit eignet sie sich gut als Optimierungsmethode für die Bereitstellung in Umgebungen mit begrenzten Ressourcen.
Beschnittene Modelle feinabstimmen#
Die besten Ergebnisse erzielst du, wenn du beschnittene Modelle anschließend feinabstimmst, um die Genauigkeit wiederherzustellen. Dazu kannst du:
- die Beschneidung mit dem gewünschten Sparsitätsgrad durchführen
- das beschnittene Modell einige Epochen lang mit einer niedrigeren Lernrate trainieren
- das feinabgestimmte, beschnittene Modell mit der Ausgangsversion vergleichen
So können sich die verbleibenden Parameter anpassen und die entfernten Verbindungen ausgleichen. Dabei lässt sich häufig der größte Teil oder sogar die gesamte ursprüngliche Genauigkeit wiederherstellen.
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen, in denen wichtige Abhängigkeiten wie CUDA, CUDNN, Python und PyTorch bereits installiert sind, damit du schnell mit deinen Projekten loslegen kannst.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Badge zeigt an, dass alle GitHub-Actions von YOLOv5 für die kontinuierliche Integration (CI) erfolgreich durchlaufen. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 in verschiedenen wichtigen Bereichen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden alle 24 Stunden sowie bei jedem neuen Commit ausgeführt.
Häufig gestellte Fragen#
Bei unstrukturierter Beschneidung werden Gewichte auf null gesetzt, die Tensorformen bleiben jedoch unverändert. Daher leisten dichte PyTorch-Kernels dieselbe Arbeit wie zuvor. Für eine höhere Geschwindigkeit ist eine sparsitätsbewusste Laufzeitumgebung wie DeepSparse oder eine strukturierte Beschneidung erforderlich, bei der ganze Kanäle entfernt werden.
Rufe den Hilfsfunktionsaufruf aus
utils/torch_utils.pyvor der Validierung oder dem Export auf:from utils.torch_utils import prune prune(model, amount=0.3) # 30 % globale Sparsität auf nn.Conv2d-GewichtenBeginne mit 0.3 und miss mAP. YOLOv5x verlor bei 30 % Sparsität ohne Feinabstimmung etwa 3.6 % mAP. Bei höheren Sparsitätsgraden sind normalerweise einige Epochen Nachtraining mit einer niedrigen Lernrate nötig, um die Genauigkeit wiederherzustellen.
Ja. Die auf null gesetzten Gewichte werden wie alle anderen gespeichert, sodass
export.pyunverändert funktioniert. Die Dateigröße verringert sich nur, wenn das Zielformat oder die Laufzeitumgebung dünn besetzte Tensoren komprimiert.