Hyperparameter-Evolution für YOLOv5#
📚 Diese Anleitung erklärt die Hyperparameter-Evolution für YOLOv5 🚀. Die Hyperparameter-Evolution ist eine Methode zur Hyperparameteroptimierung, bei der ein genetischer Algorithmus (GA) zur Optimierung verwendet wird.
Hyperparameter im maschinellen Lernen steuern verschiedene Aspekte des Trainings. Ihre optimalen Werte zu finden, kann eine Herausforderung sein. Herkömmliche Methoden wie Gittersuche sind aus folgenden Gründen schnell nicht mehr praktikabel:
- Der hochdimensionale Suchraum
- Unbekannte Zusammenhänge zwischen den Dimensionen
- Hohe Kosten für die Bewertung der Fitness an jedem Punkt
Daher eignen sich genetische Algorithmen gut für die Hyperparametersuche.
Vor dem Start#
Klone das Repository und installiere requirements.txt in einer Umgebung mit Python>=3.8.0, einschließlich PyTorch>=1.8. Modelle und Datensätze werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
1. Hyperparameter initialisieren#
YOLOv5 verwendet etwa 30 Hyperparameter für verschiedene Trainingseinstellungen. Diese sind in *.yaml-Dateien im Verzeichnis /data/hyps definiert. Bessere Anfangswerte führen zu besseren Endergebnissen. Deshalb ist es wichtig, die Werte vor der Evolution korrekt zu initialisieren. Im Zweifelsfall verwendest du einfach die Standardwerte, die für das Training von YOLOv5 auf COCO von Grund auf optimiert sind.
# YOLOv5 🚀 by Ultralytics, AGPL-3.0 license
# Hyperparameters for low-augmentation COCO training from scratch
# python train.py --batch 64 --cfg yolov5n6.yaml --weights '' --data coco.yaml --img 640 --epochs 300 --linear
# See tutorials for hyperparameter evolution https://github.com/ultralytics/yolov5#tutorials

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.01 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
2. Fitness definieren#
Fitness ist der Wert, den wir maximieren wollen. In YOLOv5 definieren wir eine Standard-Fitnessfunktion als gewichtete Kombination von Metriken: mAP@0.5 trägt 10 % zum Gewicht bei und mAP@0.5:0.95 die restlichen 90 %; Präzision (P) und Trefferquote (R) bleiben unberücksichtigt. Du kannst diese Gewichtung nach Bedarf anpassen oder die empfohlene Standarddefinition der Fitnessfunktion in utils/metrics.py verwenden. Diese Fitnessfunktion bestimmt, welches Ergebnis unter hyp_evolve.yaml gespeichert wird. Der genetische Algorithmus ordnet Eltern und Eliten jedoch allein nach mAP@0.5, sodass Änderungen an diesen Gewichten die Auswahl der Eltern nicht beeinflussen.
def fitness(x):
    """Return model fitness as the sum of weighted metrics [P, R, mAP@0.5, mAP@0.5:0.95]."""
    w = [0.0, 0.0, 0.1, 0.9]  # Gewichte für [P, R, mAP@0.5, mAP@0.5:0.95]
    return (x[:, :4] * w).sum(1)
3. Weiterentwickeln#
Die Weiterentwicklung erfolgt ausgehend von einem Basisszenario, das wir verbessern möchten. Das Basisszenario in diesem Beispiel ist das Feinabstimmen von COCO128 über 10 Epochen mit vortrainiertem YOLOv5s. Der Trainingsbefehl für das Basisszenario lautet:
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cacheUm Hyperparameter speziell für dieses Szenario weiterzuentwickeln, ausgehend von unseren in Abschnitt 1. definierten Anfangswerten und mit dem Ziel, die in Abschnitt 2. definierte Fitness zu maximieren, füge --evolve hinzu:
# Single-GPU
python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --evolve

# Multi-GPU with delay
for i in {0..7}; do
  sleep $((30 * i)) # 30-second delay (optional)
  echo "Starting GPU $i..."
  nohup python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log" &
done

# Continuous training (use with caution)
# for i in {0..7}; do
#   sleep $((30 * i))  # 30-second delay (optional)
#   echo "Starting continuous training on GPU $i..."
#   (
#     while true; do
#       python train.py --epochs 10 --data coco128.yaml --weights yolov5s.pt --cache --device $i --evolve > "evolve_gpu_$i.log"
#     done
#   ) &
# done
Die Standardeinstellungen für die Evolution führen 300 Generationen aus. In jeder Generation wird das Basisszenario einmal für jedes der 50 Individuen in der Population trainiert. Du kannst die Anzahl der Generationen über das Argument --evolve ändern, zum Beispiel mit python train.py --evolve 1000.
Die wichtigsten genetischen Operatoren sind Kreuzung und Mutation. In jeder Generation wird jedes Individuum trainiert und anhand von mAP@0.5 bewertet. Die Eltern werden durch Turnierselektion ausgewählt, wobei die fittesten Eliten dem Elternpool hinzugefügt werden. Die nächste Population entsteht durch Kreuzung und Mutation mit Raten, die sich im Verlauf der Evolution anpassen. Die Ergebnisse werden in runs/evolve/exp/evolve.csv protokolliert, und die Nachkommen mit der höchsten Fitness werden in jeder Generation als runs/evolve/exp/hyp_evolve.yaml gespeichert:
# YOLOv5 Hyperparameter Evolution Results
# Best generation: 287
# Last generation: 300
#    metrics/precision,       metrics/recall,      metrics/mAP_0.5, metrics/mAP_0.5:0.95,         val/box_loss,         val/obj_loss,         val/cls_loss
#              0.54634,              0.55625,              0.58201,              0.33665,             0.056451,             0.042892,             0.013441

lr0: 0.01 # initial learning rate (SGD=1E-2, Adam=1E-3)
lrf: 0.2 # final OneCycleLR learning rate (lr0 * lrf)
momentum: 0.937 # SGD momentum/Adam beta1
weight_decay: 0.0005 # optimizer weight decay 5e-4
warmup_epochs: 3.0 # warmup epochs (fractions ok)
warmup_momentum: 0.8 # warmup initial momentum
warmup_bias_lr: 0.1 # warmup initial bias lr
box: 0.05 # box loss gain
cls: 0.5 # cls loss gain
cls_pw: 1.0 # cls BCELoss positive_weight
obj: 1.0 # obj loss gain (scale with pixels)
obj_pw: 1.0 # obj BCELoss positive_weight
iou_t: 0.20 # IoU training threshold
anchor_t: 4.0 # anchor-multiple threshold
# anchors: 3  # anchors per output layer (0 to ignore)
fl_gamma: 0.0 # focal loss gamma (efficientDet default gamma=1.5)
hsv_h: 0.015 # image HSV-Hue augmentation (fraction)
hsv_s: 0.7 # image HSV-Saturation augmentation (fraction)
hsv_v: 0.4 # image HSV-Value augmentation (fraction)
degrees: 0.0 # image rotation (+/- deg)
translate: 0.1 # image translation (+/- fraction)
scale: 0.5 # image scale (+/- gain)
shear: 0.0 # image shear (+/- deg)
perspective: 0.0 # image perspective (+/- fraction), range 0-0.001
flipud: 0.0 # image flip up-down (probability)
fliplr: 0.5 # image flip left-right (probability)
mosaic: 1.0 # image mosaic (probability)
mixup: 0.0 # image mixup (probability)
copy_paste: 0.0 # segment copy-paste (probability)
Für beste Ergebnisse empfehlen wir mindestens 300 Evolutionsgenerationen. Beachte, dass Evolution in der Regel teuer und zeitaufwendig ist, da das Basisszenario tausende Male trainiert wird und möglicherweise Hunderte oder Tausende GPU-Stunden erfordert.
Wenn die Evolution abgeschlossen ist, kannst du die gefundenen Einstellungen wiederverwenden, indem du beim Training auf die gespeicherte Datei verweist, zum Beispiel mit python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.
4. Visualisieren#
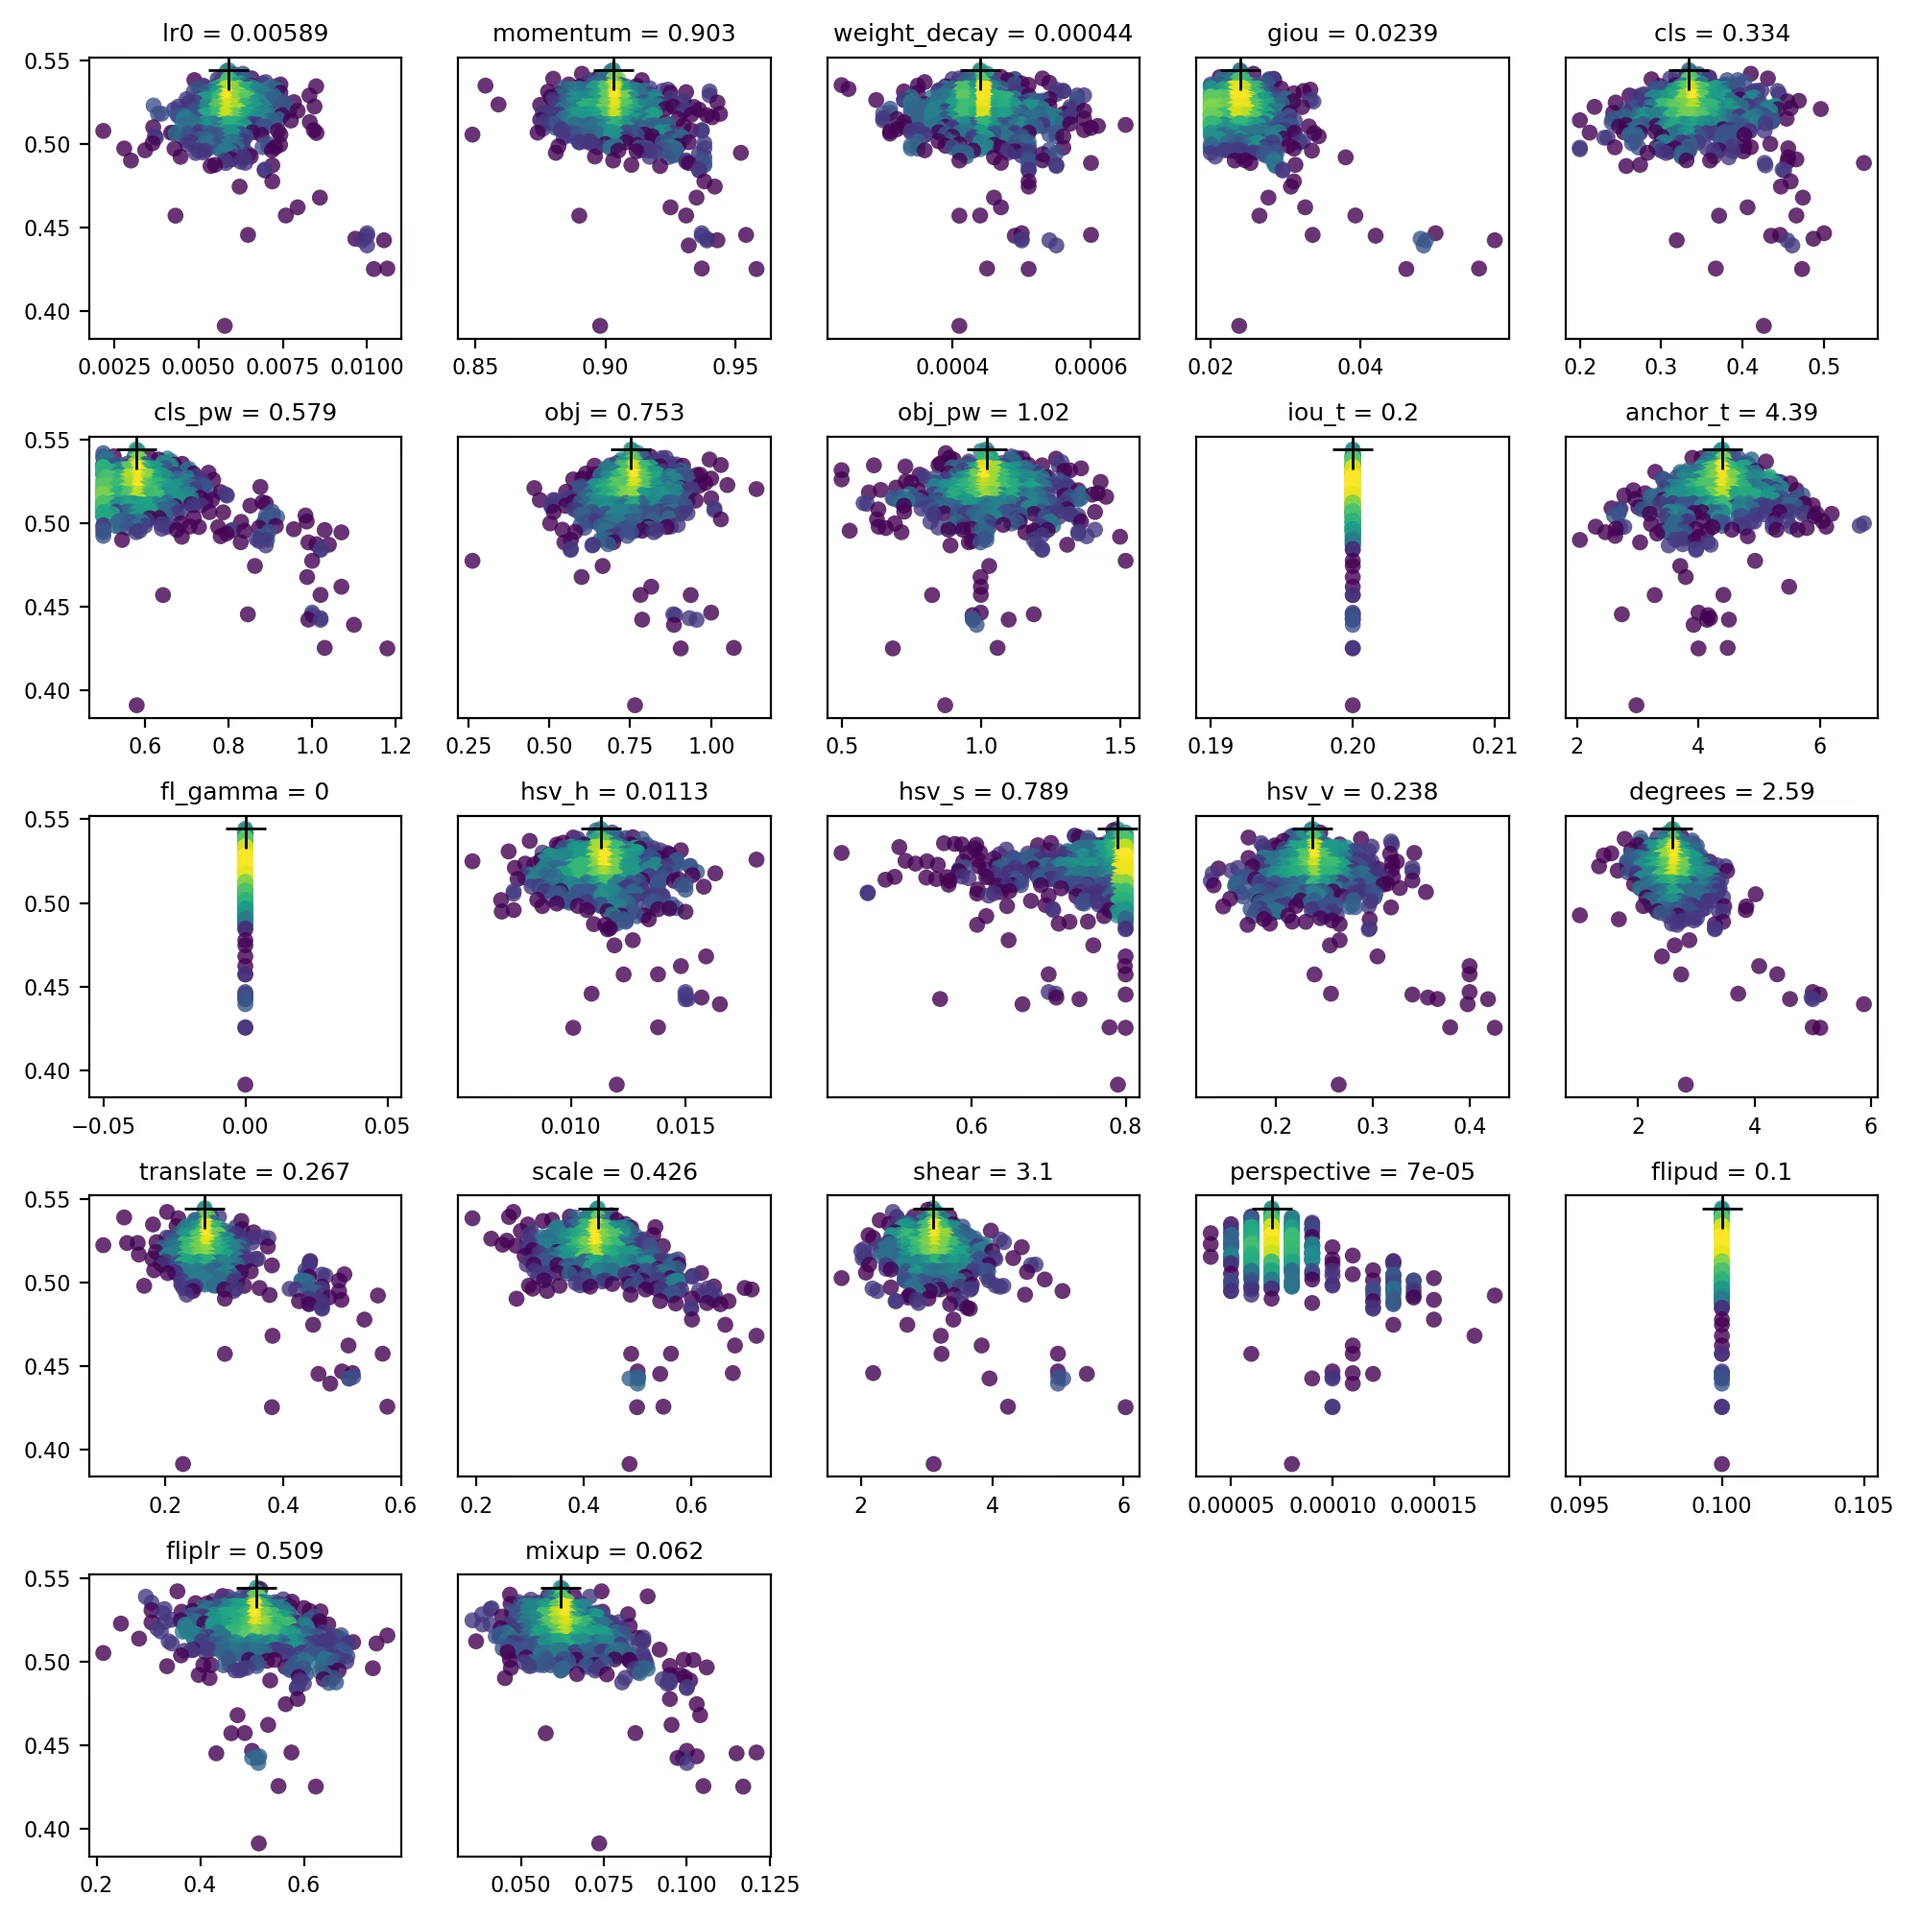
evolve.csv wird nach Abschluss der Evolution von utils.plots.plot_evolve() als evolve.png dargestellt. Für jeden Hyperparameter gibt es ein Teilbild, das die Fitness (y-Achse) den Hyperparameterwerten (x-Achse) gegenüberstellt. Gelb kennzeichnet höhere Konzentrationen. Vertikale Verteilungen zeigen an, dass ein Parameter deaktiviert ist und nicht mutiert. Diese Einstellung lässt sich im Wörterbuch meta in train.py auswählen und ist nützlich, um Parameter festzusetzen und ihre Weiterentwicklung zu verhindern.
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen, in denen wichtige Abhängigkeiten wie CUDA, CUDNN, Python und PyTorch bereits installiert sind, damit du schnell mit deinen Projekten loslegen kannst.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Badge zeigt an, dass alle GitHub-Actions von YOLOv5 für die kontinuierliche Integration (CI) erfolgreich durchlaufen. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 in verschiedenen wichtigen Bereichen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden alle 24 Stunden sowie bei jedem neuen Commit ausgeführt.
Häufig gestellte Fragen#
In jeder Generation wird das Basisszenario einmal pro Individuum in der Population mit 50 Mitgliedern trainiert. 300 Generationen eines COCO128-Laufs mit 10 Epochen kosten also ungefähr das 15.000-Fache eines einzelnen solchen Laufs. Halte das Basisszenario kurz und repräsentativ. Die obige Schleife für mehrere GPUs startet auf jeder GPU eine unabhängige Suche, statt eine Suche gemeinsam zu nutzen. Wenn du ein festes Budget einhalten musst, verringere daher
--evolvepro Prozess.Ja.
--evolveist standardmäßig auf 300 Generationen eingestellt. Übergib einen Wert wie--evolve 1000, um mehr Generationen auszuführen.Setze den ersten Wert des Eintrags im Wörterbuch
metaintrain.pyaufFalse. Ausgeschlossene Parameter behalten ihren Anfangswert bei und erscheinen inevolve.pngals vertikale Linien.Übergib die gespeicherte Datei an einen normalen Trainingslauf:
python train.py --hyp runs/evolve/exp/hyp_evolve.yaml --data your.yaml --weights yolov5s.pt.