Testzeitaugmentierung (TTA)#
📚 Diese Anleitung erklärt, wie du die Testzeitaugmentierung (TTA) beim Testen und bei der Inferenz mit YOLOv5 🚀 einsetzt, um mAP und Recall zu verbessern.
Vor dem Start#
Klone das Repository und installiere requirements.txt in einer Umgebung mit Python>=3.8.0, einschließlich PyTorch>=1.8. Modelle und Datensätze werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone
cd yolov5
pip install -r requirements.txt # install
Normal testen#
Bevor wir TTA ausprobieren, ermitteln wir eine Ausgangsleistung als Vergleichsbasis. Mit diesem Befehl wird YOLOv5x auf COCO val2017 mit einer Bildgröße von 640 Pixeln getestet. yolov5x.pt ist das größte und genaueste verfügbare Modell. Weitere Optionen sind yolov5n.pt, yolov5s.pt, yolov5m.pt und yolov5l.pt oder dein eigener Prüfpunkt aus dem Training mit einem benutzerdefinierten Datensatz, also runs/train/exp/weights/best.pt. Eine Übersicht aller verfügbaren Modelle findest du in unserer YOLOv5-Dokumentation.
python val.py --weights yolov5x.pt --data coco.yaml --img 640 --halfAusgabe:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=640, conf_thres=0.001, iou_thres=0.65, task=val, device=, single_cls=False, augment=False, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
Model Summary: 476 layers, 87730285 parameters, 0 gradients

val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2846.03it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [02:30<00:00,  1.05it/s]
                 all       5000      36335      0.746      0.626       0.68       0.49
Speed: 0.1ms pre-process, 22.4ms inference, 1.4ms NMS per image at shape (32, 3, 640, 640)  # <--- baseline speed

Evaluating pycocotools mAP... saving runs/val/exp/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.504  # <--- baseline mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.688
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.546
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.351
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.551
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.644
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.382
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.628
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.681  # <--- baseline mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.524
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.735
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.826
Mit TTA testen#
Hänge --augment an einen beliebigen vorhandenen val.py-Befehl an, um TTA zu aktivieren, und vergrößere die Bildgröße um etwa 30 %, um bessere Ergebnisse zu erzielen. Beachte, dass die Inferenz mit aktivierter TTA normalerweise etwa zwei- bis dreimal so lange dauert wie die normale Inferenz: Die Bilder werden horizontal gespiegelt, in drei verschiedenen Auflösungen verarbeitet und die Ergebnisse vor NMS zusammengeführt. Ein Teil des Geschwindigkeitsverlusts entsteht einfach durch die größeren Bildgrößen (832 statt 640), ein weiterer Teil durch die TTA-Operationen selbst. Stelle daher sicher, dass deine GPU genügend freien Speicher hat, bevor du --img erhöhst.
python val.py --weights yolov5x.pt --data coco.yaml --img 832 --augment --halfAusgabe:
val: data=./data/coco.yaml, weights=['yolov5x.pt'], batch_size=32, imgsz=832, conf_thres=0.001, iou_thres=0.6, task=val, device=, single_cls=False, augment=True, verbose=False, save_txt=False, save_conf=False, save_json=True, project=runs/val, name=exp, exist_ok=False, half=True
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Fusing layers...
/usr/local/lib/python3.7/dist-packages/torch/nn/functional.py:718: UserWarning: Named tensors and all their associated APIs are an experimental feature and subject to change. Please do not use them for anything important until they are released as stable. (Triggered internally at  /pytorch/c10/core/TensorImpl.h:1156.)
  return torch.max_pool2d(input, kernel_size, stride, padding, dilation, ceil_mode)
Model Summary: 476 layers, 87730285 parameters, 0 gradients
val: Scanning '../datasets/coco/val2017' images and labels...4952 found, 48 missing, 0 empty, 0 corrupted: 100% 5000/5000 [00:01<00:00, 2885.61it/s]
val: New cache created: ../datasets/coco/val2017.cache
               Class     Images     Labels          P          R     mAP@.5 mAP@.5:.95: 100% 157/157 [07:29<00:00,  2.86s/it]
                 all       5000      36335      0.718      0.656      0.695      0.503
Speed: 0.2ms pre-process, 80.6ms inference, 2.7ms NMS per image at shape (32, 3, 832, 832)  # <--- TTA speed

Evaluating pycocotools mAP... saving runs/val/exp2/yolov5x_predictions.json...
...
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.516  # <--- TTA mAP
 Average Precision  (AP) @[ IoU=0.50      | area=   all | maxDets=100 ] = 0.701
 Average Precision  (AP) @[ IoU=0.75      | area=   all | maxDets=100 ] = 0.562
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.361
 Average Precision  (AP) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.564
 Average Precision  (AP) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.656
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=  1 ] = 0.388
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets= 10 ] = 0.640
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=   all | maxDets=100 ] = 0.696  # <--- TTA mAR
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= small | maxDets=100 ] = 0.553
 Average Recall     (AR) @[ IoU=0.50:0.95 | area=medium | maxDets=100 ] = 0.744
 Average Recall     (AR) @[ IoU=0.50:0.95 | area= large | maxDets=100 ] = 0.833
Inferenz mit TTA#
Die TTA-Inferenz mit detect.py funktioniert genauso wie die TTA-Inferenz mit val.py: Hänge einfach --augment an einen beliebigen vorhandenen detect.py-Befehl an:
python detect.py --weights yolov5s.pt --img 832 --source data/images --augmentAusgabe:
YOLOv5 🚀 v5.0-267-g6a3ee7c torch 1.9.0+cu102 CUDA:0 (Tesla P100-PCIE-16GB, 16280.875MB)

Downloading https://github.com/ultralytics/yolov5/releases/download/v5.0/yolov5s.pt to yolov5s.pt...
100% 14.1M/14.1M [00:00<00:00, 81.9MB/s]

Fusing layers...
Model Summary: 224 layers, 7266973 parameters, 0 gradients
image 1/2 /content/yolov5/data/images/bus.jpg: 832x640 4 persons, 1 bus, 1 fire hydrant, Done. (0.029s)
image 2/2 /content/yolov5/data/images/zidane.jpg: 480x832 3 persons, 3 ties, Done. (0.024s)
Results saved to runs/detect/exp
Done. (0.156s)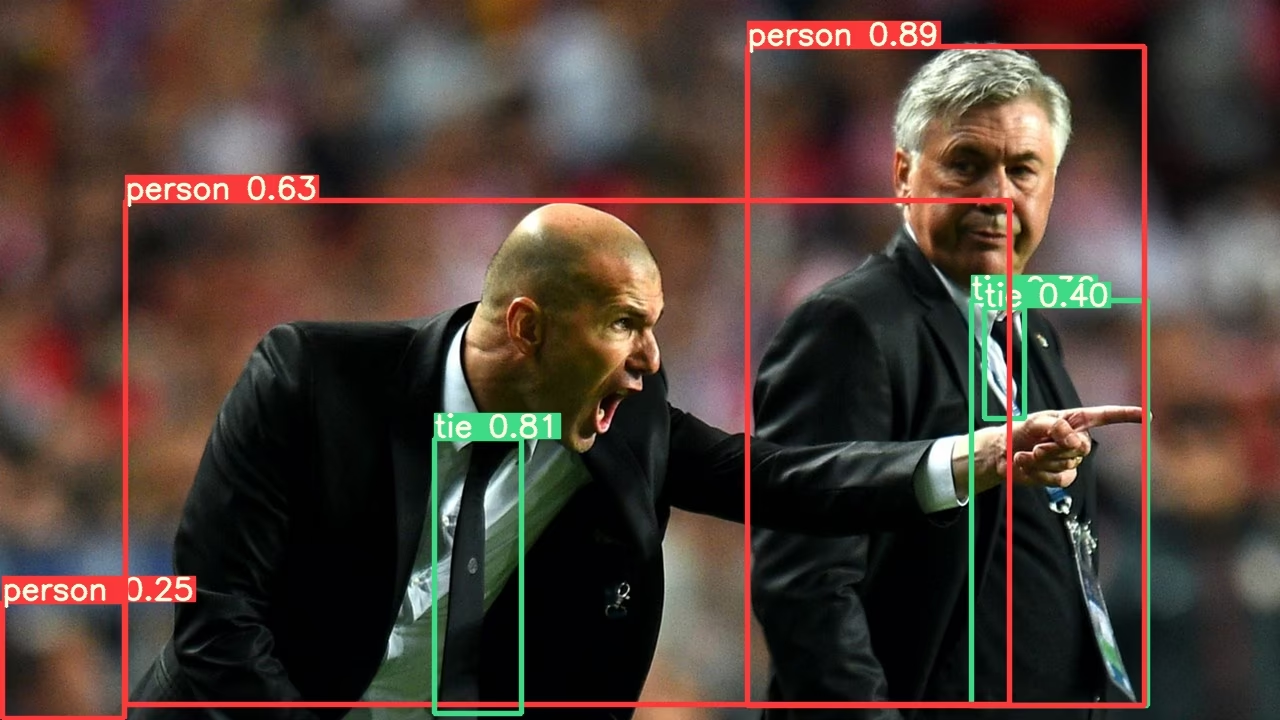
TTA mit PyTorch Hub#
TTA ist automatisch in alle YOLOv5-PyTorch-Hub-Modelle integriert und lässt sich bei der Inferenz durch Übergabe von augment=True aktivieren.
import torch

# Model
model = torch.hub.load("ultralytics/yolov5", "yolov5s")  # oder yolov5m, yolov5x, custom

# Images
img = "https://ultralytics.com/images/zidane.jpg"  # oder Datei, PIL, OpenCV, numpy, mehrere

# Inference
results = model(img, augment=True)  # <--- TTA-Inferenz

# Results
results.print() # oder .show(), .save(), .crop(), .pandas() usw.Anpassen#
Du kannst die TTA-Operationen anpassen, die in der Methode forward_augment() von YOLOv5 ausgeführt werden.
Vorteile der Testzeitaugmentierung#
Die Testzeitaugmentierung bietet mehrere wichtige Vorteile für Aufgaben der Objekterkennung:
- Höhere Genauigkeit: Wie die obigen Ergebnisse zeigen, erhöht TTA mAP von 0.504 auf 0.516 und mAR von 0.681 auf 0.696.
- Bessere Erkennung kleiner Objekte: TTA verbessert besonders die Erkennung kleiner Objekte. AP für kleine Flächen steigt von 0.351 auf 0.361.
- Höhere Robustheit: Indem mehrere Varianten jedes Bildes getestet werden, verringert TTA den Einfluss von Blickwinkel, Beleuchtung und anderen Umgebungsfaktoren.
- Einfache Umsetzung: Es muss lediglich das Flag
--augmentzu vorhandenen Befehlen hinzugefügt werden.
Der Nachteil ist die längere Inferenzzeit. Daher eignet sich TTA besser für Anwendungen, bei denen Genauigkeit wichtiger ist als Geschwindigkeit.
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen, in denen wichtige Abhängigkeiten wie CUDA, CUDNN, Python und PyTorch bereits installiert sind, damit du schnell mit deinen Projekten loslegen kannst.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Badge zeigt an, dass alle GitHub-Actions von YOLOv5 für die kontinuierliche Integration (CI) erfolgreich durchlaufen. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 in verschiedenen wichtigen Bereichen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden alle 24 Stunden sowie bei jedem neuen Commit ausgeführt.
Häufig gestellte Fragen#
Jedes Bild wird in drei Größen und zusätzlich horizontal gespiegelt verarbeitet. Die Vorhersagen werden vor NMS zusammengeführt. Die zusätzlichen Ansichten verbessern den Recall, besonders bei kleinen Objekten, erfordern aber mehr Rechenleistung.
Rechne mit etwa der zwei- bis dreifachen normalen Inferenzzeit. Ein Teil des Mehraufwands entsteht durch die größere Größe
--img. Achte daher darauf, dass deine GPU genügend Speicher hat, bevor du sie erhöhst.Eine um etwa 30 % höhere Auflösung, zum Beispiel 832 statt 640, liefert den Durchläufen mit mehreren Maßstäben mehr Details und führte in den obigen Benchmarks zu den besten Ergebnissen.
Der augmentierte Forward-Pass ist in PyTorch
DetectionModelimplementiert, daher wirkt sich--augmentnur auf.pt-Checkpoints aus. Exportierte ONNX-, TensorRT- und andere Formate berücksichtigen ihn nicht.