ClearML-Integration#

Über ClearML#
ClearML ist eine Open-Source-MLOps-Plattform, die Machine-Learning-Abläufe vereinfacht und Entwicklungszeit spart.
- 🔨 Verfolge jeden YOLOv5-Trainingslauf im Experimentmanager.
- 🔧 Versioniere deine eigenen Trainingsdaten und greife mit dem integrierten ClearML-Werkzeug zur Datenversionierung darauf zu.
- 🔦 Trainiere und überwache YOLOv5-Läufe aus der Ferne mit dem ClearML Agent.
- 🔬 Finde mit der ClearML-Hyperparameteroptimierung den besten mAP-Wert.
- 🔭 Verwandle dein trainiertes YOLOv5-Modell mit wenigen Befehlen in eine API – mit ClearML Serving.
Nutze so viele oder so wenige dieser Werkzeuge, wie du brauchst – beginne nur mit dem Experimentmanager oder verknüpfe alles zu einer vollständigen Pipeline.
🦾 Alles einrichten#
ClearML muss mit einem Server kommunizieren, um deine Experimente und Daten zu verfolgen. Du hast zwei Möglichkeiten:
- Registriere dich für den kostenlosen ClearML Hosted Service oder
- Richte deinen eigenen ClearML-Server ein – er ist Open Source und daher auch für sensible Daten eine geeignete Option.
Installiere anschließend das Python-Paket clearml und verbinde das SDK mit deinem Server:
pip install clearmlErstelle unter Einstellungen → Workspace → Neue Zugangsdaten erstellen (oben rechts in der ClearML-Benutzeroberfläche) Zugangsdaten und führe dann Folgendes aus:
clearml-initFolge den Anweisungen. Das war's – die Einrichtung ist abgeschlossen.
🚀 YOLOv5 mit ClearML trainieren#
Um das Experiment-Tracking zu aktivieren, installiere das ClearML-Paket mit pip, falls du es noch nicht getan hast:
pip install clearmlDamit wird die Integration in das YOLOv5-Trainingsskript aktiviert. Von nun an wird jeder Trainingslauf vom ClearML-Experimentmanager erfasst und gespeichert.
Um die Namen von Projekt und Aufgabe anzupassen, übergib --project und --name an train.py. Die Standardwerte sind YOLOv5 und Training. ClearML verwendet / als Trennzeichen für Unterprojekte. Vermeide daher / in eigenen Projektnamen.
python train.py --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheOder mit eigenen Namen:
python train.py --project my_project --name my_training --img 640 --batch 16 --epochs 3 --data coco128.yaml --weights yolov5s.pt --cacheJeder Lauf erfasst Folgendes:
- Quellcode und nicht committete Änderungen
- Installierte Pakete
- Hyperparameter
- Modell-Checkpoints (verwende
--save-period n, um allenEpochen zu speichern) - Konsolenausgabe
- Skalare Werte (mAP_0.5, mAP_0.5:0.95, Präzision, Trefferquote, Verluste, Lernraten)
- Maschinendetails, Laufzeit und Erstellungsdatum
- Erstellte Diagramme, z. B. das Korrelogramm der Beschriftungen und die Konfusionsmatrix
- Bilder mit Begrenzungsrahmen pro Epoche
- Mosaik-Visualisierungen pro Epoche
- Validierungsbilder pro Epoche
Alles wird in der ClearML-Benutzeroberfläche angezeigt, sodass du das Training an einer Stelle überwachen kannst. Füge eigene Spalten hinzu (zum Beispiel mAP_0.5), um nach dem leistungsstärksten Modell zu sortieren, oder wähle mehrere Experimente aus, um sie nebeneinander zu vergleichen.
Lies weiter, um mehr über Hyperparameteroptimierung und die Ausführung aus der Ferne zu erfahren.
🔗 Dataset-Versionen verwalten#
Wenn du Daten unabhängig vom Code versionierst, kannst du ganz einfach die neueste Version abrufen und die vollständige Reproduzierbarkeit sicherstellen. Dieses Repository akzeptiert eine Dataset-Versions-ID, ruft die Daten automatisch ab, falls sie fehlen, und speichert die ID als Aufgabenparameter. So weißt du immer, welche Daten in welchem Experiment verwendet wurden.
Dataset vorbereiten#
Das YOLOv5-Repository unterstützt viele Datasets über YAML-Konfigurationsdateien. Standardmäßig werden Datasets in den Ordner ../datasets heruntergeladen, relativ zum Stammverzeichnis des Repositorys. Nach dem Herunterladen von coco128 sieht die Ordnerstruktur so aus:
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ LICENSE
        |_ README.txt
Du kannst jedes Dataset verwenden, solange du diese Struktur beibehältst.
Kopiere als Nächstes die YAML-Datei des Datasets in dessen Stammverzeichnis – ClearML liest diese Datei, um das Dataset korrekt zu verwenden. Du kannst eine eigene YAML-Datei gemäß dem Beispielaufbau erstellen. Achte darauf, dass sie path, train, test, val, nc und names definiert.
..
|_ yolov5
|_ datasets
    |_ coco128
        |_ images
        |_ labels
        |_ coco128.yaml  # <---- HERE
        |_ LICENSE
        |_ README.txt
Dataset hochladen#
Um das Dataset als versioniertes ClearML-Dataset zu registrieren, wechsle in dessen Stammverzeichnis und führe Folgendes aus:
cd ../datasets/coco128
clearml-data sync --project YOLOv5 --name coco128 --folder .
clearml-data sync ist eine Kurzform für die folgende Befehlsfolge, die du auch einzeln ausführen kannst:
# Add --parent <parent_dataset_id> to base this version on a previous one.
# Duplicate files are not re-uploaded.
clearml-data create --name coco128 --project YOLOv5
clearml-data add --files .
clearml-data close
Mit einem ClearML-Dataset trainieren#
Sobald das Dataset registriert ist, gib beim Training seine ID an:
python train.py --img 640 --batch 16 --epochs 3 --data clearml://YOUR_DATASET_ID --weights yolov5s.pt --cache👀 Hyperparameteroptimierung#
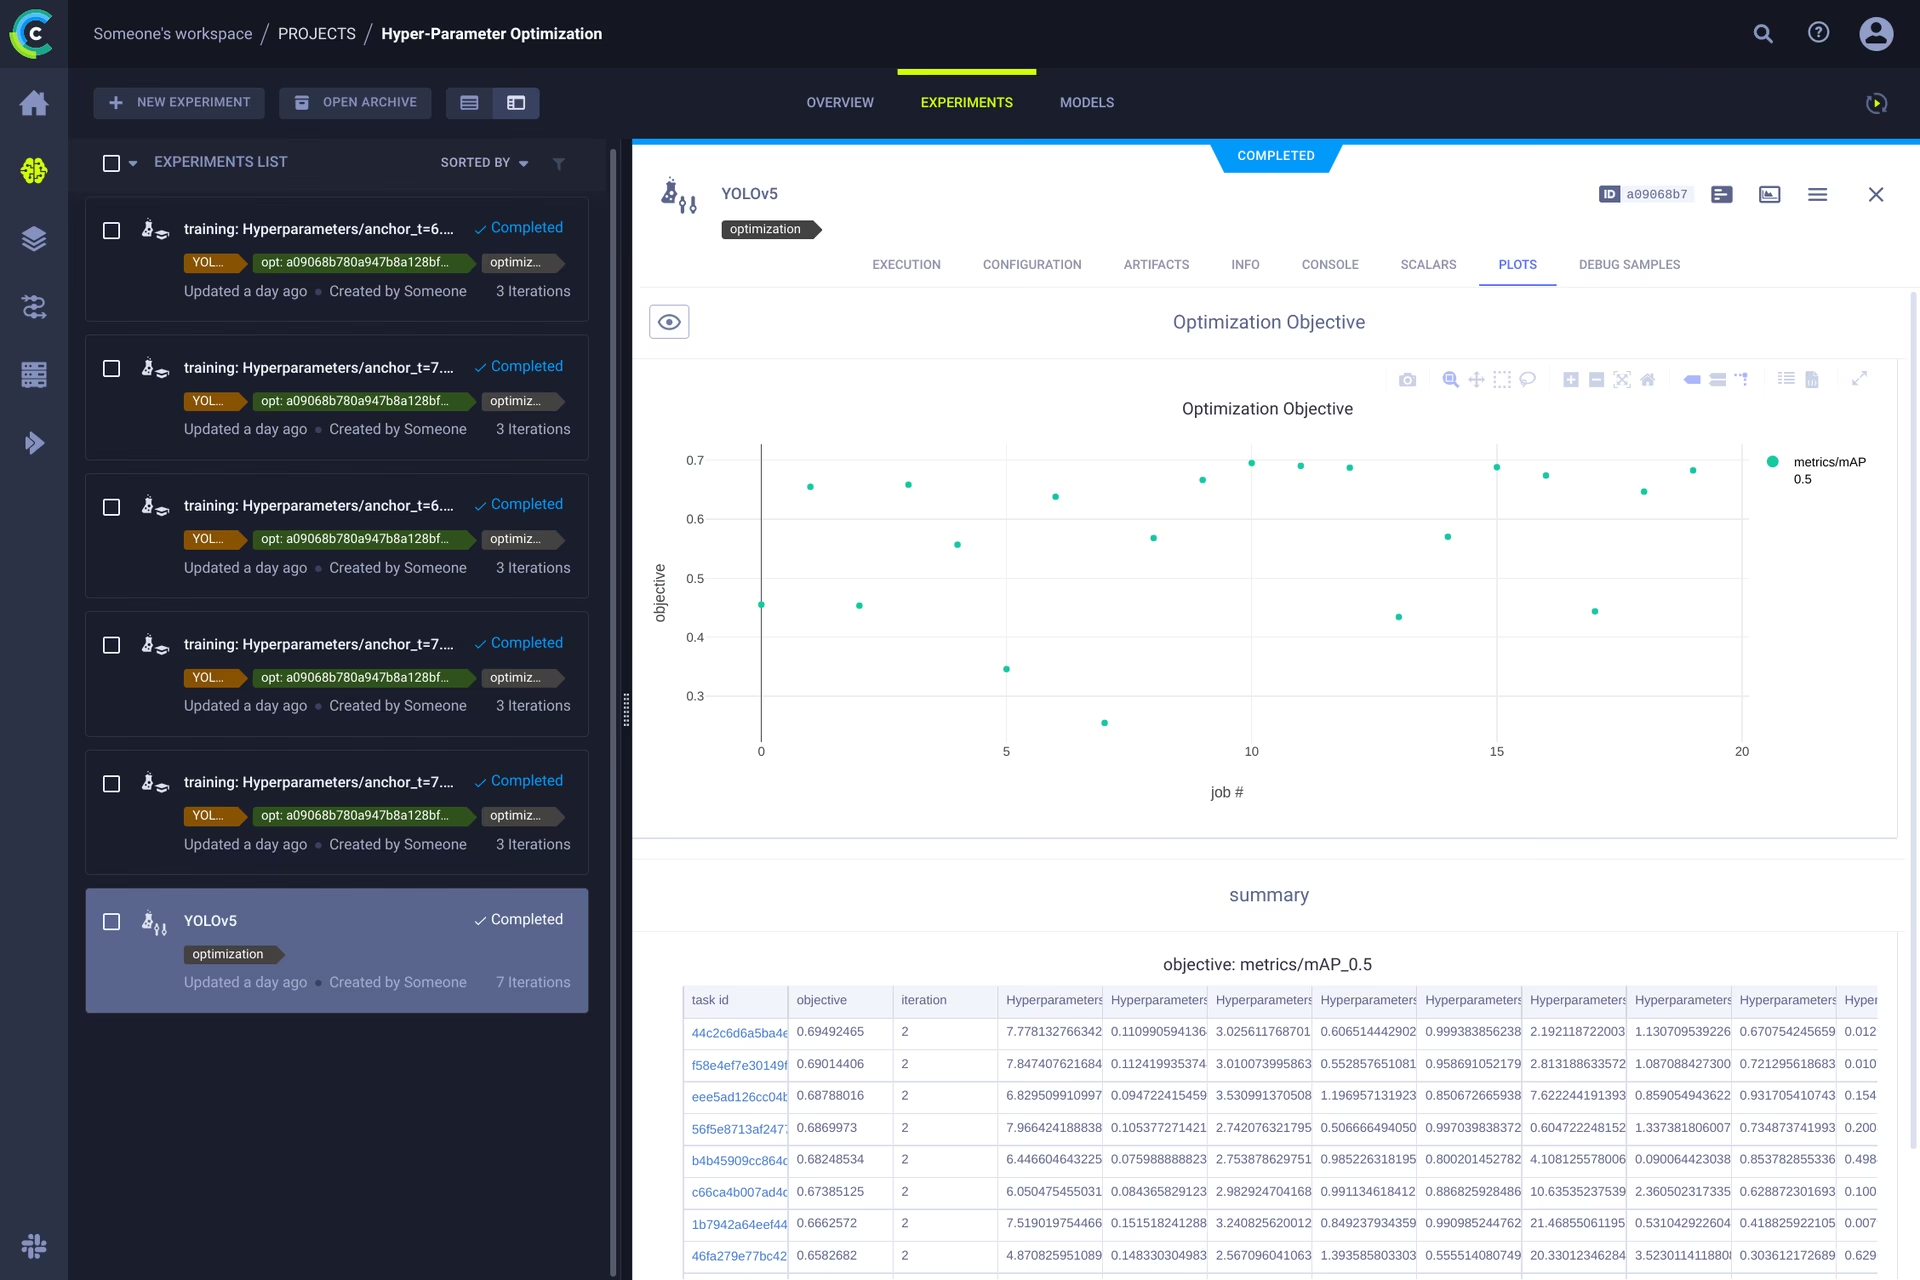
Wenn deine Experimente und Daten versioniert sind, kannst du darauf aufbauen. Da jedes erfasste Experiment die vollständige Umgebung – Code, installierte Pakete und Konfiguration – enthält, sind die Läufe vollständig reproduzierbar. Mit ClearML kannst du ein Experiment klonen, seine Parameter ändern und es automatisch erneut ausführen. Das ist die Grundlage der Hyperparameteroptimierung (HPO).
Um HPO lokal auszuführen, verwende das mitgelieferte Skript. Stelle zunächst sicher, dass im Experimentmanager eine Trainingsaufgabe vorhanden ist – das Skript klont sie und variiert ihre Hyperparameter.
Trage die ID der Vorlagenaufgabe in utils/loggers/clearml/hpo.py ein und führe dann Folgendes aus:
# Install Optuna or change the optimizer to RandomSearch.
pip install optuna
python utils/loggers/clearml/hpo.py
Um die Versuche stattdessen auf entfernten Agents auszuführen, ersetze optimizer.start_locally() durch optimizer.start() und setze execution_queue im Aufruf von HyperParameterOptimizer auf die Warteschlange, die deine Agents überwachen.
🤯 Ausführung aus der Ferne (fortgeschritten)#
HPO lokal auszuführen ist praktisch, aber oft möchtest du Experimente auf leistungsstärkerer Hardware ausführen – etwa auf einem GPU-Rechner vor Ort oder einer Cloud-Instanz. Dafür gibt es den ClearML Agent:
Jedes erfasste Experiment enthält alles, was nötig ist, um es auf einem anderen Rechner zu reproduzieren (installierte Pakete, nicht committete Änderungen und Konfiguration). Ein ClearML Agent überwacht eine Warteschlange, übernimmt eingehende Aufgaben, richtet die Umgebung erneut ein, führt den Auftrag aus und überträgt Skalare und Diagramme zurück an den Experimentmanager.
Verwandle jeden Rechner – eine Cloud-VM, einen lokalen GPU-Rechner oder einen Laptop – mit folgendem Befehl in einen ClearML Agent:
clearml-agent daemon --queue QUEUES_TO_LISTEN_TO [--docker]Klonen, bearbeiten und in die Warteschlange stellen#
Wenn ein Agent läuft, kannst du ihm direkt über die Benutzeroberfläche Aufgaben zuweisen:
- 🪄 Klicke mit der rechten Maustaste auf ein Experiment und klone es.
- 🎯 Bearbeite die Hyperparameter.
- ⏳ Klicke mit der rechten Maustaste auf die geklonte Aufgabe und stelle sie in eine Zielwarteschlange.
Eine Aufgabe aus der Ferne ausführen#
Du kannst ein laufendes Skript auch programmgesteuert für die Ausführung aus der Ferne markieren, indem du task.execute_remotely() hinzufügst, nachdem der ClearML-Logger initialisiert wurde. Füge die hervorgehobene Zeile in train.py ein:
# ...
# Loggers
data_dict = None
if RANK in {-1, 0}:
    loggers = Loggers(save_dir=save_dir, weights=weights, opt=opt, hyp=hyp, logger=LOGGER)
    if loggers.clearml:
        loggers.clearml.task.execute_remotely(queue="my_queue")  # <------ DIESE ZEILE HINZUFÜGEN
    # ...
    # Benutzerdefinierten Dataset-Artefaktlink verarbeiten
    data_dict = loggers.remote_dataset
# ...
Nach dieser Änderung wird das Trainingsskript bis zu dieser Zeile ausgeführt, packt den Code und überträgt ihn in die Warteschlange.
Worker automatisch skalieren#
ClearML enthält Autoscaler, die entfernte Rechner in AWS, GCP oder Azure starten, sobald in einer Warteschlange Experimente anstehen, diese Rechner in ClearML Agents umwandeln und sie nach Abschluss der Arbeit wieder herunterfahren. So zahlst du nur für tatsächlich laufende Rechenressourcen.
Sieh dir unten das Einführungsvideo an:
Weitere Informationen#
Weitere Informationen zur Integration von ClearML in Ultralytics-Modelle findest du in unserem Leitfaden zur ClearML-Integration. Entdecke außerdem, wie du deinen MLOps-Ablauf mit anderen Werkzeugen zur Erfassung von Experimenten verbessern kannst.
Häufig gestellte Fragen#
Nein. Der kostenlose gehostete Dienst unter app.clear.ml funktioniert direkt nach
clearml-init. Selbsthosting ist optional und die übliche Wahl, wenn Daten dein Netzwerk nicht verlassen dürfen.YOLOv5 aktiviert die Integration, sobald das Paket
clearmlimportiert werden kann. Deinstalliere es daher mitpip uninstall clearml, um die Nachverfolgung für einen Lauf zu deaktivieren.Registriere den Datensatz mit
clearml-data syncund übergib dann seine ID als Datenargument:python train.py --data clearml://YOUR_DATASET_ID --weights yolov5s.pt. Die ID wird für die Aufgabe gespeichert, damit jedes Experiment genau weiß, welche Daten verwendet wurden.Ja. Starte auf jedem Rechner einen
clearml-agent daemonund stelle dann entweder geklonte Experimente über die Benutzeroberfläche in die Warteschlange oder bearbeiteutils/loggers/clearml/hpo.py, sodassoptimizer.start()mit gesetztemexecution_queueaufgerufen wird. Dadurch überträgt der Optimierer die Versuche in die Warteschlange.