Transferlernen mit eingefrorenen Schichten in YOLOv5#
📚 Diese Anleitung erklärt, wie du beim Implementieren von Transferlernen YOLOv5-Schichten 🚀 einfrierst. Transferlernen ist eine leistungsstarke Technik des maschinellen Lernens (ML), mit der du ein Modell schnell mit neuen Daten neu trainieren kannst, ohne das gesamte Netzwerk von Grund auf neu zu trainieren. Wenn du die Gewichte der ersten Schichten einfrierst und nur die Parameter der späteren Schichten aktualisierst, kannst du den Bedarf an Rechenressourcen und die Trainingszeit deutlich verringern. Dieser Ansatz kann sich jedoch geringfügig auf die endgültige Genauigkeit des Modells auswirken.
Vor dem Start#
Klonen zunächst das YOLOv5-Repository und installiere die erforderlichen Abhängigkeiten aus requirements.txt. Stelle sicher, dass eine Python>=3.8.0-Umgebung mit installiertem PyTorch>=1.8 bereitsteht. Vortrainierte Modelle und benötigte Datensätze werden automatisch aus der neuesten YOLOv5-Version heruntergeladen.
git clone https://github.com/ultralytics/yolov5 # clone repository
cd yolov5
pip install -r requirements.txt # install dependencies
So funktioniert das Einfrieren von Schichten#
Wenn du Schichten in einem neuronalen Netzwerk einfrierst, verhinderst du, dass ihre Parameter (Gewichte und Biases) während des Trainings aktualisiert werden. In PyTorch geschieht dies, indem du das Attribut requires_grad der Tensoren der Schicht auf False setzt. Daher werden für diese Schichten während der Rückwärtspropagierung keine Gradienten berechnet, wodurch Rechenaufwand und Speicherbedarf sinken.
So friert YOLOv5 Schichten in seinem Trainingsskript ein:
# Freeze specified layers
freeze = [f"model.{x}." for x in (freeze if len(freeze) > 1 else range(freeze[0]))]  # layers to freeze
for k, v in model.named_parameters():
    v.requires_grad = True  # Ensure all parameters are initially trainable
    if any(x in k for x in freeze):
        print(f"Freezing layer: {k}")
        v.requires_grad = False  # Disable gradient calculation for frozen layers
Die Modellarchitektur erkunden#
Die Struktur des YOLOv5-Modells zu verstehen, ist entscheidend dafür, welche Schichten eingefroren werden sollen. Mit dem folgenden Python-Code kannst du die Namen aller Module und ihrer Parameter untersuchen:
# Angenommen, „model“ ist deine geladene YOLOv5-Modellinstanz
for name, param in model.named_parameters():
    print(name)

"""
Example Output:
model.0.conv.weight
model.0.bn.weight
model.0.bn.bias
model.1.conv.weight
model.1.bn.weight
model.1.bn.bias
model.2.cv1.conv.weight
model.2.cv1.bn.weight
...
"""
Die YOLOv5-Architektur besteht typischerweise aus einem Backbone (Schichten 0–9 in Standardkonfigurationen wie YOLOv5s/m/l/x), das für die Merkmalsextraktion zuständig ist, und einem Kopf (den übrigen Schichten), der die Objekterkennung durchführt.
# Example YOLOv5 v6.0 backbone structure
backbone:
    # [from, number, module, args]
    - [-1, 1, Conv, [64, 6, 2, 2]]  # Layer 0: Initial convolution (P1/2 stride)
    - [-1, 1, Conv, [128, 3, 2]] # Layer 1: Downsampling convolution (P2/4 stride)
    - [-1, 3, C3, [128]]          # Layer 2: C3 module
    - [-1, 1, Conv, [256, 3, 2]] # Layer 3: Downsampling convolution (P3/8 stride)
    - [-1, 6, C3, [256]]          # Layer 4: C3 module
    - [-1, 1, Conv, [512, 3, 2]] # Layer 5: Downsampling convolution (P4/16 stride)
    - [-1, 9, C3, [512]]          # Layer 6: C3 module
    - [-1, 1, Conv, [1024, 3, 2]]# Layer 7: Downsampling convolution (P5/32 stride)
    - [-1, 3, C3, [1024]]         # Layer 8: C3 module
    - [-1, 1, SPPF, [1024, 5]]    # Layer 9: Spatial Pyramid Pooling Fast

# Example YOLOv5 v6.0 head structure
head:
    - [-1, 1, Conv, [512, 1, 1]] # Layer 10
    - [-1, 1, nn.Upsample, [None, 2, "nearest"]] # Layer 11
    - [[-1, 6], 1, Concat, [1]] # Layer 12: Concatenate with backbone P4 (from layer 6)
    - [-1, 3, C3, [512, False]] # Layer 13: C3 module
    # ... subsequent head layers for feature fusion and detection
Optionen zum Einfrieren#
Mit dem Argument --freeze im Trainingsbefehl kannst du festlegen, welche Schichten eingefroren werden. Dieses Argument gibt den Index des ersten nicht eingefrorenen Moduls an; alle Module vor diesem Index haben eingefrorene Gewichte. Wenn du stattdessen mehrere Indizes übergibst (z. B. --freeze 0 1 2), werden genau diese Module eingefroren. Verwende model.model (ein nn.Sequential), um die Modulreihenfolge zu untersuchen und festzustellen, welche Indizes einem bestimmten Block entsprechen.
Nur das Backbone einfrieren#
Um das gesamte Backbone (Schichten 0 bis 9) einzufrieren, was häufig beim Anpassen des Modells an neue Objektklassen sinnvoll ist, während die anhand eines großen Datensatzes wie COCO erlernten allgemeinen Fähigkeiten zur Merkmalsextraktion erhalten bleiben:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 10Diese Strategie eignet sich, wenn dein Zieldatensatz ähnliche visuelle Merkmale niedriger Ebene (Kanten, Texturen) wie die ursprünglichen Trainingsdaten (z. B. COCO) aufweist, aber andere Objektkategorien enthält.
Alles außer den letzten Erkennungsschichten einfrieren#
Um fast das gesamte Netzwerk einzufrieren und nur die letzten Faltungsschichten der Ausgabe (Teil des Moduls Detect, normalerweise des letzten Moduls, z. B. Modul 24 in YOLOv5s) trainierbar zu lassen:
python train.py --weights yolov5m.pt --data your_dataset.yaml --freeze 24Dieser Ansatz ist nützlich, wenn du das Modell hauptsächlich an eine andere Anzahl von Ausgabeklassen anpassen musst und dabei den Großteil der erlernten Merkmale beibehalten möchtest. Für das Feinabstimmen werden hierbei die wenigsten Rechenressourcen benötigt.
Leistungsvergleich#
Um die Auswirkungen des Einfrierens von Schichten zu veranschaulichen, haben wir YOLOv5m 50 Epochen lang mit dem Pascal-VOC-Datensatz trainiert, ausgehend von den offiziellen, auf COCO vortrainierten Gewichten (yolov5m.pt). Wir verglichen drei Szenarien: alle Schichten trainieren (--freeze 0), das Backbone einfrieren (--freeze 10) und alle Schichten außer den letzten Erkennungsschichten einfrieren (--freeze 24).
# Example command for training with backbone frozen
python train.py --batch 48 --weights yolov5m.pt --data voc.yaml --epochs 50 --cache --img 512 --hyp data/hyps/hyp.VOC.yaml --freeze 10Genauigkeitsergebnisse#
Die Ergebnisse zeigen, dass das Einfrieren von Schichten das Training deutlich beschleunigen kann, aber möglicherweise zu einer geringfügig niedrigeren endgültigen mAP (mittleren durchschnittlichen Präzision) führt. Das Training aller Schichten erzielt im Allgemeinen die höchste Genauigkeit, während das Einfrieren weiterer Schichten das Training beschleunigt, aber möglicherweise die Leistung verringert.
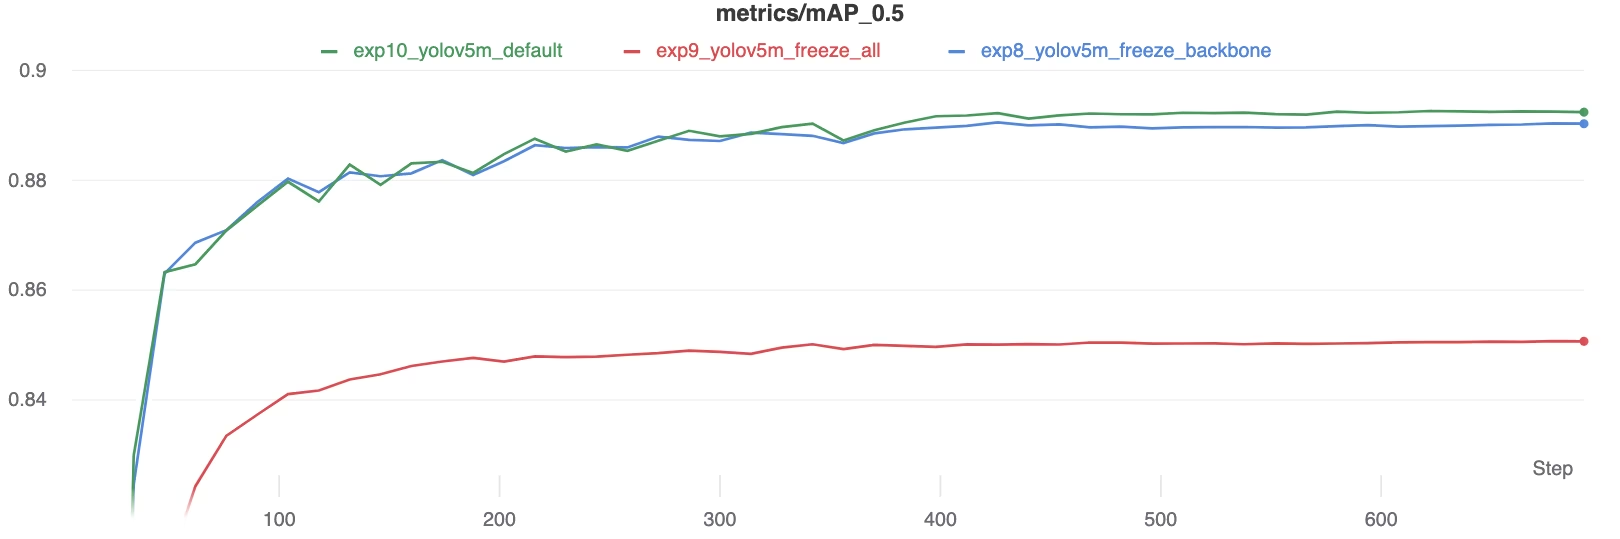 mAP50-Vergleich während des Trainings
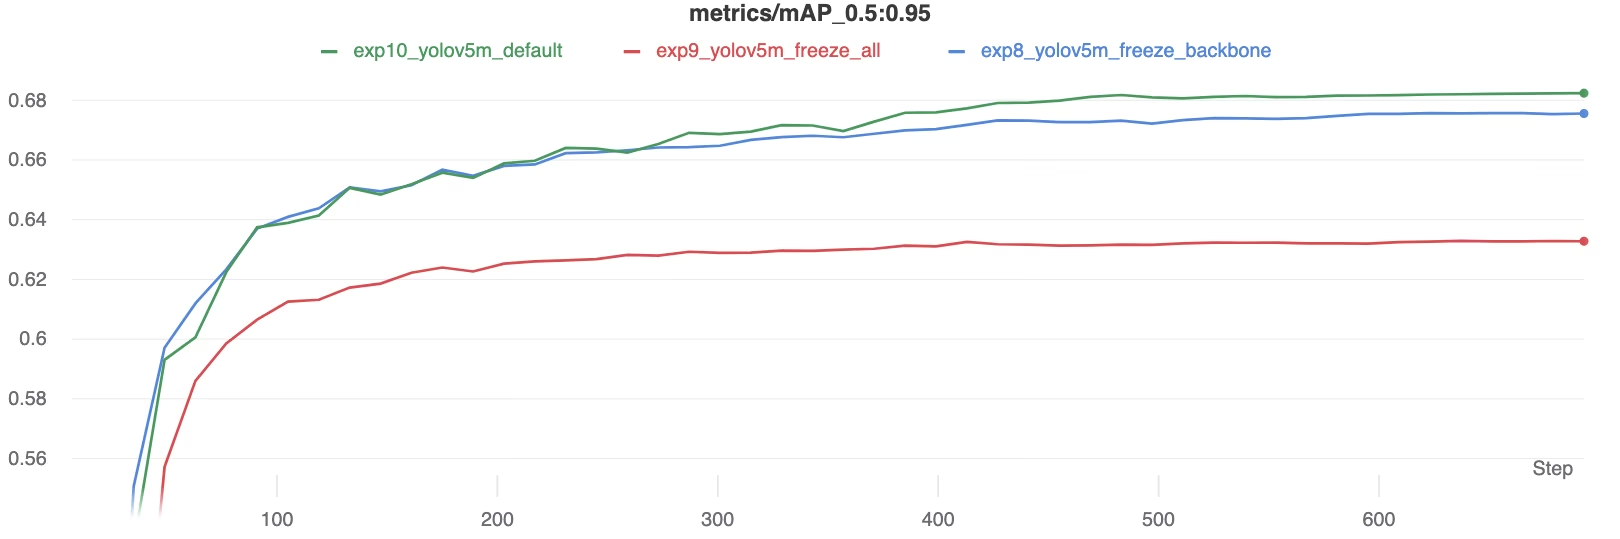 mAP50-95-Vergleich während des Trainings
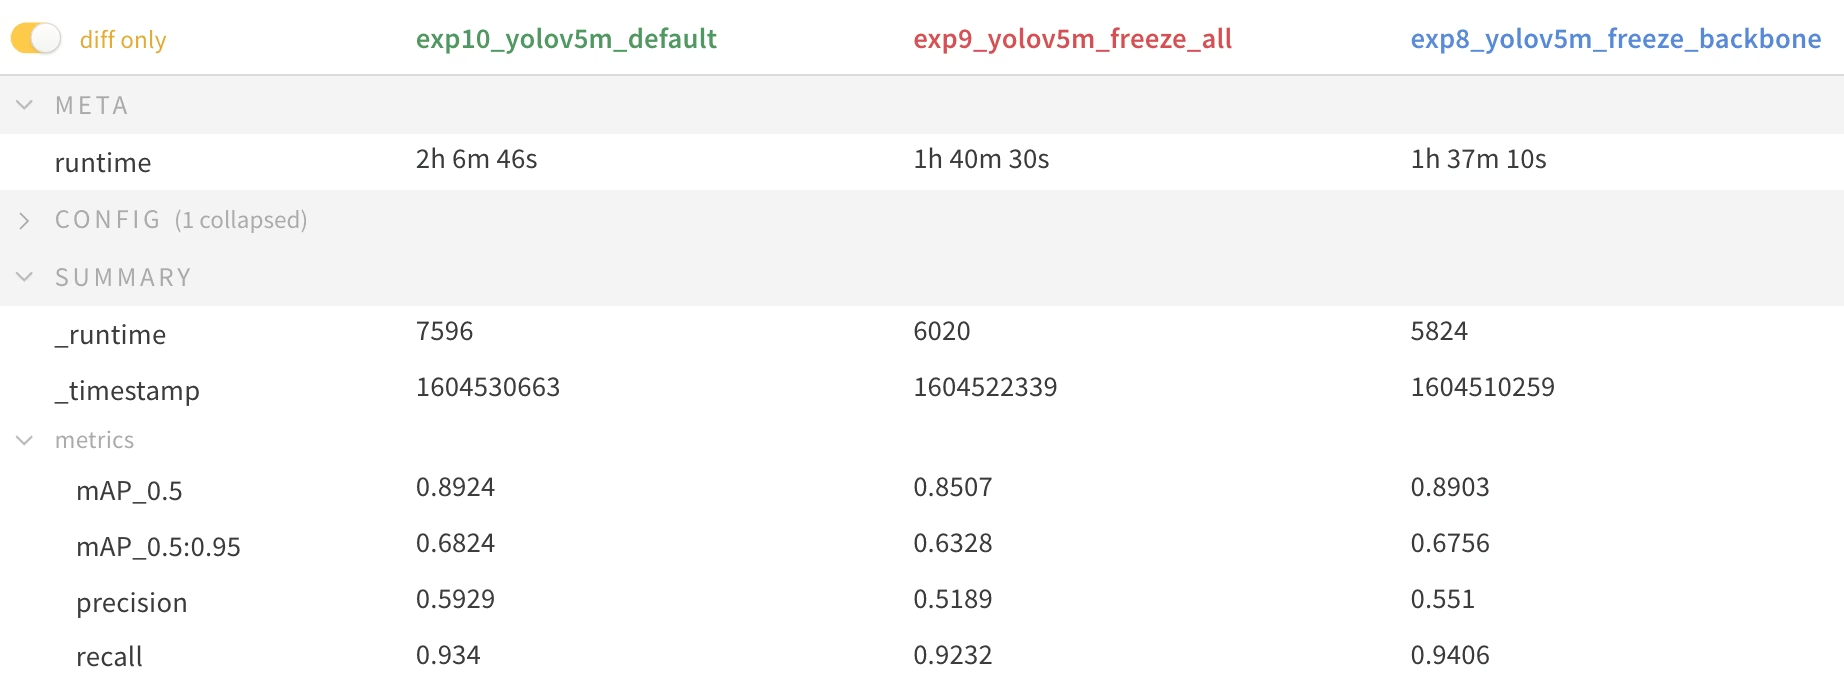 *Übersichtstabelle der Leistungskennzahlen*
Ressourcennutzung#
Wenn du mehr Schichten einfrierst, sinken der GPU-Speicherbedarf und die Gesamtauslastung deutlich. Dadurch ist Transferlernen mit eingefrorenen Schichten eine attraktive Option bei begrenzten Hardwareressourcen: Du kannst größere Modelle trainieren oder größere Bildgrößen verwenden, als es sonst möglich wäre.
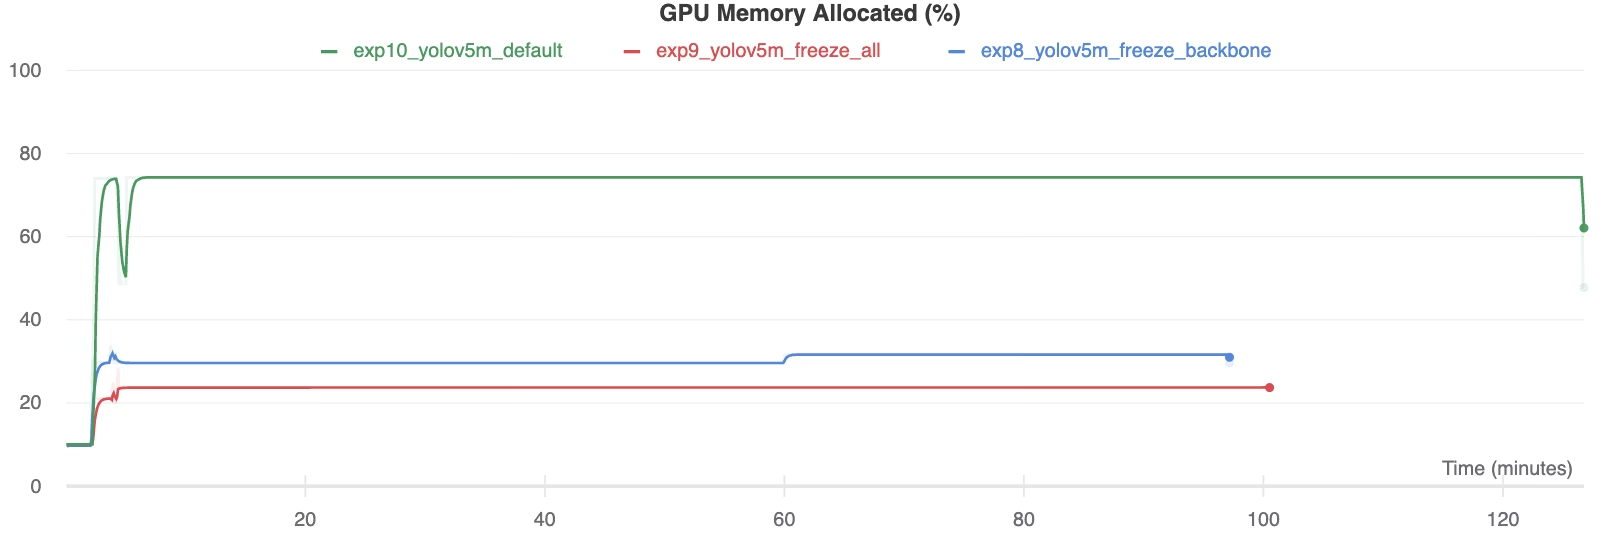 Belegter GPU-Speicher (%)
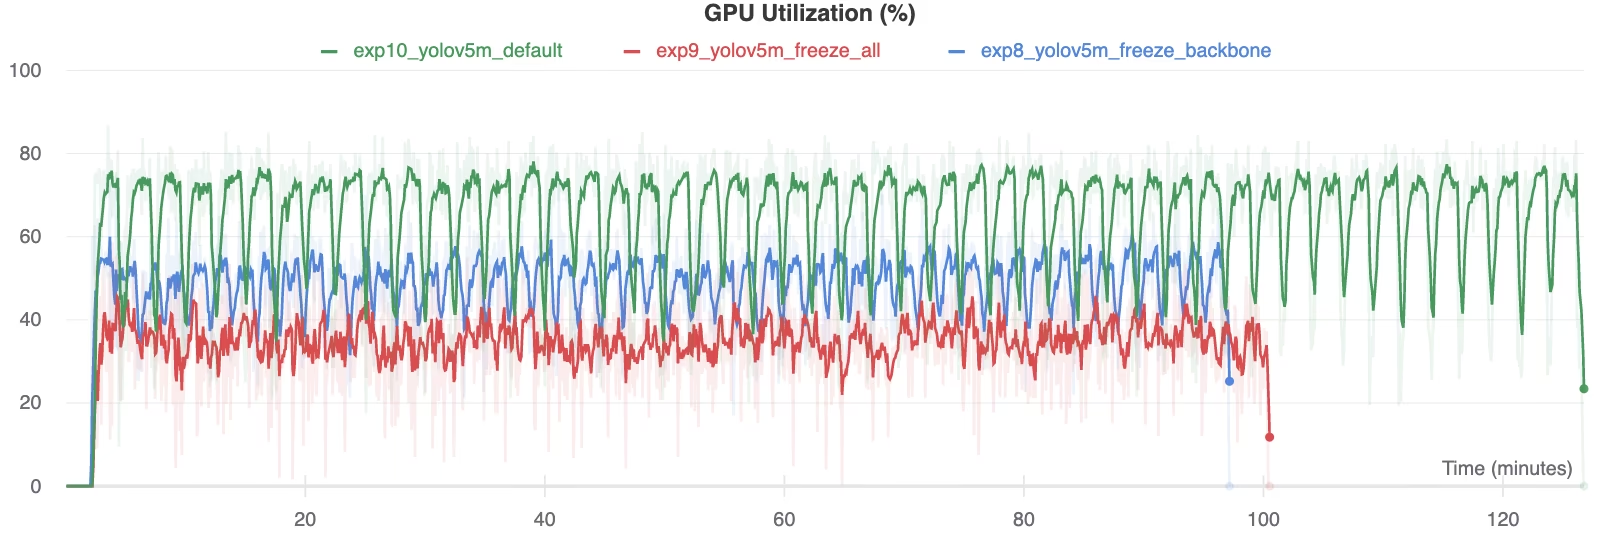 GPU-Auslastung (%)
Wann das Einfrieren von Schichten sinnvoll ist#
Das Einfrieren von Schichten beim Transferlernen ist in mehreren Situationen besonders vorteilhaft:
- Begrenzte Rechenressourcen: Wenn du nur über begrenzten GPU-Speicher oder eine eingeschränkte Rechenleistung verfügst.
- Kleine Datensätze: Wenn dein Zieldatensatz deutlich kleiner als der ursprüngliche Vortrainingsdatensatz ist, hilft das Einfrieren, Überanpassung zu verhindern.
- Schnelles Prototyping: Wenn du ein vorhandenes Modell für eine erste Bewertung rasch an eine neue Aufgabe oder einen neuen Anwendungsbereich anpassen musst.
- Ähnliche Merkmalsbereiche: Wenn die Merkmale niedriger Ebene in deinem neuen Datensatz den Merkmalen des Datensatzes, mit dem das Modell vortrainiert wurde, sehr ähnlich sind.
Erfahre mehr über die Feinheiten des Transferlernens in unserem Glossareintrag und erwäge die Hyperparameter-Evolution, um die Leistung zu optimieren.
Unterstützte Umgebungen#
Ultralytics bietet verschiedene sofort einsatzbereite Umgebungen mit vorinstallierten wichtigen Abhängigkeiten wie CUDA, CuDNN, Python und PyTorch.
- Kostenlose GPU-Notebooks:


- Google Cloud: GCP-Schnellstartanleitung
- Amazon: AWS-Schnellstartanleitung
- Azure: AzureML-Schnellstartanleitung
- Docker: Docker-Schnellstartanleitung

Projektstatus#

Dieses Abzeichen bestätigt, dass alle YOLOv5-GitHub-Actions-Tests zur kontinuierlichen Integration (CI) erfolgreich bestanden wurden. Diese CI-Tests prüfen gründlich die Funktionalität und Leistung von YOLOv5 bei zentralen Vorgängen: Training, Validierung, Inferenz, Export und Benchmarks. Sie gewährleisten einen konsistenten und zuverlässigen Betrieb unter macOS, Windows und Ubuntu. Die Tests werden automatisch alle 24 Stunden und bei jedem neuen Code-Commit ausgeführt.
Häufig gestellte Fragen#
Damit werden die ersten
NModule vonmodel.modeleingefroren. Ihre Gewichte bleiben also unverändert und erhalten keine Gradienten.--freeze 10friert das Backbone ein, und--freeze 24friert alle Module außer dem letzten ModulDetectein.Im obigen VOC-Experiment erzielte das Training aller Schichten die beste mAP. Das Einfrieren des Backbones verringerte die Genauigkeit geringfügig, während das Einfrieren aller Schichten außer dem Erkennungskopf den stärksten Rückgang verursachte. Dafür werden eingefrorene Modelle schneller trainiert und benötigen deutlich weniger GPU-Speicher.
Wenn deine Bilder Merkmale niedriger Ebene mit den Vortrainingsdaten gemeinsam haben, dein Datensatz klein ist oder du auf begrenzter Hardware schnell eine erste Vergleichsbasis benötigst. Trainiere alle Schichten, sobald der Datensatz wächst oder wenn du die letzten mAP-Punkte herausholen möchtest.
Ja. Starte einen neuen Lauf mit
best.ptdes eingefrorenen Modells und ohne--freeze, um das gesamte Netzwerk feinabzustimmen – in der Regel mit einer niedrigeren Lernrate.